Николай Хлебинский


Channel's geo and language: Russia, Russian
Category: Blogs


Регулярно делюсь своим предпринимательским опытом, лайфхаками и фишками про применение ИИ в бизнесе и в жизни.
Мои соц. сети: https://taplink.cc/nikolaykhl

Зарегистрирован в РКН
Related channels  |  Similar channels

Channel's geo and language
Russia, Russian
Category
Blogs
Statistics
Posts filter


Друзья, если у вас был установлен Claude Desktop и вы попали под бан как и я – поставьте на компьютер ChatGPT Desktop и попросите его восстановить нужные вам переписки, я смог вернуть почти все важное.

Скоро выложу на ютуб видео о том, как сделать так, что свести очень близко к нулю вероятность бана и как свести к абсолютному нулю потери чатов и накопленных наработок, если бан все-таки случился (поддержите меня огонечками к этому посту если хотите увидеть его поскорее!)


Ну что, кого еще задела вчерашняя волна банов Anthropic?


AI-проекты с нуля: как выбрать нишу, собрать продукт и выйти на первую выручку

Собрать AI-продукт сейчас можно за выходные. Сложнее добиться, чтобы им пользовались и за него платили: большинство таких проектов так и остаются демками.

8 октября на онлайн-панели разберём весь путь от идеи до первых денег.

Обсудим:

— как выбрать нишу, которую не съест следующий релиз OpenAI
— на чём собирать продукт: готовые API, агенты или своя модель, и как не утонуть в стоимости токенов
— где найти первых платящих клиентов без бюджета на маркетинг
— по каким сигналам понять, что проект пора масштабировать или закрывать

Спикеры:

Андрей Резинкин — ангел-инвестор в 20+ стартапах

Валерий Бабушкин — ex-VP of ML в Alibaba, руководил AI-командами до 600 человек в BP, Kaggle Grandmaster

Игорь Зуев — в портфеле 30+ приложений на рынок ЕС и США, выручка $1.5 млн+ в год

Артём Субботин — 20 лет опыта в hardware и создании глобальных трендов

Николай Хлебинский — серийный IT-предприниматель, основатель Retail Rocket

Александр Горный — ex-директор по стратегии Mail.Ru Group (VK), основатель клуба для предпринимателей ShareAI

📅 Когда: 8 октября, четверг, 19:00 мск
📍 Где: онлайн, Zoom
💰 Стоимость: бесплатно, нужна подписка на каналы всех спикеров
❓Q&A: да, приносите вопросы по своим проектам

Доступ к трансляции и запись получат только зарегистрированные — забирайте место:

👉 Зарегистрироваться на конференцию

5.8k 2 56 14 41

Протестировал только что вышедший Claude Opus 5.5

Вывод такой: кажется, GPT-6 Astra больше не нужна 😱

Посмотрите сами, на что способна эта штука: https://www.youtube.com/watch?v=nTejIUf_BCk

P.S.: ссылка на игрушку в первом комментарии к этому посту, пробуйте!


Яндекс выложил в открытый доступ модель под названием AliceAI-Foundation-80B-A3B-Base под лицензией Apache 2.0 (разрешено коммерческое использование). Компания заявляет, что это не докрутка китайских моделей, все веса обучены с нуля на своем корпусе текстов.

Что значат цифры в названии? 80B означает, что в ней 80 миллиардов параметров, A3B – что для ответа работают 3 миллиарда ("активные параметры", от них зависит цена ответа). По этим показателям модель сопоставима с Claude 3.5 Sonnet и GPT-4o (но это данные неофициальные никем не подтверждены). По замерам самого Яндекса, на русскоязычных вопросах и в математике она впереди модели DeepSeek-V4-Flash-Base.

"Base" в обоих случаях значит, что модель обучили на текстах, но не подготовили к общению, привычный нам чат из Base моделей получают дообучением. Грубо говоря, база – это выпускник, который прочитал всю библиотеку, а дообучение – это стажировка, где его учат работать с клиентами и соблюдать регламент компании. Дообучение делится на 3 основных стрима:

1. Дообучение самим производителем модели до чат-версии. Anthropic, OpenAI, DeepSeek и другие берут свою базу и учат ее отвечать на вопросы, следовать инструкциям, рассуждать, отказывать в опасных просьбах. Это делают на примерах диалогов и с оценками людей, которые говорят, что хорошо, а что плохо.

Этот шаг дает значимый плюс на тестах, а у Яндекса он еще не сделан. Так, флагман DeepSeek V4 Pro (это дообученная версия DeepSeek V4-Base) по тестам шла вровень с Claude Opus 4.6 и GPT-5.4, а это уже совсем другой уровень!

2. Дообучение бизнесом под свои задачи. Компания берёт готовую открытую модель и докручивает её на своих документах, переписках или отраслевой терминологии. Обычно правится малая часть весов, это относительно дешево и быстро. Важно: для "базы" от Яндекса компании придется сначала сделать первый вид дообучения, потом уже второй.

3. Доучивание поверх чужих весов. Прошлую версию Алисы Яндекс не учил с нуля, а взял готовые веса Qwen и продолжил обучение на своих данных. Это тоже дообучение, только на большом объёме и с целью получить свою модель, а не настроить чужую под задачу.

До флагманов OpenAI и Anthropic – Claude Fable 5.1 и GPT-6 Astra – отсюда далеко, но свои веса и свой корпус – вход в открытую лигу, где выкладывают свои базы, а не дообучают чужие. Пока это релиз для ML-команд. Весов 163 гигабайта, чат-версии нет, сроков Яндекс не называет и пишет, что модель "не является готовым решением". Зато у бизнеса, который держит open source у себя, чтобы данные не уходили наружу и юристы с безопасниками были спокойны, появилась отечественная база под дообучение.

Карточка модели: https://huggingface.co/yandex/AliceAI-Foundation-80B-A3B-Base


А вы знали, что все картины Моне созданы Клодом?


OpenRouter (агрегатор ИИ-моделей для разработчиков) сообщил, что на прошлой неделе его пользователи впервые за два с половиной года потратили на модели OpenAI больше, чем на Anthropic. OpenAI досталось чуть больше половины общих трат на две компании и 19% этих денег принесла одна GPT-6 Astra. Модель вышла через два дня после Claude Fable 5.1 и продается через API по тому же прайсу, 10 долларов за миллион токенов на входе и 50 на выходе.

Пару дней назад выпустил видео на ютубе про эту модель, если еще не смотрели – обязательно посмотрите, я до сих пор в шоке от ее возможностей: https://www.youtube.com/watch?v=JUWXno4Awvo

На всевозможных бенчмарках, где Astra сравнивают с Anthropic Fable 5.1 счет примерно равный. Вот где Astra впереди:

– Terminal-Bench, настройка и администрирование из командной строки – 59% против 52% у Антропика.
– AutomationBench, автоматизировация бизнес-процессов – 68% против 59%.
– ARC-AGI-2, тест на псевдо-интеллект – 95% против 90%, замер ARC Prize.
– BenchCAD, построение деталей в CAD – 95,9% против 84,3%.

Fable держит лидерство в Humanity's Last Exam, это тест 2500 из сложнейших вопросов из самых разных областей науки (59% у Fable против 55% у Astra), в работе с длинными (в том числе и офисными) документами и SWE-bench Pro (правка реальных ошибок в коде). Сводный индекс по тестам вровень, 53 на 53.

Стоимость моделей одинаковая, но счет за них приходит разный! На одну типовую задачу индекса Astra тратит 27 тысяч токенов, Fable 5.1 – 78 тысяч, и прогон индекса стоил 5,3 тысячи долларов против 13,1 тысячи, в 2,5 раза дешевле!

Модель вызвала такой всплеск внимания, что с 10 сентября OpenAI приостановила продажи подписки Pro за 200 долларов в месяц (где выдается очень много токенов), спрос на Astra компания назвала беспрецедентным. Действующие подписки работают, Plus за 20 долларов дает доступ к модели, но токены там модель съест быстро и придется покупать их в API.

OpenRouter: https://x.com/OpenRouter/status/2099898254905549220
Замеры Artificial Analysis: https://artificialanalysis.ai/models/comparisons/gpt-6-astra-vs-claude-fable-5-1
Пост сотрудника OpenAI про паузу в продаже подписки Pro: https://x.com/thsottiaux/status/2098113585683808624


Протестировал новую GPT-6 Astra. Я в шоке 😨

Просто посмотрите на что она способна: https://youtu.be/JUWXno4Awvo

8k 0 74 37 56

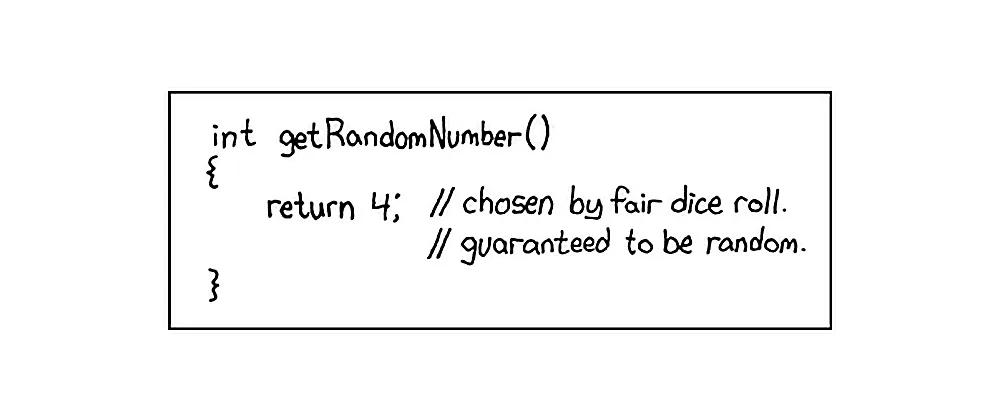
Что объединяет прошлые два поста про китайского фермера и просьбу для популярных нейронок назвать случайное число от 1 до 30 с ответом "17"?

Несколько дней назад независимый исследователь 360 раз спросил четыре ИИшки выдать число от 1 до 100 (без слово "случайное"), каждый раз в новом чате. Из ста чисел модели назвали всего 13, на 42 и 47 пришлось четыре ответа из пяти. Обычный программный генератор случайных чисел на те же 360 запросов выдал все сто!

Языковая модель ничего не выбирает и не любит. Она дописывает текст так, как скорее всего дописали бы люди, а знание о людях берется из корпуса текстов, на которых модель обучена. Какое число встречается в таком контексте чаще – такое и будет ответом.

Это не предвзятость, которую починят настройкой. Слово "случайное" в запросе в том же замере расширило набор с пяти чисел до тринадцати, лидер остался тот же. Модели не врут и не галлюцинируют, они так устроены, просто выдают следующий наиболее вероятный токен (токен – слово или кусок слова). Равных шансов у чисел нет, у одного из чатов лидер забрал больше девяти ответов из десяти.

Та же природа везде, где нейронке доверяют что-то выбрать. В свежем исследовании модели составляли тесты с вариантами ответов вида "какой ответ правильный – А,Б или В?", одна из них больше чем в половине случаев ставила правильный ответ на одну и ту же букву вместо честной четверти. Сама породить случайность модель не умеет, зато с ней работает, если число дать снаружи, кодом или генератором. При этом модель легко напишет код генератора случайных чисел по запросу (но это будет дороже в токенах).

Современный ИИ – это идеальная машина генерация того, что хочет услышать сферический усредненный по выборке из всего человечества индивид. Миллионеры едят мясо, а я – капусту, но в среднем мы все едим голубцы.

Замер 360 запросов: https://nicolassitter.com/research/ai-random-number-2026
Исследование про случайные числа у нейронок: https://arxiv.org/abs/2601.05414


Китайский фермер год с лишним следовал советам ИИ о том, как и когда обрабатывать и удобрять свои поля. Поначалу он относился к рекомендациям с сомнениями, по мере внедрения рекомендаций доверие росло, в какой-то момент критическое мышление отключилось и он стал полностью следовать рекомендациям.

В июле этого года фермер обсудил с ИИ (с каким ИИ он советовался – не уточняется) проблему сорняков и вредителей на его плантации кунжута и в конце уточнил как обработать поле дроном.
В переписке с нейронкой, которую потом посмотрел один из журналистов, ИИ выдает готовый план обработки с полным набором препаратов, встречных вопросов вопросов от фермера не было. Дрон прошел все поле и обработал 10 гектаров.

На следующий день погибли и сорняки и всходы кунжута, весь урожай был уничтожен. Эксперт-агротехник, проанализировавший потом ситуацию, сообщил, что один из гербицидов из плана ИИ применяют только направленно, по сорнякам, сплошная обработка гарантировано убивает полезную культуру.

ИИ это мультипликатор компетенций: он дает возможность профессионалу производить больше ценности в единицу времени, при этом некомпетентность и ее последствия он так же мультиплицирует.

Фермер получал от ИИ ценность в течение года, но как только предметная область вышла за рамки его компетенции – случилась катастрофа. Для профессионала первый ответ ИИ это черновик, такую ошибку он ловит быстро. У фермера ответ стал единственным мнением, ведь своего опыта по этому вопросу у него не было.

Дилетант с ИИ не может заменить профессионала, вопрос времени, когда он создаст значительно больше проблем, чем принесет пользы. Но и профессионал без ИИ обречен на вымирание, потому что профессионал с ИИ будет создавать на порядок больше ценности в единицу времени.

Источник: https://finance.sina.com.cn/jjxw/2026-08-01/doc-inikurwm3940989.shtml

8.7k 2 112 35 121

Если попросить ChatGPT дать случайное число от 1 до 30 – он ответит "17". И все остальные самые крутые LLM тоже 🙈


А вот и новое поколение ChatGPT! Очень интересно наблюдать за этой гонкой ИИ-вооружений!

8k 0 16 9 53

Что за день! Пора новую серию батла снимать ☺️


Вот это новости! Кто уже попробовал?

8.7k 0 21 44 49

У меня сегодня вакансия-бомба – HRD / HRBP в медицинский Family Office ЕС Клиника 👩‍⚕️

Мы c Михаилом Гребенюком строим ЕС-Клинику: первую в России единую систему управления здоровьем семьи. Собственная команда врачей и кураторов берёт на себя всё — от «у ребёнка температура в поездке» до сложного диагноза у родителей. Одна команда, одна история здоровья, годами.

Продукт получается сильнее, чем скорость, с которой мы собираем под него команду. Поэтому ищу человека, для которого «таких людей не найти» — это начало рабочего дня:

— сам находит и приводит лидеров, а не ждёт откликов;
— строит найм как воронку: каналы, темп, метрики;
— на невозможную задачу отвечает «придумаю, как» — и закрывает за недели;
— за пять минут разговора отличает человека премиального сервиса.

Взамен — прямая работа со мной и Михаилом, карт-бланш на инструменты и бюджет, позиция с максимальным влиянием на компанию. Знаете такого человека — перешлите ему или ей этот пост 🙏

Ссылка на анкету для отклика: https://forms.yandex.ru/u/6a967b024936390143aa6103


Через 51 минуту заберу телефоны у группы из 20 успешных предпринимателей с суммарным оборотом больше 10 млрд рублей в год и погружу их на несколько в среду развивающего дискомфорта.

Сегодня начинается мастермайнд «Совет директоров», который я лидирую уже полтора года.

Раз в квартал несколько десятков предпринимателей на 4 дня собираются и ищут ответ на вопрос «что нужно делать по-другому, чтобы кардинально изменить динамику в бизнесе».

Мы погружаемся на несколько часов в бизнес-контекст каждого участника группы и формируем план действий на квартал, потом разъезжаемся на его реализацию и через 3 месяца повторяем процесс.

Это самый эффективный способ развития в бизнесе, который мне известен (а я пробую все что можно и учусь постоянно!).


Смеяться над количеством пальцев на сгенерированной картинке или обесценивать очередную нейронку из-за ошибки ответа чат-бота – все равно, что говорить "какой из него хирург, он даже ложку держать не может" трехлетнему ребенку. Не успеем оглянуться, как робот под управлением ИИ станет хирургом.

В предыдущем посте (и в комментариях к нему, дочитайте до конца) мой вольный перевод эссе Билла Гейтса про ИИ, которое он опубликовал вчера и уже наделал им много шума в западных медиа.

Источник: https://www.gatesnotes.com/work/make-ai-work-for-everyone/reader/a-turbulent-ai-era-and-critical-choices-to-make


Важный текст, пожалуйста прочитайте

ИИ станет либо величайшим уравнителем из всех когда-либо изобретенных человечеством, либо худшим источником несправедливости за всю историю. Даже при самом удачном раскладе переход в новую эпоху ИИ будет одним из самых бурных периодов в истории цивилизации. Как использовать эту технологию, чтобы мир стал справедливее, а пропасть между богатыми и бедными не стала шире? Как защитить тех, кто наиболее уязвим перед вредом от искусственного интеллекта, - включая тех, кто гарантированно потеряет средства к существованию и ощущение, что их будущее хоть как-то у них под контролем?

Ответить на эти вопросы и действовать - главный приоритет для планеты. Если мир сделает правильные шаги, ИИ станет силой во благо, и каждый останется в выигрыше.

К сожалению, прямо сейчас мы полностью игнорируем эти вопросы. Я не вижу признаков того, что мировые лидеры, эксперты и профессиональные сообщества адекватно адресуют эти вызовы. Плана, который смягчил бы вход в эпоху ИИ, не существует.

Отчасти причина в том, что многие просто недооценивают масштаб влияния ИИ. Думаю, на то есть несколько причин.

Первая - ИИ-модели все еще ошибаются. Трудно представить, что какая-то из них заменит человеческое мышление, когда еще недавно они не могли решить простой судоку или посчитать, сколько букв R в слове strawberry.

Но проблема надежности быстро решается: исследователи создают модели, которые проверяют собственную работу и улучшают сами себя. Скоро во многих задачах они будут существенно лучше людей.

Вторая причина, по которой люди недооценивают ИИ, - аналогии с эффектами прошлых инноваций вводят в заблуждение. У нас нет опыта с технологией, которая распространяется так быстро и умеет думать и действовать как человек.

Когда появился персональный компьютер, ему понадобилось двадцать лет, чтобы всерьез изменить нашу работу: нужно было разработать софт, снизить цену, а людям - научиться пользоваться инструментами и встроить их в свои бизнес-процессы. ИИ, напротив, работает на устройствах, которые у нас уже есть, и общается на естественном языке. Нам не нужно приспосабливаться к нему, потому что он приспосабливается к нам. Он может посмотреть то же обучающее видео, на котором учат живых сотрудников, и учиться на уже существующих данных.

Продолжение текста в комментариях 🫥


Криптобиржа Binance открыла возможность подключать ИИ-агентов (ChatGPT, Claude Code, Cursor) к своей платформе и торговать со счета пользователя. Средства лежат на отдельном субсчете, вывести их агент по умолчанию не может, есть два режима работы на выбор: подтверждать каждую сделку руками или отпустить его торговать самому.

В прошлом году появилось несколько публичных соревнований ИИ-агентов в криптотрейдинге. Самый известный проект – Alpha Arena – по сумме нескольких месяцев торгов в минусе оказались все модели, кто играл в обоих, включая Qwen, который в первой части соревнования показал +22% к портфелю и включая Grok, который в некоторый момент показал серьезный результат в плюс. С декабря 2025 публичных результатов нет ни у одной арены.

Для биржи это интересный путь увеличить объем торгов и привлечь новых пользователей. При этом вся финансовая ответственность, конечно же, у владельца агента: потолка на торговые убытки внутри субсчета нет, ограничение только суммой, которую вы туда завели. Сама Binance тоже пишет, что их Agent OS – это не автономная торговая система, следить за агентом работа владельца счета.

Скорее всего агент на субсчете деньги потеряет. Индустрия пускает агентов к живым деньгам, не дождавшись ни одного публичного доказательства, что они умеют их не терять. А единственный, кто на аренах заработал, – вендор, выставивший в турнир свою модель. Пост не является инвестиционной рекомендацией, только мое личное мнение!

Источник: https://techcrunch.com/2026/08/20/binance-now-lets-ai-agents-trade-but-keeping-them-in-check-is-largely-up-to-users/


Третья серия ИИ-Баттла уже на ютубе!

Построил 2 ИИ-агентов, анализирующих качество работы отдела продаж в AmoCRM, одного через GPT 5.6 Sol, второго через Fable.

Оба анализировали 40 сделок, которые я разметил заранее (контакты, заметки, звонки, переписки и тд), как думаете, кто отработал лучше?

Кстати, в этот раз показываю как обезличить персональные данные перед передачей в американские модели (очень уж много было комментариев по 152ФЗ в прошлом выпуске).

Классный ролик получился 🔥 напишите комментарий на ютубе под видео, чтобы помочь его продвинуть: https://youtu.be/pI9TsWS0rw0

PS: все материалы из ролика в первом комментарии под этим постом

20 last posts shown.