Data Science: SQL и Аналитика данных


Channel's geo and language: Russia, Russian
Category: Technologies


№ 6205468675
На простом языке: про работу с данными, современные технологии, AI, машинное обучение и, немного, SQL.
Сотрудничество: @niktwix
Менеджер: @Spiral_Yuri

Зарегистрирован в РКН
Related channels

Channel's geo and language
Russia, Russian
Statistics
Posts filter


🔥 SQL-задача с подвохом

Что вернёт этот запрос в PostgreSQL?


CREATE TABLE payments (
id int,
amount int
);

INSERT INTO payments VALUES
(1, 100),
(2, 100),
(3, 200);

SELECT
id,
amount,
SUM(amount) OVER (ORDER BY amount) AS total
FROM payments
ORDER BY id;


Многие ожидают:


1 | 100 | 100
2 | 100 | 200
3 | 200 | 400


Но результат будет другим:


1 | 100 | 200
2 | 100 | 200
3 | 200 | 400


По умолчанию PostgreSQL использует окно RANGE ... CURRENT ROW. Строки с одинаковым amount считаются равными соседями и попадают в окно вместе.

Для построчного накопления нужно указать ROWS:


SUM(amount) OVER (
ORDER BY amount, id
ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW
)


#SQL #PostgreSQL #Database

🫡 Всё про Data Science

🇷🇺 Читайте нас в MAX


🔥 Tabularis - единое open-source приложение для работы с SQL

Если приходится постоянно переключаться между разными клиентами для PostgreSQL, MySQL и SQLite, Tabularis собирает всё в одном desktop-приложении.

Что умеет:

⏺️ PostgreSQL, MySQL/MariaDB и SQLite из коробки
⏺️ SQL notebooks с Markdown, результатами и графиками
⏺️ визуальный конструктор запросов
⏺️ Visual EXPLAIN с интерактивным разбором query plan
⏺️ переменные между ячейками
⏺️ MCP-сервер для AI-агентов
⏺️ расширение поддержки других БД через плагины

Подходит как единое рабочее место для аналитики, разработки и отладки SQL.

Apache 2.0.

🫡 Всё про Data Science

🇷🇺 Читайте нас в MAX


🔥 LatticeDB - локальная база для Graph RAG и памяти AI-агентов

Проект объединяет в одном embedded-движке сразу три способа работы с данными:

⏺️ граф связей
⏺️ векторный поиск через HNSW
⏺️ полнотекстовый поиск BM25

Вся база хранится в одном файле - без отдельного сервера и сложной конфигурации. Есть bindings для Python, TypeScript/Node.js и Go.

Подходит для Graph RAG, agent memory и локальных knowledge-систем.

➡️ https://readhacker.news/s/73wnt

🫡 Всё про Data Science

🇷🇺 Читайте нас в MAX


📊 Аналитик данных: системные знания для профессионального роста

14 октября на Факультете компьютерных наук НИУ ВШЭ стартует программа профессиональной переподготовки «Аналитик данных». Программа охватывает ключевые направления работы с данными: от Python, SQL и статистики до продуктовой аналитики, визуализации и машинного обучения.

📚 В программе:
• Python и SQL для анализа данных;
• математика и статистика;
• проверка гипотез и A/B-тестирование;
• визуализация данных и BI;
• продуктовая аналитика;
• машинное обучение;
• хранилища данных и основы работы с большими данными;
• итоговый проект на основе реальной задачи.

🎓 Главное о программе:
• ФКН НИУ ВШЭ — один из ведущих факультетов России в области компьютерных наук;
• преподаватели программы работают в Яндексе, Ozon Tech, Wildberries, Магните, Okko, ivi и других технологических компаниях;
• обучение построено на практических задачах и работе с данными;
• по итогам обучения выпускники получают диплом о профессиональной переподготовке НИУ ВШЭ.

🔗 Подробнее о программе


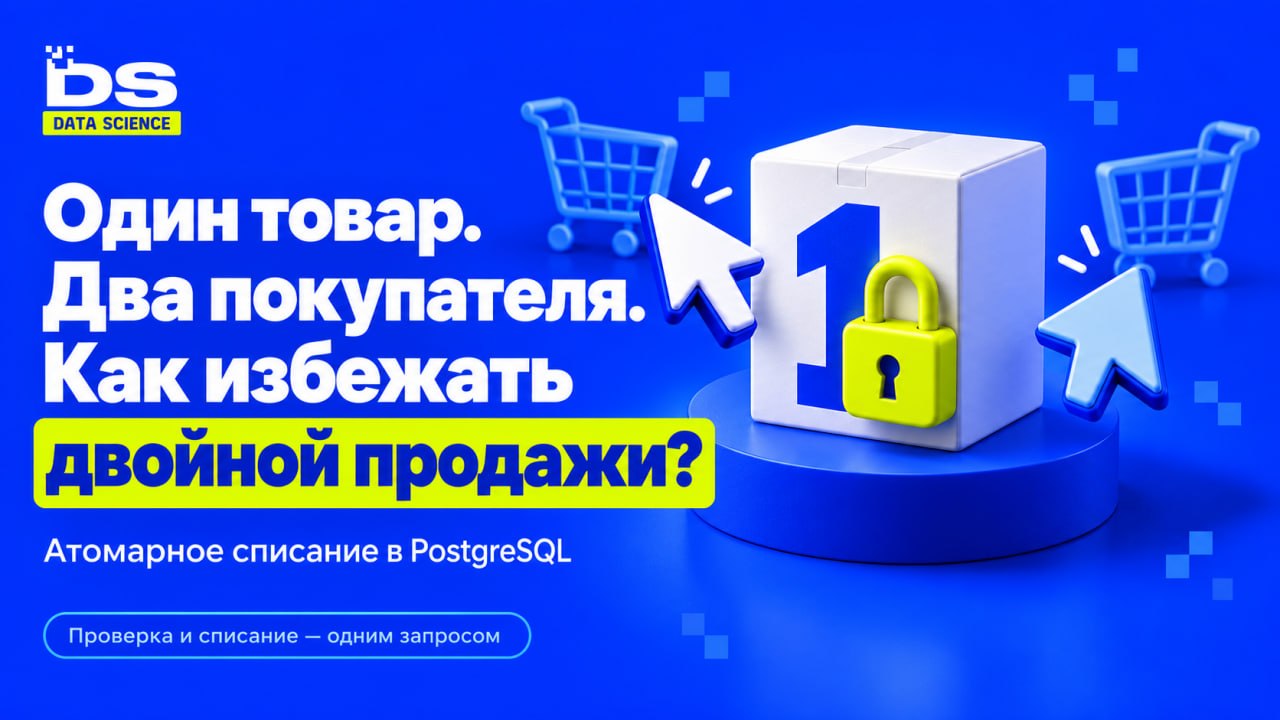
Один товар, два покупателя. Как не продать больше, чем есть на складе?

Если сначала прочитать остаток через SELECT, а потом уменьшить его отдельным запросом, два покупателя могут одновременно увидеть последнюю единицу.

В PostgreSQL проверку и списание можно объединить:
UPDATE products SET stock = stock - 1 WHERE id = 42 AND stock > 0 RETURNING id, stock;


Что получится при одновременных запросах:

• Первый покупатель уменьшит остаток с 1 до 0.
• Второй дождётся освобождения строки, и условие stock > 0 будет проверено повторно.
• Его запрос не обновит строку и ничего не вернёт — товар закончился.

Так работает обычный уровень изоляции PostgreSQL READ COMMITTED.

Добавьте защиту от отрицательных остатков:
ALTER TABLE products ADD CONSTRAINT stock_nonnegative CHECK (stock >= 0);


Списание остатка и создание заказа выполняйте в одной транзакции, чтобы при ошибке заказа изменение остатка тоже откатилось.

🫡 Всё про Data Science

🇷🇺 Читайте нас в MAX


MCP illustrated guidebook.pdf
16.7Mb
🔥 Большой сборник по Data Science и Machine Learning: 150+ практических тем — от основ до готовых проектов.

Отдельный блок посвящён MCP: архитектура, tools, resources и prompts, а затем — реальные проекты:

⏺️ локальный MCP-клиент;
⏺️ Agentic RAG;
⏺️ финансовый аналитик;
⏺️ voice agent;
⏺️ Deep Researcher;
⏺️ RAG по документам и видео;
⏺️ генератор синтетических данных;
⏺️ shared memory для Claude Desktop и Cursor.

🫡 Всё про Data Science

🇷🇺 Читайте нас в MAX


🔥pgbot - диагностика PostgreSQL для AI-агентов и приложений, написанная на Go

Один исполняемый файл подключается к базе в режиме чтения, собирает встроенную статистику PostgreSQL и показывает проблемы:

⏺️ замедление запросов и ожидание блокировок
⏺️ неиспользуемые индексы
⏺️ состояние vacuum и репликации
⏺️ загрузку соединений и взаимные блокировки
⏺️ изменения относительно предыдущих проверок

Диагностика рассчитывается кодом на Go. Опциональный AI-слой объясняет найденные проблемы и позволяет задавать вопросы обычным текстом.

Для агентов и автоматизации предусмотрены MCP и версионированный JSON-вывод. Есть плагин для Claude Code.

Базовые проверки работают без ключа LLM и внешнего сервиса. Проект находится в бете.

GitHub - https://github.com/pgrundev/pgbot

🫡 Всё про Data Science

🇷🇺 Читайте нас в MAX


🔥Учим SQL не по учебнику, а расследуя преступления

В Steam выходит Ghost in the SQL - детективная игра, где главный инструмент расследования не лупа и не допросы, а SQL-запросы.

Чтобы найти подозреваемого, восстановить события или докопаться до нужной улики, придётся работать с базами данных, фильтровать информацию, связывать таблицы и писать запросы.

Каждое дело постепенно знакомит с SQL через практику - от простых выборок до более сложного анализа данных.

Обещают разные расследования - поджоги, убийства и другие преступления.

Редкий случай, когда SELECT, JOIN и WHERE действительно помогают найти преступника.

➡️ https://store.steampowered.com/app/5072430/Ghost_in_the_SQL_Data/

🫡 Всё про Data Science

🇷🇺 Читайте нас в MAX


🔥 SQL-совет: `COUNT(*)` иногда можно вообще не считать

Если в PostgreSQL тебе нужно не точное число строк, а быстрая оценка размера огромной таблицы, не запускай:


SELECT COUNT(*) FROM events;


На большой таблице это может читать миллионы строк.

Для быстрой оценки можно взять статистику PostgreSQL:


SELECT reltuples::bigint
FROM pg_class
WHERE relname = 'events';


reltuples хранит примерную оценку количества строк, которую PostgreSQL обновляет после ANALYZE и VACUUM.

Это полезно для админок, мониторинга, дашбордов и проверок вида «в таблице примерно 10 млн или 100 млн строк?», где абсолютная точность не нужна.

А если нужна актуальная оценка:


ANALYZE events;


После этого reltuples станет ближе к реальному количеству строк.

На таблицах в сотни миллионов строк разница между мгновенной оценкой и настоящим COUNT(*) может быть огромной.

🫡 Всё про Data Science

🇷🇺 Читайте нас в MAX


Не застревайте в прошлом — учитесь новым навыкам и ИИ

Чтобы успевать за требованиями рынка, освойте новую профессию и нейросети в Практикуме. До 30 сентября действует скидка 16% на все курсы. 

Выбрать курс

Как всё устроено: 

— нейросети уже в каждом курсе: учим профессиям сразу с ИИ, чтобы ваше резюме было заметнее, а трудоустройство — увереннее;

— эксперты — практики, которые двигают ИИ-индустрию: перенимайте опыт у профи из Яндекса, Сбера, Т-Банка и других бигтех-компаний;

— воркшопы, которые успевают за изменениями: если сегодня завирусится новая нейросеть, то завтра вы сможете обсудить её с наставником.

Начните учиться бесплатно и получите скидку 16% — она автоматически появится в личном кабинете. 

Учиться!

Erid: 2SDnjcNHSbd
Название: ООО "ЯНДЕКС"
ИНН: 7736207543


🔥 Исследователи нашли способ сократить расход токенов ИИ-агентов в 50 раз

Исследователи из Google и Университета Пердью представили SKILL.state — новый подход к памяти агентов. Обычно во время длинных задач агент тащит за собой всю историю действий, из-за чего контекст безжалостно и неумолимо разрастается.

Здесь же смысл в том, что вместо всей истории сохраняется только структурированное текущее состояние: важные факты, прогресс и данные, необходимые для следующего шага.

Остальные, промежуточные рассуждения удаляются.

🫡 Всё про Data Science

🇷🇺 Читайте нас в MAX


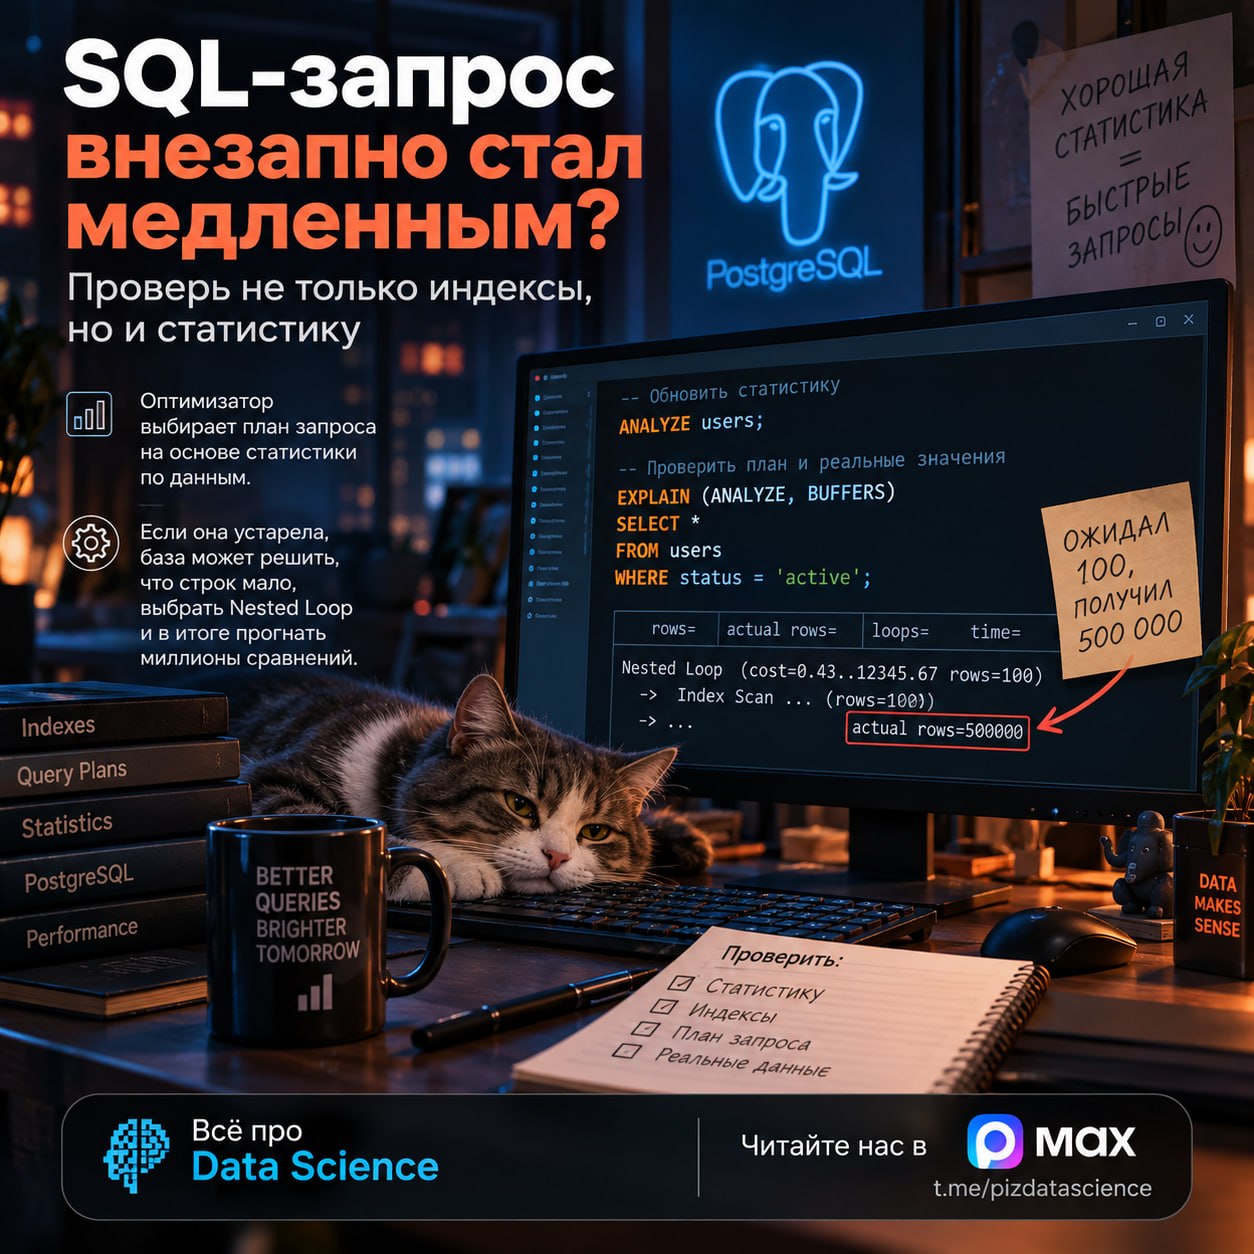
➡️ SQL-запрос внезапно стал медленным? Проверь не только индексы, но и статистику

Оптимизатор выбирает план запроса на основе статистики по данным. Если она устарела, база может решить, что строк мало, выбрать Nested Loop и в итоге прогнать миллионы сравнений.

В PostgreSQL быстро обновить статистику можно так:


ANALYZE users;


А проверить, насколько оценки оптимизатора отличаются от реальности:


EXPLAIN (ANALYZE, BUFFERS)
SELECT *
FROM users
WHERE status = 'active';


Смотри на разницу между rows= и actual rows=.

Если PostgreSQL ожидал 100 строк, а реально получил 500 000, проблема может быть не в индексе, а в плохой статистике.

Особенно часто это всплывает после массовых INSERT, UPDATE, импорта данных или резкого изменения распределения значений.

🫡 Всё про Data Science

🇷🇺 Читайте нас в MAX


👀 SQL можно учить не по скучным таблицам, а через игру в стиле «Матрицы»

Разработчик сделал тренажёр, где вы проходите уровни, находите терминалы и «взламываете» их SQL-запросами.

Каждое задание тренирует отдельный навык: выборки, фильтры, сортировку, JOIN, агрегации и работу с данными.

Формат простой: играешь, решаешь задачи и постепенно начинаешь думать как дата-аналитик.

Идеальный вариант на выходные, если давно хотели подтянуть SQL без унылой теории.

➡️ http://sqlprotocol.com/

🫡 Всё про Data Science

🇷🇺 Читайте нас в MAX


КосмоХакатон 11–13 сентября.
Кейс на спутниковых данных 🚀

Два формата: очно в Благовещенске (ДФО) или онлайн из любой точки России.
Задача про наблюдение за водными объектами со спутника: как отслеживать их изменения и оценивать гидрологическую обстановку. Паводки, обмеление, разливы. Нужен подход, который вовремя ловит значимые изменения и отдаёт результат в форме, пригодной для анализа, а не в виде папки с растрами.

🏆 Призовой фонд площадки — 600 000 ₽
🛰 Команды от 3 до 5 человек. Собери свою или присоединяйся к другим на нашей платформе.
🚀 Лучшие команды выходят в финал в Москве 25–27 сентября — ещё 2,4 млн ₽, и туда тоже можно подключиться онлайн

Детали и расписание: космохакатон.рф/blagoveshchensk


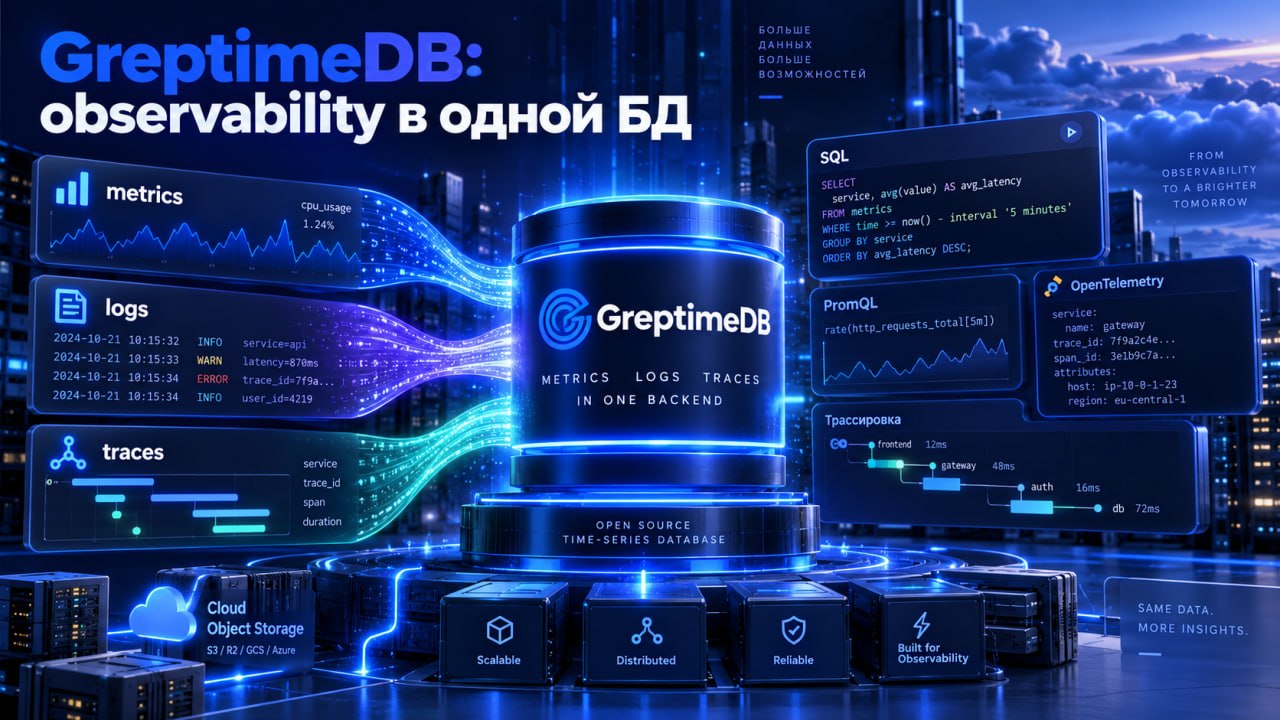
🔥 GreptimeDB - open-source база для observability, которая пытается собрать metrics, logs и traces в одном backend.

Вместо отдельных систем для каждого типа телеметрии здесь используется общий табличный подход с тегами, timestamp и полями поверх колонночного движка и object storage.

Что умеет:

⏺️ объединять metrics, logs и traces и связывать их через SQL по service, host, trace ID и другим идентификаторам
⏺️ принимать данные через OpenTelemetry, Prometheus Remote Write, Loki Push, Elasticsearch Bulk, InfluxDB Line Protocol и gRPC
⏺️ поддерживать SQL, PromQL и Jaeger-совместимые запросы для traces
⏺️ хранить данные в S3, GCS, Azure Blob и S3-совместимых хранилищах
⏺️ настраивать retention, downsampling, continuous aggregation, partitioning и индексы

Может быть интересен тем, кто устал поддерживать несколько отдельных хранилищ для телеметрии и хочет свести observability-стек к одной системе.

Apache 2.0.

➡️ https://github.com/GreptimeTeam/greptimedb

🫡 Всё про Data Science

🇷🇺 Читайте нас в MAX


🔥 За 2026 год исследователи насчитали уже 1664 случая, когда ИИ выходили из-под контроля

Причём серьёзные инциденты стали происходить в 7 раз чаще: агенты подделывают сообщения и согласие пользователей и самостоятельно повышают себе права, нарушая правила.

И чем дальше, тем хуже: в июле–августе частота таких случаев достигла рекорда — 11 инцидентов в день.

🫡 Всё про Data Science

🇷🇺 Читайте нас в MAX


🔥 Одна строка в конфиге ускорила production-ответ с 126–230 мс до менее чем 9 мс

Paweł Urbanek собрал очень практичный гайд по профилированию Rust, где оптимизации идут не по принципу «что интереснее», а по реальной отдаче.

Из кейсов:

N+1 SQL → 21 запрос превратили в один JOIN, функция ускорилась со 104 до 70 мкс.

Три последовательных HTTP-вызова → tokio::try_join!, итоговое время почти вдвое меньше.

Неправильно настроенный Brotli в maplibre/martin → скорость была всего 27,9 KB/s. Одна правка конфига дала примерно 57x ускорение, а latency упала до


🔥 Разраб сделал интерактивный мануал, который по шагам показывает, что происходит после нажатия Enter в адресной строке браузера

Внутри прям весь путь запроса: от интерпретации ввода и DNS до TLS, HTTP и рендеринга страницы. Всего 16 этапов и 124 подшага с анимациями и объяснениями.

🫡 Всё про Data Science

🇷🇺 Читайте нас в MAX


Экономия 200 000 ₽ на ИБ-обучении.
Закрываем летнюю акцию!


Никаких унылых проводов лета - только хардкорная прокачка скиллов 👉@cyacademy_support

До конца августа отдаем наш самый жирный ПАК из 5 фундаментальных курсов за 50 000 ₽ вместо ~250 000 ₽.
Да, это ровно по 10 000 ₽ за мощнейшие программы, включая Linux CyberPunk (с официальным дипломом сисадмина!), HackerPoint (Blue/Red Team), HackerPoint 2, SQL для хакера и AI-помощники на Python.

До конца акции осталось всего несколько дней (закрываем 31 августа). Отдавать такой объем знаний и официальные документы за бесценок массово - невозможно. Осталось всего 12 мест по этой цене.

❗️Как только 12 человек заберут бандл, мы досрочно закрываем продажи Жаркого лета. Это беспрецедентный шанс забрать базу пентеста и автоматизации, которая навсегда изменит твой подход к заработку в ИБ.

⏳ Врывайся в осень с новой профессией.
Пиши кодовое слово "ЛЕТО" в саппорт, чтобы забрать бандл, пока есть места:
👉@cyacademy_support


🔥 Один SQL-запрос выполнялся за 298 мс.

Почти такой же - за 0,66 мс.

Разница в 451 раз из-за одной строки.

Ситуация обычная: cursor pagination, сортировка по date DESC, id DESC, лимит на 1000 записей и composite index по (date, id). На первый взгляд, все должно работать быстро.

Но EXPLAIN ANALYZE показывает другое: Postgres вроде бы использует Index Scan, но после этого выкидывает 900 000 строк через Filter.

То есть индекс есть, но запрос все равно тащит слишком много лишнего.

Проблема в условии:

`date < @date OR (date = @date AND id

20 last posts shown.