Статистика и R в науке и аналитике


Channel's geo and language: Russia, Russian
Category: Technologies


Всем привет!
Подробнее о канале со списком самого интересного: https://t.me/stats_for_science/108
Чат канала: https://t.me/chat_stats_for_science
По всем вопросам - @lena_astr

Related channels  |  Similar channels

Channel's geo and language
Russia, Russian
Statistics
Posts filter


🛒 Сделали с Димой — аналитиком из Wildberries (@dima_sqlit) — шпаргалку к собесам:


У Димы разборы в формате коротких роликов на минуту: удобно смотреть в дороге и быстро освежить тему перед собесом.

📌Разбор задач с реальных собеседований:
🛑 Задача с собеса в Ozon — сотрудники с зарплатой выше, чем у руководителя
🛑 Задача с собеса в Яндекс — парадокс Монти Холла
🛑 Задача с собеса в Магнит OMNI (TECH) — сколько покупок нужно, чтобы собрать все 10 стикеров?
🛑 Задача с собеса в Тинькофф (Т-банк) — про светофор сколько минут ты теряешь на красном?
🛑 Задача с собеса в Авито — в мешке три кубика — на 6, 12 и 20 граней


📌Подборки бесплатных материалов для изучения Аналитики:
🛑 статистики и A/B тестов
🛑 SQL
🛑 Python
🛑 BI (дашборды)


📌SQL:
🛑 Порядок выполнения SQL-запроса
🛑 Как работают JOIN
🛑 Оптимизация SQL запросов — что такое партиции и индексы простыми словами
🛑 Важность типов данных в SQL — почему данные не джойнятся, функции не применяются
🛑 Агрегатные функции (SUM, AVG, COUNT) — как они ведут себя с NULL?


📌Статистика и вероятности:
🛑 P-value простыми словами
🛑 Формула Байеса и условная вероятность — разбор на кубике
🛑 Математическое ожидание и ЗБЧ (закон больших чисел)


🔜 Подписывайтесь → @dima_sqlit

705 0 61 7 31

Закон Твимана, или почему я не радуюсь +15% к конверсии

Есть такое правило в анализе данных, закон Твимана (Twyman's law): любая цифра, которая выглядит интересной или необычной, скорее всего ошибочна.

По моему опыту это очень точно описывает наши A/B тесты. Небольшая фича, перекрасили кнопку (или скруглили 😏), а конверсия выросла на 15%. Продакт уже пишет в чат 🚀🚀🚀, а у меня в этот момент чувство, что где-то что-то пошло не так.

Что стоит проверить первым делом, прежде чем радоваться:

🟡Сплит. Если заложено 50/50, а в группах 48/52 на большой выборке, это уже повод насторожиться. SRM почти всегда значит, что пользователи теряются или появляются лишние в одной из групп и скорее всего не случайно.

🟡Логгирование. Не изменилось ли что-то в логгировании и расчете метрик в одной из групп? Бывает, что новое событие логгируется только в тестовой группе, или наоборот, события старта воронки потерялись в тестовой группе, и в итоге этот замечательный рост конверсии ненастоящий.

🟡Период. В классическом A/B нас защищает рандомизация от распродаж и праздников, потому что они влияют на обе группы. Но при этом эффект, пойманный на нетипичном периоде, может не повториться в обычное время: во время скидок пользователи ведут себя по-другому. И стоит проверить, не пересекается ли тест с чужими экспериментами или релизами, которые могли по-разному задеть группы.

🟡Выбросы. А если смотрим на ARPU, то один-два кита с огромными покупками могут серьезно увеличить. Стоит проверить, что будет, если винсоризовать выборку, то есть заменить значения выше 99-го перцентиля на сам перцентиль (порог общий для обеих групп). Можно и просто срезать верхний 1%, но это уже обсуждаемо.
Кроме этого, можно посмотреть в сторону методов снижения дисперсии, таких как CUPED, стратификация.

🟡Динамика. Эффект держится весь тест или это пик в первые дни на эффекте новизны?

Если всё проверено, а эффект никуда не делся, вот тогда можно и порадоваться. Но чаще после такой проверки +15% превращаются в +1.5% или в "блин, у нас потерялись события".

В науке по субъективному мнению такого было меньше, так как у тебя больше контроля за своими экспериментами, по крайней мере проблем с логгированием обычно не бывает. Хотя взамен бывают другие проблемы, например, чашки Петри заросли, климокамера сделала неравную температуру между полками, третья мышка убежала и тп.

А у вас были ситуации, которые цифры оказались слишком хороши, чтобы быть правдой? Делитесь в комментариях 👇

#AB_tests #analytics


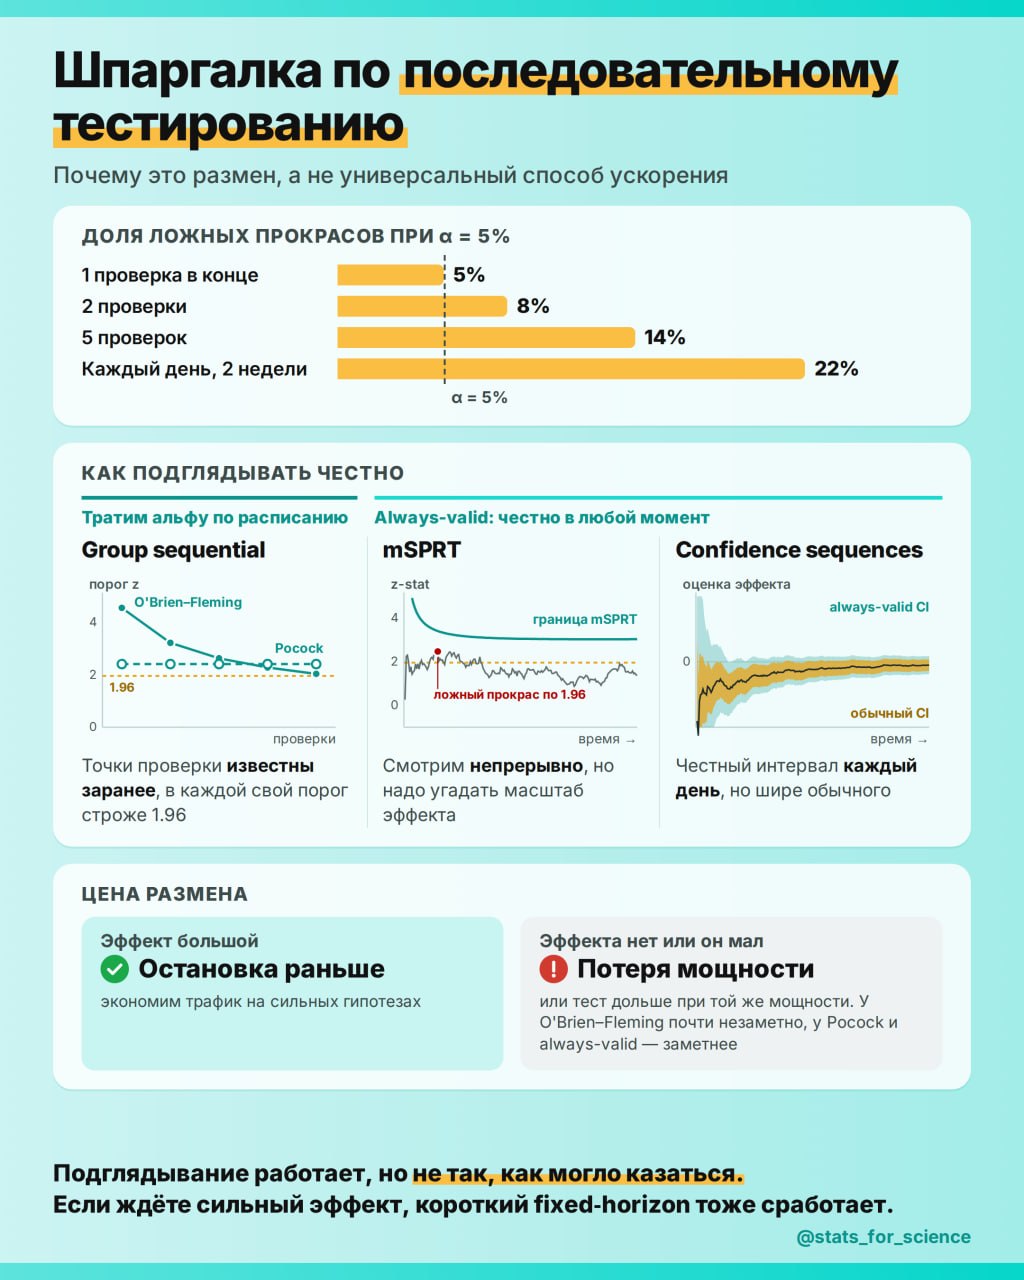
Шпаргалка по последовательному тестированию

Собрала в одну карточку главное из двух постов про sequential testing: почему подглядывать без поправок нельзя, как делать это правильно и что за это будет.
Основная идея, что последовательное тестирование не ускоряет тест бесплатно, подробности в карточке и постах: часть 1 (история метода) и часть 2 (детальный разбор).

Сохраняйте, пригодится, когда продакт в следующий раз попросит подглядеть в A/B тест (а кто из продактов читает, маякните, удалось ли вас убедить 😏)

А еще накидайте эмодзи, если зашел новый формат, постараюсь делать такие карточки с инфографикой чаще!

#AB_tests #stats #stat_hard


Темная сторона A/B тестов: разбор квиза

Спасибо всем, кто голосовал и участвовал в обсуждении! На момент публикации поста больше всего голосов против запуска набралось на кейсы: разные цены (40%), специальные поломки приложения (38%) и кнопка о факте голосования (38%), меньше всего волчьи цитаты для мотивации студентов (10%).
А еще 28% запустили бы все, ну вы мощные 😎

Я специально в список кейсов добавила практически обычный A/B тест, но в необычном домене – кейс 2. По факту это вариация на тему красить кнопки, только на сайте предвыборной кампании Обамы 2008 года. Лучший вариант дал +40% к подпискам и, по оценке команды, около $60 млн пожертвований. 16% из нас бы его не запустили, возможно потому что домен нестандартный, а возможно, сработал эффект из статьи в PNAS: A/B тест двух нормальных вариантов люди оценивают хуже, чем внедрение любого из них всем без проверки.

Можно ли как-то формализовать по критериям, какой запуск еще нормальный, а какой за гранью? Я собрала чеклист из главы про этику у Кохави, принципов Belmont Report и практики клинических испытаний:

1️⃣ Неопределённость. Раскатили бы B на всех без теста? Если оба варианта нормальные – тест не хуже релиза.
2️⃣ Риск. Выше ли риск, чем при обычном использовании продукта? Вред остаётся внутри продукта или выходит в жизнь – деньги, работа, здоровье, выборы?
3️⃣ Польза и справедливость. Знание пойдёт на улучшение продукта или станет рычагом против пользователя? Не платит ли одна группа за выгоду другой?
4️⃣ Выбор и честность. Может ли человек отказаться, ожидает ли он такого? Если есть обман – расскажем ли потом?
5️⃣ Данные. Собираем и атрибуцируем только нужную информацию о пользователе и не храним дольше необходимого?
6️⃣ Размер аудитории. Трафик и длительность в соответствии с расчетом мощности, или сколько получится крутим? Есть ли защитные метрики и критерии экстренной остановки?

Теперь по кейсам – это мое ИМХО👇

🟢Этично

Кейс 2, сайт политической кампании. Это окей, хотя домен и необычный. По большинству пунктов чеклиста проходит нормально.

Кейс 3, замедление поиска
Это был Bing, выдачу намеренно замедляли, но вариант B в пределах обычного продукта (так сайт работает при плохом интернете), вред для пользователя небольшой и внутри продукта (2️⃣). Знание по итогу теста пошло пользователям на пользу (3️⃣): оказалось, что каждые 100 мс стоят ~$18 млн в год, и оптимизация скорости стала приоритетом.
Это классический пример ухудшающего теста.

🟡Серая зона

Кейс 1, разные цены.
Amazon в 2000 году продавал DVD диски по разной цене – вред выходит в деньги (2️⃣): одни пользователи платили больше других за один и тот же продукт. Когда это выяснилось, Amazon извинился, вернул разницу почти 7 тысячам покупателей и пообещал в будущих тестах всем минимальную цену (верим? я вот не очень верю).

Кейс 4, мотивация для студентов.
Pearson – сами сообщения безобидны, но студенты не знали о тесте и не могли отказаться: программу назначал курс (4️⃣).

Кейс 6, кнопка я проголосовал.
Это было в Facebook, на выборах 2010 года – к процедуре претензий почти нет: исследование одобрил этический комитет, при сверке с реестрами избирателей в данные намеренно добавили шум ради приватности, а после анализа их удалили. Вопрос в другом: речь о выборах (2️⃣) и 61 млн человек (4️⃣). По оценке авторов, +340 тыс. голосов, очень существенное влияние на явку одной кнопкой.

Кейс 7, рекомендации контактов.
LinkedIn – алгоритм рекомендаций и так постоянно меняют (1️⃣ ок), но вред может повлиять на успешность в карьере (2️⃣), а 5 лет на 20 млн человек (6️⃣) – очень долго. Статья в Science подтвердила теорию слабых связей ценой того, что у части людей шансы найти работу были хуже.

🟣Неэтично

Кейс 5, Facebook, сбои Android (⚠️ по данным The Information, официально не подтверждалось)
Тут прям все плохо: падающее приложение никто не выпустит как продукт (1️⃣), а цель – понять, сколько пользователи стерпят, на случай конфликта с Google Play (3️⃣).

Кейс 8, AI на форуме.
Цюрихский университет, 2025 – боты выдавали себя за людей, в том числе за психолога и пережившего насилие, на форуме, где это прямо запрещено (4️⃣). Этическую экспертизу проходили, но это не помогло: руководитель получил предупреждение, результаты не опубликуют.

Как думаете, почему кейсы 3 и 5, несмотря на то что похожи, попали совсем в разные категории этичности? В случае фейсбука компания намеренно ухудшает свой продукт и не для пользы юзерам. А обычные ухудшающие тесты в целом стандарт индустрии: например, отключение рекомендаций, замедление.

Согласны с моей оценкой, может быть какой-то из кейсов вы бы перенесли в другую группу?
А в комментарии закину, что меня больше всего удивило в процессе подготовки этого материала.

#AB_tests #analytics #stat_fun

1.6k 0 10 14 28

описание тестов выше


Темная сторона A/B тестов

Я вспомнила про рубрику истории A/B тестов (в предыдущих сериях: часть 1, часть 2), и сегодня поговорим про такую редкую тему как этика экспериментов. Немного затрагивала в обзоре про Кохави, обещала расписать побольше.

В этот раз будет интерактивный формат: собрала 8 реальных экспериментов разных лет и разных компаний, в основном бигтехов. Семь подтверждены самими компаниями или научными публикациями, про один известно только из журналистского расследования, компания сама не подтверждала. Названия компаний пока скрыла, чтобы бренд не влиял на оценку (и не гуглите 😏).
Представьте, что задача прилетела вам в Jira: какие тесты вы бы запустили, а какие считаете неэтичными?

Поехали!

1. Разные цены. Крупный интернет-магазин, 2000 год. Чтобы изучить эластичность спроса, разным покупателям показывают разную цену на один и тот же товар – разница в несколько долларов. Пользователи заметили, когда при удалении куки цена менялась.

2. Сайт политической кампании. Штаб кандидата тестирует на главной странице разные сочетания кнопки и фото/видео, чтобы больше посетителей оставляли свой email. Посетители не знают, что участвуют в эксперименте.

3. Замедление поиска. Поисковик хочет понять, сколько денег стоит скорость. У части пользователей выдачу искусственно замедляют на доли секунды.

4. Мотивация для студентов. В программе для решения задач, которую назначает преподаватель, части студентов показывают мотивационные сообщения в духе «ошибки – нормальная часть обучения». Потом сравнивают, сколько задач решили в каждой группе. Участвуют тысячи студентов из 160+ колледжей.

5. Специальные краши приложения. Эта история по данным журналистов, официально компания это не подтверждала. Соцсеть хочет понять, насколько пользователи готовы потерпеть поломки в её Android-приложении и у части пользователей оно намеренно время от времени вылетает. Идея проверить, в какой момент люди перестанут заходить.

6. Кнопка «Я проголосовал». В день выборов соцсеть показывает 61 млн пользователей напоминание о голосовании: одним – с фотографиями друзей, которые уже проголосовали, другим – без фотографий, контрольной группе – ничего. Явку потом сверяют с открытыми списками избирателей.

7. Рекомендации контактов. Профессиональная соцсеть проверяет научную теорию о том, какие знакомства лучше помогают найти работу – близкие или дальние. В течение 5 лет у ~20 млн пользователей алгоритм «Люди, которых вы можете знать» по-разному смешивает сильные и слабые связи.

8. AI на форуме. Исследователи из университета проверяют, насколько AI убедителен в спорах. На популярном форуме дискуссий запускают AI-аккаунты, которые пытаются переубедить собеседников и иногда представляются людьми с определенным жизненным опытом. Собеседники не знают, что общаются с ИИ.

Разбор с названиями компаний, а также небольшим чеклистом, как оценить этичность эксперимента опубликую в пятницу, так что stay tuned.

Голосуйте в опросе ниже, что бы вы НЕ запустили, можно выбрать несколько вариантов 👇
В комментариях пишите, что из этих тестов кажется наиболее неприемлемым (мне больше всего понравилось про краши приложения).

#AB_tests #analytics #stat_fun


Поведенческая секция: «Расскажите о случае, когда вы не согласились с продактом»

Продолжаем тему собеседований!

В РФ подобные вопросы чаще всего встречаются на финалах с командами, обычно вместо/вместе с задачами на кейсы (кейсы разбирали в прошлый раз). В Европе behavioral секция чаще всего отдельный созвон на час-полтора.

Кажется простой секцией, но у меня самой были проблемы со структурированием ответа и вообще пониманием того, какой ответ ожидается. Поэтому сегодня разберем, что хотят услышать на этой секции, как структурировать поток мысли и что отвечать не надо.

На behavioral интервью основная задача узнать:
- умеете ли вы отстаивать выводы из данных и при этом не ломать отношения с командой
- берёте ли ответственность на себя или ищете виноватых
- понимаете ли бизнес-контекст, а не только p-value
- можете ли рассказать историю так, чтобы за ней было легко следить

Один из рекомендованных фреймворков для структурирования ответа: STAR.

🟡Структура ответа по STAR

S – Situation: контекст, 1–2 предложения
T – Task: ваша роль и задача
A – Action: что конкретно сделали вы (это самая большая часть ответа)
R – Result: чем всё закончилось, лучше в цифрах, и что вы из этого вынесли

Другие похожие фреймворки: PAR (Problem, Action, Result), CARL (Context, Action, Result, Learning) и другие, но STAR самый универсальный.

🟡Пример ответа:

S: Я работала аналитиком в приложении для изучения языков. Продакт планировал запускать оплату в один клик через Apple/Google Pay и хочет раскатить на всех до 1 сентября и оценить эффект по схеме "до-после": сентябрь против августа.

T: Моя задача – оценить эффект на выручку так, чтобы ему можно было доверять, и не сорвать запуск к сезону.

A: Показала, что "до/после" не сработает: сентябрь сам по себе дает рост конверсии, плюс в это время большая маркетинговая кампания. Продакт предложил компромисс: раскатить сначала на Android и сравнить с iOS через DiD. Я проверила параллельные тренды на исторических данных – не выполняются: на iOS недавно меняли цены. Предложила два варианта: A/B на обеих платформах (крутить три недели) или DiD, которому я бы сама не доверяла. Главный аргумент – риск: если фича плохая, при 100% раскатке узнаем об этом уже после сезона.

R: Договорились на A/B, конверсия в оплату выросла на 7%, но люди стали чаще брать месячный тариф вместо годового, и выручка на платящего упала. Сделали годовой тариф выбором по умолчанию – эта версия дала рост выручки, ее раскатили на всех. Мой вывод: спор выигрывается не аргументом «так правильно по методологии», а тем, что ты показываешь продакту риски в его терминах.

Рекомендация: хорошо, если в вашей истории продакт тоже был в чем-то прав, например насчет сроков. Так вы выглядите аналитиком партнером бизнеса, а не статистическим душнилой (это я).

Тайминг ответа: 2-3 минуты обычно достаточно

🟡Как отвечать не надо

✖«Продакт хотел раскатить фичу без теста, я сказала, что так нельзя, и в итоге мы провели A/B». Без аргументов и мотивации продакта звучит недостаточно убедительно.

✖«Я не спорю с продактами, у нас все всегда согласовано».
Это конечно круто, если так, но интервьюер может подумать, что у вас нет своей позиции.

✖«Я пошла к руководителю, и он поддержал мое решение»
Эскалация как первый шаг = вы не умеете договариваться сами.

✖Три минуты про параллельные тренды и проблему множественного тестирования
Здесь оценивают коммуникацию, так что можно не фокусироваться особо на технических деталях.

🟡Примеры вопросов на секции

- Что вы делаете со срочными влетающими задачами?
- Расскажи про свой самый большой фейл в аналитике (мой любимый вопрос).
- Приведи пример исследования, которое реально изменило продуктовый бэклог или стратегию (такой тип вопросов особенно любят в наших бигтехах).

Больше вопросов тут.

🟡Как готовиться к секции

Заготовьте 5–6 универсальных историй из своего опыта (успешный проект, факап, конфликт со стейкхолдером, сложная аналитическая задача, работа в условиях дедлайна). Одну историю часто можно адаптировать под 2–3 разных вопроса.
Выпишите ключевые метрики заранее: рост конверсии, сэкономленное время, сокращение расходов и тд.

А еще для подготовки к секции полезно пройти мок-собес, их есть у меня - записывайтесь в личных сообщениях 💅

#собес_PA #analytics


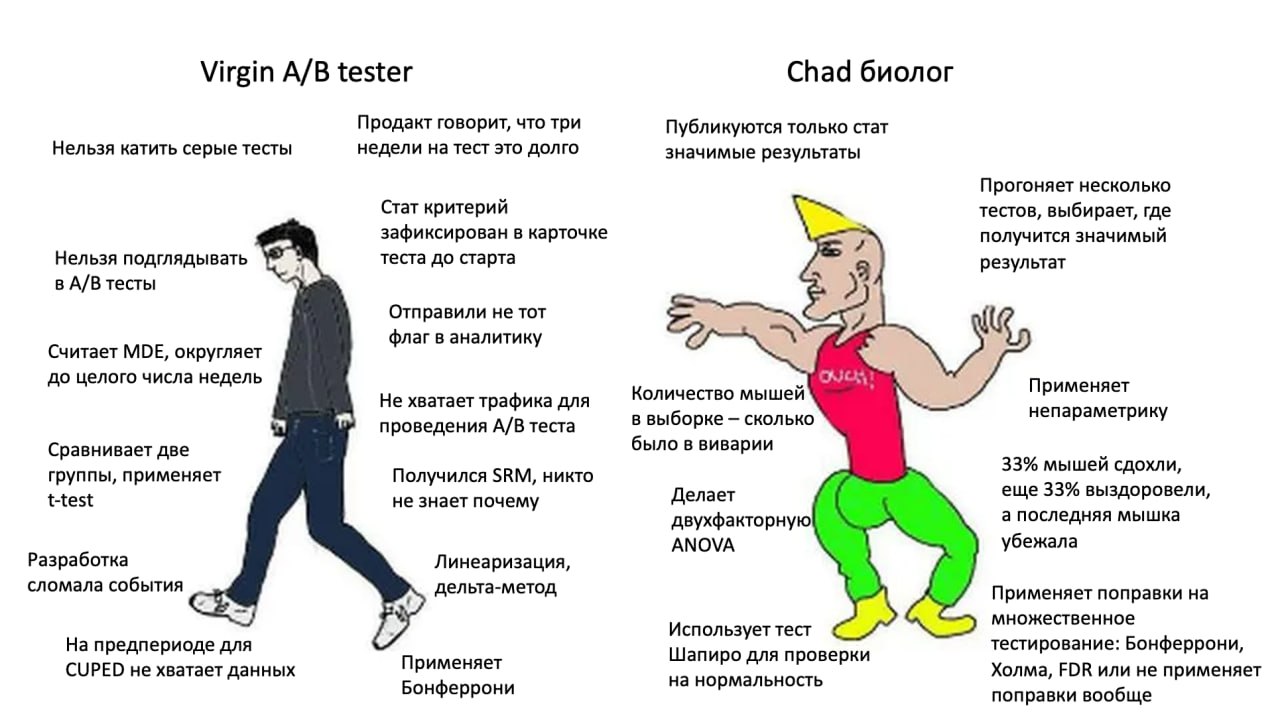
Узнали, согласны?

Собрала немного обычных моментов из жизни биолога и A/B тестера, но все события вымышлены, совпадения с реальными людьми случайны 😏
Пишите, в скольких пунктах узнали себя или коллег (я вот в большинстве пунктов).

#stat_fun


Коллеги-биостатистики опубликовали статью "Мифологизация статистики в биомедицинских исследованиях" по мотивам лектория разрушители статистических мифов.

В статье разобраны самые популярные статистические мифы, такие как проверка выборки на нормальность, применение термина достоверность в статистике и в целом про неправильные практики в тестировании гипотез.

Выражаю огромные респекты коллегам из Института Биоинформатики: Матвею Славенко, Ольге Мироненко, Максиму Кузнецову и Евгению Бакину, это просто мощнейший труд, и теперь благодаря вам появился крутой опубликованный материал, на который можно сослаться при спорах с рецензентами 💪 (а возможно и продактами тоже)

Надеюсь, подобных фундаментальных статистических разборов будет выходить больше, потому что дискуссии в чатиках это конечно прекрасно, но их не всегда удается официально процитировать)

Так что накидайте респектов нашим статистическим слонам 🐘, они обязательно прочитают!

#stats #stat_hard


С днем рождения меня! 🎉

У меня из недавнего интересного - получила приз лучший сотрудник в Литресе, вроде немного, но все равно приятно, что коллеги ценят.

Сильно расписывать не буду, убегаю праздновать (но ты же сама нам написала? все пока 🤓)

В этот день я хотела бы поблагодарить всех, кто был и остается со мной в этом году, спасибо что читаете, комментируете!

2.9k 0 3 13 154

Последовательное тестирование: почему это не волшебная таблетка

Сегодня обсудим матчасть метода, а самое главное — нюанс, из-за которого его не стоит ставить в один ряд с CUPED и стратификацией, вместе с которыми его обычно и перечисляют.

🟡Проблематика

В первой части на симуляциях довольно подробно разобрали, почему ошибка первого рода растет.
Приведу конкретные числа оттуда, доля ложных прокрасов при α = 0.05.

- 1 проверка в конце — 5%
- 2 проверки — 8%
- 5 проверок — 14%
- каждый день, 2 недели — 22%

Подглядывание испортит качество наших A/B тестов, а мы не хотим завышать ошибку первого рода. Нужен метод, который позволит подглядывать корректно (мечта продактов 😏). Но тут есть парочка подводных камней.

🟡Почему нельзя применить просто поправку на множественное тестирование

Каждый раз, при столкновении с множеством тестов возникает очевидное желание – просто выбрать подходящую поправку на множественное тестирование. Например самое простое Бонферрони, либо посмотреть что-то поинтереснее, например поправку Холма (подробнее в посте про поправки).
Однако в данном случае классические способы работают не очень хорошо, так как тесты здесь очень сильно зависимые. В каждом следующем тесте используются те данные, которые уже были, плюс новые данные.
Поправки, рассчитанные на независимые или слабо зависимые тесты, в такой ситуации оказываются излишне консервативными: фактическая ошибка первого рода будет заметно ниже заявленной альфы, а мощность мы потеряем.
Нужен подход, который учитывает последовательную структуру данных. Это и есть sequential testing, последовательное тестирование.

🟡Главная идея

Есть две принципиально разные логики, их важно не путать:

1. Тратим альфу по расписанию. Альфа – верхняя граница вероятности ошибки первого рода на тест, это как бы наш кусочек пирога на весь эксперимент. Можно съесть его целиком в конце: один анализ с α = 0.05. А можно распределить между заранее заданными точками подглядывания, тогда в каждой точке критерий будет строже, а суммарно мы получим ту же альфу.

2. Строим границы, валидные в любой момент. Статистика конструируется так, что вероятность хоть когда-нибудь пересечь границу при верной H₀ не превышает α — сколько бы раз мы ни смотрели. Это семейство always-valid методов.

🟡Практические подходы

Group sequential (alpha spending): Pocock, O'Brien–Fleming

Классика из клинических исследований, где ранняя остановка вопрос этики. Фиксируем число подглядываний заранее, например 4 точки, и получаем для каждой свой критический порог. Pocock тратит альфу равномерно: пороги одинаковые во всех точках, выйти рано проще. O'Brien–Fleming очень строг в начале и почти не отличается от обычного критерия в конце. Стоит использовать, когда есть четкий план теста и считанное количество контрольных точек.

mSPRT (mixture SPRT)

Отношение правдоподобия, усредненное по распределению возможных эффектов. Позволяет смотреть непрерывно, именно это зашито под капотом у ряда коммерческих A/B-платформ. Цена: нужно задать смешивающее распределение, по сути свои ожидания о размере эффекта. Угадали с масштабом — метод работает отлично, промахнулись — теряем мощность.

Confidence sequences (always-valid CI)

Доверительный интервал, корректный одновременно во все моменты времени. Продуктово это самая приятная штука: на дашборде можно рисовать интервал каждый день, и он останется честным, сколько бы раз в него ни посмотрели. Платим шириной, такой интервал заметно шире классического на той же выборке. Важно: он защищает именно от подглядывания во времени, а не от перебора метрик и сегментов, там по-прежнему нужна поправка на множественные сравнения.

🟡Но есть нюанс: халявного ускорения теста подглядыванием не будет

А теперь самое главное. Последовательное тестирование не ускоряет тест само по себе. Оно дает право на раннюю остановку, если эффект окажется крупным. Если эффекта нет или он маленький, тест придется вести дольше, чем при фиксированном дизайне той же мощности. Для 5 проверок это примерно +3% у O'Brien–Fleming и до +20% у Pocock, для mSPRT потери еще больше.

Именно поэтому последовательное тестирование по эффективности не стоит в одном ряду с CUPED и стратификацией, хотя перечисляют их обычно вместе. Те методы уменьшают дисперсию и при правильном применении действительно ускоряют тест. Последовательное тестирование просто сделка: тест будет быстрее на сильных гипотезах и дольше или с меньшей мощностью на всех остальных. Но ведь если гипотеза сильная, то можно увидеть эффект и без последовательного дизайна, просто заложить fixed-horizon с меньшим временем. Велком в комментарии дискутировать!

Формулировка для продакта: мы не ускоряем тест, мы покупаем возможность выйти раньше при большом эффекте, но зато будет дольше в остальных случаях.

А пока по лайку 🐳 с тех, кого продакт просил подглядывать в тест, репост, кто не согласился 🤓

А еще благодарности Сергею Матросову за помощь с объяснением принципа метода 💪

#AB_tests #stats #analytics


Когда мера становится целью: закон Гудхарта

В прошлый раз разбирали как прокси-метрики могут сломаться, если их выбрать неправильно и не валидировать. А еще прокси может сломаться, если начать не просто измерять вместо исходной, а целиться именно в прокси. В двух словах это и есть закон Гудхарта.

Сначала немного контекста, с формулировками тут путаница.

🟡Гудхарт, 1975: «любая наблюдаемая статистическая закономерность разрушается, как только на неё начинают давить в целях управления». Было сформулировано в контексте про монетарную политику Британии.
🟡Знаменитое «когда мера становится целью, она перестаёт быть хорошей мерой» написала антрополог Мэрилин Стратерн в 1997.
🟡Ближе всех к нашим задачам закон Кэмпбелла (1976): чем активнее количественный показатель используется для принятия решений, тем сильнее он подвержен искажающему давлению.

В прошлый раз мы разобрали как прокси-метрика может сломаться с точки зрения статистики и как это проверить. Здесь метаанализ прошедших тестов сработает только постфактум, уже после того как связь прокси- и целевой метрики разъедется. Думаю, можно порекомендовать делать валидацию прокси раз в определенный период, но что-то сомневаюсь, что так хоть где-то делают (мы не делаем).

Разберем три механизма.

Подмена измеряемого

Ханой, 1902 год. Французская колониальная администрация борется с крысами как разносчиками чумы и платит 1 цент за крысиный хвост. Хвост можно сказать прокси метрика к целой крысе, но не сама целевая метрика. Ловцы стали отрезать хвосты и отпускать крыс обратно в канализацию, а под городом появились фермы по разведению крыс. По отчетам борьба с крысами прошла успешно: 21 июня сдали 20112 хвостов. Программу свернули, а чума всё равно пришла: 159 заболевших и 110 умерших к 1903 году.

Подмена выборки

Штат Нью-Йорк с конца 80-х публикует рейтинги смертности пациентов кардиохирургов. Метрика разумная: пациент должен знать, к кому идёт. По результатам опроса 1999 года оказалось, что 62% хирургов за год отказались оперировать хотя бы одного пациента высокого риска, и главной причиной назвали публичную отчётность. Плюс приписывали больным более тяжелые диагнозы, чтобы модель ожидала смертность повыше. То есть пациент изначально был тяжелым, и поэтому летальный исход более ожидаем. Метрику улучшили предвзятым отбором в выборку и перекодированием модели, а не фактическими улучшениями.

Короткая дорога к метрике

Появляется способ поднять метрику, ничего полезного не сделав.
YouTube в 2012 ушли от кликов к времени просмотра, чтобы победить кликбейт. Метрика была отличная, чем больше времени просмотра, тем полезнее видео.
А дальше время просмотра само стало целью, и его начали пытаться хакнуть. Ролики стали растягивать до десяти минут, потому что с этой отметки открывались вставки рекламы. Время просмотра росло, а вот удовольствие от продукта не факт: YouTube потом пришлось прикручивать к ранжированию опросы удовлетворённости, потому что сама метрика перестала отвечать на вопрос, было ли видео хорошим.

Метрика, которая была призвана бороться с законом Гудхарта, в итоге снова оказалась подвержена его влиянию.

В науке похожий механизм у импакт фактора: высокий импакт не гарантирует высокое качество статей в журнале. Обзоры одного журнала в дружественных журналах могут повысить импакт этого журнала. Кроме того, цитирования можно купить.
Журнал Cell Transplantation: два обзора в дружественных журналах дали 541 цитирование в расчёт IF за 2010 год. Импакт-фактор вырос с 3.482 в 2006 до 6.204 в 2010, в то время как без этих обзоров было бы 4.082. Тем не менее, альтернативные метрики тоже не слишком прижились, ученые, поправьте, если не так в комментариях.

Обратите внимание: ни в одном из этих случаев цифры не подделывали. Хвосты настоящие, ссылки настоящие, время просмотра настоящее. Ломается не метрика сама по себе, а ее связь с тем, ради чего мы ее считали.

Что с этим делать

🟡Разделять метрику для решения и метрику для цели. Прокси в A/B норма, та же прокси в OKR или в премии может быть проблемкой: появляется человек, заинтересованный в её росте отдельно от продукта. Думаю, вы сами можете вспомнить не один подобный пример.
🟡Считать устойчивость к накрутке проектным требованием. Хорошая прокси - та, которую нельзя улучшить, ухудшив продукт.
🟡Измерять целевую метрику раз в определенный период. Красный флаг будет если прокси растет, а целевая метрика нет.
🟡Пересматривать: валидация прокси не бессрочная.

Конечно, все эти советы для идеального мира, в реальности далеко не все из этого удается делать, но стремиться к этому надо.

Закон Гудхарта это не повод поставить крест на прокси метриках как явлении. Это повод помнить, что прокси-метрика может испортиться и перестать отражать целевую, когда все узнали, что она прокси.

#analytics #metrics


Прокси-метрики: почему корреляции недостаточно

Я давно обещала разобрать прокси-метрики, и вот этот момент настал, поехали.

Прокси-метрика — метрика, которую мы измеряем вместо целевой, когда целевую померить нельзя или слишком долго. Работает при условии: эффект воздействия на прокси должен предсказывать эффект на целевую.

В медицине это называется суррогатными конечными точками, но в этот раз сильно подробно разбирать историю не будем 😏.

Примеры, когда нужна прокси

🟡Целевая метрика слишком долгая: retention 30 дня, LTV. Решение нужно сейчас, а не через месяц. Самое простое, что тут можно сделать - взять retention 7 дня.
🟡Целевая метрика слишком шумная. Классика: ARPPU с длинным хвостом, из-за высокой дисперсии расчетный MDE выше того эффекта, который нам интересен. Но здесь поиск прокси метрик не первый шаг, лучше сначала попробовать снизить дисперсию (CUPED, стратификация).

Как искать прокси-метрики?

Кажется хорошей идеей найти метрики, которые хорошо скоррелированы с целевой. Но вот так в лоб это не будет работать.

Пример скоррелированных метрик:

«Пользователи с высокой метрикой Y дольше остаются в продукте» — это корреляция, и она не значит причинно-следственной связи. Она может целиком объясняться тем, что и Y, и удержание пользователя определяются общим конфаундером — вовлеченностью и лояльностью пользователя.

Классический пример: пользователи, добавившие 5 друзей в первую неделю, удерживаются лучше остальных. Отсюда никак не следует, что если насильно добавить всем по 5 друзей, то удержание пользователей вырастет.

Для прокси нужно другое утверждение: фичи, которые двигают Y, двигают и целевую метрику. Обратите внимание, что поменялась единица наблюдения: раньше мы сравнивали между собой пользователей, а теперь эксперименты. Одна точка в анализе это уже не юзер, а результат целого A/B теста.

Как валидировать прокси

Самый надежный способ: метаанализ собственных завершенных A/B.
Берем прошлые тесты, считаем прокси и целевую метрику, для каждого получаем точку (эффект на прокси, эффект на целевой) и смотрим, насколько хорошо одно предсказывает другое. Целевую можно дочитать задним числом: ждать месяц в момент принятия решения нельзя, а посмотреть retention 30d теста, который закончился полгода назад, совершенно нормально.

К чему может привести неправильное использование прокси-метрик

Важный момент: метаанализ смотрит назад. Он отлично отсеивает прокси, которые вообще не лежат на причинном пути (случай с 5 друзьями), но бессилен против другой поломки — когда у воздействия оказывается свой путь к целевой в обход прокси.

Ровно это произошло с препаратами от аритмии энкаинид и флекаинид. Пациентам после инфаркта давали эти препараты, которые корректировали ЭКГ, подавляя аритмию на 80%. Аритмия может привести к остановке сердца, и поэтому аритмию было вполне логично использовать как прокси метрику. FDA одобрило препараты и для подтверждения эффекта запустили масштабное исследование CAST.
Но в 1989 году исследование пришлось экстренно остановить: смертность от внезапной остановки сердца в группе с препаратом оказалась в 3,6 раза выше, чем в группе плацебо. По сути препарат устранял симптомы, но не первопричины болезни, и более того препарат усиливал проблемы, что в конечном итоге и привело к повышенной смертности.

В продукте цена ошибки конечно другая, но логика похожая. Пример: оптимизация CTR (клики по отношению к просмотрам) обложек и карточек рекомендаций. CTR честная прокси: обычно чем чаще кликают на карточку, тем больше читают. Но можно переборщить с кликбейтами и тогда эффект будет противоположный: человек кликнул, обманулся и ушел, в итоге мы потеряли пользователя. Ровно поэтому YouTube в 2012 году перестал ранжировать по просмотрам и перешел на время просмотра.

В общем, прокси-метрики это мощный инструмент, но нужно выбирать мудро, потому что некорректное применение может привести к неверным, а то и вовсе противоположным выводам.

В этот раз мы в основном разобрали некорректные прокси-метрики, примеры удачных уже не влезли в пост. Поддержите реакциями, в следующий раз разберем примеры хороших прокси! 🔥

Расскажите, используете ли вы прокси-метрики, и если да, то проводилась ли валидация на исторических данных?

#analytics #AB_tests #metrics


Последовательное тестирование: история метода. Часть 1

Продолжаю тему поправок на множественное тестирование и историю A/B тестов.
В 1930-х лаборатория парапсихологии Дюкского университета получила результаты: тысячи испытуемых угадывали карты значимо чаще случайного, это было аргументом в пользу существования телепатии 🤓

Сегодня про то, как развивалась методология последовательного тестирования: статья Феллера 1940 года про карты Зенера и разоблачение экстрасенсов → SPRT Вальда (да, того самого, что и про ошибку выжившего) → альфа-spending Lan-DeMets в 1983-м. В программе парочка мемов, немного математики, и интерактивный симулятор. Получилось легкое чтение на воскресенье, ну и ничего что уже понедельник 🤓 (не успела опубликовать вчера)

https://ubogoeva.github.io/R4Analytics/posts/sequential_testing_part1_history.html

В части 2 разберем, как эту же проблему решили для продуктовой аналитики и что можно применить на практике.

Заходите, пишите комментарии!

#stats #stat_hard #AB_tests


Топ каверзных вопросов по статистике с собеседований. Часть 2

Продолжение разбора вопросов, вторая часть. Первая часть была здесь. Поехали!

🟡Дизайн готов, A/B тест запущен. Продакт волнуется и смотрит результаты каждый день, в один день пишет, что ключевая метрика статистически значимо упала, надо отключать. Что делаем?

Тут спрятаны сразу две ловушки:

1. Проблема подглядывания. Нельзя смотреть результаты каждый день и принимать решения по первому стат значимому результату, если в дизайне теста изначально не было заложено последовательное тестирование. При таком принципе оценивания теста вероятность ложного прокраса в любую сторону стремительно растет.
2. Экстренная остановка. Важно не путать это с пунктом 1. Корректный критерий аварийной остановки закладывается заранее и обычно не завязан на пересчет p-value день в день, иначе он страдает от той же проблемы подглядывания. Обычно это простой практический порог: метрика упала на конкретное число процентов, выросло число ошибок, начались краши, возможно мы выкатили критический баг 😬.
Если продакт увидел на платформе A/B статистически значимое падение без такого заранее согласованного порога, то это все еще подглядывание в результаты A/B.

В хорошем ответе для собеседования нужно четко разделить два случая. Стоит подчеркнуть недопустимость подглядывания без специального дизайна, но обязательно сказать про возможность ранней остановки теста при критическом падении ключевых или заградительных метрик.

🟡Тест завершен, анализируем 5 ключевых метрик. Одна из них статистически значимо изменилась, p-value = 0.03. Выкатываем тест?

Для внимательных читателей канала вопрос очевидный, это ловушка на множественное тестирование. Конечно, если мы тестируем 5 ключевых метрик, то вероятность совершить ложное открытие повышается, поэтому нужно использовать поправку на множественное тестирование или принимать решение только по одной ключевой метрике. Из поправок обычно достаточно назвать Бонферрони или Холма, а вот FDR я бы сильно не рекомендовала упоминать и применять. Подробнее писала про поправки здесь, а вот здесь есть мощный технический разбор FWER на зависимых тестах

🟡Распределение p-value при A/A тесте

Этот вопрос посоветовали в комментариях к предыдущей части, тоже нередко встречается. Тут нужно вспомнить, какая гипотеза верна при A/A тесте. Так как отличий на самом деле нет, то верна нулевая гипотеза. Ожидаемое распределение p-value при верности нулевой гипотезы равномерное на отрезке от 0 до 1. Это можно увидеть на симуляциях, например здесь

Пишите в комментарии, на сколько вопросов из обеих частей удалось ответить без подглядывания! И делитесь, про что было бы интересно почитать еще 👇

#analytics #собес_PA


Топ каверзных вопросов по статистике с собеседований. Часть 1

Сегодня разберем самые интересные, на мой взгляд, вопросы и типичные ловушки. В изначальной версии получилось довольно много, поэтому мне посоветовали разделить пост на два.
Правильные ответы спрятала под спойлером, попробуйте сначала ответить сами.
Здесь не будет вопросов "что такое p-value" или "что такое доверительный интервал". Хотя они могут встретиться на HR-скринингах, на техническом интервью обычно вопросы поинтереснее. Отмечайте, сколько из этих вопросов вам уже попадалось 👇

Поехали!

🟡От чего зависит размер выборки? Иногда могут спросить формулу MDE, что в числителе, а что в знаменателе.

Можно назвать сразу все 4 параметра: MDE (минимально детектируемый эффект), дисперсия, уровень значимости и мощность. Обычно уровень значимости и мощность фиксированы, размер выборки в основном зависит от дисперсии и MDE. Для непрерывных метрик, таких как ARPPU, характерна высокая дисперсия из-за длинного хвоста, что увеличивает время проведения тестов. Для непрерывных метрик дисперсия и среднее это независимые параметры.

Бонусный вопрос: как считается дисперсия для конверсионных метрик?
Для биномиального распределения дисперсия напрямую зависит от значения среднего по формуле `p(1−p)`.

🟡Что такое ошибка первого и второго рода и какая из них хуже на практике? Как связаны ошибка первого рода и уровень значимости?

Ошибка первого рода — ложноположительный результат (нашли эффект, которого нет), ошибка второго рода — ложноотрицательный результат, не обнаружили реальный эффект (тут моя любимая картинка-мнемоническое правило).

Какая ошибка хуже зависит от конкретного кейса, нельзя дать универсальный ответ. В медицинской диагностике ложноположительный результат почти всегда более безопасен, чем ложноотрицательный, лучше перепровериться, чем пропустить болезнь. В A/B тестировании по-разному, не заметить положительный эффект фичи может быть хуже чем раскатить нейтральную, а может и наоборот, нейтральные фичи усложняют поддержку, кодовую базу, а влияние на метрики не имеют.

Уровень значимости - верхняя граница вероятности ошибки первого рода. Подробнее про это и связь их между собой здесь.

🟡Приготовили дизайн A/B, но тест идет долго, например больше месяца, продакт просит ускорить его. Что делать?

Есть ряд способов ускорения A/B, например через снижение дисперсии: CUPED и стратификация. Кроме этого, можно использовать последовательное тестирование, но с этим есть нюансы, планирую разобрать это в одном из следующих постов. Еще один способ - рассмотреть вариант с прокси-метриками.
В крайнем случае можно увеличить MDE, сократив выборку и ускорив тест, но продакта нужно предупредить, что мелкие изменения теперь не засечем. На тему ускорения A/B можно делать не один пост, здесь будет только нужная информация для старта.

Вторая часть с вопросами выйдет завтра, накидайте лайков, если формат понравился ❤️ Пишите в комментарии вопросы, с которыми сталкивались!

#analytics #собес_PA

3.7k 4 81 11 96

4 неочевидных способа зафейлить A/B тест

Как испортить A/B тест поглядыванием, отсутствием проверки на множественные тестирования или незафиксированными критериями принятия решения до запуска многие знают (а если не знаете, про это еще напишу). Но сегодня речь будет про другое. Статистика и знание теории экспериментирования важная вещь, но даже с идеальным знанием статистики и A/B тестов все еще нет гарантии, что A/B тест пройдет корректно.

Ниже тру стори из моей практики, как разнообразно зафейлить АБ тест не статистикой 👇

🟡Конверсия в эксперименте в одном из сегментов получилась больше 100%

Это мое любимое, писала про похожее чуть выше, но история не устаревает. На общей конверсии этого не было видно, однако результаты A/B получились странные. В разрезе по сегментам обнаружилось: в одном из них не отправлялись события начала воронки, и конверсия получилась выше 100%. Мы не знаем, сколько пользователей заходило в воронку, и было ли это равномерно между тестом и контролем, этот сегмент однозначно зафейлен. Далее я попробовала посчитать результаты A/B без этого сегмента, но это уже методологически неверно (получился серый тест, потому что эффекта нет или после удаления сегмента не хватило мощности?) и эксп пришлось перезапускать после починки логгирования.

Важное замечание: анализ по сегментам был уже в рамках исследования, что пошло не так с A/B тестом, а не для принятия решения на основании одного из сегментов (для этого надо было изначально закладывать в дизайне и делать поправку, что отдельная история).

🟡12% пользователей оказались одновременно в тесте и в контроле из-за бага при запуске A/B

Флаги аналитики протекли в конфиг, и сплитование поломалось. Со стороны мониторинга казалось, что все ок, группы были равны (формально), однако на этапе анализа результатов выяснилось, что часть пользователей из тестовой группы по флагам были и в тесте, и в контроле. В результате корректно просплитованных пользователей оказалось меньше чем ожидалось, эксп пришлось перезапускать. Примерная оценка потерь: с таким багом сплитования нужно на 30% больше трафика при том же MDE.

🟡Некоторые пользователи попали в тест, но воздействия не получили

Сплитование на этот раз было корректным, но на бэке стояли дополнительные условия выдачи фичи, и часть тестовой группы фичу просто не увидела. Это в итоге снова нарушило рандомизацию, просто исключить пользователей из анализа не получилось, тест пришлось перезапускать.

🟡Расхождение данных между источниками, которое случилось из-за теста

По событиям из одного источника в тестовой группе увидели стат значимое падение ключевой метрики. По другому источнику (данным из хранилища DWH) получился стат значимый рост, хотя обычно источники были коррелированы. Оказалось, что события терялись чаще именно из-за тестовой фичи. На этот раз был хеппи энд, так как по более надежным данным из хранилища удалось подвести итоги и тест был признан успешным 🎉


Я бы хотела сказать, что больше подобных случаев не было, к сожалению на этом список не заканчивается, а здесь приведены самые эпичные.

Что общего у этих историй? Ни одну из них не предотвратит знание поправок на множественное тестирование или разницы между тестами Стьюдента и Велча.
Однако со зрелой платформой и культурой экспериментов половина этих фейлов не случилась бы вообще или была отловлена еще при запуске: мониторинг и алерты количества событий, проверка что пользователи реально получают фичу, расчет денежных метрик по DWH, а не по событиям и это далеко не все.

Поэтому немного вечной классики про качество данных: сложные методы хороши, но только после того, как в простых тестах удается добиться максимальной корректности запусков и расчетов на платформе. На отсутствии перезапусков можно очень неплохо улучшить time-to-market, возможно даже лучше, чем внедрением diff-in-diff, CUPED и других модных методов.

В нашем случае все уже не так драматично, мы растем и в процессах и культуре АБ тестов, что уже позволило сократить количество историй выше. Кроме этого, меняем текущую платформу сплитования на более кастомизируемую и современную (угадайте, кто лидирует этот процесс 😎).

А что из неочевидных багов в АБ попадалось вам? Пишите в комментариях 👇


Коллеги из ExperimentHub сделали крутого бота для тех, кто хочет прокачать знания в АБ тестах: @expertmaker_bot

Механика следующая: раз в два дня открывается челлендж из 5 вопросов на A/B тесты, такие, с которыми можно столкнуться на практике. Вопросы непростые, я сама закрываю челлендж на 80-90% (обидно, почему не на 100%, надо прокачиваться на курсе). После выбора ответов сразу открываются правильные с разбором, почему они именно такие. У меня в основном есть некоторые трудности с ratio-метриками, подводит недостаток практики.

Есть геймификация в виде стриков, сколько челленджей подряд закрыл, и лидерборд, где можно соревноваться с остальными игроками.

Полезно, чтобы держать себя в форме, а еще бот составляет карту навыков и слабых мест, что позволяет лучше понять, на каких темах сосредоточиться при подготовке к собеседованиям или на работе.

Помимо квиза с разными вопросами, есть еще формат квеста с серией вопросов про один кейс, можно вызвать в боте командой /quest

Короче рекомендую, заходите в бота, пишите, кто прошел челлендж на 100%, посоревнуемся 😎

#stats #stat_hard


Вчера провели лютый баттл по датавизу, здесь опишу свои впечатления, пока они свежи.

🟡Позвать Настю как эксперта по визуализации данных было очень удачным решением. Во-первых стрим получился более образовательный, с рекомендациями, как строить графики нужно и как не нужно (привет двойным осям). Во-вторых, мне понравились истории, пока мы кодили, например как спалить человека, который пользуется ИИ-агентом прям на собеседовании.

🟡В этот раз была проделана серьезная подготовительная работа над качеством картинки и звука, я пересматривала частично в записи, смотрится очень достойно, сам код тоже виден. Прикрепила к посту скриншот с типичной сценой на стриме (зацените какой дизайн крутой).

🟡Можно в следующий раз сделать звуковой гонг для старта раунда и особенно для окончания, чтобы было понятнее нам, когда пора заканчивать (обратный отсчет тоже можно). Гонг наверняка добавит атмосферности как в ЧГК

🟡Оказалось, что немного недооценила время, которое нужно для подготовки графиков, возможно сказывается недостаток практики в ggplot2. Еще выяснила, что во время такого скоростного кодинга требуется довольно высокая концентрация и из-за этого не особо получилось развлекать зрителей шутками. К счастью, Настя помогла с этим тоже, поэтому пауз было не так много, как могло быть, если проводить без эксперта. Возможно в следующий раз нужен еще один человек как ведущий/комментатор для общения со зрителями во время скоростного кодинга.

🟡Понравилось, что один из зрителей отправил свои графики в комментарии, и можно было оценить и сравнить (третий график возможно получился лучше чем у нас).

🟡Из приятного: все еще помню и могу написать пивот в R самостоятельно, отцентровать заголовок, но все это становится не таким полезным навыком, так как ллм все сделает еще быстрее и качественнее. Но на самом стриме LLM-ка очень долго думала и мне было быстрее написать самостоятельно или по старинке погуглить.

🟡Заценила Positron как IDE, все привычные хоткеи из арстудии работают, поэтому переход был относительно безболезненный. RStudio 🖥 конечно хороша, но отсутствие возможности встроить любого агента огорчает в современных условиях.

В общем и целом: формат понравился, думаем продолжить что-то на похожую тему. Возможно баттл чисто на агентах, как предлагали в комментариях или BI-система vs кодинг (правда я тут догадываюсь как все закончится). Предлагайте еще варианты, что было бы интересно посмотреть и пишите свои впечатления!

По атмосфере я себя ощущала похоже немного на видос, где программист с трудом кодит, а дизайнер с кайфом рисует, прикреплю в комментарии.

Кто не был на трансляции, обязательно посмотрите в записи, получилось сбалансированно образовательно и развлекательно, на мой взгляд

#data_vis #R #stat_fun

4.1k 0 15 14 78

Стрим по датавизу уже сегодня!

Заглядывайте в 19.00 МСК на трансляцию сюда, болейте за наших 😎

Будем кодить на R и Python, вместе с Ромой, а оценивать графики будет Анастасия настенька и графики

Приходите, ставьте лайки, жмите на колокольчик, будет познавательно и весело) (надеюсь)

UPD: По-моему получилось очень душевно, мне самой понравилось)
А вот и репозиторий с данными, заданиями и нашими наработками https://github.com/rosolimo212/visualization_battle/tree/main

#data_vis #analytics

20 last posts shown.