WildRecSys


Channel's geo and language: Russia, Russian
Category: not specified


Рассказываем про рекомендации
Для связи: @erqups

Related channels  |  Similar channels

Channel's geo and language
Russia, Russian
Category
not specified
Statistics
Posts filter


📸 Как работает «Поиск по фото»?

На Wildberries можно загрузить любое изображение — и сервис почти мгновенно подберёт похожие товары из каталога. Это особенно удобно, когда сложно описать вещь словами или нужно найти «точно-такую-же-и-никакую-другую»

В новой статье наш коллега Никита Романов, техлид продуктов «Поиск по фото» и «Похожие по фото», подробно разбирает, как устроен сервис — какие модели используются, как достигается высокая скорость отклика и какие решения лежат под капотом 📝

Если вам интересно:
- как устроен продовый пайплайн поиска по фото,
- как обучается модель распознавания и зачем ей MRL
- при чем здесь LLM, и как их можно использовать для уточнения запроса текстом для реализации мультимодального поиска,

то стоит прочитать статью! 🤓


🤔 Неочевидные подробности обучения двухбашенных моделей

Все, кто работает с рекомендациями, наверняка сталкивались с pop-bias — эффектом, при котором чем популярнее товар, тем выше вероятность, что модель снова его порекомендует.

Наш коллега Андрей Атаманюк из R&D команды подготовил статью на Хабре, где (очень) подробно разбирает эту тему. Статья обзорная и не столько про практические советы, как бороться с popularity bias, сколько про фундаментальное раскрытие причин его появления.

В материале много математики, но она спрятана под каты, так что можно легко пройтись только по основным тезисам! 🙂


Forward from: RWB делает ML
Привет! Делимся видеозаписями докладов после RecSys Meetup 🤘

1️⃣ «Трансформеры в персональных рекомендациях: от гипотез до AB-тестирования» | Иван Ващенко, DS Team Lead в команде персональных рекомендаций
VK | YouTube | Презентация

2️⃣ «Semantic IDs: архитектура и наш опыт внедрения» | Александр Тришин, DS Stream Lead в команде персональных рекомендаций
VK | YouTube | Презентация

3️⃣ «Как мы обучаем CLIP-ы для текстовых тегов» | Михаил Киндулов, Stream Lead в команде Поиск по фото
VK | YouTube | Презентация

4️⃣ «Счастье пользователя vs счастье продавца. Онлайн-доранжирование и байесовская оптимизация в товарных рекомендациях» | Андрей Ветров, Data Scientist в команде товарных рекомендаций
VK | YouTube | Презентация

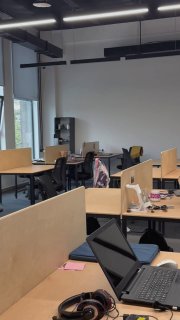
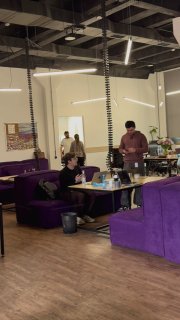
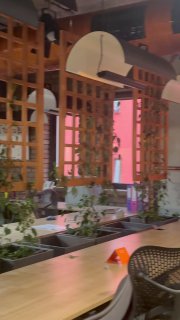
Смотрите фото, чтобы оценить атмосферу. И до встречи на следующих митапах!

🌟 @wb_space


🪄 Как мы тестировали увеличение разнообразия в рекомендациях

В прошлый раз мы поделились нашими способами контроля разнообразия в рекомендациях. Теперь рассказываем, что получилось на практике!

Мы попробовали новый способ формирования ленты и доработали исходную гипотезу.

В текущей статье — все подробности! 👌


Forward from: RWB делает ML
Приглашаем на RecSys Meetup!

Когда? 28 августа, старт в 18:00
Где? Москва + онлайн-трансляция

Обсудим актуальное из мира рекомендаций: от передовых архитектур для построения Semantic IDs и их внедрения в продуктивные системы, до тонкостей балансировки интересов пользователей и продавцов маркетплейса с помощью онлайн-доранжирования и байесовской оптимизации.

В программе:

🚩 «Semantic IDs: архитектура и наш опыт внедрения» | Александр Тришин, Data Scientist в команде персональных рекомендаций

🚩 «Счастье пользователя vs счастье продавца. Онлайн доранжирование и байесовская оптимизация в товарных рекомендациях» | Андрей Ветров, Data Scientist в команде товарных рекомендаций

🚩 «Как мы обучаем CLIP-ы для текстовых тегов» | Михаил Киндулов, CV Engineer в команде Поиска по фото

🚩 «Трансформеры в Wildberries & Russ: от гипотез до AB-тестирования» | Иван Ващенко, DS Stream Lead в команде персональных рекомендаций

Регистрация уже открыта! PS: для участия в офлайне регистрация обязательна.

🌟 @wb_space


📊 Продуктовая аналитика в рекомендациях

Исторически, в этом канале мы рассказывали в основном про различные DS/ML-подходы к построению рекомендаций, не акцентируя внимание на самом продукте.

Именно поэтому, для полноты картины, мы запускаем цикл аналитических статей.

В них мы расскажем про особенности в проведении A/B-экспериментов и аналитических исследований, построении и визуализации CJM, разработке метрик, специфичных для рекомендаций, а также о других задачах продуктовой аналитики, помогающих бизнесу принимать решения на основе данных!

Сегодня эстафетная палочка у Лёши Кузнецова - лида аналитики персональных рекомендаций. Он расскажет о своём пути и особенностях работы продуктовым аналитиком.


❤ Negative sampling в рекомендательных системах

Негативное сэмплирование - один из ключевых инструментов обучения моделей на большом каталоге.

В сегодняшнем обзоре расскажем про основные стратегии сэмплирования:

❤ In-Batch Negative Sampling

❤ Random Negative Sampling

❤ Frequency based Random Negative Sampling

❤ Adaptive mixed strategy

❤ Adaptive mixed strategy с линейной комбинацией


⚙ Векторное доранжирование

В сегодняшней статье рассказываем про техническое решение, которое позволяет использовать WildBERT для персонализации произвольной поюзерной выдачи без дополнительного переобучения.

Про подход, модель и инфраструктуру - тут.

С праздником!


🪆 Сжатие без потерь: как мы уменьшили эмбеддинги для онлайн-ранжирования рекламы

18-19 апреля, в городе Ульяновск, прошла конференция Стачка. Там, помимо доклада про декомпозицию юзера, также рассказали про обучение Matryoshka представлений.

Выступал Илья Бадекин - DS команды товарных рекомендаций.

➡ Запись доклада

➡ Презентация

❓ Описание

Можно сделать крутую модель, но от нее будет мало проку, если не обеспечить ее интеграцию в реальные бизнес-процессы. В докладе расскажем, откуда и зачем в команде «Товарных рекомендаций» Wildberries текстовый энкодер, на что он способен и как мы сжимали его эмбеддинги для онлайн-доранжирование рекламных баннеров по запросам пользователей: от классических PCA, автоэнкодеров и полносвязных слоев до одного интересного подхода с очень русским названием.

💬 Основные тезисы:

- Текстовый энкодер в похожих товарах: зачем?

- Что было в проде на тот момент: описание е5-multilang large; обучение, сбор хороших негативов, промпт; метрики

- Как в мл размерность уменьшать принято?

- Матрешка - как сохранить 95% от метрик


🎤 Декомпозиция юзера на кластерные сущности

На прошлой неделе прошла конференция Data Fusion, где в кейс-сессии рекомендательных систем мы рассказали как не разориться на инфраструктуре при постоянном росте количества пользователей

➡ Запись сессии

➡ Презентация

❓ Описание

При построении персональных рекомендаций зачастую подразумевается, что мы должны получить для каждого пользователя свою, уникальную подборку товаров. Однако в случае, когда пользователей становится слишком много, а в инфраструктуре товары хранятся с обогащением бизнес-факторами, такая схема становится все менее масштабируема.

Расскажу о том, как мы без просадки в качестве существенно сократили затраты на инфраструктуру за счет кластеризации пользователей и товаров.

💬 Основные тезисы:

- кластеризация пользователей (эмбеддинги WildBERT), создание агрегированной выдачи для кластера

- кластеризация товаров (e5) - выделение интересов, отображение пользователя в пространство интересов

- сравнение АБ-тестов для схем "храним подборку для каждого пользователя" и "храним только кластера, юзера описываем как набор кластеров и интересов" в разрезе ранжирующих метрик и затрат на инфраструктуру

- как в такой схеме не просадить качество - доранжирование по эмбедингам в онлайне в момент формирования выдачи

⏱ Скоро расскажем как выступили на Стачке в Ульяновске, которая также прошла на прошлой неделе


🛍 Управление разнообразием рекомендаций

Ксюша Малкова, DS команды персонализации, написала статью про методы управления разнообразием на этапе подготовки данных и на пост-процессинге

Якорные товары, квоты, инференс по категориям и немного про Beyond-Accuracy - все тут!


🖱 Отбор качественных кликов

В одной из давних статей я рассказывал о комбинации фидбека в u2i моделях. В тот раз мы обогатили цепочки взаимодействий для инференса берта, который обучался только на заказах, добавлениями в корзину - и получили значимый прирост по метрикам.

❗ Из той череды тестов, да и в целом, эмпирически, напрашивался вывод - чем более близкий фидбек к последним действиям пользователя на платформе мы используем - тем лучше.

Одно из таких “близких” действий - это клики. Но с ними есть нюанс - их слишком много, миллиарды ежедневно, и просто дописать их в цепочки взаимодействий, как добавления в корзину, не получится.

Значит, задача звучит так - “как отобрать из всех кликов только те, что несут максимальный сигнал для моделей?”

В задаче рекомендаций основной сигнал будут нести те карточки товара, к которым юзер проявил интерес, этот самый интерес можно разложить на 2 составляющие:

1⃣ Временные эвристики - сколько раз пользователь открывал конкретную КТ, сколько времени провел на ней и т.п.

На приложенной картинке как раз сглаженный график зависимости конверсии в заказ от времени, проведенного на карточке товара. Пунктирными линиями схематично отображено одно из правил отбора хороших кликов - берем только те, что удовлетворяют нашему диапазону по времени просмотра.

2⃣ Продуктовые события

Когда пользователь уже находиться в КТ - есть много вариантов для развития событий. Добавить товар в отложенное, провалиться в отзывы, посмотреть изменение цены, найти похожие по фото и т.д.

Такие события также говорят об интересе пользователя к товару и учитываются в правилах отбора кликов.

✅ Если собрать 2 направления интереса в единое целое, то правило отбора кликов может звучать так - “давайте брать только те клики, где пользователь взаимодействовал с карточкой минимум 3 раза за неделю, в среднем больше 45 секунд и смотрел отзывы”

Вариаций на самом деле много, мы использовали ту, которая позволила нам сократить до 10% количество кликов, которыми мы обогащаем цепочки, и получить статзначимый рост денежных и продуктовых метрик в АБ тестах различных моделей.


6.1k 1 110 3 52

Forward from: Персонализация неизбежна
Мой ТОП-10 проверенных и популярных моделей RecSys.

Для меня модели рекомендаций начинаются с тех, которые можно построить на данных формата (user_id, item_id, timestamp). Если у вас есть такие наборы данных, то с помощью следующих моделей можно составить список персональных рекомендаций для каждого пользователя внутри датасета. Этот список я составил по субъективной популярности и уверенности в том, что модели проверены временем:

1. iALS (2008, 4к+ цитирований) - масштабируемая на большие объемы данных матричная факторизация. Крупные компании в РФ часто упоминают ее как кандидатогенератор, рассказывают про различные трюки с оптимизациями. Скорее всего, про ALS на собеседованиях хотят слышать в первую очередь.
2. EASE (2019, 250+ цитат) - моя любимая модель. Один гиперпараметр, решение в явном виде. Моделька - матрица весов item*item. Топ-1 модель по мнению авторов из Сбера. Мы взяли первое место на Hack the cart, используя только эту модель. Ее минус - большие каталоги айтемов, но на них можно использовать ELSA или SANSA.
3. SLIM (2011, 900+ цитат) - аналог EASE. Матрица весов разреженная, зависимость от гиперпарметров более сильная, их больше. По качеству SLIM похуже EASE. С ней возиться сложнее. Однако, в силу разреженности матрицы весов есть и плюс. Помню, SLIM весил 100 Кб, а EASE около 600 МБ на одинаковых размерах.
4. MultiVAE (2018, 1350+ цитат) - модель от Netflix. Та самая, которая в обзоре are we really... выиграла SLIM и стала единственной нейронкой, которая это сделала. На вход модели идет только вектор интеракций, поэтому ее можно обучить на 1000 юзерах, а инференсить на 100к юзерах без дообучения - это прекрасно!
5. ItemKNN (2001, 13к+ цитат). Про этот алгоритм обычно не говорят на собеседованиях, так как "что-то на старом", а зря. У recsys есть open benchmark BARS, и на датасете Amazon Books ItemKNN занимает второе место среди многих моделей. И ни GCN, ни LightGCN, ни даже UltraGCN его не побеждают.
6. GRU4Rec (2015, 3400+ цитат). В 2019 году я занял 17/264 место в Rekko Challenge от Okko. Тогда я в первый раз обучил нейронку для рекомендаций, и это была GRU4Rec. Ожидния не оправдались, но для старта нормально. Кстати, недавно автор разобрал популярные ошибки в ее имплементации.
7. SASRec (2018, 2400+ цитат). Это трансформер для next-item recommendation. Основа основ для использования трансформеров в мире рекомендаций. Имеет множество расширений (TiSASRec).
8. BERT4Rec (2019, 1900+ цитат). Чуть лучше SASRec, например, по статье Саши Петрова. По опыту, часто нет смысла использовать SASRec и BERT4Rec вместе, лучше выбрать что-то одно.
9. LightGCN (2020, 3300+ цитат) - графовая сверточная сеть. В графе есть только юзеры и айтемы, модель оценивает связи user-item с точки зрения графа и делает рекомендации. На мой взгляд, крайне громоздкая, медленно обучаемая и негибкая модель, куда лучше ее улучшение в виде GFCF.
10. TIFU KNN (2020, 120+ цитат). Если в ваших данных есть повторные действия между юзерами и айтемами (например, покупки в супермаркетах), то, скорее всего, все модели выше проиграют по качеству TIFU KNN. Эта модель играет вокруг персональной частоты покупок пользователя. Если человек купил 100 раз молоко, именно TIFU KNN без проблем порекомендует его 101 раз и не ошибется. Остальные модели могут повторить персональные частоты, но все равно по качеству уступят TIFU KNN.

Мне кажется, если вы хотите ввести модель полноценно в свой инструментарий, надо сделать следующее:

✅ Прочитать оригинальную статью.
✅ Посмотреть ее имплементацию: какие идут данные на вход на трейне и инференсе, как данные идут внутри, что на выходе.
✅ Запустить модель на любом датасете, посмотреть за метриками, возможно, на рекомендации.
✅ Изучить гиперпараметры, посмотреть, как они влияют на модель.
✅ Повторить то же для расширений модели. Например, EASE -> ELSA, Lightgcn - GFCF и т.д..
✅ В идеале, применить на проде в АБ или в рамках соревнования.

Выучив все эти модели и пройдя чек-листы, уже можно уверенно ориентироваться в основных моделях, но на этом recsys не заканчивается, а только начинается)

3.1k 0 127 5 43

❤ Записи докладов про рекомендации с первого ML Meetup от Wildberries

❤ Саша Тришин из команды персонализации про LightGCN - YouTube, VK

❤ Георгий Соколов из команды товарных рекомендаций про мультиязычный e5 - YouTube, VK

Другие доклады можно посмотреть тут


🔍 Поиск по фото

Не успела на разных ресурсах отгреметь новость (VC, Habr, Рифмы и Панчи и многие другие) о выкатке нового большого релиза поиска по фото, а лид одноименной команды, Никита Романов, уже написал большую статью про то, как все устроено под капотом!

Про архитектуру, детекцию объектов и валидацию - читайте в первой части разбора!


⌚ Лучше поздно, чем никогда

Читая статью на Хабре наткнулся на комментарий (первый скрин под этим постом) от 2021 года, в котором подсвечивается одна из проблем реактивного домешивания на главной.

Исходная задумка простая - давайте заранее построим i2i матчинг похожих товаров (второй скрин). Далее, юзер в рамках сессии кликает на товары, а мы в онлайне домешиваем на главную похожие карточки.

Работает хорошо, но есть corner case - если я выбираю определенный товар (ту же лопату), то я прокликаю их много - а значит вся главная будет забита лопатами.

В прошлом квартале, в рамках решения проблемы, выкатили 2 большие фичи. Первая - это экспоненциальное затухание реактивных взаимодействий, чтобы через некоторое время главная “откатывалась” к исходному состоянию.

Вторая - применение MMR в мерджере (таким гордым именем у нас зовется блендер оффлайн и реактивных источников 😤), в момент формирования выдачи.

Подробнее про эксперименты с MMR и DPP расскажет Никита Ваганов, DS в команде HML, в рамках обзорной статьи.

Всем хороших выходных! 🙂


🛒 WB RecSys на AiConf

Вчера, во второй, завершающий день конференции, выступили сразу с двумя докладами:

➡ WildBERT — развитие трансформерных архитектур для персонализации Wildberries
➡ Мультимодальные рекомендации в Wildberries

🔥 Было круто! Презентации можно найти по ссылкам, дополнительно закину в комментарии к посту. Записи появятся в течение трех недель.

😇 Остаемся на связи, в ближайшее время частота выхода технических постов в канале вернется к прежнему уровню.😌

P.S. Большое спасибо всем, кто принимал участие в подготовке докладов и тем, кто всячески поддерживал! 😍

P.P.S. Слева направо - Саша Самойлов, Макс Пасашков, Женя Иванов, Степа Евстифеев


📌 AiConf 2024

Привет! Рад сообщить, что мне выпала честь представлять Wildberries в целом и команду персонализации в частности на конференции AiConf 2024, которая будет проходить 26 - 27 сентября.

Расскажу про то, как шаг за шагом нативный BERT4Rec превратился в WildBERT — инструмент, который играет одну из самых важных ролей в персонализации Wildberries. На главной, в карточке товара, поиске и каталоге.

❓ Про что поговорим:

- Large vocabulary bottleneck, negative sampling и logQ correction;
- выкатка в прод и бизнесовые требования, дихотомия офлайн и онлайн метрик;
- подход к маскированию при обучении, next basket prediction;
- формирование цепочки взаимодействий юзера — якорные товары, комбинированный фидбэк и учет OOV;
- ALBERT или DEBERTA;
- SparseAdam и ускорение обучения;
- квоты как инструмент оптимизации diversity;
- интеграция в единую инфраструктуру WBX, что позволило унифицировать процесс векторного доранжирования выдач на главной, в поиске и каталоге;
- и многое другое!

😱 Все доклады можно посмотреть тут, а при оформлении билета использовать промокод от членов программного комитета datascience, который позволит получить скидку в 15%


Forward from: RWB делает ML
#wb_в_деле
Интересуешься Машинным обучением и Data Science? Хочешь узнать, как современные технологии применяются в работе маркеплейса? Тогда welcome на первый ML Meetup Wildberries 🎤

На митапе спикеры расскажут про ML-решения в продуктах и процессах компании, а также поделятся интересными решениями в Рекомендациях и Поиске.

🔜 11 сентября, 18:00
📍 офис Wildberries в Москве, метро Белорусская

Регистрация уже открыта. Поторопись, количество мест ограничено⚪️

Подписывайтесь, чтобы не пропустить новые подробности о митапе:
🌟 @wb_space

20 last posts shown.

1 871

subscribers
Channel statistics