Yandex for Backend


Channel's geo and language: Russia, Russian
Category: Technologies


Канал для бэкендеров от Яндекса. Рассказываем про события по Python, Go, Java и C++ и не только, делимся экспертизой, обсуждаем технологии и поддерживаем бэкенд-комьюнити.
Другие каналы Яндекса по стекам разработки: https://t.me/addlist/Hrq31w2p1vUyOGZi

Related channels  |  Similar channels

Channel's geo and language
Russia, Russian
Statistics
Posts filter


🦾 Что под капотом полнотекстового и гибридного поиска в YDB

Меня зовут Александр Зевайкин, я руководитель команды разработки YDB (СУБД Яндекса). Год назад я рассказывал на Хабре, как мы запустили векторный поиск, а весной — как он используется в Нейроюристе для поиска по миллионам юридических документов.


В релизе 26.3 мы добавили полнотекстовый поиск с ранжированием и объединили его с векторным с помощью HybridRank (всё это работает в одном SQL-запросе!). Теперь можно искать документы по смыслу и одновременно учитывать точные совпадения — номера, названия и коды. А поисковые индексы находятся в YDB и обновляются вместе с данными.

В статье на Хабре я рассказал:

🟢 Почему одного вида поиска недостаточно

🟢 Чем полнотекстовый и векторный поиск дополняют друг друга

🟢 Как сделать инвертированный индекс в виде распределённой таблицы и что добавляет к нему ранжирование по BM25

🟢 Что происходит с каждым индексом при записи и как индекс объединяется с фильтрацией

🟢 Как две выдачи объединяются внутри одного плана запроса

🟢 Чем гибридный поиск помогает рекомендательным системам и как измеряют результат

📖 Читайте все подробности здесь

Кстати, 15 октября я проведу практический вебинар. На примере документов, тикетов, карточек товаров и диалогов покажу, как настроить гибридный поиск, фильтровать результаты и подключить выдачу к AI-ассистенту через RAG.

🔶 Зарегистрироваться на вебинар

Подписывайтесь:
💬 @Yandex4Backend
📹 @YandexforBackend


💹 Открываем код YTsaurus Flow

Потоковая обработка информации в реальном времени под высокими нагрузками часто упирается в инфраструктуру. Как правильно партиционировать поток данных? Как гарантировать exactly-once при сбоях оборудования? И как понять, обработали ли мы все данные на тот или иной момент?

Для решения этих задач команды Yandex Infrastructure и Яндекс Рекламы создали YTsaurus Flow — фреймворк потоковой обработки данных с сохранением состояния между событиями. Сегодня мы выложили его исходный код в опенсорс под лицензией Apache® 2.0.

Flow входит в экосистему платформы YTsaurus и использует её хранилище, очереди и механизм транзакций. Движок берёт на себя координацию узлов, управление стейтом и восстановление после падений, позволяя разработчику сосредоточиться на бизнес-логике.

Архитектурные особенности YTsaurus Flow:

🟢 Гарантия exactly-once по умолчанию. Атомарная фиксация состояния, метаданных очередей и данных синхронных приёмников в рамках одной транзакции (эпохи). Для экономии ресурсов гарантию можно явно ослабить до at-least-once или at-most-once

🟢 Защита от дублирования работы. Механизм prerequisite-транзакций не позволяет устаревшему воркеру закоммитить результат, если контроллер уже передал задачу новому узлу

🟢 Нативное C++-ядро и гибкий выбор языков. Бизнес-логику пайплайнов можно писать на C++, Python, Go, Kotlin или Java, а простые графы вычислений описывать на YQL

🟢 Автоматическая адаптация под поток. Движок сам балансирует партиции по машинам и подбирает их количество без ручного тюнинга

🟢 Отказоустойчивость. Полноценная работа пайплайнов с распределением компонентов по трём дата-центрам для непрерывной обработки при недоступности любого из них

В статье на Хабре мы подробно разобрали, как устроен YTsaurus-Flow-пайплайн. А ещё поделились кейсом Яндекс Рекламы: как за счёт перехода на real-time с внедрением YTsaurus Flow удалось практически полностью сократить техническую задержку поставки данных для дообучения рекомендательных моделей.

🔶 Читать статью на Хабре

Подписывайтесь:
💬 @Yandex4Backend
📹 @YandexforBackend


🔶 «Я про бэкенд» начнётся через час!

Уже сегодня состоится конференция для бэкенд-разработчиков, где мы поговорим о высоконагруженных рекомендательных, генеративных и других системах под капотом AI‑first продуктов. А также о вызовах, с которыми сталкиваются их разработчики.

📺 Подключайтесь к трансляции на сайте

Подписывайтесь:
💬 @Yandex4Backend
📹 @YandexforBackend


💹 От MVP до десятков тысяч магазинов

На конференции Back to Back Олег Садовников, руководитель бэкенда платформы Яндекс КИТ, поделился опытом масштабирования конструктора интернет-магазинов, а также рассказал, какие ресурсы становились критичными по мере роста нагрузки и как менялась архитектура.

📺 Смотрите все подробности на ютубе и в VK Видео.

Подписывайтесь:
💬 @Yandex4Backend
📹 @YandexforBackend


🎙 Как ускорить работу LLM — в подкасте «От инженера слышу»

Почему мощная видеокарта не гарантирует быстрый ответ нейросети? И как обслуживать больше запросов на том же железе, не заставляя пользователей ждать?
В первом выпуске разбираемся, что происходит между отправкой запроса и появлением ответа. А также объясняем, как устроен инференс больших языковых моделей и что помогает сделать его быстрее и дешевле.

💬 Что ещё обсуждаем:

🟢 Чем обработка контекста отличается от генерации токенов

🟢 Как KV-кеш, квантование и спекулятивное декодирование помогают выжать больше из GPU

🟢 Как обрабатывать большой запрос одного пользователя, не тормозя остальных

🟢 Почему удачная оптимизация может оказаться бесполезной для конкретной нагрузки

🟢 Когда стоит разрабатывать свою библиотеку инференса и какую часть работы уже можно доверить AI-агентам

🔊 Слушайте выпуск на ютубе и в VK Видео
А больше о работе с LLM и других инженерных задачах бэкенда — на конференции «Я про бэкенд»

🈁 Регистрируйтесь и приходите за подробностями и опытом коллег

Подписывайтесь:

💬 @Yandex4Backend
📹 @YandexforBackend


💹 Делимся записями с deep tech night 

5 сентября прошла масштабная конференция Яндекса о технологических вызовах, с которыми сталкиваются разработчики и инженеры в эпоху AI. Здесь эксперты мирового уровня рассказали о нетривиальных задачах в работе: от Physical AI до продуктовой агентской разработки.

📺 Записи докладов экспертов уже доступны на лендинге конференции. А вот некоторые из выступлений, которые мы особенно рекомендуем посмотреть:

🟢 Василий Ершов, руководитель AI Studio Tech в Yandex Cloud: «Облако в эпоху AI: архитектура платформы для гибридных агентов» 

🟢 Егор Филимонов, лидер команды по ускорению инференса на NPU в SGLang: «Влияние трендов развития нейросетей на архитектуру NPU и инференс-фреймворки» 

🟢 Иван Сапожков, руководитель группы базовой ML-инфраструктуры в Яндексе: «Инфраструктура RL-обучения» 

🟢 Павел Капля, руководитель продуктовой разработки Алисы в Яндексе: «От поиска к агентам: путь Алисы» 

🟢 Сергей Мельник, руководитель сервиса Автономного транспорта и роботов в Яндексе: «Physical AI: от симуляции к реальным дорогам»

Ещё доклады можно посмотреть на ютубе:

❇️ Hard
❇️ Experiment

🈯️ Спасибо, что были с нами! 

Подписывайтесь:

💬 @Yandex4Backend
📹 @YandexforBackend


🔠 Приглашаем в Архитектурный клуб Яндекс 360

Это открытое сообщество для архитекторов и инженеров. В этот раз мы разберём, как устроен AI-агент, который работает с корпоративными данными и остаётся управляемым.

Даниил Смирнов, руководитель службы бэкенд-разработки антиспама в Яндекс 360, расскажет:

🟢 Что учитывать при поиске по корпоративным данным: как сочетать полнотекстовый и векторный поиск с учётом метаданных, фильтров и устройства источников

🟢 Как наследовать права доступа исходных систем и изолировать данные пользователей и организаций

🟢 Как ограничивать автономность агента и оценивать качество поиска, выбора инструментов и итогового ответа

В финале мы спроецируем решения на референсную архитектуру с использованием опенсорсных технологий и библиотек.

Когда и где:

📆 6 октября, 17:00 мск
💻 Онлайн

🔶 Зарегистрироваться на встречу

Подписывайтесь:
💬 @Yandex4Backend
📹 @YandexforBackend


🏆 Международное соревнование для разработчиков

Young&&Yandex открывает регистрацию на Yandex Cup 2026 — международный чемпионат Яндекса по программированию с призовым фондом 9 млн рублей. Принять участие смогут разработчики любого уровня, от юниоров до опытных специалистов.

Выбирайте одно из трёх направлений:

🟢 Машинное обучение
🟢 Алгоритм
🟢 Аналитика

Что вас ждёт:

🟢 Призовой фонд 9 млн рублей и денежные призы в каждом направлении
🟢 Офлайн-финал в Москве для 120 лучших участников и 36 призовых мест

В прошлом году соревнование собрало свыше 21 тысячи заявок от разработчиков из 60 стран. В 2026-м можно вновь проверить свои силы, познакомиться с сильными разработчиками из разных городов и побороться за призовой фонд.

🔶 Успейте зарегистрироваться до 1 ноября

Подписывайтесь:
💬 @Yandex4Backend
📹 @YandexforBackend


🐾 Яндексоиды рассказывают про свои пет-проекты: ktoml и diktat

Продолжаем показывать видео про пет-проекты и сегодня обсудим разработки из экосистемы языка Kotlin.

👨‍💻 Андрей Кулешов, руководитель разработки SourceCraft Security, рассказал в нашем новом видео о своих двух петах:

1️⃣ Ktoml — нативная и мультиплатформенная библиотека для сериализации и десериализации формата TOML на основе kotlinx.serialization

🟢 SourceCraft
🟢 Гитхаб

2️⃣ Diktat — легковесный статический анализатор (линтер), а также набор стилистических правил для написания кода на Kotlin

🟢 SourceCraft
🟢 Гитхаб

🔶 Смотрите все подробности на ютубе, а всю серию видео про пет-проекты яндексоидов можно найти в плейлистах на ютубе и в VK Видео.

Подписывайтесь:
💬 @Yandex4Backend
📹 @YandexforBackend


📎 Как сэкономить 1000+ ядер на ровном месте

На связи Миша Иглицкий, бэкенд-разработчик в платформе Яндекс Еды. У нас есть PHP-монолит, в который пишут мало нового кода, поэтому он спокойно работает и не привлекает к себе лишнего внимания. Так оно бы и продолжалось, если бы не случился период повышенной нагрузки и понадобилось зарезервировать побольше мощностей для беспроблемной обработки подобного спроса.

Монолит отлично справился. Но после этой ситуации я случайно обратил внимание, что RPS в пиковые вечерние часы подозрительно совпадает с количеством ядер CPU, выделенных на весь монолит. Нехитрая арифметика показала: 100% загрузки одного ядра приходятся на 2,5 RPS. Я решил разобраться, что к чему.

Спойлер: дело оказалось не только в PHP.

❇️ Perforator vs PHP-монолит

У нас есть Perforator, который установлен почти на все хост-машины в дата-центрах, и с его помощью можно посмотреть, на что уходит процессорное время на подах. Проблема в том, что он видит почти всю работу PHP как вызов zend_execute_ex.

Хорошая новость: коллеги как раз допиливали поддержку PHP в Perforator, но пока не вмержили её в основную ветку. Однако нам залили на одну из хост-машин, где крутился инстанс PHP-монолита, специально собранную версию с поддержкой PHP. И я сразу же увидел пожирателя CPU.

Им оказалась функция getRoutePattern для атрибута http.route. Изначально никто не заметил, что getRouteCollection не возвращает готовый закешированный список роутов, а каждый раз собирает его заново: проходит по всем YAML-файлам и читает аннотации в PHP-файлах.

🦾 Исправление оказалось элементарным: теперь роуты читаются и сохраняются один раз на этапе сборки контейнера, а в рантайме берутся из кеша.

➖ Результат: потребление CPU в 99-м процентиле снизилось почти на 30%.

❇️ Инфраструктурные полтергейсты

На стороне PHP очевидных тормозов больше не было. Но я обратил внимание, что теперь топ потребления CPU выглядит так:

🟢 PHP: 20%
🟢 HAProxy: 19%
🟢 psql: 17%

🔍 Внутри psql мы увидели странный call stack. Оказалось, что в Debian psql по историческим причинам запускается через Perl-обёртку. Она выбирает нужную версию клиента, потому что в системе может быть установлено сразу несколько версий PostgreSQL (этой возможности уже больше 20 лет).

Также монолит на PHP не использует postgres-специфичные connection string, чтобы подключаться к primary-ноде БД — это решение вынесено на уровень HAProxy. А он не умеет делать это нативно, только проверять tcp connectivity. Так что для проверки были написаны специальные скрипты, которые и вызывали psql. В итоге один только запуск Perl-обёртки начал заметно потреблять ресурсы.

🦾 Проблему решили довольно просто: добавили agent-check в HAProxy. Передаём проверку состояния бэкенда отдельному агенту, который может делать то, чего HAProxy не умеет.

➖ Результат: строки с описанием бэкенда теперь длиннее, но зато работа стала быстрее и стабильнее. И после выкатки этого изменения на тестинге Perl пропал в профилях.

🔶 Читайте больше подробностей в статье на Хабре. Там я рассказал, почему HAProxy продолжал расходовать много CPU даже после наших изменений. А ещё поделился, как мы увеличили выделенную под APCu память и реализовали динамическую балансировку.

Подписывайтесь:
💬 @Yandex4Backend
📹 @YandexforBackend


Video is unavailable for watching
Show in Telegram
📺 «Нерешённые задачи» — премьера к празднику

Сегодня, 13 сентября, мы отмечаем День программиста, а ещё этот праздник совпадает с днём рождения Ильи Сегаловича, сооснователя Яндекса. Так что это идеальный день для премьеры нашего документального фильма «Нерешённые задачи» на Кинопоиске.

🟢 О чём картина

Это 30-минутная история о разработчиках Яндекса, которые каждый день берутся за задачи без готовых решений. Герои из команд Автономного транспорта, Алисы, Yandex Infrastructure и Yandex Cloud расскажут об экспериментах, ошибках и моментах, когда неудача становилась шагом к большому открытию.

Обсудим, почему некоторых пассажиров автономного транспорта укачивает, как подготовить инфраструктуру к трафику, который каждый год растёт вдвое, и что делать программисту, если модели уже пишут код быстрее него.

Готовых инструкций нет. Есть гипотезы, эксперименты, ошибки и новые попытки разобраться. Поэтому если вы не знаете, что делать, — это нормально. Вы просто оказались перед настоящей задачей.

🍿 Смотрим фильм на Кинопоиске или на YouTube

🈯️ Приятного просмотра и с Днём программиста!

Подписывайтесь:
💬 @Yandex4Backend
📹 @YandexforBackend


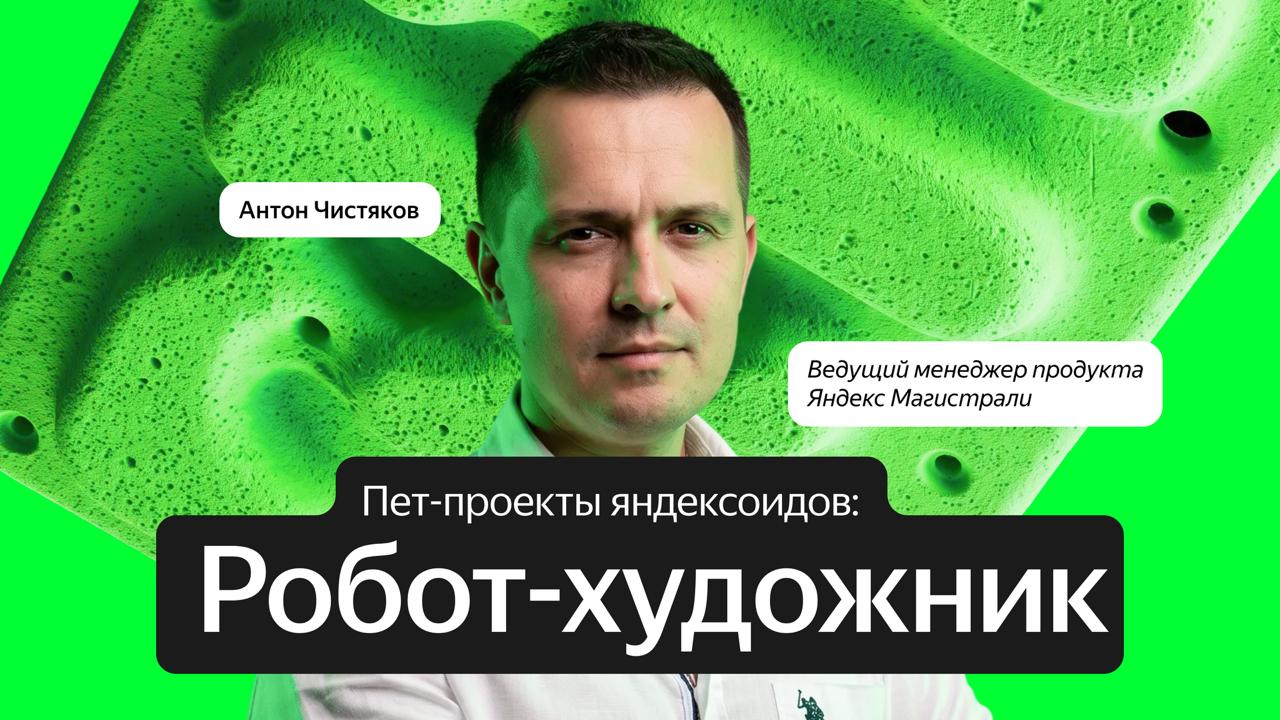
🐾 Яндексоиды рассказывают про свои пет-проекты: робот-художник

Хотим познакомить вас с разработкой на стыке программирования и искусства — об этом наше новое видео.

🈁 Мы уже рассказывали о проекте в нашем канале, а теперь представим героя поближе!

Автор пета — Антон Чистяков, ведущий менеджер продукта «Яндекс Магистрали». Он навайбкодил программное обеспечение на Python, которое превращает коллаборативного робота-манипулятора (uFactory Lite 6) в настоящего художника.

📺 В ролике Антон рассказывает:

🟢 Как робот самостоятельно рисует на холсте акварелью и выполняет сложные действия — от набора краски и промывки кисти до нанесения мазков с правильной ориентацией

🟢 Из каких частей состоит проект

🔶 Смотрите все подробности на ютубе, а всю серию видео про пет-проекты яндексоидов можно найти в плейлистах на ютубе и в VK Видео.

Подписывайтесь:
💬 @Yandex4Backend
📹 @YandexforBackend


🛎 «Я про бэкенд» × «2718»: ищем сложные задачи для инженеров Яндекса

В карточках знакомим вас с первыми спикерами «Я про бэкенд», а в посте рассказываем про «2718». В прошлом году на конференции инженер Яндекса в прямом эфире разбирал сложную архитектурную задачу. Все участники предлагали свои решения и спорили о деталях, поэтому мы решили повторить формат.

И здесь нам нужна ваша помощь. Присылайте нетривиальные задачи на проектирование бэкенда сервиса в области информационного поиска. Мы выберем самую интересную и подходящую для публичного разбора, а инженеры Яндекса будут решать её в прямом эфире на «Я про бэкенд».

❇️ Примеры тем для задач:

• Сбор данных: обход, обработка, хранение.

• Индексация: построение индексов, хранение, запросы к индексам.

• Кандидатогенерация: отбор первичного множества документов, фильтрация.

• Свежесть данных: добавление новых документов/данных, удаление неактуальных документов/данных.

• Шардирование: деление данных на подмножества.

❇️ Ваша задача должна быть:

• Связана с областью информационного поиска, посвящена одной или нескольким смежным темам.

• Решаема (примерно за час).

• Приближена к реальному миру.

📆 Принимаем задачи до 11 сентября, форма участия и подробные условия «2718» — по ссылке.

🔶 Регистрируйтесь на конференцию «Я про бэкенд». С задачей или без неё — будем рады встретиться на серверной стороне AI-технологий.

Подписывайтесь:
💬 @Yandex4Backend
📹 @YandexforBackend


🚀 Погружаемся в технологии на deep tech night

Уже 5 сентября пройдёт deep tech night — масштабная онлайн-конференция Яндекса о технологических вызовах, с которыми IT-индустрия сталкивается в эпоху AI: от изменений в разработке до новых требований к архитектуре и инфраструктуре.

Это событие для ML-разработчиков, бэкендеров, фронтендеров, тимлидов, аналитиков, продактов и всех, кто работает в IT-индустрии, внедряет AI в процессы, проектирует сложные системы и ищет новые решения.

🔥 Вас ждут темы от инфраструктуры и железа для нейросетей до AI-агентов и внедрения AI в разработку и два формата:

🟢 Hard — доклады о сложных и масштабных задачах для тех, кто хочет вдумчиво разобраться в технической стороне сферы.

🟢 Experiment — лайтнинги и интерактивные кейсы об экспериментах с AI-агентами, новых подходах и продуктовых находках. Для всех, кому интересно пробовать новое и следить за трендами.

Среди спикеров — Мо Гавдат, десять лет руководивший бизнес-развитием в Google X, Алексей Гусаков, CTO Поисковых сервисов и ИИ, Сергей Мельник, руководитель сервиса Автономного транспорта и роботов, и другие эксперты из Яндекса и других IT-компаний.

🧬 Чтобы подключиться к онлайн-трансляции, нужна предварительная регистрация. Она также даст возможность задать вопросы экспертам в прямом эфире и первыми посмотреть запись после события.

🔶 Смотрите полную программу и регистрируйтесь на deep tech night.

До встречи!

Подписывайтесь:
💬 @Yandex4Backend
📹 @YandexforBackend


🔍 Как построить здоровый мониторинг

Нам нужны метрики и оперативное подсвечивание инцидентов, чтобы понимать, хорошо ли всё работает, и вовремя узнавать, если что-то идёт не так. Но чем больше новых измерений мы добавляем, тем больше появляется информационного шума.

Меня зовут Настя Кузнецова, я бэкенд-разработчик в Яндекс 360 и отвечаю за надёжность Календаря. Хочу рассказать, как мы приводим в порядок мониторинг, какие метрики стоит взять за основу и в чём суть нашего правила 80/20.

❇️ Два главных принципа здорового мониторинга

1️⃣ Помните, что метрики — это маяки, а не микроскопы. Они сигнализируют о наличии проблемы, но не рассказывают детально, какая из шестерёнок огромного механизма барахлит. С алертами та же история: они просто показывают, есть проблема или нет, без указания на конкретную строку в коде

2️⃣ Стремитесь к балансу. Конечно, хочется замониторить все сервисы так, чтобы нигде и никогда не пропустить ни одну проблему. Однако нельзя полагать, что дашборд на 1000+ метрик будет кому-то полезен, ведь в этом случае никто не знает наверняка, на какой именно график надо смотреть, чтобы найти нужную информацию

❇️ Подход 80/20

Хороший мониторинг помогает быстро понять, что происходит с приложением и куда смотреть в первую очередь. Для этого не нужно пытаться измерить всё: базовый набор технических метрик покрывает большинство типовых проблем (80%). А бизнес-метрики, SLO и анализ аномалий помогают заранее замечать нетипичные отклонения (20%).

🧬 Базовый набор для типичного бэкенда: RED-метрики для HTTP/gRPC, клиентов, очередей и баз данных.

❇️ В HTTP/gRPC-сервере замеряем три вещи:

🟢 Количество запросов. Тут мы можем увидеть, если кто-то решил спустить на нас DDoS или, наоборот, перестал это делать, а также если у нас куда-то утекает трафик

🟢 Ошибки, которые наш сервер отдаёт клиенту. В случае HTTP — это 4xx и 5xx, в случае gRPC — unavailable и прочее

🟢 Длительность запросов. Это помогает узнать, что сервер где-то начал подтормаживать или очень быстро отдавать что-то странное

Всё это даёт возможность понять практически любую проблему на стороне сервера.

❇️ В очереди смотрим на лаги:

Например, мы внесли в неё ряд данных, из-за этого там скопились сообщения, но по какой-то причине их не читают. Поэтому нам и нужны лаги — записанные сообщения минус прочитанные.

Эта метрика позволяет получить разницу позиций в очереди.

❇️ В БД следим за connection pool:

На стороне приложения есть клиентский пул, а между приложением и базой данных — отдельный серверный. Если наблюдать только за одним из них, отклонение на другом уровне останется незаметным, поэтому оба пула нужно включать в общий контур мониторинга.

Метрики клиентского пула обычно можно подключить через Spring Boot и Micrometer. Если в архитектуре есть отдельный серверный пул, его нужно мониторить на стороне компонента, который им управляет.

Такой контур помогает заметить риск заранее — до того, как он повлияет на запросы.

🔶 Читайте больше подробностей на Хабре. Там я поделилась золотыми метриками конкретно для Java-приложений и объяснила, как поймать 20% бизнес-специфичных. А также рассказала, как выбирать полезные алерты.

Подписывайтесь:
💬 @Yandex4Backend
📹 @YandexforBackend


19 last posts shown.