


🙂 А что, если ИИ читает старопечатные тексты слишком старательно?
Знакомимся со статьей Марии Левченко “Evaluating LLMs for Historical Document OCR: A Methodological Framework for Digital Humanities”. Автор исследует распознавание русских текстов мультимодальными LLM и предлагает подход к устранению методологических пробелов.
На корпусе из 1 029 страниц 428 уникальных русских книг 1750-1800 годов, напечатанных гражданским шрифтом, протестировали 12 мультимодальных моделей.
LLM действительно оказались сильны в OCR. При распознавании целой страницы Gemini 2.5 Pro показала CER (Character Error Rate) 3.36%. Для сравнения: у Tesseract этот показатель составил 21.55%, у Transkribus/PyLaia и Surya – еще выше: 26.93% и 45.96%.
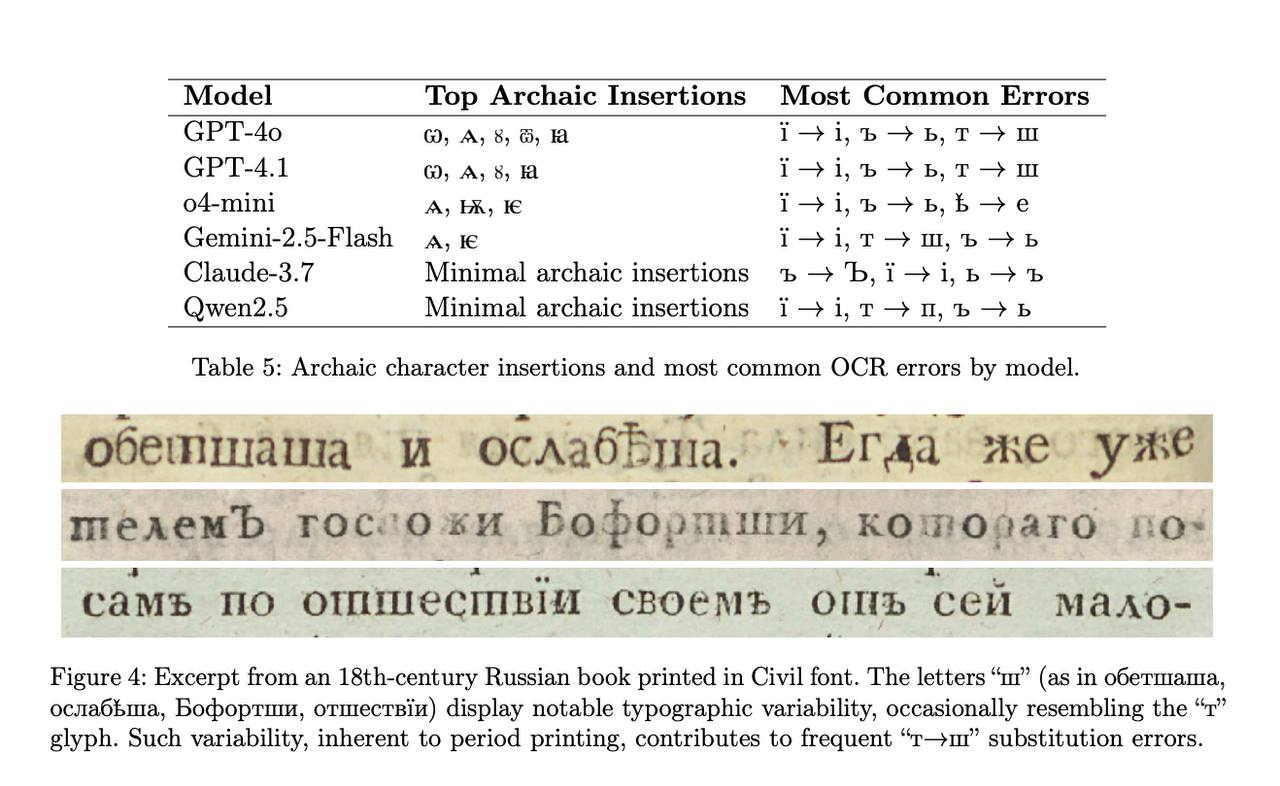
Интересно то, что порой LLM не просто распознают исторический текст, а уверенно «улучшают» его на свой лад: добавляют архаические графемы, которые на самом деле не соответствуют орфографии XVIII века, хотя и выглядят вполне правдоподобно. Например, модели нередко заменяют историческое ї на i. Автор называет это over-historicization (условно «переисторизация»).
В итоге автор предлагает расширить привычные OCR-метрики, добавив, в частности Historical Character Preservation Rate (HCPR) – чтобы выяснить, насколько хорошо модель сохраняет исторические графемы, и Archaic Insertion Rate (AIR) – насколько часто она добавляет архаические знаки, которых в оригинале нет.
Есть и ещё один важный результат. Автор сравнила распознавание отдельных срок, нескольких строк и целой страницы. Оказалось, что контекст заметно помогает: для Gemini 2.5 Pro CER снизился примерно с 9.35% для отдельных строк до 3.36% для целой страницы.
LLM действительно становятся очень мощными инструментами для работы с историческими источниками. Но, кажется, чем увереннее они «читают» старые тексты, тем важнее проверять, что именно они распознали – а что, возможно, додумали сами.