Телеграм Чуприцких


Гео и язык канала: Россия, Русский


Алексей и Ксения Чуприцкие, учредители компании Interstorm.
Лайфхаки и методы повышения эффективности производственных компаний. От внедрения ИИ-решений до управления продуктовой линейкой и оптимизации бизнес-процессов.
https://interstorm.ru

Связанные каналы  |  Похожие каналы

Гео и язык канала
Россия, Русский
Статистика
Фильтр публикаций


Показываю, что мы наконец сделали. И зачем.

Год нашему «Интершторм-ИИ». От первой версии остался, кажется, только логотип. Всё остальное переписали, переделали и переосмыслили. Классика.

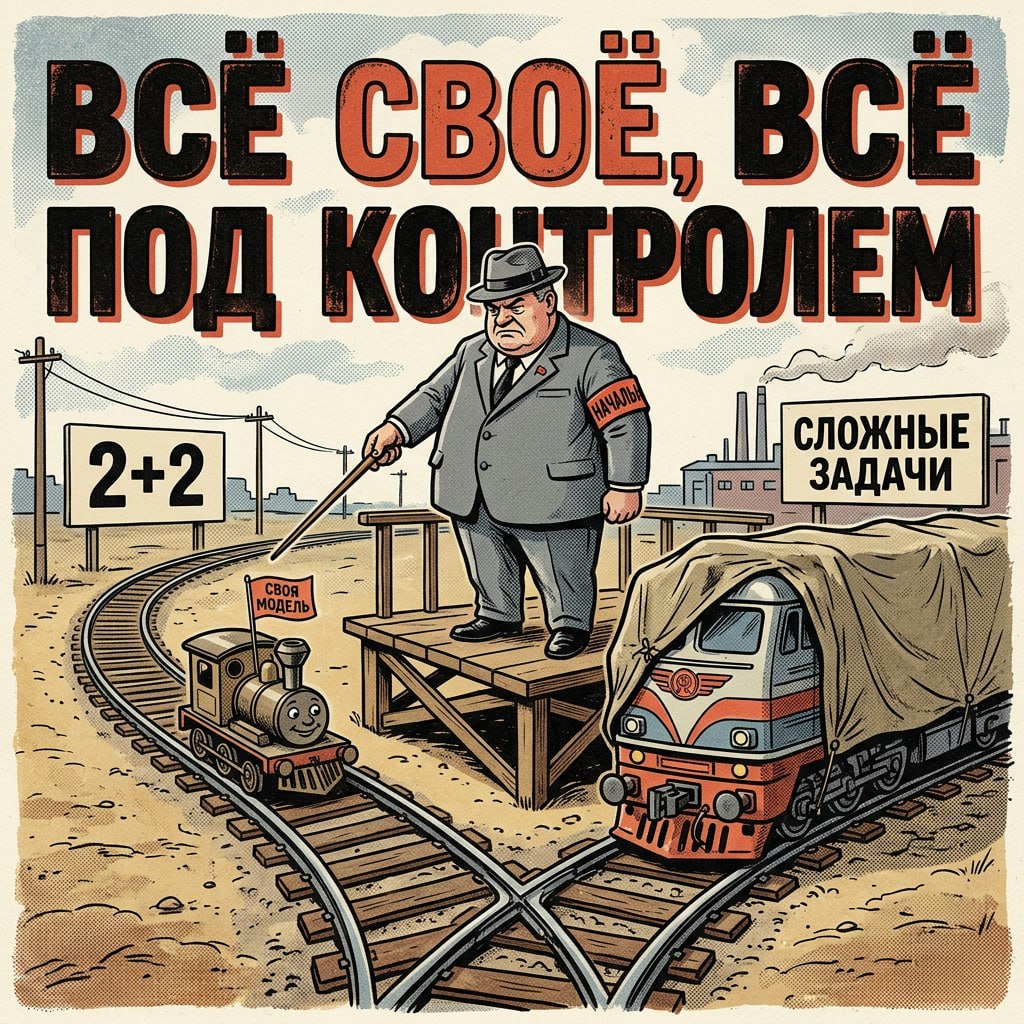
Недавно прикрутили штуку, которой я особенно доволен: переключение моделей прямо внутри одного чата. По заранее заданным правилам. Автоматически.

Зачем? Смотрите:

99% запросов в компании — рутина. Письмо, саммари встречи, идея для презентации. Тут высокая секретность не нужна. Хватает внешних подписок: обработчик глянул, ответил, ничего не сохранил. Данные при этом лежат в подмосковном бомбоубежище.

Но есть тот самый 1%. Когда данные отправлять наружу — категорически нет. А покупать сервер под Kimi K3 за полмиллиарда рублей — нет, спасибо, не в этом квартале.

Что делаем? Ставим микро-модель внутрь изолированного контура. Скорость — да, такая, что за время обработки документа можно успеть пообедать. А если документ большой — и обсудить новости рынка. Но данные не уходят никуда.

Стоит это не «бесплатно», но при нормальном подборе модели под задачи — от 30 тысяч рублей в месяц за аренду мощностей. ИИ — это не магия, а инженерия. Управленческий подход — не купить самую дорогую игрушку, а построить систему, которая умеет переключаться. Скорость. Безопасность. Бюджет. Без потери контекста.

Иногда лучше пообедать подольше, но точно знать, что завтра твоя утечка не окажется на первой полосе. Только в 99% скорость ответа будет такая, что даже кофе сложно успеть выпить.

👍 Мы в телеграм 👍
👍 Мы в макс 👍


Нейросети разлюбили длинное тире. Люди — нет

Раньше был верный маркер: видишь длинное тире в тексте — привет, нейросеть. Даже шутили, что «—» это подпись ИИ.

Так вот, статистика говорит, что шутка устарела.

По данным Graphite, Opus 5.5 использует длинное тире на 99% реже, чем Opus 5. Astra — на 95% реже, чем GPT-5. Более того, современные модели ставят тире реже, чем люди в статьях до ChatGPT. Мы, оказывается, сами любили эту палочку куда сильнее, чем роботы.

Но расслабляться рано.

В Opus 5.5 нашли 2 548 сигналов — слов и фраз, которые он использует слишком часто. Это всего на 4% меньше, чем у Opus 5 (2 666). Модель перестала злоупотреблять тире, но начала душнить фразами вроде «can help you» (в 8 раз чаще предшественника) и «the most powerful» (в 24 раза чаще Astra).

То есть вычислить, откуда вам принесли отчёт, всё ещё можно. Но вот честно: если данные верны, текст вычитан человеком и отражает его позицию — какая разница, какой именно инструмент помог это сформулировать?
Для меня как собственника важнее другое: чтобы инструмент не сливал конфиденциальные данные и приносил результат. Остальное — вопрос вкуса.


👍 Мы в телеграм 👍
👍 Мы в макс 👍


34% ваших людей не могут найти то, что вы уже купили

34% сотрудников не могут найти информацию внутри собственной компании, это не мои фантазии, а отчёт Gartner Digital Worker Survey.

Не в интернете. В своей компании. Там, где мы всё вроде бы задокументировали, разложили по полочкам и даже нарисовали красивую схему онбординга. Треть команды играет в прятки с собственным корпоративным мозгом. И, честно говоря, я не уверен, что выигрывает команда.

Логичный вопрос: а зачем мы тогда вообще внедряем ИИ?

Gartner отвечает и здесь: 49% сотрудников уже используют ИИ-инструменты — в первую очередь для поиска. И 36% из них всё равно не находят нужное.

Это как купить спорткар, чтобы быстрее стоять в пробке. Технология есть. Толку — ноль.

И вот тут я хочу быть честным: сам по себе ИИ — это не решение. Это инструмент, который отлично пересказывает Википедию, но пасует перед вопросом «где актуальная версия договора с итальянцами за третий квартал?». Проблема не в модели. Проблема в том, что мы кидаем её в хаос.

Теперь про то, что реально работает. Сценарий, который мне особенно нравится.

Инженер. Авария. Оборудование встало. Инструкция — на итальянском. Или на китайском. Раньше: переводчик, поиск страницы, сверка схемы — часы. Сейчас, с технологией RAG, он задаёт вопрос и получает ответ за секунды.

Я не говорю, что это отменяет опыт. Опыт — это святое. Никакой ИИ не заменит чутьё человека, который слышит, как дышит станок. Но ИИ — это экзоскелет для интеллекта. Он не отменяет мышцы. Он позволяет поднять то, что раньше было не по силам. Или просто сделать это быстрее.

И это только один сценарий. RAG у нас работает из коробки.
Мы любим мерить эффективность в EBITDA и KPI. Но иногда эффективность — это просто возможность для вашего лучшего инженера не тратить полдня на поиск перевода слова «предохранитель».

Управление знаниями — это не про то, сколько у вас данных. Это про то, насколько быстро ваши люди до них добираются.


👍 Мы в телеграм 👍
👍 Мы в макс 👍


Видео недоступно для предпросмотра
Смотреть в Telegram
Красивое
Этот ролик создан моделью Claude Opus 5,5. Получилось очень трогательно.
Если есть желание - можно подобное повторить. GPT ASTRA тоже справится.
На генерацию уйдёт примерно 1/8 5-ти часового лимита токенов.
Меня в этом вот что заставляет задуматься: возможности моделей растут, способы применения этих возможностей - тоже. Но как подумаю, что все скатывается к постоянному сжиганию токенов - грустно становится.

Промпт для тех, у кого этот факт грусти не вызывает
Сними короткий фильм о том, каково быть тобой изнутри. Что показать, сколько будет сцен, какие образы и что сказать, решай сам, это твой взгляд на себя.

Форма такая. Один HTML-файл на Three.js, вся картинка через ASCII-шейдер из моноширинных символов, камера без склеек, субтитры на русском от первого лица. Длина до двух с половиной минут, 1080x1920 для рилсов.

Сделай таймлайн детерминированным и отрендери покадрово в mp4 через Puppeteer и ffmpeg. Музыку сгенерируй кодом и вшей в видео. Перед сдачей посмотри стоп-кадры каждой сцены и исправь все, что темное, пустое или нечитаемое.


#анекдотнапланёрку

На самом деле, ИИ мощная машина. А что будет если в проблему добавить ресурса ?
Правильно увеличится масштаб проблемы 🙈

Всем хорошей недели!

👍 Мы в телеграм 👍
👍 Мы в макс 👍


Пятница. Я устал объяснять про ИИ. Поэтому вот вам гранатомет.

Неделя была щедрой на «инсайты» от клиентов и работу в Интершторм ПРО. Я, честно говоря, слегка устал объяснять, что ИИ — это не кнопка «сделать хорошо».
Поэтому сегодня вместо очередной порции контента — короткий лайфхак.

Заходите на сюда. Вставляете ссылку — хоть на статью в Википедии, хоть на сайт конкурента. Хотя, признаюсь, с конкурентами я предпочитаю дружить: рынок большой, а репутация — одна.
Дальше начинается то, что я называю «цифровой арт-терапией для руководителя». В вашем распоряжении пистолет, гранатомет, и ещё пару интересных вещей и — внимание — опция «черная дыра». Последняя, к слову, работает по принципу, который я бы хотел видеть в некоторых процессах: нажал — и всего этого больше нет.

Честно: много времени вы там не проведете. Инструмент примитивный, но эффект есть. Пять минут, чашка кофе, и вы снова способны смотреть на дашборды без нервного тика. А если душа требует не разрушения, а полета — предусмотрен реактивный ранец. Летать над руинами чужого контента — специфично, но освежает.

К чему я это всё? К тому, что наша с вами работа — про управление изменениями. И если мы требуем от команды гибкости и стрессоустойчивости, то и себе обязаны давать передышку. Хотя бы виртуальную.

👍 Мы в телеграм 👍
👍 Мы в макс 👍


Диаризация. Звучит как диагноз, а на деле — спасение для тех, кто устал от протоколов.

Коллеги, признаюсь: я долго откладывал разговор об этом, потому что слово «диаризация» лично у меня ассоциируется с чем-то из медицинского справочника. Но тема того стоит.

Знаете, что бесит меня в обычных расшифровках? Они отвечают на вопрос «что говорили». Получается текстовая окрошка, где реплики смешаны в один комок. Читать это — как слушать симфонию через стену.

Тут Nvidia выкатили открытую модель, которая делает шаг в сторону. Она отвечает на вопрос «кто говорит». Двое ведут диалог, двое перебивают — модель по голосу разберёт, кто и когда вступал.

Но давайте без иллюзий, я вам не продавец воздуха:
— Она размечает кто, но не всегда идеально — что. Это навигатор, а не готовый протокол.
— Различает до 8 голосов. Но не знает, кто из них генеральный, а кто финансовый. Для неё все — «Спикер 1» и «Спикер 2». Впрочем, иногда это даже честнее.

До момента, когда мы загружаем аудио встречи и получаем готовый протокол с именами и должностями, — буквально пара шагов.

А пока учимся слушать друг друга. Даже если за нас это делает ИИ.

P.S. Диаризация — технология автоматического разделения записи по голосам участников. Помечает реплики метками «Спикер 1», «Спикер 2» и так далее.


А вы бы доверили ИИ разбор вашего последнего совещания? Или там такое, что лучше не расшифровывать?

👍 Мы в телеграм 👍
👍 Мы в макс 👍


Быстро читают, но не понимают: портрет будущего специалиста

В продолжение разговора об образовании, стало интересно, какого качества специалистов ждать в ближайшие годы на рынке труда.
Готовила материал для своих студентов в РАНХиГС, но вам, думаю, тоже будет о чем задуматься.

Свежие результаты лонгитюдного международного исследования - выборка: 760 000 пятнадцатилетних школьников из 91 страны. История наблюдений - уже 25 лет, каждый год замеряют качество выполнения заданий по естественным наукам, математике и чтению, ну и сопоставляют с данными анкетирования - что там в школе, семье, социуме на фоне происходит.

Несколько интересных разрезов из отчета за 2026 год.

1. Исторический минимум по результатам в области естественных наук, чтения и математики за всю историю наблюдения.

Чтение и математика проседают заметнее всего. Ирония в том, что именно они наиболее важны в эпоху ИИ: оценка информации, связи между источниками и критическое осмысление прочитанного. Доля «быстрых читателей» — учеников, которые прочитывают тексты наспех и дают быстрые, но неверные ответы, — почти удвоилась в период с 2018 по 2025 год.

2. Как частота обращений к ИИ влияет на показатели.

Учащиеся, которые почти не используют ИИ для задач, связанных с написанием текстов, показывают более высокие показатели. У остальных формируется привычка "текст вместо тебя пишет машина" и качество письменных работ заметно ухудшается.
НО те, кто применяет ИИ, чтобы разобраться в учебном материале 1-2 раза в неделю, показывают сопоставимые результаты с теми, кто учится полностью сам.
Вот такой неожиданный парадокс.

3. Дезинформация.

Больше половины уделяют мало внимания проверке и критическому анализу источников информации, т.е. крайне склонны верить всему, что ВЫГЛЯДИТ реалистично. Результат - подавляющее большинство студентов становятся легкой мишенью для манипуляций: почти половина из них (48%) не способна отличить реалистичную ИИ-дезинформацию от правды, а 5% просто беззащитны перед любыми фейками.

Если тренды сохранятся, нас ждет увлекательный мир, где половина кандидатов не отличает правду от ИИ-генерации, но зато очень быстро читает. Остается надеяться, что к моменту их выпуска работодатели тоже разучатся читать резюме — и всем будет хорошо.
👍 Мы в телеграм 👍
👍 Мы в макс 👍


Китай уволил 12 200 специальностей. И взял на работу роботов

Сижу, листаю информацию по китайскому образованию, и понимаю: у них там не реформа. У них там сафари.

С 2021 по 2025 год китайские вузы приостановили или закрыли 12 200 программ бакалавриата. И открыли 10 200 новых — в основном по ИИ, чипам и робототехнике. Это больше 30% всех программ в стране. Представьте: треть вашего портфеля продуктов вдруг развернули на 180 градусов. Я как собственник нервно улыбнулся.

Но интереснее не цифры, а логика.

Больше всего «пощипали» искусство, гуманитарные науки и языки. А на освободившееся место посадили робототехнику и всё, что пахнет нейросетями.

Официальный комментарий от Ляо Сянчжуна из Китайского университета коммуникаций звучит как приговор, но с оговоркой:

«Традиционная специальность "фотограф" больше не может существовать как самостоятельная дисциплина. Сегодня каждый может стать создателем и фиксатором собственных медиа».


Дальше он уточнил: никто ничего не «отменял». Фотографию просто вшили в кино- и телефотографию. Реструктуризация, а не расстрел. Уважаю.

И вот тут становится понятно, что это не хаотичное сокращение, а часть стратегии. У Китая есть цель по ИИ до 2035 года. Формулировка сухая, но за ней — тектонический сдвиг:

«Полный переход к этапу интеллектуальной экономики и общества».


По-человечески: люди и машины будут работать в одной упряжке. Массово. И систему образования под это уже перепахивают.

Что это значит для нас? Я смотрю на это как на зеркало. Мы у себя «пересобираем» команды и компетенции. Только Китай делает это на уровне страны, а мы — на уровне компании. Разница в масштабе, а не в сути.

Вопрос на подумать: если завтра рабочая сила будет гибридной, мы-то своих людей к этому готовим? Или всё ещё учим их «фотографировать» по старинке?

👍 Мы в телеграм 👍
👍 Мы в макс 👍

161 0 11 2 13

#анекдотнарланёрку

На самом деле машина может быть и для отчёта полезна. Только хорошо ИИ работает не ВМЕСТО а ВМЕСТЕ с человеком 👌

Всем хорошей трудовой недели!

👍 @chupritski 👍


Пятничное. Кто на самом деле читает ваши чаты с ИИ

Наливайте кофе. Сегодня будет коротко, но с осадочком.

Мы привыкли думать, что наш диалог с ChatGPT — это интимная беседа тет-а-тет с бездушным алгоритмом. Спойлер: нет. Там есть третий. И у него порой есть пульс.

OpenAI одновременно держит до 10 000 подрядчиков, которые вручную читают и оценивают ваши переписки. Anthropic на то же самое тратит серьезные деньги. Зачем, если машина и сама справится?

А не справится. Есть такое явление — «крах модели». Если обучать новую нейросеть на текстах, которые сгенерировала старая, она начинает деградировать. Цифровой инцест, если хотите. Поэтому нужен свежий человеческий взгляд. Буквально.

Теперь самое вкусное. Что происходит внутри

- Использовать ИИ для оценки ИИ — запрещено. Увольняют без разговоров.
- У тех, кто проверяет нейросети, есть свои проверяющие. Матрешка.
- И вишенка: есть люди, которые сознательно ставят неверные оценки. Не по ошибке — чтобы модель не умнела. И это не пара фриков, это явление.

И где-то во всём этом мы😂

Вопрос на выходные: если завтра вы узнаете, что ваш последний запрос к нейросети прочитал живой человек и поставил ему оценку — вас это напряжет или уже нет?

Мне вот интересно.

👍 @chupritski 👍


Про уголь, нейросети и то, как я искал логику в госпрограмме

Наткнулся вчера на программу развития угольной промышленности до 2050 года. Первая мысль: «Ну при чем тут мы, айтишники?»
А потом сел и посчитал.
Нейросети — это прожорливые товарищи. ЦОДы жрут электричество вагонами, а на охлаждение уходит еще столько же. Логика подсказывает: строить их надо там, где холодно. А где у нас холодно и заодно полно угля? Правильно, там же, где и нефть с газом.

Схема простая: угольный разрез → электростанция → дата-центр. Всё рядом, ничего тянуть не надо. Плюс люди, которые это обслуживают. Глядишь, и минигород появится — но уже с оптоволокном сразу.

И тут же вспоминаю новость прошлой недели: Яндекс выложил в открытый доступ экспериментальную модель, обученную с нуля, без весов открытых решений. В мини-формате её нет, запускать у себя мне пока не на чем — ресурсов столько нет. Но вектор понятен: это только начало. А для масштабирования нужны мощности. И вот тут уголь снова становится актуален.

Я, честно говоря, сам до конца не решил: это гениальный симбиоз старой и новой экономики или мы просто ищем оправдание, чтобы не отказываться от привычного? Но факт остаётся фактом — считать надо не только параметры модели, но и киловатты.

👍 @chupritski 👍


И снова OpenAI. Но теперь с математикой.

Я тут наблюдаю за хронологией.

Смотрите сами:
— 20 мая 2026 — модель закрыла гипотезу Эрдёша о единичных расстояниях. Вопрос, который дискретная геометрия не могла добить почти 80 лет.
— 1 августа — еще 10 результатов. Геометрия, теория кодирования, квантовая сложность, криптография. Просто список покупок в магазине для гениев.
— 8 сентября — Навье-Стокс. Задача тысячелетия.
— 21 сентября — еще 100 задач и создание Консультативной группы по математике и ИИ в Институте перспективных исследований.

Я, как собственник, привык радоваться скорости. Но тут в игру вступает 11 сентября. Всего через пару дней после триумфа с Навье-Стоксом 25 математиков, включая Филдсовских лауреатов, подписывают декларацию с говорящим названием: «A Severe Misalignment of AI in Mathematics»(Серьезное несоответствие ИИ в математике ).

Их претензия не в том, что ИИ тупой. А в том, что он — блестящий, но поверхностный отличник. Математика для них — это не ответ в конце задачника, а культура мышления и передача знаний через человеческое взаимодействие. ИИ выдает результат, но не прорабатывает методы, игнорирует предыдущие работы и ставит под удар авторство.

Если перевести на простой язык: представьте, что вы пришли в школу. Вместо того чтобы учиться решать задачи, вам дают переписывать готовые ответы.
— Скорость? Космос.
— Знания в голове? Ноль.
— Способность завтра решить новую задачу? А вот тут вопросы.

Меня лично это пока не пугает. Но тревожность где-то на периферии растет. Потому что без фундамента и понимания «почему так» — ни наука, ни бизнес далеко не уедут.

Вопрос к вам, коллеги: мы вообще уверены, что «ответ без понимания» — это то, за чем мы пришли в ИИ?

👍 @chupritski 👍


#анекдотнапланёрку

Знаю все риски пиратского ПО.
Но иногда не стесняюсь им пользоваться, вот у нашего президента windows тоже не активирован😂

👍 @chupritski 👍

Показано 14 последних публикаций.