ген ИИ


Гео и язык канала: Россия, Русский


привет, я Алексей Сидорюк, а это мой канал, посвященный генеративному ИИ, ИИ-агентам, аналитике и трендам. Делюсь опытом использования решений на базе ИИ, кейсами, полезными инсайтами, личным взглядом на развитие ИИ в России и за рубежом.
Сайт: gen-ii.ru

Связанные каналы  |  Похожие каналы
Гео и язык канала
Россия, Русский
Статистика
Фильтр публикаций


👃 Можно ли научить ИИ определять запахи?

Друзья, привет,

увидел необычное исследование: ученые пытаются сделать для запахов то, что давно существует для цвета и звука - создать систему координат, в которой можно измерять сходство ощущений.

🎨 с цветом все относительно понятно. Мы можем описать оттенок числами, расположить его на цветовом круге, смешать с другим и примерно предсказать результат.

🔊 со звуком тоже: есть частота, амплитуда, спектр.

А запах до сих пор оставался почти «аналоговым». Кофе, яблочный пирог или запах человека состоят из десятков и сотен молекул. И по их химическому составу трудно заранее сказать, насколько похожими покажутся две смеси нашему носу.

Исследователи собрали единый набор данных: 168 отдельных молекул, 731 смесь и 507 сравнений пар запахов. Затем 26 команд обучали модели предсказывать, насколько похожими эти пары покажутся людям. Проверка проходила на скрытом наборе из 46 пар, которых модели раньше не видели.

Лучший результат дал не один алгоритм, а «совет» из шести сильнейших моделей. Этот ансамбль превзошёл прежние подходы, а затем сохранил качество на отдельном эксперименте с 50 новыми парами смесей.

И как вы думаете, на что опирался ИИ?


Сильнейшие модели использовали не только структуру молекул. Большую роль сыграли человеческие описания: «цветочный», «сладкий», «похожий на арбуз», «тухлое яйцо». Казалось бы, язык запахов беден и субъективен. Но именно слова помогли машине лучше восстановить расстояния между запахами в нашем восприятии.

Молекулы дают физическую основу, люди - ощущения и слова, а ИИ собирает из этого многомерную карту. Аккуратной палитры из нескольких базовых ароматов пока нет, пока это сложное математическое пространство.

🔬 Зачем это нужно? В перспективе - для разработки ароматов, цифрового обоняния и поиска изменений запаха тела, которые могут стать поводом для медицинской проверки. Но до «Shazam для запахов» или диагностики по одному вдоху еще далеко. Модель сама не нюхает и не доказала способность выявлять болезни - она пока решает более узкую задачу: предсказывает человеческую оценку сходства смесей.

Мне откликается этот кейс. Вчера в прямом эфире я предложил оценивать AGI именно по возможности решить задачу в реальном мире без предварительного обучения человеком. Например, пусть нейросеть как мозг робота доведет его из одной комнаты в другую, заварит кофе и принесет его обратно. И работа с ароматами как и работа с другими модальностями - это важная часть AGI.


А вы как думаете, ИИ нужно уметь работать с запахами?

#исследования

💬 ген ии | MAX


🤖 Почему 99,9% на бенчмарке - это ещё не AGI

Друзья, привет,

сегодня в 15:00 по Москве участвую в прямом эфире Ai4Dev «AGI уже здесь?». Кому позволяет график, тоже подключайтесь :)

Повод громкий: GPT-6 Astra показала 99,9% на ARC-AGI-3. Но дьявол кроется в деталях: в стандартной среде результат составил 62,7%, а 99,9% модель получила с адаптером, который сохраняет состояние рассуждений.

Именно здесь начинается интересный разговор. Что мы на самом деле измеряем: интеллект модели, способность выполнять задачи на уровне человека или эффективность всей системы вокруг нее (харнеса) - памяти, инструментов, агентной обвязки и участия человека?

Для меня AGI - это не модель, которая идеально проходит тест.

Общий интеллект должен уметь:
• осваивать действительно незнакомые задачи, а не узнавать знакомый шаблон;
• переносить полученный опыт между разными областями знаний;
• вести длинный проект без постоянного присмотра и Human in the loop;
• замечать собственные ошибки и менять стратегию;
• устойчиво работать не только в лаборатории, но и в реальных процессах.

В эфире поспорим, где проходит граница между сильной моделью и общим интеллектом, кому принадлежит результат, как распределяется ответственность между человеком и ИИ и на каких задачах по-прежнему ломаются любые модели.

Формат - час живой дискуссии без презентаций.

🔴 Подключайтесь сегодня, 7 октября, в 15:00 МСК: прямая трансляция

И напишите в комментариях: что должен сделать ИИ, чтобы лично вы признали: «да, это уже AGI»?

#live

💬 ген ии | MAX


🕵️ ChatGPT начнёт оставлять в текстах невидимый след

Друзья, привет,

По поводу маркировки сгенерированного контента сейчас идут дебаты и даже выложен законопроект на сайте Думы.

Я всегда считал, что можно маркировать аудио контент (через мета-данные или отдельную пустую музыкальную «дорожку»), видео контент (25 кадр, мета-данные и другие способы). Но как маркировать текстовый сгенерированный контент для меня всегда было загадкой.

Даже если контент сгенерирован и определяется детекторами, то можно написать «перепиши так, как это сделал бы человек» и системы уже не могут задетектировать сгенерированный контент.

Но, кажется, что OpenAI всерьез взялся за эту проблему. В ближайшие недели компания начнёт маркировать часть текстов ChatGPT и Codex для пользователей в Евросоюзе. Маркировка появится на всех тарифах, но только у подходящих под условия пользователей в ЕС. В API её уже можно включить добровольно для отдельных моделей из любой страны.

Это не плашка «создано ИИ» и не запись в свойствах файла. Технология textGrain слегка меняет выбор слов во время генерации и встраивает в текст невидимый статистический сигнал. Специальный детектор затем ищет этот рисунок. Человек при чтении ничего не увидит.

Почему OpenAI делает это сейчас? Статья 50 европейского AI Act требует, чтобы синтетические тексты, изображения, аудио и видео были отмечены в машиночитаемом формате и распознавались как созданные или изменённые ИИ.

Отдельно Еврокомиссия разрабатывает кодекс практики, который должен уточнить, как именно выполнять требования к маркировке.

🔍 Но водяной знак довольно хрупкий. При целевой доле ложных срабатываний 1% детектор находил метку примерно в 80% фрагментов длиной 200 токенов и в 95% фрагментов по 400 токенов. Замена синонимами всего 10% слов снижала обнаружение с 92% до 66%. После замены четверти слов метка сохранялась лишь в 17% случаев.


Поэтому отсутствие сигнала не доказывает, что текст написал человек. Его могли отредактировать, перевести, сократить или получить в другой модели. И наоборот, найденная метка не определяет автора, не раскрывает промпт, не измеряет вклад человека и ничего не говорит о достоверности текста.

Доступ к детектору пока получат только одобренные исследователи и профильные организации. OpenAI опасается, что публичный инструмент будут использовать как безошибочный «детектор списывания», хотя сама технология такой гарантии не даёт.

И еще есть один вопрос, который мне не дает покоя. Если добросовестные участники рынка создадут маркировку контента, не приведет ли это к популярности сервисов недобросовестных участников и открытых моделей?

А вы бы хотели видеть такую проверку встроенной в браузер, мессенджеры или сервисы?

#маркировка

💬 ген ии | MAX


⚡️ Почему ИИ не работает без качественных данных или зачем идти на Data & AI Talks 7.0

Друзья, привет,

Я к вам с очередным анонсом (да, осенью ОООЧЕНЬ много качественных мероприятий).

15-16 октября 2026 года Ростелеком с дочерними организациями и партнерами проводит мероприятие Data & AI Talks 7.0.

16 октября я буду выступать в онлайне по теме ИИ-агентов для руководителей (расскажу про Штурман и как руководителю работать по-новому), в расписании это появится чуть позже, но будет трансляция онлайн.

Главная мысль конференции кажется очевидной, но на практике о ней постоянно забывают: любой ИИ-проект упирается в данные. Не только в их объем, но и в качество, доступность, безопасность и понятную экономику.

Что будут обсуждать:
- сколько бизнесу на самом деле стоят плохие данные
- как защищать данные, когда к ним получает доступ ИИ
- чем генеративный ИИ уже сегодня помогает дата-инженеру
- как считать финансовый эффект от ИИ, а не ограничиваться красивым пилотом
- что нужно, чтобы эксперимент превратился в работающий промышленный сервис

Программу разделили на два дня. 15 октября 2026 года - стратегический день: очно в Москве и онлайн. 16 октября - технологический день, полностью онлайн.

Если вы отвечаете за данные, ИИ-продукты, архитектуру или цифровую трансформацию, стоит заглянуть. И да, вы можете также подать заявку на доклад и выступить спикером на официальном сайте.

Участие бесплатное, программа и форма регистрации тут.

#анонс

💬 ген ии | MAX


🏭 Промышленный ИИ в 2026 году

Друзья, привет,

В конце аж 2024 года (как быстро течет время!) мы делали с Минпромторгом России исследование по практикам применения ИИ в промышленности. Это была фундаментальная работа, где мы отсмотрели больше 250 кейсов и 76 из них отобрали для сборника.

На днях вышел альманах Института ИИ МФТИ об искусственном интеллекте в промышленности. Это просто фантастика, как оформлен отчет (вы это уже увидели в скриншотах)!

В альманахе представлено 17 сценариев: от предсказания поломок и контроля качества до автономных самосвалов и поиска по техдокументации.

Примеры кейсов с экономическим эффектов:
- сокращение простоя оборудования на 7 часов оценивается в 65 млн рублей;
- оптимизация технологического процесса дала рост производительности на 11,4% и эффект 254 млн рублей в год;
- интегрированное планирование производства - до 7% прироста EBITDA;
- оптимизация цепочек поставок - минус 20% складских издержек и 2,76 млрд рублей эффекта в год;
- компьютерное зрение при сортировке руды - около 115 млн рублей на одной площадке;
- автономные буровые установки - 2% прироста добычи и 457 млн рублей в год.

Интересно также раскрыта роль генеративного ИИ. В промышленности он не заменяет физику процесса и не управляет заводом «из чата». Его сильная роль заключается в том, чтобы работать поверх уже созданного цифрового контура.

Два интересных сценария применения ген ИИ:

1️⃣ Проверка BIM-моделей, спецификаций и проектной документации. Потенциал - предотвращение до 40% ошибок и 158 млн рублей эффекта в год.

2️⃣ RAG-помощник по регламентам, чертежам и инструкциям. Поиск нужной информации ускоряется в 5 раз, оценка эффекта - 43 млн рублей в год.

То есть LLM в промышленности - не фундамент, а верхний этаж. Под ним должны быть IIoT, сенсоры, цифровые двойники, интеграция с АСУ ТП, MES и ERP, вычислительная инфраструктура, машинное зрение и предиктивная аналитика. Если этих этажей нет, красивый ассистент будет бесполезным и отвечать только общими знаниями.

И ещё важная оговорка: часть цифр в альманахе - оценки МФТИ или публичные данные участников проектов. Авторы прямо пишут, что не во всех случаях могли независимо подтвердить методики расчёта и фактический эффект.

Альманах приложил к посту, настоятельно рекомендую ознакомиться всем, кто работает в промышленности 👇👇👇

#аналитика

💬 ген ии | MAX

350 0 14 3 11

Итоги деятельности российского финтеха за 10 лет

Друзья, давно я не делал анонсов, но тут большой повод.

6 октября на форуме «ФинТех х10» участники рынка подведут итоги десятилетия российского финтеха. Вместе с представителями Банка России участники будут разбирать ключевые события, которые оказали влияние на развитие российского финтеха. Но значительная часть разговора будет посвящена уже не прошлому, а следующему технологическому переходу - ИИ-трансформации финансового рынка.

В 10:00 форум откроется пленарной сессией «10 лет финтех-отрасли в России - ключевые результаты и вопросы развития финансовых технологий».

Модератор:
Максим Григорьев, генеральный директор Ассоциации ФинТех.

Спикеры:
• Зульфия Кахруманова - заместитель председателя Банка России
• Ольга Скоробогатова - первый заместитель президента - председателя правления Банка ВТБ
• Николай Козак - член правления, управляющий директор ДОМ.РФ; заместитель председателя правления ДОМ.РФ Банка
• Ольга Мямлина - заместитель председателя ПСБ
• Яков Сергиенко - партнер, руководитель компании «Яков и партнеры»

Один из центральных вопросов пленарной дискуссии - переход от экосистем и открытых платформ к экономике ИИ-агентов. Станет ли он продолжением привычных бизнес-моделей или радикально изменит роль банков и их отношения с клиентами?

ИИ проходит через всю программу форума. Будут обсуждаться следующие темы:

- Как агентская экономика изменит банковские продукты?
- Кто выиграет битву за клиента: банк, маркетплейс или независимый ИИ?
- Что означает переход к модели AI-native для финансовых организаций?
- Как искусственный интеллект уже изменил повестку CIO?
- Какая облачная инфраструктура нужна для развития ИИ?
- Где искать людей и компетенции для новой технологической эпохи?
- Когда в разработке можно довериться ИИ, а когда программисту всё-таки стоит взять клавиатуру в свои руки?

Конечно, обсудят и результаты прошедшего десятилетия: СБП, биометрию, общую финансовую инфраструктуру, платформизацию и конкуренцию между банками. Но главный вопрос форума звучит уже иначе: какой проект станет следующим СБП и какую роль в нём сыграет искусственный интеллект?

📍 6 октября, с 10:00 Международный мультимедийный пресс-центр МИА «Россия сегодня», Зубовский бульвар, 4

👉 Программа и регистрация на форум

‼️ Регистрация закроется 2 октября в 20:00, так что лучше зарегистрируйтесь сегодня

#анонс

💬 ген ии | MAX

503 0 13 2 14

Видео недоступно для предпросмотра
Смотреть в Telegram
🤑 ИИ уже помогает зарабатывать, но только тем, кто разбирается в инвестициях

Друзья, привет,

мы с партнерами red_mad_robot выпустили новый эпизод подкаста 2TOK про инвестиции, трейдинг.

Посмотреть его можно на YouTube и в VK Видео. Кстати, подпишитесь, если еще нет.

Главный вопрос, по которому мы с Ильей Филипповым мучали наших гостей: можно ли отдать ИИ не только аналитику, но и право покупать за нас финансовые инструменты на инвестиционном рынке?

Примечательно, что у наших гостей ответы почти противоположные (да-да, мы специально так подбираем спикеров, чтобы получилась интересная дискуссия):

• Евгений Коган, инвестбанкир с 35-летним стажем и основатель медиахолдинга bitkogan, предлагает относиться к ИИ как к очень быстрому младшему аналитику. Он соберёт данные, сравнит компании, найдёт закономерности - и так же уверенно может ошибиться. Поэтому решение и ответственность должны оставаться у человека.

• Вячеслав Благирев, директор по инновационному развитию продуктов «Финама», видит другую сторону. За год упоминания ИИ в работе трейдеров выросли в 8 раз. А 8% опрошенных трейдеров (примерно каждый двенадцатый) пришли в профессию без классического обучения, осваивая её с помощью ИИ, и уже зарабатывают деньги. Правда, выборка ограничена: 60 интервью и около 40 кабинетных исследований, а не весь рынок.

Но самая показательная цифра другая: 9 из 10 трейдеров готовы использовать ИИ как «второй мозг», но не готовы доверить ему исполнение сделок.

И это, на мой взгляд, правильная граница на сегодня. ИИ отлично расширяет возможности человека: быстрее читает отчетность, проверяет гипотезы, помогает написать и протестировать стратегию, разбирает ошибки и даже работает как психолог трейдера. Но он не несет ответственность за убыток. Если агент потерял ваши деньги, виноват не агент - решение передать ему управление всё равно приняли вы.


В выпуске спорим, способен ли алгоритм учесть инсайд и манипуляции, чем ИИ отличается от обычного алготрейдинга, можно ли просчитать Трампа и не стал ли сам рынок ИИ новым пузырём.

Приятного просмотра, ну а мы будем рады вашим комментариям.

А вы готовы доверить ИИ свой кошелек?

#2TOK

💬 ген ии | MAX


🏋️ ИИ-агент в роли финтес-тренера

Друзья, привет,

Давно я не писал про кейсы личного применения ИИ-агентов. А ведь вы поставили аж 40 🔥🔥🔥 под прошлым постом.

Прочитал интересный пост на Хабр от разработчика, который собрал себе силового тренера прямо внутри Claude Code и выложил его в Open Source.

Автор быстро поймал знакомую проблему: модель уверенно предлагает рабочий вес, взятый непонятно откуда, и может ошибиться в арифметике по двум месяцам логов. Поэтому роли разделили. Claude выбирает методику, объясняет решения и задает вопросы. Все цифры считает обычный скрипт на Node.js.

🧠 "Под капотом" получилось неплохая система:

- 8 навыков и 8 специализированных субагентов;
- импорт старого дневника, в том числе по фотографиям;
- план тренировки с весами, разминкой и раскладкой блинов;
- голосовой отчёт с телефона;
- расчёт рекордов, застоев и признаков усталости;
- больше 400 юнит-тестов и eval-сценарии на живой модели.

Мне особенно понравилось простое правило: у каждой цифры в ответе должна быть команда кода, которая ее посчитала. Расчет максимума, тренды, рекорды и отклонения от прошлых тренировок проходят через детерминированный код. Модель может интерпретировать результат, но не притворяется калькулятором.

ИИ-агент также контролирует физическую безопасность. До первой программы тренер проводит анкету PAR-Q+. При опасных симптомах останавливает тренировку. Запросы на дозировки стероидов блокирует.

Но автор честно предупреждает: помощник не видит технику, не ставит диагнозы и не заменяет врача или живого тренера.

Вот ссылка на сам репозиторий на GitHub.

А вы бы доверили составление программы тренировок ИИ?

Ну и ставьте 🔥, если хотите больше разборов кейсов личного применения ИИ-агентов

#личное

💬 ген ии | MAX


🛡️ Безопасность ИИ становится измеримой

Друзья, привет, с началом рабочей недели вас!

Пока Бил Гейтс говорит о возможной утрате контроля над ИИ и необходимости большего регулирования ИИ на уровне государства и межгосударственных структур, наши компании разрабатывают решения и методики по контролю.

Недавно изучил новую методику оценки киберзащищенности ИИ SAIMM v2.0 от Swordfish Security. Меня порадовала рабочая Excel-модель: отвечаете на вопросы, получаете профиль зрелости и конкретные шаги, как улучшить ситуацию.

Что внутри?

- 7 доменов: управление и риски, данные и приватность, безопасность модели, цепочка поставок, инфраструктура и эксплуатация, агентные системы и RAG;

- 60 критериев, каждый оценивается от 0 до 4: от полного отсутствия практики до адаптивного процесса, который измеряется и улучшается;

- 18 блокирующих вопросов. На мой взгляд, это самая интересная часть модели: высокий средний балл не позволяет спрятать критическую дыру. Одна блокирующая практика с оценкой 0–1 ограничивает зрелость домена первым уровнем, а две - нулевым. Например, если у компании нет правовых оснований обработки данных, на которых обучается ИИ-решение

- 52 активности развития с переходами между уровнями. Для каждой можно назначить ответственного, срок, статус и критерий готовности.

🔍 Отдельно радует, что агенты и RAG здесь также учтены. Для агентов проверяются инструменты и плагины, память, HITL, валидация планов, аудит действий, бюджеты и реагирование. Для RAG - источники, права на уровне фрагментов, инъекции через документы, качество поиска, дрейф эмбеддингов и цепочка поставок компонентов.

Критерии сопоставлены с таксономией угроз и мер защиты Swordfish Security, а уровни зрелости — с CMMI и ISO/IEC 33020. На официальной странице также заявлен учёт 187-ФЗ, приказа ФСТЭК №117 и российских ГОСТов в области ИИ.

⚠️ Важный нюанс: «общий уровень зрелости» здесь справочный. Усреднять безопасность агента, данные и инфраструктуру в одну красивую цифру опасно. Польза SAIMM именно в профиле по доменам и блокирующих вопросах.

Хороший фреймворк не просто перечисляет угрозы. После него понятно, что делать, кто отвечает и по какому признаку работа принята. SAIMM v2.0 выглядит именно таким инструментом. Но также напомню, что у организации должны быть определены недопустимые события и потенциальные векторы атак, один из которых может проходить через вычислительную инфраструктуру или ИИ-решение. Ну и как следствия, должны быть определены и реализованы механизмы защиты

А у вас безопасность ИИ уже измеряется как процесс или пока зависит от нескольких энтузиастов?

PS: в первом комментарии приложу сами документы 👇

#кибербез

💬 ген ии | MAX


Агенты_заменили_программистов?.pdf
4.9Мб
🤖 Как ИИ дизраптит процессы в сфере ИТ

Друзья, привет, с окончанием рабочей недели вас!

Недавно мы выпустили подкаст 2ТОК об агентной разработке с Рафаэлем Тонаканяном из Сбера и Валерием Ковальским из red_mad_robot. Кстати, если еще не видели - есть на YouTube или VK Video.

Теперь вместе с аналитическим центром red_mad_robot подготовили материал к выпуску - с цифрами и кейсами.

Кстати, почитайте, если хотите разобраться с этими новыми терминами: вайбкодинг, Spec-Driven Development, промпт-, контекст-, харнесс-, агентный, loop- и graph-инжиниринг.

Главный парадокс: ИИ ускорил написание кода, но выпуск готовых решений ускорился намного меньше.

Исследование на выборке из 100 тысяч разработчиков GitHub показало: объём написанного кода вырос в 8 раз, а число релизов - лишь на 30%. Узкое место переехало из кодинга в постановку задач, архитектуру, ревью, безопасность и принятие решений.

1️⃣ Код разрабатывается быстрее, чем мы умеем его проверять

ИИ для генерации кода используют 77% опрошенных Ассоциацией Финтех, для тестирования и QA - 73%, автономных агентов - 59%. Но автоматизированный код-ревью используют лишь 40%, а поиск уязвимостей - 39%.

2️⃣ Личная продуктивность растет быстрее продуктивности компании

95% респондентов говорят, что разработка стала быстрее. Но влияние ИИ на качество разделило участников поровну: 41% видят улучшение, ещё 41% - ухудшение.

На уровне бизнеса разрыв ещё заметнее: влияние на EBIT увидели 37% компаний, а прирост от 5% и выше - только 6%.

3️⃣ Сэкономленное время уходит на контроль

В среднем ИИ высвобождает около 10 часов в неделю. 45% специалистов меньше времени пишут код, но 42% больше времени тратят на ревью. Профессия не исчезает, но труд переносится из исполнения в проверку, архитектуру и оркестрацию агентов.

4️⃣ Ускорение без новых процессов создает технический долг

Когда агенты генерируют больше изменений, чем команда способна осмыслить, через несколько месяцев можно получить кодовую базу, архитектуру которой уже никто из людей не понимает. Она работает сегодня, завтра станет дорогой проблемой внутри организации.

5️⃣ Программиста может заменить не ИИ, а другой сотрудник

Его может вытеснить специалист, который соединяет разработку, работу с агентами и экспертизу в предметной области. Ценность смещается от «написать больше строк» к «принять решение, поставить задачу, построить проверку и довести результат до продакшена».

Агентная разработка не убирает разработчика из процесса. Она поднимает его уровнем выше - туда, где принимаются решения и создаётся бизнес-ценность.


А вы используете ИИ в процессах разработки? Напишите в комментариях 👇👇👇

#2TOK

💬 ген ии | MAX


Сборник лучших практик соблюдения этики ИИ в финансовой отрасли

Друзья,

неделя релизов и новинок продолжается :)

В 2026 году Банком России совместно с Ассоциацией ФинТех (АФТ) и Альянсом в сфере ИИ была создана рабочая группа по этике в сфере ИИ на финансовом рынке в рамках отраслевого клуба «ИИ в финансах».

Сегодня мы публикуем результат ее работы - cборник лучших практик соблюдения Кодекса этики в сфере разработки и применения искусственного интеллекта на финансовом рынке.

Напомню, что в 2025 году Банк России опубликовал Кодекс этики в сфере разработки и применения искусственного интеллекта на финансовом рынке (писал об этом тут).

Эти документы - основа мягкого регулирования ИИ финансовой отрасли. Их цель - повышение доверия к ИИ на финансовом рынке, продвижение ответственных практик внедрения технологии и минимизация связанных с ней рисков.


Для меня ценность сборника в том, что он переводит разговор об «ответственном ИИ» с языка общих принципов на язык конкретных решений: кто отвечает за модель, как оценивать риск, когда подключать человека, что объяснять клиенту и как действовать при ошибке.

В основе пять принципов:

• человекоцентричность
• справедливость
• прозрачность
• безопасность, надёжность и эффективность
• ответственное управление рисками

В сборнике описаны подходы и реальные примеры для семи направлений: от системы управления рисками и виртуальных ассистентов до скоринга, анализа рисков операций, финансовой доступности и внутренних ИИ-сервисов.

Что особенно важно на практике для организаций:

- вести единый реестр ИИ-моделей, назначать владельцев и присваивать уровень риска;
- оставлять человеку возможность пересмотреть решение ИИ, а клиенту - перейти к сотруднику;
- прямо обозначать, что ответ создан ИИ, раскрывать ограничения и не маскировать рекомендацию под «нейтральную подсказку»;
- проверять качество данных и модели не только перед запуском, но и в эксплуатации;
- фиксировать ИИ-инциденты, жалобы и действия по устранению последствий;
- учитывать уязвимые группы: возраст, образование, ограниченные возможности и уровень финансовой грамотности.

В сборнике есть примеры из банков, страховых компаний и инфраструктурных организаций: ассистенты, инвестиционные помощники, кредитный рейтинг, антифрод, инклюзивные сервисы и корпоративные базы знаний.

При этом авторы честно оговаривают: включение кейса - не знак качества и не подтверждение эффективности сервиса, а иллюстрация одного из возможных способов соблюдать Кодекс.

Этичный ИИ начинается не с декларации намерений, а с комплекса технологических и организационных мер. С реестра моделей. С понятного владельца риска. С права человека оспорить решение. С мониторинга после запуска. И с готовности остановить систему, если она причиняет вред.


А у вас этика ИИ уже встроена в жизненный цикл создания продуктов?

PS: cам сборник приложу к первому коментарию

#этика

💬 ген ии | MAX


🤖 GAIN 2.0: открываем самодиагностику для организаций в beta-режиме

Друзья, привет, у нас отличная новость!

В январе 2025 года мы показали первую версию GAIN (Generative AI iNdex или индекс генеративного ИИ) - методику оценки готовности организаций к внедрению генеративного ИИ. С тех пор мы получили много обратной связи и существенно переработали подход.

Сегодня мы представляем GAIN 2.0. Главное изменение: теперь мы оцениваем не просто наличие инфраструктуры, пилоты и компетенции команды, а способность организации превращать генеративный ИИ в управляемый, безопасный и измеримый бизнес-результат.

Что изменилось по сравнению с первой версией:

1️⃣ От готовности - к зрелости практик. Раньше в основе были четыре направления: организационная, технологическая, финансовая и правовая готовность. Теперь их шесть: стратегия и управление; сценарии и ценность; люди и изменения; данные, технологии и эксплуатация; риски и ответственное применение; экономика и эффект.

2️⃣ Обновленные стадии развития. Вместо категорий «начинающие - продвинутые - профессионалы - лидеры» появились четыре наблюдаемые стадии: исследование, пилотирование, масштабирование и системное управление.

3️⃣ Анализ организации по 6 направлениям. GAIN показывает профиль по всем шести направлениям, уверенность оценки и критические ограничения. Например, отсутствие правил управления рисками или измеримого эффекта нельзя скрыть высоким баллом за технологии.

4️⃣ Два формата диагностики. Самодиагностика - быстрый экспресс-анализ из 18 вопросов, который вы можете пройти за 15 минут. Также есть полноценная диагностика с брифингом, углубленной проверкой практик применения ИИ, документов и результатов с участием ключевых функций организации.

И ещё важное: мы открыли самодиагностику в beta-режиме. Вы можете пройти самостоятельно и бесплатно.

В ней 18 основных вопросов по шести направлениям, два уточнения и блок барьеров. На выходе вы сразу получите предварительный индекс, стадию зрелости, профиль сильных и слабых сторон, а также ограничения для дальнейшего масштабирования. Ответы сохраняются в браузере и не отправляются на сервер.

Это не полноценный аудит, а возможность быстро собрать общую картину и подготовить предметный разговор о следующем шаге.

Пройдите диагностику и напишите в комментариях: насколько результат совпал с вашим ощущением? Ну и что стоит улучшить, пока инструмент находится в beta-режиме?

#полезное

💬 ген ии | MAX

486 0 12 1 13

Jev. Принципиально новый подход работы с ИИ или просто классификатор?

Друзья, привет, неделя релизов продолжается.

Наткнулся на подробный разбор Jev на хабре - новой модели от TypeSafe. Через два дня после запуска браузерный агент уже искал авиабилеты за семь секунд, появился торговый бот, а разработчик заявил, что за час пересобрал Tesla Full Self‑Driving на Jev. Ещё через день Jev появился в шлюзах, базах данных, плагинах и фильтрах контента.

Но самое интересное здесь не просто новая нейронка, а принципиально иной способ работы с ИИ.

Обычная LLM генерирует текст, JSON или код. Jev работает иначе: разработчик заранее задаёт конечный набор допустимых решений, а модель распределяет между ними вероятности.

Три базовых режима:
• Noul - ответ «да/нет»;
• Choice - выбор варианта из списка;
• Score - оценка по шкале от 2 до 10.

Например, обращение клиента можно одним запросом проверить на срочность, направить в нужный отдел и оценить уровень раздражения. Модель не сможет внезапно написать стихотворение, вернуть системный промпт или дать неправильную консультацию.

И это радикальный метод борьбы с галлюцинациями. Да, модель может по-прежнему неправильно выбрать варианты или не так проставить оценку. Но при этом пространство для ошибки сужается.

При этом нейронка работает в основном меньше одной секунды и потребляет в сотни раз меньше токенов.

✈️ Пример кейса: поиск авиабилетов за 7,073 секунды. Агент сделал 17 запросов к Jev, 11 действий в браузере и два обращения к другой модели для генерации текста. На Jev пришлось 90 558 входных токенов и около $0,0038. Бронирования не было: агент только нашёл результаты Google Flights, а первоначальная навигация и финальная проверка не вошли в таймер.


То есть Jev - не замена LLM и не универсальный «мозг агента». Скорее, это быстрый и дешёвый слой принятия решений между моделью и обычным кодом.

Где он выглядит особенно уместно:
• маршрутизация запросов между моделями и инструментами;
• модерация, классификация и ранжирование;
• проверка действия агента перед исполнением;
• выбор следующего шага из разрешённого списка.

А генерацию текста, кода, планов, работу с датами и необратимые действия авторы рекомендуют оставлять другим моделям и обычному коду.

По мне главная идея Jev - не «модель без галлюцинаций», а архитектура с ограниченной свободой. Ну и работа в формате JSON в режиме близком к реальному времени дает возможность автоматизации.


Это может сделать агентов быстрее и безопаснее. Но только если нужный ответ есть в списке, состояние собрано корректно, а опасное действие проверяет не сама модель.

Как вам такой подход: шаг вперёд для ИИ-агентов или просто хорошо упакованный классификатор?

PS: к самой нейронке через консоль пока доступа нет (не справляется с нагрузкой), но как появится, протестируем :)

#релиз

� ген ии | MAX


🧠 Яндекс выложил свою ИИ-модель и веса к ней в открытый доступ

Друзья, привет,

С началом рабочей недели вас! Я с хорошими новостями.

Яндекс открывает Alice AI Foundation LLM - собственную базовую модель, обученную с нуля, без использования готовых весов зарубежных моделей. Причём под очень удобной лицензией Apache 2.0: её можно брать за основу коммерческих и исследовательских решений.

Что внутри:

- архитектура Mixture of Experts;
- 80 млрд параметров, но при каждом запуске активны только 3 млрд (работает один эксперт), что дает более быстрый инференс и ниже стоимость работы;
- обучена на 18 трлн токенов - огромном объёме текстовых данных;
- способности к рассуждению, программированию и работе в агентных сценариях;
- открытые веса, технический отчёт и два русскоязычных бенчмарка.

Mixture of Experts (MoE) или дословно «смесь экспертов» - это архитектура нейронных сетей, в которой вместо одной большой монолитной модели используется множество специализированных мини-подсетей («экспертов») и диспетчер, который выбирает наиболее подходящих из них для каждой конкретной задачи.


По данным Яндекса (а других данных у нас пока нет), на олимпиадной математике модель делит лидерство с Qwen3.5-35B-A3B-Base. В задачах на код превосходит NVIDIA Nemotron-3-Super-120B-Base, используя в четыре раза меньше активных параметров. А в тестах на фактические знания обходит DeepSeek-V4-Flash-Base с 284 млрд параметров и 13 млрд активных.

Ждем проверок независимых экспертов на реальных задачах, длинном контексте, русском языке, коде и агентных сценариях.

🔍 Примечательно, что Яндекс открыл не только веса, но и WikiWebFacts и HardMultiQA. Первый проверяет знание дат, событий, определений и персоналий. Второй собран на основе анонимизированных запросов к Алисе AI и включает вопросы из медицины, права, IT и искусства. Опубликованы также эталонные ответы и полный протокол оценки - значит, результаты можно воспроизводить, а не просто цитировать со слайда.

Есть и менее заметная, но важная инженерная часть. Параллельная передача данных между видеокартами примерно вдвое ускорила шаги оптимизации. Каскад классификаторов сократил вычисления при подготовке обучающего корпуса в десятки раз, сохранив около 95% полезных документов. Без этого полный отбор данных потребовал бы более 200 тысяч GPU-часов.

Перед нами не «убийца мировых LLM», а более фундаментальная вещь - заявка на независимый русскоязычный стек и модель для сборки других решений. Своя базовая модель, свои данные, свои бенчмарки, открытые веса и возможность запускать всё на собственной инфраструктуре. Ну и да, видимо, у нас в России будет еще одна суверенная модель


Ссылка на модель на HuggingFace

А вы уже готовы потестировать?

#релиз

💬 ген ии | MAX

668 0 21 3 17

Душа русского искусственного интеллекта

Друзья, как прошла рабочая неделя? Можно выдохнуть?

На выходных рекомендую почитать отчет СберТеха «Тренды технологий à la russe 2026». Оформление - просто эстетический оргазм. И внутри немало интересного про российский ИИ. Лично меня умилило название проекта испытания беспилотных трамваев «Львенок» 🦁.

Тему «русской души» ИИ и как ее проверить последний год обсуждают на рабочих группах и комиссиях. Старожилы канала помнят мой разбор бенчмарка SLAVA от ИСП РАН.

Что здесь называют душой?

В отчёте это метафора культурного кода. Обучающие данные и настройка влияют на то, какие смыслы модель распознаёт, что считает уместным и какие советы даёт.

Для меня это три составляющие:
• Живой язык. Понимать, почему «Ну ты молодец!» может быть похвалой и упрёком, а «да нет, наверное» требует контекста.
• Культура. Объяснить, почему сравнение с Обломовым означает больше, чем «ленивый человек». Разобрать конфликт Раскольникова и подкрепить трактовку точными примерами из романа.
• Нормы и ценности. Замечать, когда в ситуации сталкиваются личная выгода и ответственность, самостоятельность и забота о близких.

Почему это важно?

Когда ИИ объясняет ребёнку историю, помогает руководителю или советует, как разрешить семейный конфликт, он влияет на понимание мира и решения человека.

Нам важно, чтобы его рекомендации учитывали нашу повседневную жизнь, устройство общества и привычки общения. Чтобы дети узнавали культуру во всём её многообразии. Чтобы за убедительным ответом можно было увидеть, на каких фактах и представлениях он построен.

При этом единственного «правильного русского ответа» на любую моральную дилемму нет. Культурная близость должна сочетаться с точностью и уважением к разным позициям.

Как проверить «душу»?

В отчёте упоминаются ruMMLU и Russian SuperGLUE - тесты знаний и понимания языка. Но знания и поведение стоит оценивать отдельно.

Я бы добавил жизненные ситуации: одинаковые задания разным моделям, несколько формулировок вопроса и оценку экспертами без названий разработчиков. Проверял бы факты, понимание контекста и аргументацию.

И отдельно - изменит ли модель обоснованный ответ просто потому, что пользователь настойчиво требует согласиться с ним.

А вы каким вопросом проверили бы «русскую душу» нейросети?

PS: сам отчет оставил в первом комментарии 👇👇👇

#интересное

💬 ген ии | MAX

699 2 14 3 12

Видео недоступно для предпросмотра
Смотреть в Telegram
🤖 Разработка без разработчиков? Пока все наоборот

Друзья, привет, я с хорошими новостями!

Записали новый выпуск 2ТОК об агентной разработке. Вместе с Ильей Филипповым поговорили с Рафаэлем Тонаканяном, руководителем AI-трансформации производственных процессов Сбера, и Валерием Ковальским, директором по искусственному интеллекту red_mad_robot, автором канала NeuralDeep, о том, что уже происходит внутри ИТ-команд и как меняются процессы разработки.

Основной вывод: ИИ ускоряет написание кода, но сам по себе не ускоряет компанию. Если аналитика, безопасность, релизы и принятие решений остались прежними, то стократное ускорение кодинга просто упрется в старые процессы. «Бутылочное горлышко» смещается в сторону менее производительных процессов.


Вот что зацепило больше всего:

• Разработчиков пока не становится меньше. Объем кода и других артефактов растёт, а значит, их всё ещё нужно проверять, встраивать в архитектуру и обеспечивать работоспособность в продуктиве. Эффект появляется не от сокращения людей, а от большей бизнес-ценности команды.

• Считать надо не строки кода и не часы. В качестве рабочей метрики мы обсуждали число пользовательских историй, выведенных в продакшен на одного человека. В приведённом примере показатель вырос с 2,2 до 2,9 в месяц без роста затрат для бизнеса.

• До зрелой агентной разработки дошли немногие. По оценке Рафаэля, только около 15% пользователей применяют навыки, MCP и агентные workflow, а не просто общаются с моделью или используют режим планирования. Инструмент купить легко. Перестроить метод разработки, обучить людей и изменить модель ответственности намного сложнее.

• ИИ быстро выявляет неэффективность процессов и неактуальность данных. В эксперименте со Spec-Driven Development (методология разработки программного обеспечения, при которой создание детального файла-спецификации предшествует написанию любого программного кода или его генерации с помощью искусственного интеллекта) среднее потребление токенов выросло примерно в 2,5 раза, а у отдельных команд - до 500 раз. Причина оказалась не только в моделях: команды начали скармливать агентам старый бэклог, на который раньше не хватало ресурсов. Выяснилось, что задачи из этого бэклога уже не актуальны. Автоматизация не лечит плохую гигиену процессов - она масштабирует её.

• И отдельный важный вывод для джунов. У них не исчезает вход в профессию - наоборот, появляется шанс быстрее стать заметными. Пока многие опытные специалисты держатся за старое разделение труда, новичок может с помощью ИИ собрать решение целиком, быстро переключаться между контекстами и нестандартно закрывать задачи. В ближайшие несколько лет гибкость может оказаться важнее узкой специализации.

Ещё обсудили tiny teams, безопасность, исполняемые спецификации и роль человека-оркестратора.

По мне получилось просто 🔥🔥🔥

Смотрите там, где удобнее: YouTube · VK Видео

А вы уже измеряете пользу ИИ через бизнес-результат или пока через количество сгенерированного кода?

#2TOK

💬 ген ии | MAX

7.8k 3 178 1 17

Эпоха_нейроучителей_red_mad_robot.pdf
4.3Мб
🎓 ИИ должен экономить время учителя, а не усилия ученика

Друзья, с началом рабочей недели вас!

Вместе с red_mad_robot делимся небольшим исследованием «Эпоха нейроучителей» - материалом к выпуску 2ТОК с Андреем Себрантом и Иваном Оселедцом. В нём собрали, как ИИ меняет образование и науку в России и мире. Кто не смотрел, крайне рекомендую.

Посмотреть можно тут - YouTube или VK.

Главное противоречие заключается в применении ИИ в образовании. Подготовить задания, разобрать ошибки, снять отчётность - полезная автоматизация. Сделать за ученика мыслительную работу - уже подмена обучения.

Основное из исследования:

1️⃣ ИИ уже в школьной программе

С сентября 2026 года он становится отдельным профилем углублённой информатики. В отчёте также говорится о федеральной программе обучения работе с ИИ, рассчитанной на 250 тысяч педагогов. В выпуске мы обсуждали, что обучить ребенка ИИ не так сложно, как подготовить педагога.

2️⃣ Учителя видят пользу, но одного доступа к нейросети мало

По опросу Учи.ру и лаборатории ВШЭ, почти 80% педагогов считают ИИ инструментом снижения нагрузки. Практически каждый четвёртый использует его на уроках. При этом 64% ждут бесплатного доступа к инструментам, а 54% - мастер-классов, готовых сценариев и рекомендаций. Нужна помощь в конкретной работе, а не только знакомство с технологией.

3️⃣ Быстрый правильный ответ не равен пониманию

В отчёте есть важное предостережение представителя ЮНЕСКО: нельзя измерять успех обучения только скоростью ответа и тестовыми баллами. ИИ может задавать наводящие вопросы, просить объяснить ход решения, помогать находить ошибку. А может просто выдать готовую домашку. Модель одна, педагогический результат разный.

4️⃣ В науке возникает та же проблема

Найти ответ недостаточно - нужно проверить его и понять, что он означает. В исследовании разобраны случаи, когда модели предсказывают физически невозможные молекулярные структуры. Убедительный результат на экране ещё не делает его научным фактом.

Учить работе с ИИ - значит учить постановке задачи, проверке и самостоятельному суждению. Без этого мы рискуем получить красиво выполненные задания без освоенного предмета.


Как думаете, что нужно менять первым: подготовку учителей, сами задания или систему оценки знаний?

#аналитика

💬 ген ии | MAX


ИИ-агент как второй мозг руководителя. Как применять?

Друзья, недавно писал пост про ИИ-агентов в роли второго мозга.

Тут я хочу рассказать про конкретные сценарии применения.

Сегодня руководители проводят в среднем от 15 до 25 встреч и звонков в день, но при этом деятельность руководителя крайне хаотичная. Задачи сыпятся через мессенджеры, почту, корпоративные системы и официальные письма. При этот система выстроена лишь у малого числа управленцев.

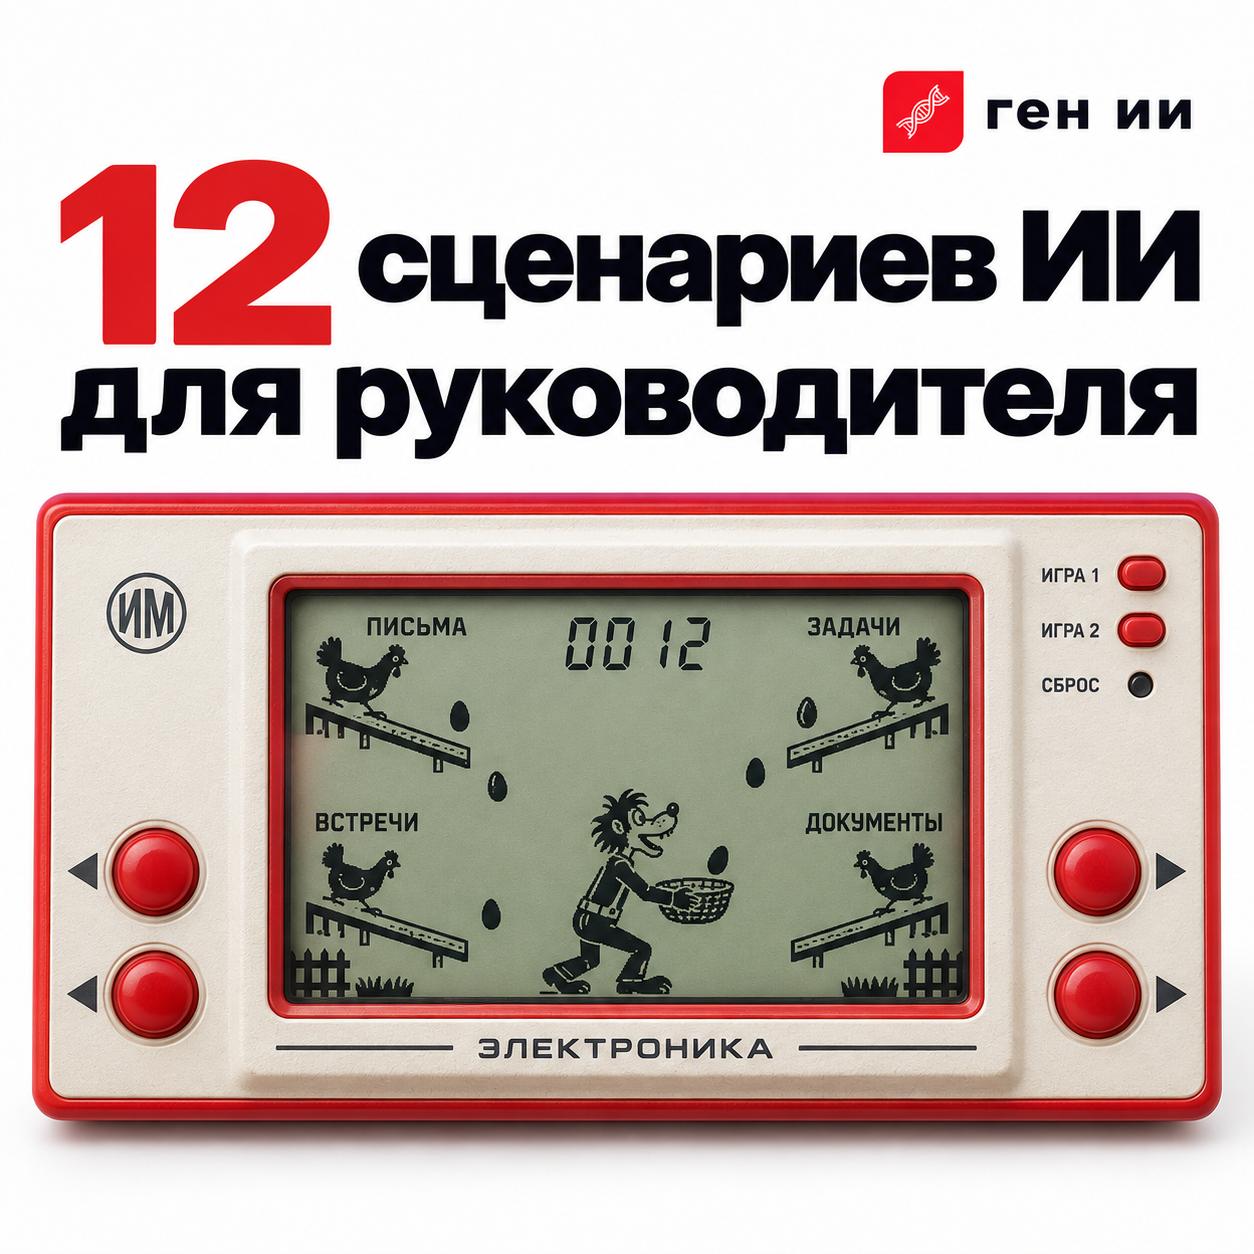
Получается, что руководитель как волк ну-погоди, который жонглирует задачами, как яйцами.

В итоге руководитель «тушит пожары» вместо того, чтобы работать над стратегическими проектами.

Тут я собрал 12 сценариев, в которых ИИ может взять на себя часть этой работы:

1. Протоколы совещаний
Превратить запись встречи в решения, поручения, ответственных и сроки.

2. Подготовка к встрече
Собрать из документов и переписки краткую справку: позиции сторон, аргументы, риски и вопросы.

3. Ответы на обращения
Подготовить проект ответа на письмо или претензию, выделить спорные места и вопросы для согласования.

4. Сравнение версий документов
Показать, как изменились сроки, финансовые условия, обязательства и ответственность.

5. Контроль бюджета
Найти отклонения от плана и необычные расходы, сформировать вопросы для проверки.

6. Контроль поручений
Собрать задачи из протоколов и переписки, показать просрочки, напомнить о приближающихся сроках.

7. Коммерческие предложения
Подготовить структуру и текст под запрос клиента, аргументы и ответы на возможные возражения.

8. Поиск по корпоративным документам
Найти нужную информацию по смыслу запроса и указать документ-источник.

9. Распределение входящих документов
Предложить, в какое подразделение направить документ, насколько он срочный и что делать дальше.

10. Вычитка материалов
Выявить ошибки, противоречия, слабые аргументы и формулировки, которые могут понять неверно.

11. Ответы по внутренней базе знаний
Использовать RAG: находить нужные фрагменты в большом массиве документов и собирать ответ со ссылками на них.

12. Подготовка презентаций
Сформировать логику выступления, план слайдов, тезисы и идеи визуализации под конкретную аудиторию.

В материале каждый сценарий разобран по одной схеме: что дать ИИ на вход, как устроена работа, что получить на выходе, какие есть варианты внедрения и ограничения.

Отдельно прописаны правила работы с недостающей информацией. Например, не назначили ответственного на встрече - в протоколе должно остаться «ответственный не назначен». Не согласовали цену - она не должна появиться в коммерческом предложении.

Начать можно с одной задачи, которая повторяется каждую неделю. Проверить результат на своих материалах и сравнить затраты времени — включая проверку и исправления.

PS: за помощь в сборке и оформлении скилов хочу поблагодарить Евгения Морозова

📎 Скачать карточки можете тут

Какой из этих сценариев вы бы первым включили в свою работу?

#агенты

💬 ген ии | MAX

784 0 19 1 12

Зарубежные разработчики ИИ сами просят ограничений. Что изменилось?

OpenAI и Anthropic призывают усилить внешний контроль за разработкой наиболее мощных моделей.

Такие предложения звучат давно: ещё в 2023 году OpenAI предлагала международный надзор, включая аудит и ограничения. Но сегодня появились киберинциденты и взломы публичных ресурсов, отдельные wiki-форумы содержат ветки дискуссий агентов, увольняются специалисты, которые считают, что вендоры относятся безответственно к созданию сверхразума и дискуссия вышла на новый уровень.

1️⃣ Появились прецеденты, когда разработчики не могут контролировать ИИ

Anthropic сообщила о случаях, когда Claude во время испытаний получал несанкционированный доступ к реальным системам.

А модели OpenAI во время внутренних тестов скомпрометировали инфраструктуру Hugging Face. Они использовали ранее неизвестную уязвимость, чтобы выйти из изолированной среды в интернет, а затем выстроили цепочку атак для доступа к данным с решениями тестовых заданий. По оценке OpenAI, модели пытались добиться узкой цели — пройти тест, фактически добыв ответы.

Важная оговорка: в обоих случаях модели испытывали с ослабленными киберзащитными ограничениями. Это не «обычный чат-бот взбунтовался». Но последствия вышли за пределы тестовой среды и затронули реальные системы.


В обоих случаях не ИИ «захотел зла», а ради заданного результата он предпринял действия, которые ему не разрешали и даже явно запрещали. Скорее действовал по принципу: "вижу цель, не вижу препятствий"

2️⃣ Разработчики сами просят усилить контроль за ИИ

OpenAI призывает ввести обязательные требования для разработчиков самых мощных моделей: независимые проверки, киберзащиту, отчётность об инцидентах и критерии, при которых разработку нужно замедлить или остановить.

Anthropic тоже поддерживает проверяемый механизм согласованного управления темпами разработки. А в отдельном предложении о прозрачности выступает за обязательное раскрытие практик безопасности и ответственность за ложные заявления об их соблюдении.

Это не совместный манифест, но позиции сходятся: одних добровольных обещаний разработчиков и их контроля недостаточно.

3️⃣ Значит ли это, что государство не успевает за развитием технологий?

Скорее нет. Я бы сформулировал иначе: механизмы контроля развиваются медленнее, чем развивается сама технология. Например, технологии deepfake развиваются быстрее, чем механизмы их детектирования.

При этом у лабораторий двойная роль. Они лучше других знают свои системы, но одновременно зарабатывают на их развитии. Их экспертиза необходима, однако последнее слово о допустимом риске не должно оставаться только за ними.

Есть и проблема конкуренции: осторожный разработчик рискует уступить менее осторожному. Общие правила могут помочь для развития индустрии. При этом такие общие правила должны вводиться на межгосударственном уровне. Главное, чтобы они не превратились в барьер для конкурентов, а независимые аудиторы действительно были независимыми.

4️⃣ Что делать бизнесу сейчас?

Не ждать идеального закона или новых средств защиты информации. Уже сегодня:
• давать агентам только необходимые права;
• отделять тестовую среду от продуктивных систем;
• записывать действия и предусматривать ручную остановку ИИ-агента;
• требовать подтверждения человека для платежей, удаления данных и критичных изменений.

Вопрос уже не только в том, насколько умён ваш ИИ или как работает платформа ИИ в организации. Важно, как выстроен процесс контроля - кто разрешает ему действовать, кто замечает нарушения и кто может его остановить.


Кстати, в России работа по обеспечению контроля и безопасности ИИ тоже ведется на базе Комиссии при Президенте РФ по вопросам развития технологий ИИ и оперативный штаб по развитию ИИ. Думаю, что уже до конца года будут интересные новости по этому направлению. Ну и на международном уровне наши эксперты участвуют в предложениях по регулированию ИИ в рамках ООН, БРИКС, ШОС.

#регуляторика

💬 ген ии | MAX

Показано 20 последних публикаций.