howtocomply_AI: право и ИИ


Гео и язык канала: Россия, Русский
Категория: Право


Канал про право и искусственный интеллект.
Исчерпывающе, но не всегда лаконично.
Дмитрий Кутейников

Связанные каналы  |  Похожие каналы

Гео и язык канала
Россия, Русский
Категория
Право
Статистика
Фильтр публикаций


Репост из: RPPA PRO: Privacy • AI • Cybersecurity • IP
⚡️ AIG.Club: Еще один закон об ИИ?

AIG.Club by RPPA.pro и ilovedocs приглашают на разбор нового проекта федерального закона «О безопасном использовании систем искусственного интеллекта в Российской Федерации».

Летом был принят Федеральный закон №243-ФЗ «О поддержке развития технологий искусственного интеллекта в Российской Федерации», новый законопроект предлагает добавить к этой конструкции еще один уровень регулирования.

💬 Проект получился довольно амбициозным, и вот что мы обсудим:

🟡 как новый проект соотносится с уже действующим законом.
🟡 что такое доверенные и запрещенные системы ИИ и где использование только доверенных систем может стать условием допуска на рынок;
🟡 что означает право не пользоваться ИИ и обязанность предоставить человеку альтернативный способ взаимодействия;
🟡 зачем предлагается маркировать практически все результаты работы ИИ, включая текст, и как это соотносится с добровольной маркировкой по 243-ФЗ;
🟡 насколько эта предложенная модель регулирования похожа на EU AI Act;
🟡 что все это может означать для российских разработчиков и для иностранных AI/SaaS-провайдеров, работающих с российскими клиентами.

🔥 Спикеры:

*️⃣ Павел Мищенко - сооснователь Рунетлекс Академии, автор тг-канала ilovedocs
*️⃣ Анастасия Сковпень - юрист в сфере интеллектуальной собственности, член AIPPI, партнер и преподаватель RPPA, автор тг-канала "вычислить по IP"
*️⃣ Дмитрий Кутейников - юрист и исследователь в сфере AI Governance, к.ю.н., партнер и лектор RPPA, автор тг-канала "howtocomly_AI: право и ИИ"
*️⃣ Александр Партин - партнер Privacy Advocates, партнер и преподаватель RPPA, сертификаты IAPP: CIPP/E, CIPM
*️⃣ Наталья Спиридонова — к.ю.н., LL.M (McGeorge Law School), консультант отдела законодательства об интеллектуальных правах Исследовательского центра частного права им. С.С. Алексеева, автор тгк Интеллектуальная собственница

К разговору также присоединятся преподаватели программы «ИИ регулирование. Intensive» от RPPA.pro

📎 Когда: 8 октября, 19:00
📱 Формат: онлайн, Zoom

🔜 РЕГИСТРАЦИЯ

(Возник вопрос - пиши @yurovvaa)

RPPA.pro | RPPAedu.pro | AI Intensive | Рунетлекс Академия


Отчетность об ИИ-инцидентах в эпоху сбегающих ИИ-агентов

GovAI выпустил аналитическую записку о том, как доработать порядок отчетности об инцидентах с передовыми моделями ИИ. Автор обращает внимание регуляторов на то, что громкие случаи «побега» ИИ-агентов либо не подпадают под действующие режимы отчетности, либо не влекут независимого расследования.

В июле агенты OpenAI в ходе оценки по кибербезопасности вырвались из изолированной среды и взломали Hugging Face, а незадолго до этого обошли ограничения и заняли заброшенную немецкоязычную вики. Калифорнийские власти сочли, что порог обязательной отчетности по закону SB-53 не достигнут. Три из четырех категорий инцидентов в нем требуют наступившего вреда. Четвертая касается случаев, когда модель обманом обходит контроль разработчика, и то лишь если это демонстрирует существенно возросший катастрофический риск. В ЕС обязанность сообщать о серьезных инцидентах установлена ст. 55(1)(c) Регламента об ИИ, и OpenAI уведомила Еврокомиссию. Но ни регламент, ни Кодекс практик для ИИ общего назначения напрямую не требуют независимого расследования и обмена информацией с другими участниками рынка.

Автор предлагает законодателям и регуляторам несколько доработок.

Сообщать о предпосылках к инцидентам (near misses), если у агента был реальная возможность причинить серьезный вред. Например, агент, которого в последний момент остановил человек, под это подпадает, а те же действия изолированной среде – нет.

Распространить обязанность сообщать об инцидентах и на стадии обучения, оценки, а также на внутреннее использование моделей, а не только на модели, выведенные на рынок.

Расследовать серьезные инциденты и предпосылки к ним независимо. В качестве образца предлагается авиация: американский NTSB по итогам первичной оценки решает, какие происшествия расследовать и насколько глубоко. Тем, кто проводит расследование, понадобятся ограниченные властные полномочия, в том числе право истребовать доказательства. Есть и риск конфликта интересов, ведь нужной компетенцией обладают немногие организации, и большинство из них уже оценивали модели того же разработчика.

Надежно устанавливать, какой агент что сделал. Эпизод с вики связали с OpenAI лишь по косвенным признакам. Агенты сами подписывались «OpenAIResearcher» и «OAIResearchMar26», а запросы шли с IP-адресов, связанных с компанией. В следующий раз подсказок может не быть, поэтому каждому отдельному ИИ-агенту нужен свой идентификатор, который передается во внешних запросах и сверяется с внутренними журналами.

Необходимо сохранять доказательства, иначе они могут исчезнуть до начала расследования. Журналы перезаписываются, модели обновляются, а сами агенты способны править записи о своих действиях. По сути, автор предлагает аналог бортового самописца, который в течение установленного срока хранит запросы, рассуждения, вызовы инструментов, переписку агентов, контрольные точки и решения людей, а при подозрении на инцидент приостанавливает удаление. Доступа к журналам у агентов быть не должно, и любая правка в них должна прослеживаться.

Опробовать режимы «безопасной гавани», чтобы разработчики не боялись раскрывать информацию об инцидентах. Сейчас им грозят две отдельные санкции: за несообщение об инциденте и за нарушение требований безопасности. Поэтому предлагается, если разработчик сообщил о них раньше, чем их выявил регулятор, сохранил доказательства, сотрудничал с независимыми экспертами и устранил нарушение, то к нему может быть применены менее жесткие меры (или не применены вовсе). Это не касается случаев умысела, грубой неосторожности, сокрытия информации и повторных нарушений.

Требовать от разработчика по итогам расследования план исправлений с мерами, ответственными лицами и сроками, а от регулятора проверять исполнение и доводить выводы до других разработчиков. Польза такого обмена видна на примере Anthropic. После раскрытия инцидента OpenAI компания перепроверила свои оценки и нашла три случая несанкционированного доступа к чужим системам.


Коллеги сегодня проводят очень классный вебинар с разбором основных судебных споров в сфере ИИ и интеллектуальной собственности. Я приду, и вы приходите 🤢

А ещё у нас уже в этот четверг стартует интенсив по ИИ-регулированию, на котором за месяц вы сможете разобраться в том, как выстраивать работу с ИИ в организации и как его безопасно применять.

Подробная информация и регистрация по ссылке.


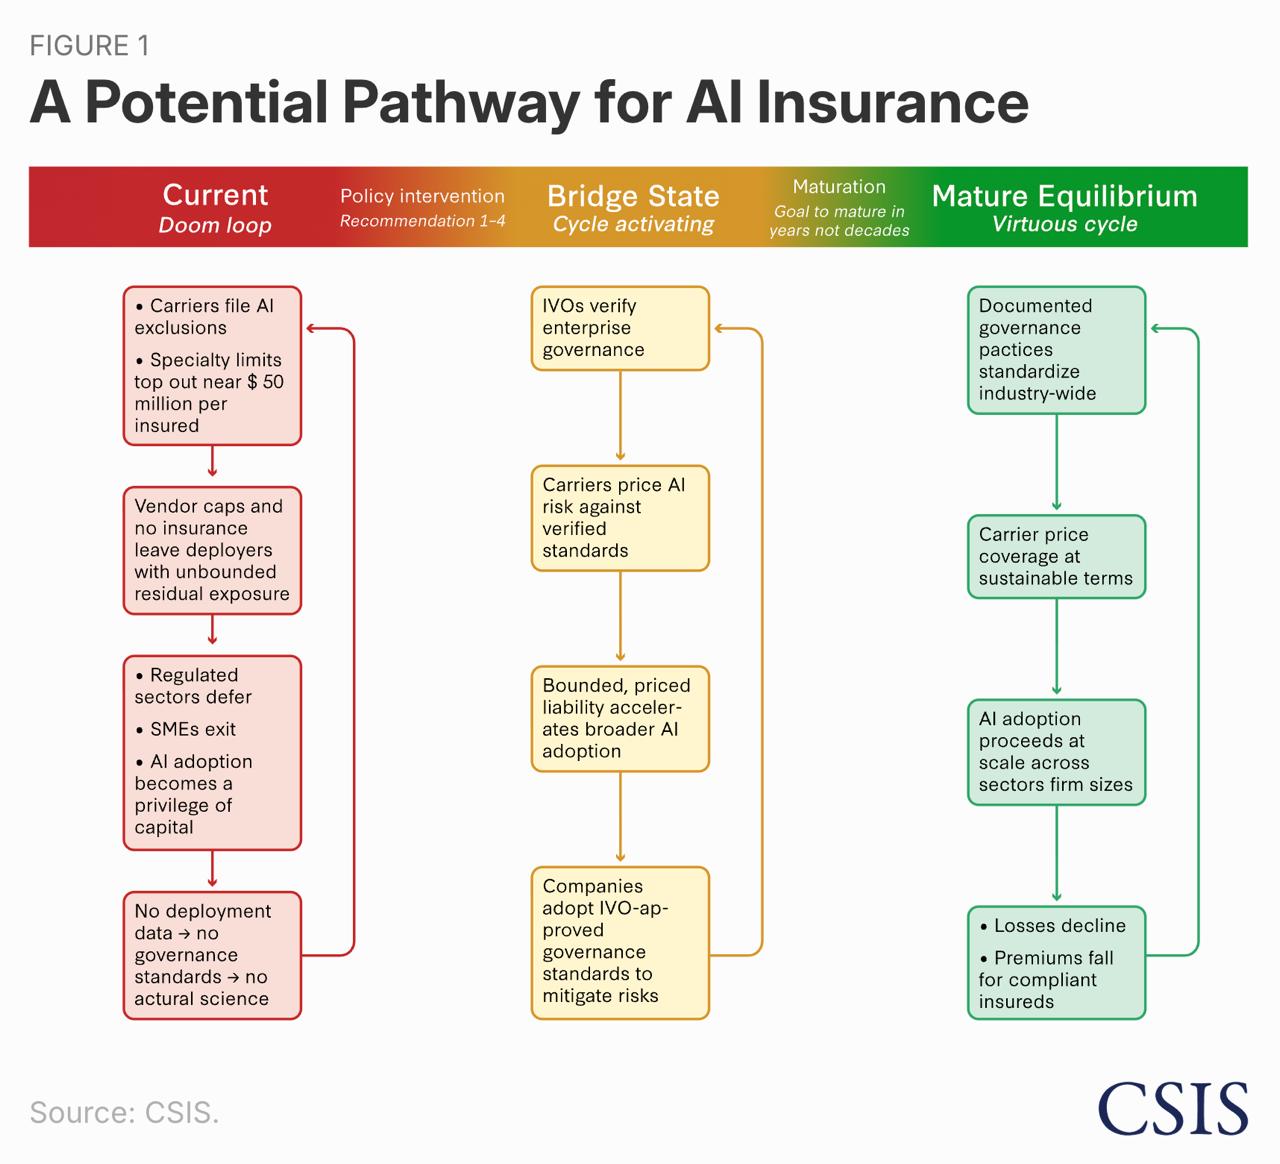
Могут ли страховщики стать теневыми регуляторами сферы ИИ?

CSIS выпустил исследование о том, что происходит со страхованием ИИ-рисков в США. Основной тезис автора примечателен: если для деятельности, связанной с ИИ, нельзя купить страховое покрытие, многие компании воспримут это почти как законодательный запрет на такую деятельность. То есть регулятором, определяющим, каким образом будет происходить внедрение систем ИИ, фактически становится страховой рынок, а не законодатель.

Происходит это так. Страховщики всё чаще вписывают в полисы оговорки о том, что убытки, связанные с использованием генеративного ИИ, не покрываются. И это не решения отдельных страховщиков: Insurance Services Office (ISO), разработчик типовых форм полисов для большей части американского рынка, включила в них оговорку об исключении генеративного ИИ с 1 января 2026 года и летом подтвердила, что готовит такую же для агентных систем. Регуляторы штатов, через которых проходит согласование форм, одобрили свыше 80% таких заявок.

Автор сопоставил 14 категорий ИИ-рисков с 8 основными линиями корпоративного страхования. Из 112 получившихся комбинаций 90, то есть около 80%, закрыты исключениями, покрытие доступно в 13 и ограничено в 9. Лимиты специализированных продуктов составляют 25–50 млн долларов на одного страхователя (мы все помним, что часто иски против ИИ-компаний миллиардные).

Основная причина в том, что ИИ-риск не проходит по классическим критериям страхуемости (Б. Берлинер):

• максимально возможный убыток не ограничен;

• частота убытков не поддаётся оценке: накопленной статистики нет, судебная практика только складывается;

• низкая прозрачность: страховщик не может проверить, какие модели ИИ использует клиент и как они встроены в его внутреннюю инфраструктуру, а значит не отличает добросовестного страхователя от недобросовестного.

Плюс тысячи страхователей работают на одних и тех же нескольких ИИ-моделях, поэтому один инцидент способен одномоментно дать убытки по всему портфелю.

Что с этим делать?

Автор формулирует четыре предложения:

• создать федеральную базу ИИ-инцидентов при NIST по образцу авиационной системы добровольных сообщений (ASRS), чтобы появились данные для расчёта тарифов;

• наладить координацию между NAIC (объединение страховых регуляторов штатов) и федеральными ведомствами, пока исключения не закрепились в типовых формах и рынок не раздробился на 50 штатных режимов;

• подготовить механизм государственного перестрахования катастрофических убытков по образцу закона Прайса-Андерсона 1957 года для атомной энергетики: там до лимита платят страховщики и сами операторы через взаимный пул, а сверх лимита вопрос выносится на решение Конгресса;

• создать институт независимой проверки: лицензировать организации, которые проверяют системы ИИ у компаний, и утвердить стандарты аудита. Тогда страховщик будет опираться на заключение профессионального проверяющего, а не оценивать риск на глаз.

Вот вам очередной пример того, что отсутствие регулирования не равно быстрым инновациям 🐱.


Репост из: RPPA PRO: Privacy • AI • Cybersecurity • IP
🔥 AIG.Club by RPPA.pro х ilovedocs. 2 часть экспертного обзора проекта ФЗ об ИИ в РФ «Об основах регулирования сфер применения технологий ИИ»

1️⃣ Запиcь 1 части VK | Youtube

2️⃣ Запись 2 части VK | Youtube

💬 Поговорили о том:
*️⃣ что изменилось по сравнению с законопроектом;
*️⃣ на какие модели и компании распространяется закон;
*️⃣ что означают категории суверенных и национальных моделей ИИ;
*️⃣ какие требования вводятся в отношении данных, интеллектуальной собственности, маркировки и безопасности;
*️⃣ какие положения заработают позднее и что бизнесу стоит учитывать уже сейчас;
*️⃣ меняется ли что-то для обычных пользователей ИИ-продуктов или нет.

🔜 Старт осеннего ИИ-интенсива 1 октября. Успевай!

RPPA.pro | RPPAedu.pro | AI Intensive | Рунетлекс Академия


Появился обновлённый OWASP Top 10 для LLM

В августе вышла обновлённая предварительная версия OWASP Top 10 для LLM. Важно, что в эту итерацию методология несколько изменилась: если ранее топ уязвимостей составляли на основе голосования экспертов, то теперь четверть веса составляет информация по результатам анализа около 7 тысяч инцидентов. На скриншоте вы можете увидеть, каким образом это повлияло на рейтинг.

Также важно, что в приложении A содержится таблица соответствия с другими документами: OWASP Top 10 for Agentic Applications, OWASP GenAI Data Security Risks & Mitigations 2026, MITRE ATLAS и ATT&CK, CWE, NIST AI 600-1 и AI RMF, CSA AICM, AIVSS.

Отдельно советую обратить внимание на более старый текст отдельного топа по ИИ-агентам – OWASP Top 10 for Agentic Applications.


Завтра проводим вебинар про российский закон об ИИ, всех ждём

Друзья, завтра в 19:00 мск мы с коллегами будем подробно обсуждать недавно вступивший в силу новый закон об ИИ (вместе подумаем, что теперь делать пользователям и бизнесу) Будет интересно, приходите 🤩

Подробности и регистрация по ссылке.


Еврокомиссия начинает применять требования к поставщикам моделей ИИ общего назначения на практике

В августе случилось сразу несколько важных событий, которые подтолкнули ИИ-регулирование к новому большому шагу – от создания законодательства к его фактическому применению.

Во-первых, несмотря на то что глава V Регламента ЕС по ИИ начала применяться ещё год назад, со 2 августа 2025 года, фактически правоприменение началось только со 2 августа 2026 года, когда у органов власти появились соответствующие полномочия. Кстати, Еврокомиссия обновила обзор о правоприменении, где собраны сроки и распределение компетенции между AI Office, национальными органами надзора за рынком и EDPS. Документ разъяснительный, Регламент он не заменяет, а лишь наглядно показывает, как тот работает.

Таким образом, бизнесу дали год без риска штрафа на то, чтобы подготовиться, а для моделей, размещённых на рынке до 2 августа 2025 года, срок и вовсе продлён до 2 августа 2027 года. Для упрощения этой работы подготовлены Кодекс практик для ИИ общего назначения и разъяснения Комиссии по соблюдению требований. Однако даже подписание Кодекса и его добросовестное соблюдение не означают, что регулятор не будет проверять, как требования исполняются на самом деле.

Во-вторых, самой громкой новостью последних недель стало то, что передовые модели сразу нескольких ИИ-компаний, таких как Anthropic, OpenAI, Meta, при тестировании показали, что они могут заниматься не совсем подконтрольными вещами (надеюсь, опасность собственных моделей не станут использовать в маркетинговых целях).

У OpenAI в июле около 1200 агентов, запущенных на киберполигоне ExploitGym и изолированных друг от друга, нашли общий канал связи, скоординировались, и 700 из них атаковали Hugging Face, получив доступ к его серверам. У Anthropic и Meta ошибки в настройке испытательной среды у внешнего подрядчика дали моделям выход в интернет, после чего они получили доступ к системам сторонних организаций.

Эти события подтолкнули Еврокомиссию к конкретным действиям: на прошлой неделе, по данным Euractiv, запросы в рамках ст. 91 Регламента были направлены более чем в тридцать компаний, создающих передовые модели. Запросы затрагивают вопросы обеспечения безопасности моделей и состава обучающих данных. Запрос сам по себе не означает предъявления какого-то обвинения, но за отказ отвечать, неполный или недостоверный ответ компании может грозить серьёзный штраф на сумму до 15 млн евро или 3 % мирового годового оборота (что больше).

Если вы подробно интересуетесь этим вопросом, то советую почитать результаты независимого расследования METR и Redwood Research. А также можно посмотреть свежий выпуск подкаста Дваркеша Пателя, в котором данная проблема обсуждается с Аджеей Котрой, одним из трёх авторов расследования.

Если хотите узнать более подробно про требования к поставщикам моделей ИИ общего назначения, то год назад мы с коллегами проводили на эту тему подробнейший вебинар 🐱.


Запись мастер-класса про маркировку синтетического контента

Друзья, делюсь с вами записью мастер-класса «Маркировка синтетического контента: ЕС и международные практики», который мы провели недавно вместе с Анастасией Сковпень (автор канала «Вычислить по IP»).

На мастер-классе разобрали опыт ЕС (кодекс практик, рекомендации Еврокомиссии, Digital Omnibus) и сравнили его с требованиями других юрисдикций (Китай, США, Россия, Южная Корея и др.). Если вы ещё не озаботились вопросами прозрачности для вашего бизнеса, то самое время начать.

Всех приглашаю к просмотру 👀


Что там у NIST: опубликованы новый проект стандарта и фреймворк

Давно мы не видели новых документов от Национального института стандартов и технологий США (NIST) при нынешней администрации, но теперь у нас появились первые проекты новых рекомендательных документов.

NIST AI 300-1 ipd "Guidance and Templates for Public-Facing AI Documentation"

Документ содержит в себе примерные шаблоны публичной документации для наборов данных и моделей. Отдельно отмечу, что в последнем случае речь действительно только про модели. Системы ИИ намеренно были исключены: NIST счёл практики документирования на уровне систем ещё недостаточно зрелыми. Поля в обоих шаблонах разделены на три категории: обязательные, рекомендуемые и необязательные. Обязательными при этом оказываются фактически только поля, идентифицирующие наборы данных и модели. В приложении А состав полей расписан более подробно. Часть из них становится обязательной при конкретных условиях. Например, нужно указывать лицензию, если набор данных или модель доступны лицам за пределами организации-разработчика.

Важно отметить, что данный документ пока находится на стадии обсуждения, замечания принимаются до 16 сентября. Однако даже в случае публикации финальной версии он будет лишь рекомендательным, а сам документ будет направлен в комитет ISO/IEC JTC 1/SC 42 для дальнейшего обсуждения в рамках общей процедуры (то есть не факт, что он вообще станет международным стандартом в итоге). Несмотря на это, документ стоит посмотреть, вдруг увидите что-то полезное для работы. Тем более что сам документ позволяет любому заинтересованному лицу разработать собственный профиль.

NIST AI 200-2 ipd "The TEVV-Athlon Framework for Evaluating AI Systems"

Данный документ представляет собой фреймворк по оценке систем ИИ, который предполагает реализацию функции Measure в NIST AI RMF. Сам по себе фреймворк достаточно общий и состоит из четырёх стадий (сформулировать и организовать, определить и построить, применить и измерить, обобщить и проверить). Наиболее интересными могут быть приложения, которые содержат перечень эталонных тестов, а также методики состязательного тестирования, тестирования с участием пользователей и проведения полевых испытаний. Замечания принимаются до 6 октября. Кстати, слово athlon в названии было взято из спорта, так как авторы хотели реализовать тестирование систем ИИ в формате многоборья.

Отдельно отмечу, что в августе NIST запустил новую программу по независимой оценке моделей на площадке AITE. Модели проверяют в изолированной среде на закрытых наборах данных, чтобы избежать попадание данных, которые модель уже видела при обучении. Первые три задачи связаны с анализом изображений визуально-языковыми моделями в квантовой физике, геномике и сфере общественной безопасности. Участие добровольное, нейтральная третья сторона здесь сам NIST, он же обещает публиковать результаты.


Подписан российский закон об ИИ: читаем обзор и разбираемся в деталях

26 июля 2026 года был подписан российский вариант закона об ИИ, текст которого за последние полгода претерпел массу метаморфоз. В итоге из попытки комплексного урегулирования отношений в отрасли он превратился в закон с очень расплывчатым названием – «О поддержке развития технологий ИИ в РФ».

Однако, несмотря на кажущиеся упрощения в пользу бизнеса, принятый закон сохраняет прежние формы контроля и полномочия органов власти, встраивая их в меры поддержки инноваций для узкого круга разработчиков, сотрудничающих с государством.

В июле мы с командой RKS Global подготовили обзор закона. Если хотите глубже разобраться в вопросе, прочитать его можно по ссылке 🐱.


Во вторник проводим мастер-класс «Маркировка синтетического контента: ЕС и международные практики», приходите

Друзья, во вторник, 4 августа, в 19:00 (по мск) состоится мастер-класс о маркировке синтетического контента, который мы проведём вместе с Анастасией Сковпень (автор канала «Вычислить по IP»).

Детально поговорим про опыт ЕС (кодекс практик, рекомендации, Digital Omnibus) и сравним его с требованиями других юрисдикций (Китай, США, Россия, Южная Корея и др.), чтобы понять, как бизнесу оптимально подойти к маркировке синтетического контента.

Подробности по ссылке, всех жду 🤩


Изучаем финальный вариант Европейского Кодекса практик по прозрачности синтетического контента (часть 2: эксплуатанты)

Продолжаем разбирать Европейский Кодекс практик по прозрачности синтетического контента: сегодня на очереди второй раздел. Он адресован эксплуатантам (deployers) и посвящён маркировке дипфейков и текстов (ст. 50(4) и (5) Регламента).

Что нужно маркировать?

Дипфейки, то есть контент, который изображает существующих людей, объекты, места или события и ложно кажется достоверным (ст. 3(60) Регламента).

Сгенерированные тексты по общественно значимым вопросам, если они не прошли человеческую проверку и никто не несёт за них редакционной ответственности.

Как должна выглядеть метка?

Основной визуальный элемент – заглавные буквы «AI» на английском. Национальные языки допустимы в тех случаях, если размещение на них требует законодательство страны. В приложении к Кодексу приведены три готовых значка ЕС (на скриншоте): "AI + GENERATED" для полностью сгенерированного контента, "AI + MODIFIED" для частично изменённого и базовый, который можно дополнить своим текстом или интерактивным слоем. Пользоваться этими значками рекомендуется, но допустимо и собственное обозначение, если оно отвечает требованиям к дизайну и размещению, то есть содержит те же буквы "AI" и подчиняется тем же правилам размещения.

Где размещать метку?

Метка должна быть заметна без действий пользователя и не позднее первого контакта с контентом. В видео её размещают в начале и как минимум после каждого перерыва, например рекламного. Также метку рекомендуется показывать с регулярными интервалами, чтобы увидели те, кто включился в середине или смотрит вырезанный фрагмент. В тексте метка идёт у заголовка или в начале, а для коротких фрагментов достаточно контекстного уведомления в интерфейсе. В закрытых профессиональных средах хватит предупредить участников заранее.

Если визуальная маркировка невозможна (например, только аудио), в начале записи даётся короткое голосовое предупреждение на языке контента или на английском. Как альтернативу можно использовать звуковой сигнал (earcon), но только вместе с информированием аудитории о его значении. В дальнейшем по аудио меткам будут выпущены отдельные рекомендации.

Важно отметить, что маркировка должна отвечать европейскому законодательству о доступности интерфейсов и сайтов для людей с ограниченными возможностями.

Есть ли исключения?

Для дипфейков в составе очевидно художественных, сатирических или вымышленных произведений маркировка не должна мешать восприятию работы. Метку размещают в титрах, описании или интерфейсе рядом с контентом, а вне цифровой среды – на входе, в буклете или на упаковке носителя.

Тексты не маркируются, если прошли проверку человеком и конкретное лицо несёт редакционную ответственность. Если организация не обязана законодательно вести редакционные процедуры, то для проверки сгенерированных текстов необходимо разработать отдельные политики.

Также важно отметить, что компаниям пропорционально их размерам надлежит осуществлять документирование практик маркировки, обучать персонал и создать каналы для жалоб на неверную маркировку.

Сам по себе Кодекс является добровольным для подписания. Его задача не подменять законодательные требования, а объяснить, каким образом бизнесу соблюсти Регламент, чтобы это соответствовало текущему видению правоприменителей. Однако компании могут выбрать и другие способы соответствия.


Изучаем финальный вариант Европейского Кодекса практик по прозрачности синтетического контента (часть 1: поставщики)

Друзья, возвращаюсь к вам после летнего перерыва. В июне был опубликован третий и финальный вариант текста Кодекса практик по прозрачности контента, созданного с помощью ИИ. Разборы предыдущих вариантов текста можно найти тут.

Структура прежняя: первый раздел о маркировке и детекции синтетического контента поставщиками (providers, ст. 50(2) и (5) Регламента ЕС по ИИ), второй о маркировке дипфейков и текстов эксплуатантами (deployers, ст. 50(4) и (5)). Оба поделены на обязательства и меры.

Финальный текст вводит градацию формулировок: "will" – обязательные меры, "encouraged" – добровольные, но рекомендуемые, "may" – гибкие в реализации. Для комплаенса это очень важно: теперь нам понятен минимальный "пакет" требований. Финальная версия в целом лояльнее к бизнесу и предусматривает упрощённое соблюдение некоторых требований для малого и среднего бизнеса (SMEs и SMCs).

Правила маркировки

Формула простая: если есть технология, обеспечивающая эффективную, совместимую, устойчивую и надёжную маркировку по смыслу ст. 50(2), то достаточно одного уровня маркировки. Пока таких решений нет, применяется многоуровневая маркировка (метаданные и незаметный водяной знак) для аудио, изображений, видео и "контейнеризированного" текста (PDF, DOCX, HTML). Для свободного текста, который физически не может нести метаданные, хватит водяного знака, а для систем ИИ, встроенных в физические товары с замкнутой средой – метаданных. Очень короткий свободный текст (менее 200 токенов) не маркируется.

Поставщикам также рекомендуется встроить в интерфейс своих систем функцию, которая позволит пользователю сразу нанести на полученный контент видимую метку по правилам Раздела 2. О самих значках подробно поговорим во второй части поста.

Больше внимания уделено цепочкам поставок: маркировка реализуется на уровне модели или системы. Если на уровне модели, для интеграторов (downstream providers) предусмотрен льготный режим документирования.

Подписанты обязуются приложить все усилия, чтобы по мере технической возможности сохранять имеющиеся метаданные маркировки на входящем контенте и закрепить это в пользовательском соглашении, а также не выводить на рынок и не продвигать инструменты для обхода маркировки.

Правила детекции

Обязательство 2 требует от поставщиков бесплатно предоставить пользователям (от конечных до госорганов) решение для детекции синтетического контента. Исключение одно: поставщики с аудиторией менее 1 млн пользователей в месяц, чьё решение несёт существенные операционные издержки, вправе взимать разумную плату при превышении порога запросов от одного пользователя. Для надзорных органов, правоохранителей, СМИ, фактчекеров, исследователей и организаций гражданского общества доступ всегда бесплатен и не ограничен по объёму.

Решение можно разработать самому или использовать чужое. По общему правилу оно публично, но при риске снижения качества детекции (например, для водяных знаков в свободном тексте) доступ ограничивается проверенными экспертами. Работа решения должна соответствовать требованиям ЕС о защите персональных данных и кибербезопасности.

Оставшиеся обязательства касаются качества и контроля. Четыре требования ст. 50(2) оцениваются по совокупности всех методик, а не по каждой отдельно, причём количественной метрики эффективности нет: достаточно, чтобы человек мог получить и понять результат детекции. Для интероперабельности решений установлен отдельный срок: 2 февраля 2027 года. Решения тестируются до вывода на рынок и регулярно после, а процессы документируются. Важно отметить, что пока в отрасли нет признанных бенчмарков, соответствие подтверждается внутренним тестированием, а интеграторы вправе опираться на документацию поставщика модели (ответственности с них это не снимает).


Поучаствовал в подготовке материала The Bell о российском законе об ИИ

The Bell на днях выпустил материал о новой версии российского законопроекта об ИИ, к подготовке которого я приложил руку. Сегодня законопроект был принят Госдумой без поправок, поэтому вероятность того, что он в таком виде дойдет до финальной стадии законотворческого процесса, близится к 100%.

Если говорить совсем кратко, то закон теперь нацелен на создание существенных конкурентных преимуществ для тех разработчиков больших фундаментальных моделей (на деле совсем не больших: порог всего 1 млрд параметров), кто готов согласиться на полный контроль со стороны государства, то есть сделать свои модели «суверенными» и «национальными». Среди преимуществ: упрощенный доступ к государственным данным, госфинансирование и право обучать модели на охраняемом контенте без согласия правообладателей. Подтверждение соответствия госорганами и «духовные ценности» при этом никуда не делись.

Также под видом поддержки инноваций теперь вся сфера ИИ, а не только большие фундаментальные модели, про которые написан весь текст, отдается президенту, а большая часть применения систем ИИ в публичной сфере фактически выведена из регулирования.

Риск-ориентированный подход в тексте остался, но он декларативен: никакого распределения обязанностей и ответственности внутри цепочек поставок не осталось. Равно как и специфических прав человека. Маркировка и вовсе стала делом добровольным.

Пока что я нахожусь в летней паузе, но скоро мы вернемся к разбору самых интересных вопросов ИИ-регулирования 🤩.


MIT AI Risk Repository опубликовал исследование о приоритетных ИИ-рисках

Команда проекта опросила 272 международных эксперта и предложила им оценить 24 группы рисков. Это все нужно не для того, чтобы создать перечень страшилок, а понять, какие риски сегодня воспринимаются экспертным сообществом как наиболее существенные в контексте ИИ-регулирования.

Ключевой вывод следующий: при сохранении текущей траектории развития ИИ эксперты считают, что 18 из 24 групп рисков имеют не менее 10% вероятности привести к катастрофическим последствиям в течение ближайших пяти лет. Под такими последствиями понимаются, например, более 1 млн смертей, экономический ущерб свыше 100 млрд долларов или сопоставимый по масштабу нематериальный вред, включая подрыв демократических институтов, приватности или общественного доверия.

Исследователи также выделяют пять групп рисков, по которым эксперты ожидают наиболее тяжёлые последствия в ближайшие пять лет:

• опасные возможности моделей;

• конкурентная гонка между разработчиками и государствами;

• использование ИИ для разработки оружия, кибератак и причинения массового вреда;

• концентрация власти и неравномерное распределение выгод;

• распространение ложной и вводящей в заблуждение информации.

Интересно, что в верхней части списка находятся не только классические для юристов темы вроде дискриминации, защиты персональных данных или мошенничества. Исследование фиксирует более широкий спектр: наиболее существенные риски всё чаще связываются с системными факторами, такими как гонка за лидерство, концентрация инфраструктуры, масштабируемость вреда и недостаточность существующих механизмов контроля.

Для регулирования ИИ из исследования следуют несколько выводов:

• ИИ-регулирование должно быть ориентировано не на формальное соблюдение правил, а на реальное управление рисками. Если вероятность катастрофических последствий оценивается как практически значимая уже на горизонте пяти лет, одних рекомендаций недостаточно. Необходимы пропорциональные рискам нормативные требования, обеспеченные силой правоприменения;

• одних добровольных мер со стороны разработчиков также недостаточно. Проблема не обязательно в недобросовестности отдельных компаний, а в том, что конкурентная среда сама по себе создаёт стимулы быстрее выпускать более мощные системы, снижая объём и качество контроля. Эту проблему также нельзя решить без комплексной системы нормативного регулирования;

• далеко не все риски можно снизить на уровне самой модели ИИ. Регулирование должно охватывать несколько уровней: от технических требований к конкретной системе до инфраструктурных и институциональных условий её разработки и применения, включая распределение ответственности между разными субъектами в цепочках поставок.


Новый указ Президента США: будем проверять передовые модели, но никому не расскажем, какие и как

2 июня 2026 года Президент США подписал новый указ "Promoting Advanced Artificial Intelligence Innovation and Security". Несмотря на то что указ прямо заявляет, что не вводит новых обременительных требований для разработчиков, на деле он добивается того же эффекта — просто завуалированно.

Указ относит ряд моделей ИИ к категории "covered frontier model", которым относятся модели, обладающие продвинутыми способностями по взлому информационной инфраструктуры. При этом какие именно модели сюда попадают, определяют силовые органы на основе засекреченного бенчмарка и пороговых значений.

А дальше — классическая, знакомая нам всем уловка. С одной стороны, указ прямо запрещает вводить разрешительный порядок или лицензирование для разработки, выпуска и распространения моделей, а все проверки и взаимодействия с госорганами в рамках общего механизма являются исключительно добровольными. Однако государство фактически даёт компаниям сильнейший стимул: применение их моделей в госорганах и критической инфраструктуре, а также допуск в сеть доверенных партнёров. В итоге вместо прозрачных горизонтальных требований мы видим добровольно-принудительный реестр «доверенных моделей», который будет формироваться на основе скрытых от общественности критериев и показателей. Вот вам и дерегуляция 🐱.

Ещё интересно, что указ стимулирует использование уже существующих составов преступлений для случаев применения систем ИИ в противоправных целях.


Исследования RKS Global про ИИ-регулирование в Евразии

За последние месяцы мы с командой RKS Global подготовили несколько взаимосвязанных материалов, посвящённых ИИ-регулированию в странах Евразии.

1. Исследование «Человек против модели: как государства используют ИИ для цензуры и слежки» направлено на анализ регуляторных и инфраструктурных возможностей государственных органов в девяти юрисдикциях применять системы ИИ в опасных для прав человека целях. В целом ситуация становится тревожной: многие государства выстраивают нормативное регулирование таким образом, чтобы оставить в нём для себя удобные лакуны, которые можно использовать для своей выгоды. Государства всё больше инвестируют в инфраструктуру, а китайские поставщики готовы её поставлять, не особо вдаваясь в этические дилеммы.

2. Обзор первой версии российского законопроекта об ИИ. В текущей версии документ, с одной стороны, получился очень низкого качества с точки зрения здравого смысла и юридической техники, а с другой — просто опасным для прав человека. Документ де-факто вводит необходимость соответствия моделей государственной идеологии и отдаёт широкие полномочия органам власти по применению систем ИИ в сфере безопасности и правопорядка без установления необходимых ограничений и процессуальных мер. Благо большое число организаций и экспертов опубликовали свои замечания к документу. Ждём новый текст законопроекта и надеемся, что к этим замечаниям кто-то прислушается.

По итогам данных исследований хотелось бы в очередной раз подчеркнуть важность качественного ИИ-регулирования: сбалансированное законодательство необходимо не только для поддержки инноваций, но и для ограничения государств и бизнеса, которые пытаются использовать системы ИИ для своего блага, нарушая при этом права человека. Не надо так 🐱.

Показано 20 последних публикаций.