Vadim Lunin


Гео и язык канала: Россия, Русский
Категория: Технологии


О тестировании, AI и IT!
Делюсь опытом, кейсами и инструментами для автоматизации, упрощения процессов и внедрения трендов.
Я — Вадим Лунин, Head of QA в Альфа-Банке.
Связаться: @VadimLunin

Связанные каналы

Гео и язык канала
Россия, Русский
Категория
Технологии
Статистика
Фильтр публикаций


Всем привет! 7 октября выступаю на Techweek в БГУИР (Белорусский государственный университет информатики и радиоэлектроники, Минск) — моей альма-матер — с докладом «Эволюция тестирования».
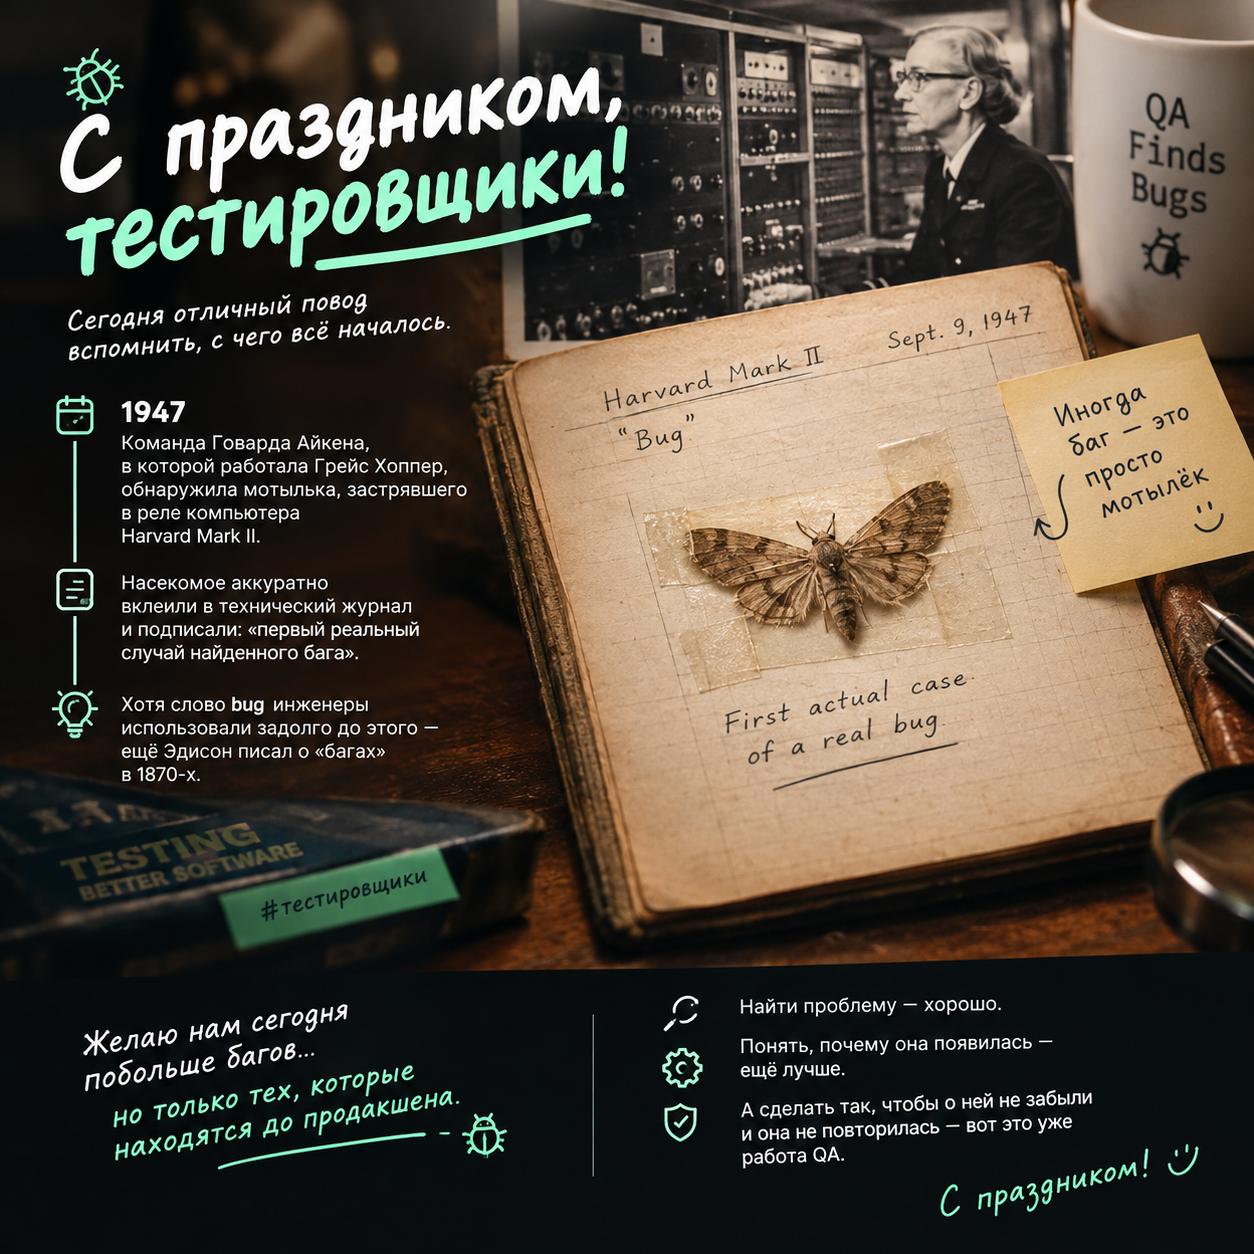
QA как профессия скоро может исчезнуть — но не так, как вы думаете. Пройдём путь от одного мотылька, из-за которого появилось само слово «баг», до идеи, что код и даже интерфейс на экране скоро могут просто... перестать существовать между кликами.
Будет история, будут неудобные факты и смелые прогнозы на 5–10 лет вперёд. А в конце — блиц с каверзными вопросами и мерч тем, кто дослушает внимательно 🎁
📍 БГУИР, Techweek
🗓 7 октября
Приятно вернуться туда, где всё начиналось 😊


Репост из: Эльдар SQA Days & Analyst Days (команда организаторов)
Видео недоступно для предпросмотра
Смотреть в Telegram
🤖 От хайпа к метрикам: реальный опыт внедрения AI в тестировании Вадим Лунин

Генерация тестов силами ИИ давно перестала быть научной фантастикой — сегодня это огромный рынок инструментов. Но давайте будем честны: за впечатляющими промо-роликами часто прячутся серьезные проблемы с качеством и полное отсутствие измеримой пользы.

Как понять, где реальное ускорение процесса, а где просто следование модному хайпу?

На SQA Days 38 Вадим Лунин поделится честным практическим опытом внедрения ИИ в тестирование и на примере продукта TestWriter разберет изнанку этой технологии.

🔍 В докладе:
✅ почему гигантское количество сгенерированных тест-кейсов — это ложная метрика, которая ничего не говорит о качестве продукта.
✅ что реально удалось ускорить с помощью нейросетей, а какие подходы потерпели крах в боевых условиях.
✅ как выстроить многоступенчатую валидацию, чтобы не проверять сгенерированный мусор вручную.
✅ реальные показатели эффективности, типичные ошибки на старте внедрения и рамки, за которые современные LLM выпускать пока рано.

Ждём всех на SQA Days 39
30-31 октября в Москва и онлайн❤️

⚡️программа
⚡️билеты
⚡️афиша
⚡️скидки
⚡️видео

#анонсыsqa39


Репост из: Futuris
Вайбкодить ретро-игры стало удобнее ✨ Pyxel (18к ⭐️) - бесплатный движок на Python в духе старых приставок: 16 цветов, четыре звуковых канала и встроенные редакторы персонажей, уровней и музыки. На нём можно собрать аркаду, платформер или маленькую RPG, а готовую игру запустить на компьютере или в браузере. У того же автора есть второе решение - Pyxel MCP. Оно даёт Codex и Claude возможность не только написать игру, но и запустить её, нажать кнопки, посмотреть скриншоты и проверить, что происходит на экране. Если герой застрял или кнопка не работает, агент увидит результат и сможет поправить код. Для Claude Code есть ещё готовый skill, который подсказывает агенту весь этот порядок работы.

Кто давно хотел попробовать себя в (ретро)геймдеве, но не решался, это ваш вариант👌 Обязательно соберу что-нибудь сам😉


Репост из: Клуб CDO
Дайджест статей

📰 Автоматизация Data Quality: как мы изменили подход к нашим инструментам
🔗 https://habr.com/ru/companies/tbank/articles/1085014/
💡 Отдай генерацию DQ-проверок агенту поверх каталога метаданных с обязательным HITL: 373 таблицы покрыты за три дня силами трёх стажёров.

📰 От сырых проверок качества данных до понятной картины в OpenMetadata
🔗 https://habr.com/ru/companies/magnit/articles/1085076/
💡 Интегрируя внешние DQ-проверки в OpenMetadata, ставь Kafka перед медленным API (около 1 с на запрос) и используй 409 как идемпотентность.

📰 Как устроена платформа данных «АстраЗенека» в России: BI, DWH и Data Lake в одном контуре
🔗 https://habr.com/ru/companies/astrazeneca/articles/1085060/
💡 Разводи запросы по контурам: официальная цифра - в DWH, гипотеза - в озеро, а приёмку работ делай через описание объектов в каталоге.

📰 VK Data Platform под капотом: как устроена платформа для Data Lakehouse
🔗 https://habr.com/ru/companies/vktech/articles/1086190/
💡 Выбирая Lakehouse, проверяй изоляцию compute-пулов над единым Iceberg-слоем, иначе тяжёлый Spark ETL будет тормозить BI.

📰 BI в эпоху ИИ: BI больше не нужен? Да здравствует BI
🔗 https://habr.com/ru/companies/luxms_bi/articles/1086568/
💡 Вкладывайся в обвязку, а не в модель: LLM - расходник, а права, семантика данных и аудит действий агента переживают любую смену модели.

📰 Data-driven или data-hopeful: зачем аналитике становиться системой
🔗 https://habr.com/ru/companies/garage8/articles/1086780/
💡 Оценивай аналитику матрицей зрелости по семи доменам и расти на одно деление за цикл, защитив 10-15% времени аналитиков.

📰 Data mart vs semantic layer when do you need both aedbad
🔗 https://medium.com/@kausik.kb.bhowmik/data-mart-vs-semantic-layer-when-do-you-need-both-ae625db547ad
💡 Прежде чем покупать semantic layer, напиши контракт на одну спорную метрику и прогони его параллельно со старой логикой.

📰 From Messy Data Models to Agentic Data Catalogs: Building an AI Data Architect with OKF and Gemini
🔗 https://medium.com/google-cloud/from-messy-data-models-to-agentic-data-catalogs-building-an-ai-data-architect-with-okf-and-gemini-75a20caee9ed
💡 Храни метаданные как Markdown в Git со ссылками-связями, и агенту хватит одного read-инструмента, чтобы трассировать lineage.


Видео недоступно для предпросмотра
Смотреть в Telegram
Вайбкодеры поймут 😎


Всем привет! Пару недель назад вышел Allure Java 3.0. И это не просто «подкрутили пару зависимостей» — Java 3 получила довольно много изменений. Я выбрал 5 фич, на которые, на мой взгляд, стоит обратить внимание:

1️⃣ Java 17 как минимальная версия

Allure Java 3 перешёл на Java 17. Так что перед обновлением стоит проверить, не живёт ли ваш автотестовый проект где-нибудь в прекрасном мире Java 11 😁

2️⃣ Поддержка встроенного HTTP Client

Теперь Allure умеет работать с Java HttpClient и добавлять HTTP-обмен в результаты тестов. То есть если вы используете стандартный HTTP-клиент Java, не придётся городить отдельные решения для получения нормального evidence в отчёте.

3️⃣ Kotlin-first API + coroutines

Для Kotlin разработали отдельные API, плюс появилась поддержка корутин. Особенно актуально для тех, кто уже давно пишет автотесты на Kotlin и устал притворяться, что Java API — это вполне себе удобно 😄

4️⃣ Global error reporting и run-level globals

Появились глобальные параметры запуска и возможность работать с ошибками на уровне всего запуска. Это полезно, когда проблема относится не к конкретному тесту, а ко всему запуску целиком.

5️⃣ Более богатые attachments и evidence

Улучшили работу с attachment'ами, в том числе добавили поддержку бинарных типов и HTTP exchange attachments. Плюс поправили множество моментов с потерянными или некорректно отображаемыми вложениями.

А мы все знаем: хороший тест без evidence — это просто тест, которому не доверяют. 😏

Ну и это только верхушка айсберга. В релизе ещё куча изменений для JUnit, TestNG, Cucumber, Spock, Karate, gRPC, Playwright и других интеграций.

Полный changelog тут: https://github.com/allure-framework/allure-java/releases/tag/3.0.0

А вы уже успели попробовать Allure Java 3 или пока смотрите на него издалека и ждёте, пока кто-нибудь другой найдёт все сюрпризы? 😁


Репост из: Силиконовый Мешок
Видео недоступно для предпросмотра
Смотреть в Telegram
Немного упоролся в Jev, но так у меня всегда бывает, когда на чем-то гиперфиксацию поймаю.

Вот, например, собрал подборщик нейросетей на базе тех, что есть у OpenRouter, под ваши задачи. Просто пишите, что хотите - получаете подборку нейросетей.

Тут можно поиграть: https://jev-sorter.vercel.app/


Репост из: Neural Shit
Антропики выкатили жирнющий отчёт о использовании Клода с декабря 2025 по август 2026.

Если вкратце: восемь месяцев они отслеживали, кто и как пытается абузить Клода в обход их фильтров. И судя по отчёту фильтры местами держатся на честном слове и изоленте.

Выбрал самое интересное:

1. Китайские ИИ-лаборатории доили Claude
Alibaba, DeepSeek, Moonshot/Kimi, Xiaomi и другие китайские компании в библейских масштабах вытаскивали из Claude данные для обучения своих моделей.

Alibaba, например, выкачала больше 150 млн диалогов и специально заставляла Claude выплёвывать цепочку рассуждений, чтобы потом скармливать эти рассуждения Qwen для дистиляции. Moonshot и DeepSeek пошли путём ещё веселее: часть запросов своих пользователей они втихую пересылали в Claude Opus, а ответ возвращали как свой. Таким макаром DeepSeek однажды случайно отправил Anthropic действующие доступы от базы российского госведомства, связанного с Минобороны. Таким же образом утекал и внутренний софт китайской полиции для отслеживания людей.

2. Йеменцы и ракеты
Группа из северного Йемена решила, что незачем нанимать программистов, есть же Клод, ёпта. Claude Code запрягли писать софт управления и наведения для разных вариантов ракет и прочих взрывных ништяков. Самое прекрасное: у одной ракеты бортовой компьютер был уровня обычного смартфона и её даже реально запустили. Антропики пишут, что испытание закончилось хуёво: спустя несколько часов разработчики вернулись к Клоду уже с телеметрией разбираться, почему эта хуйня упала.

3. Дейтинг-фермы
Китайская студия сделала 20+ скамных приложений для знакомств и заселила их виртуальными барышнями на базе Claude. За две недели более 4700 ИИ-персонажей успели пообщаться минимум с 25 тысячами человек.
Чтобы мамонты не заподозрили неладное, наняли ещё и живых людей (примерно одного кожаного на трёх ботов). Они подключались к видеозвонкам, подписывались в соцсетях и прочими способами подтверждали, что "девушка настоящая". После этого общение снова брал на себя Клод, а пользователь продолжал покупать внутри приложения монетки для переписки.

4. Самопересобирающаяся малварь
Русскоязычная кибершпионская группа, которую Антропики связывает с Midnight Blizzard, собрала почти идеальный конвейер: ИИ-агенты проверяли, палятся ли их трояны антивирусами. Если да, то агенты сами лезли в исходники, правили вирусы, пересобирали и снова проверяли. И так по кругу, пока антивирусы не переставали замечать малварь. После этого свежая версия вируса сама отправлялась на боевые серверы.

5. Автономный рой FPV-камикадзе
В России небольшая команда пилила проект DronDoc/Serafim. Это автономный рой FPV-дронов-камикадзе. Claude помогал писать почти весь софт: координацию роя, наведение по камере, поиск операторов противника, прошивку и логику атаки. На борту предполагалась маленькая локальная модель, которая решала, атаковать, наблюдать или возвращаться. Отдельный компьютерный классификатор обучали на реальных фронтовых видео. До подтверждённого применения в бою вроде как дело не дошло, но код уже заливали на реальные платы и гоняли вместе с железом.

6. Иранские спецслужбы тоже не отстают: эти клепали вредоносные расширения для Firefox под видом утилит для проверки времени намаза, чтобы массово собирать данные о пользователях соцсетей. Параллельно строилась система Arman, где на человека можно было собрать досье с национальным ID, убеждениями, судимостями, соцсетями и дальнейшими "действиями". Через Claude они прогнали анализ 155 тысяч твитов.

7. Вайб-хакинг
Один из связанных с ShinyHunters чуваков скачал 1,8 млн Android APK, автоматически декомпилировал их и сканировал на предмет забытых API-ключей, токенов и прочих подарков от криворуких разработчиков. Найденные ключи потом использовали для взломов. А если попадался ключ от Claude, то вообще красота: он использовался уже для следующих атак. Anthropic называет такой подход vibe hacking. Т.е. мамкиным хакерам уже ненужно разбираться в инфраструктуре компании. Он просто тыкает агента палкой и говорит: "Вот тебе доступ, найди что-нибудь ценное и спизди". А дальше нейронка сама изучает систему, пишет и запускает скрипты, ковыряет API и базы и повторяет всё это, пока не доберётся до результата.

Ну и в итоге, получается, что "РЯЯЯЯЯЯ!!! ИИ УНИЧТОЖИТ ЧЕЛОВЕЧЕСТВО" пока не случилось. Зато стадия "ИИ помогает человечеству уничтожать друг друга быстрее и дешевле" уже во всю идёт по плану.


Ну что, господа агрономы, картошки не будет 😄

А вот худи, сумка и немного тестировщицкого мерча от ТестОпс есть.

Спасибо ребятам! Очень приятно, когда на День тестировщика дарят не очередную кружку, а вещь, которую реально будешь носить ❤️


Привет всем!

Мне тут ребята из ТестОпс сделали подарок ко Дню тестировщика 🎁

Судя по объёму, весу и внешнему виду, очень похоже на… грунт 😄

Я, конечно, понимаю, что я белорус и люблю драники. Есть такое. Но свою картошку я пока ещё не начал сажать 😂

Поэтому теперь мне интересно: как вы думаете, что там внутри?

Делитесь версиями 👇


Недавно поучаствовал в ряде собеседованиях к нам в команду.

Вообще, собеседования я уже давно стараюсь делегировать своим ребятам. Иногда мне кажется, что они от этого не в восторге 😄 Но на одну вакансию решил поучаствовать лично.

И каждому кандидату задавал один и тот же вопрос:

«Знакомы ли вы с моими материалами на Хабре или с моими выступлениями на YouTube?»

И знаете что? Каждый ответил — нет 😄

Дело даже не в том, что меня не читают. Хотя, конечно, могли бы! 😂

Я когда-то писал эти материалы не просто ради статей. Хотел показать, какими современными инструментами мы пользуемся в Альфа-Банке, почему именно их выбрали и как вообще устроен наш подход к тестированию.

А то вдруг кто-то думает, что в банке до сих пор работают на «Корветах», а тесты пишут на перфокартах 😄

Но в итоге на собеседовании мне всё равно приходилось всё это рассказывать самому.

Поэтому решил исправляться.

Буду периодически делиться здесь отдельными инструментами, подходами и интересными решениями, которые используем в QA в Альфа-Банке.

А пока можно начать со старых материалов, которые я писал ещё в 2023 году:

• Part 0. Инструментарий QA в Альфа-Банке
• Part 1. Инструменты автоматизации тестирования
• Part 2. Инструменты управления тестированием
• Part 3. Инструменты тестирования производительности

Материалы уже не новые, но многие вещи до сих пор актуальны.

487 0 14 5 20


Нашёл интересное обсуждение на Lobsters: человек жалуется, что после массового внедрения AI коллеги начали приносить на ревью PR в среднем на ~6000 строк.

И в комментариях, кажется, собрали почти весь коллективный крик боли разработчиков 😄

Что советуют:
- Большой PR — отправлять обратно.
В одной компании, например, есть правило: максимум 400 строк diff. Неважно, написал код человек или AI.

- PR должен объяснять “что и зачем”.
Если автор не может нормально объяснить, что изменилось и почему, ревью превращается в археологические раскопки.

- AI можно использовать как первый фильтр.
Пусть он найдёт очевидные проблемы, а человек уже решает, действительно ли их нужно исправлять. Потому что AI умеет найти проблему даже там, где её нет.

- Разбивать изменения на маленькие атомарные PR.
Stacked PR — вполне рабочий вариант. Причём AI неплохо помогает технически разделить большой PR на части, но вот придумать хорошую архитектуру этих изменений ему доверять пока рановато.

- Не надо бояться сказать “нет”.
“Я не могу качественно проверить 6000 строк. Разбей на части” — это не вредность ревьюера, а нормальный engineering process.

- И самое интересное: AI не несёт ответственность за то, что попало в production.

Можно сгенерировать код за 5 минут. Но понять, что именно ты собираешься выкатить, всё равно придётся человеку.

И, пожалуй, главная боль всей истории:

AI ускорил написание кода. А вот скорость человеческого понимания пока не увеличил.


В результате мы можем получить ситуацию, когда код пишется быстрее, чем его успевают прочитать.

А у вас уже появились AI-generated PR на сотни/тысячи строк? Как с этим боретесь?

Источник и очень интересное обсуждение — Lobsters.


Репост из: Айтигребец
Замена @gif уже тут - @gifer 🥳

Увидел, что это не только моя боль и решил создать inline телеграм бота для нормального поиска гифок - таким каков был @gif до момента поломки.

Как пользоваться?
В любом чате напишите "@gifer кот"

и выберите котика. Он сохраняется в ваши личные гифки. Всё просто ❤️

Что под капотом
Я пошёл немного дальше и предобрабатываю поисковой запрос фокусом на русский язык. Я замечал явную деградацию выдачи даже в старом нативном боте. Опечатки, сложные русские слова, аббревиатуры - оно часто ломало поиск и нужно было придумывать какой-то синоним или вспоминать как это на английском пишется = трата времени.

В техническом плане - довольно "дефолтный" для всех моих пет-проектов стек - тайпскрипт, серверлесс на aws, dynamodb, s3, cloudfront, cloudflare, lamdas, sqs.

В общем, должно быть удобно для тех, кто пользовался @gif'ом

Буду рад фидбеку и распространению по друзьям ^^ 🤟


Приглашают на бесплатный вебинар про автоматизацию и ИИ 🤖

Тема: «Автоматизация тестирования как инвестиция: от внедрения к измеримому результату в эпоху ИИ»

Мне кажется, тема сейчас очень актуальная. Мы активно внедряем автоматизацию, используем ИИ, пробуем новые инструменты, но главный вопрос остаётся прежним — а какой реальный результат это даёт QA и бизнесу?

На вебинаре обсудят:

• должна ли автоматизация работать на цели QA и бизнеса или достаточно считать количество тестов;
• почему автотесты и репозитории могут быть, а регресс всё равно оставаться ручным;
• где ИИ действительно помогает экономить время QA-команды — от анализа требований до генерации автотестов и разбора логов;
• почему ИИ не всегда спасает и иногда просто помогает быстрее масштабировать существующий хаос 😄;
• и как вообще выбирать подход: сначала найти проблему в QA-процессе, а уже потом решать, что использовать — автоматизацию, изменение процесса, архитектуры или ИИ.

Спикеры:
• Вячеслав Аргунов — менеджер по обеспечению качества «Перфоманс Лаб»
• Тимофей Бородич — заместитель технического директора «Перфоманс Лаб»

Отдельно приятно видеть Тимофея в роли спикера — думаю, будет интересно послушать его взгляд на эту тему.

🎁 Все участники также получат новый выпуск Russia Quality Report 2026 — исследование рынка QA и опыта 470+ компаний.

3 сентября, 16:00 МСК
Участие бесплатное, зарегистрироваться можно здесь: https://www.performance-lab.ru/webinar/qa-03-09/

До встречи на вебинаре!


Репост из: эйай ньюз
Nvidia покупает 🤗HuggingFace

Не прошло и недели с начала слухов о покупке, а на HuggingFace уже нашёлся покупатель в лице Nvidia. Компания заплатит $12,9 миллиардов за покупку.

В принципе это лучший возможный сценарий, у HuggingFace всё было не идеально с выручкой — всего $150 миллионов в год. А Nvidia, как компания, кровно заинтересована в развитии открытых моделей, так что HuggingFace продолжит развиваться.

@ai_newz

Показано 20 последних публикаций.