Make. Build. Break. Reflect.


Гео и язык канала: Россия, Русский
Категория: Технологии


Полезные советы, всратые истории, странные шутки и заметки на полях от @kruchkov_alexandr

Связанные каналы

Гео и язык канала
Россия, Русский
Категория
Технологии
Статистика
Фильтр публикаций


#aws #пятница

2016 год.
AWS re:Invent. Под музыку прямо на сцену въезжает фура.
Это AWS Snowmobile: контейнер на 100 петабайт с охраной и GPS.
Зал аплодирует 😲😮😮.
Никто не понимает, зачем это нужно, но все снимают на телефон.

2024 год.
Snowmobile тихо убирают из списка сервисов, без пресс-релиза и без прощальной вечеринки.
Дальше о нём помнят только авторы вопросов к экзамену AWS и несчастные экзаменующиеся.

2032 год.
Дата-центры выходят из строя чаще, чем падают деплои по пятницам.
Единственный бэкап в соседнем регионе удалил ИИ-агент. Его попросили почистить неиспользуемые ресурсы, и бэкап выглядел весьма таким заманчиво неиспользуемым.

Кто-то в Сиэтле вспоминает старую мудрость: never underestimate the bandwidth of a truck full of disks 💪.

Грузовик находят на задворках склада в Неваде.
Обшивают железом и шипами, как в "Безумном Максе", и запускают программу "Snow-бэкап региона".
В 2016-м 100 петабайт казались бесконечностью.
Теперь же в них влезает целый регион, если не брать логи и стактрейсы джавы.
С современными же дисками влезает даже node_modules.

Он несётся по пустому шоссе из Техаса в Миннесоту.
Рулит ИИ-агент со своим роем сабагентов.
Каждые 50 миль он спрашивает:
- "Продолжить? (y/n)".
Охранник в кабине жмёт Y 🤪.

За грузовиком летят дроны. Чьи - никто уже не помнит.
Дронов сбивают беспилотные Waymo, впервые в истории никому не перегородив дорогу. Роботы Unitree забрасывают остальных сетками.
Кто согласовал эту поддержку, неизвестно.
Кажется, просто чёт так навайбкодилось 🤷.

Ночью помятый и в подпалинах грузовик с гирляндой на кабине въезжает в резервный дата-центр.
Играет "Праздник к нам приходит" из рекламы Кока-Колы.
Люди обнимаются. Кто-то плачет.

Восстановление из бэкапа прошло успешно.
Впервые в истории его кто-то реально проверил.

Вернулся даже Netflix. Первым делом он предложил продолжить просмотр с 2031 года.

В слаке инженер пишет:
- "Ашалеть, не думал, что вопрос про Snowmobile с экзамена мне когда-нибудь пригодится 😮"

На ближайшем re:Invent под музыку
The Chemical Brothers - Go прямо на сцену въезжает фура. С шипами.
На борту надпись
"Snowmobile AI. Now with AI agents. AI!".
Зал аплодирует 😲😮😮.
Никто не понимает, зачем там агенты, но все снимают на телефон.


#troubleshooting #devops #одинденьизжизни

Однажды пришёл на работу, я oncall, вижу алерт - поды рестартятся.

Смотрю, что там:
kubectl get pods -n | grep redis
redis-ha-server-1 1/4 Running 7 10m
Ага, один под постоянно рестартится. 7 раз за 10 минут.

Смотрю логи:
kubectl logs -p redis-ha-server-1 -c redis -n

1:S * MASTER REPLICA sync started
1:S * Full resync from master
1:S * MASTER REPLICA sync: receiving streamed RDB from master
1:signal-handler Received SIGTERM scheduling shutdown...
1:S * User requested shutdown...
Реплика начинает Full Resync, а через 27 секунд получает SIGTERM и умирает. А синхронизация большой базы занимает минуты.

Смотрю ивенты:
kubectl get events -n --field-selector involvedObject.name=redis-ha-server-1 --sort-by='.lastTimestamp'

Normal Killing pod/redis-ha-server-1 Container redis failed startup probe, will be restarted
Warning Unhealthy pod/redis-ha-server-1 Startup probe failed: role=slave; repl=sync
Ага, контейнер убивает стартап проб.

Проверяю настройки:
kubectl describe pod redis-ha-server-1 -n | grep -A1 Startup:

Startup: exec [sh -c /health/redis_readiness.sh] delay=5s timeout=15s period=10s #success=1 #failure=3

failureThreshold: 3, periodSeconds: 10, initialDelaySeconds: 5.
Первая проверка на 5-й секунде, дальше каждые 10: 5, 15, 25. Третья неудача подряд, и контейнер убивают. Плюс пара секунд на сам скрипт, отсюда и мои 27.

А база весит 550 мегабайт, и Full Resync идёт дольше.
Пока реплика синхронизируется, health check возвращает ошибку.
Через три неудачи подряд startup probe считает контейнер мёртвым, и кублет его перезапускает. Синк начинается заново, и так по кругу.

Проблема вроде бы понятна. Нужно увеличить failureThreshold.

Правлю StatefulSet:
kubectl edit statefulset redis-ha-server -n
Меняю failureThreshold у контейнера redis с 3 на 120. Сохраняю.
Удаляю под:
kubectl delete pod redis-ha-server-1 -n

Жду, смотрю логи.
Та же херня, рестарты продолжаются.
Сука.

Проверяю, что применилось в поде:
kubectl get pod redis-ha-server-1 -n
-o jsonpath='{.spec.containers[?(@.name=="redis")].startupProbe.failureThreshold}'
3
Бл, под создался со старым значением.

А в StatefulSet что?
kubectl get statefulset redis-ha-server -n
-o jsonpath='{.spec.template.spec.containers[?(@.name=="redis")].startupProbe.failureThreshold}'
120
В StatefulSet уже 120, а в поде 3.
Что за ебанная магия?

Проверяю, кто управляет StatefulSet:
kubectl get statefulset redis-ha-server -n -o yaml | head -30

metadata:
annotations:
meta.helm.sh/release-name:
meta.helm.sh/release-namespace:
labels:
app.kubernetes.io/managed-by: Helm

Helm. Но сам по себе Helm ничего не откатывает: reconcile у него нет, ресурсы он трогает только на helm upgrade.
Кто именно подсунул поду старый шаблон, я так и не выяснил. Если поймаете такое, смотрите managedFields: там видно, кто и когда писал в объект.
kubectl get statefulset redis-ha-server -n --show-managed-fields -o yaml

Ладно. Шаблон в StatefulSet правильный, значит, надо заставить контроллер пересоздать поды из него. Смотрю стратегию обновления:
kubectl get statefulset redis-ha-server -n -o jsonpath='{.spec.updateStrategy}'
{"type":"OnDelete"}
При OnDelete контроллер обновляет под, только когда его удаляют. Я его и удалил, а он всё равно поднялся со старым шаблоном. Почему, честно, не знаю.

Переключаю на RollingUpdate, чтобы контроллер перекатил всё сам:
kubectl patch statefulset redis-ha-server -n --type=json -p='[
{"op": "replace", "path": "/spec/updateStrategy/type", "value": "RollingUpdate"}
]'

Проверяю новый под:
kubectl get pod redis-ha-server-1 -n
-o jsonpath='{.spec.containers[?(@.name=="redis")].startupProbe.failureThreshold}'
120
Отлично, теперь 120.
Смотрю логи: Full Resync завершился успешно, всё синхронизировалось.
Но дальше вижу, что сразу после успешной синхронизации соединение теряется.

Смотрю логи мастера:
kubectl logs redis-ha-server-0 -c redis -n --tail=50

1:M * Connection with replica lost.
1:M # closed for overcoming of output buffer limits
Ага, мастер рвёт соединение, потому что переполнился output buffer.

Проверяю лимиты:
kubectl exec redis-ha-server-0 -c redis -n --
sh -c 'redis-cli -a $AUTH CONFIG GET client-output-buffer-limit'

slave 268435456 67108864 60
Hard limit 256 MB, soft limit 64 MB на 60 секунд.

Буфер на мастере дорос до 152 MB. До hard limit не дотянул, но soft limit (64 MB) держался превышенным дольше 60 секунд. Этого достаточно, чтобы мастер убил соединение.

Пока мастер стримит RDB, все новые записи копятся в этом буфере. Большая база и активная запись дают ровно такую картину.

Увеличиваю лимиты:
kubectl exec redis-ha-server-0 -c redis -n --
sh -c 'redis-cli -a $AUTH CONFIG SET client-output-buffer-limit "slave 1073741824 536870912 60"'

Теперь hard limit 1 GB, soft limit 512 MB. CONFIG SET применяется сразу, без рестарта. Важен он именно на мастере, но я прописал его на всех нодах: sentinel может переключить мастера в любой момент.

Заодно поднимаю repl-backlog-size до 512 MB. Full sync это не лечит: backlog нужен, чтобы после короткого разрыва реплика догналась частичным PSYNC, а не начинала полный синк заново. Но и памяти он съедает столько же, так что проверь лимиты, если не хочешь поймать OOMKill.

Перезапускаю реплику, чтобы она заново прошла full sync уже с новыми лимитами:
kubectl delete pod redis-ha-server-1 -n
Смотрю логи: теперь всё ок. Соединение не теряется, реплика стабильна, никто не пиздит в канале алёртов.

Что сделать, чтобы всё это не слетело
Всё, что я накрутил руками, временное:
- kubectl edit, kubectl patch и смена updateStrategy слетят на следующем helm upgrade или sync
- CONFIG SET живёт до рестарта пода, потом конфиг снова берётся из ConfigMap

По-нормальному это должно жить в values чарта, в Git:
redis-ha:
redis:
startupProbe:
failureThreshold: 120
config:
client-output-buffer-limit: "slave 1073741824 536870912 60"
repl-backlog-size: "512mb"

Итог.
- дефолты редиса (или чарта редиса?) не рассчитаны на 550 MB кеша (на тот момент было около 25000+ аппилкейшнов)
- Helm не делает reconcile, но ручные правки в кластере всё равно не живут, всё постоянное должно лежать в values
- если под пересоздаётся со старым спеком, смотрите managedFields; RollingUpdate может помочь, но мастер тоже перекатится, будет failover
- CONFIG SET живёт до рестарта 🫠

Довольный, на дейли рассказываю, как героически победил редис.
Лид дослушивает, кивает и спрашивает:
- А нахера ты с этим возился? Это ж редис арго, там только кеш.
Дропнул бы базу, и всё.

- ...

Читаю интернеты, так и есть. Всё лечилось одной командой на мастере:
kubectl exec redis-ha-server-0 -c redis -n --
sh -c 'redis-cli -a $AUTH FLUSHALL'
Реплика синкает пустую базу за секунды, арго сам заново греет кеш.

Справедливости ради, кеш снова дорастёт до 550 MB, так что values с лимитами всё равно пригодятся. Но это можно было сделать спокойно, а не под алертами!

Мораль: прежде чем героически чинить, спроси себя, что это вообще за данные и жалко ли их.🤡🤡🤡

Сгорая от стыда, пишу эту заметку и скрываюсь в тумане 🚶‍♀


#kubernetes #devops

Kubernetes не решает проблемы хуёвого софта.

Если приложение течёт по памяти, не умеет в пробы, не отдаёт метрик, не умеет в параллельность, падает от каждого чиха и хранит стейт в локальной папке, то в кубере оно будет делать то же самое, только теперь с регулярным рестартом и алертами в три ночи.

790 0 7 17 45

Последние пару лет, и на этой работе, и на прошлой, каждая встреча у меня начинается одинаково: я либо игнорирую, либо радостно жамкаю "отклонить" всем ноттейкерам в лобби.

Позиция простая: либо приходите сами, либо сами нажимайте "разрешить" своим ботам и идите по своим делам.

Всю жизнь мечтал работать швейцаром у ботов в Zoom/Teams/Google Meet 🙂

На самом деле бесит пздц.


Интересно, а что там внутри?

Типа полетели алёрты в слак из датадог/ньюрелик/алертменеджер.
Потом включается Claude on-call.
Caramelizing...
Flibbertigibbeting...
...
Cogitating

...
Contemplating...
Coalescing...


И потом типа он такой выдаёт
Found root cause...
It was ... Release!...
Opening a revert PR
...
С вас 500k токенов, лол.
Так?

Ну я к тому, что когда агент работает от моего ПК, у меня есть скиллы, инструкции где что брать, настроен конфиг, есть MCP, есть VPN, ежедневно прохожу авторизацию для SSO, раз в пару недель для google аккаунта - и от меня всё работает так, как я хочу при траблшутинге по алертам.

Не очень хорошо, но терпимо работает агент в автономном режиме с моего пк, лишь ровно до тех пор, пока не слетят авторизации и VPN или пока он не начнёт нести херню в слаке коллегам, раздражая их (ему пофиг на запреты не писать в слак свои простыни текста моим коллегам, сука).

Только проблема далеко не всегда в релизе, а в куче других факторов.
Для анализа нужны метрики, логи, ивенты и так далее.
Всё это под SSO авторизацией, в закрытом контуре.

А если всё-таки проблема в релизе - простите, роллбек кривого релиза сделает любой инженер, который умеет считать дважды два и у него есть хотя бы один глаз.
Зачем тут агент?

А как это работает с клод онколлл?
Как он сможет траблшутить чего-либо, если у него физического доступа нет?
Предоставить доступ? Задеплоить сабагента в кубер и дать ему IRSA/pod identity на нужные ресурсы? Сделать мир прекраснее и открытее для всех агентов?

Короче маркетинговая коричневая магия какая-то.
Решил посмотреть документацию.

Оказалось, что живёт он не в наших кластерах, а в песочнице Антропика, так что IRSA мимо.
Креды берёт из сервисных учёток, которые мне надо завести и отдать им, и ходит только по HTTPS.
VPN, SSH, SMM и прямой доступ к базам ему недоступны, тоже мимо.😁
Если весь обсервабилити в SaaS (Datadog, New Relic) - ок, выдал read-only апи ключ и поехали.
А если Prometheus/VictoriaMetrics, логи и кубер живут за VPN - либо открывать ему всё наружу🤣, либо получаешь тот самый "It was Release… Opening a revert PR…".

Ну в общем пока поживём на локальных/кубер агентах (типа https://github.com/kagent-dev/kagent или http://github.com/mezmo/aura, тысячи их), без клод онколла.


#aws #AWScommunity #eks #kubernetes

Что выбрать при создании нового AWS EKS кластера в 2026 году: стандартный режим или Auto Mode?

Выбирайте стандартный режим (без Auto Mode), если вы:
- хотите разобраться в облачном кубере Амазона и изучить десяток компонентов (Karpenter, VPC CNI, CoreDNS, kube-proxy, EBS CSI, Load Balancer Controller…), которые вам теперь придётся обслуживать примерно всегда
- любите тюнить кубер или компоненты минимум раз в квартал
- боитесь, что вас заменят ИИ, и хотите оставить себе крепкий якорь, который помешает вас уволить
- любите читать матрицы совместимости и GitHub issues по каждому компоненту
- гоняете большой флот на спотах или сейвинг план и умеете считать деньги
- без своего AMI, софта прямо на ноде или собственного CNI жить не можете
- любите зайти на ноду по SSM и посмотреть чо там
- живёте на Windows- или Ubuntu нодах 😬

Выбирайте Auto Mode, если:
- у вас нет DevOps/Platform команды, которая бы поддерживала кубер, потому что вы стартап
- вы руководитель, всех уволили, заменив на ИИ, и теперь, как Дункан Маклауд, остались один и не знаете, что делать с вашим кубером ⚔️
- хотите тратить время на код и манифесты, а не на поддержку инфраструктуры
- готовы потерять последние крохи экспертизы по эксплуатации нод и аддонов для куба, ведь уже через год на автомод вы не сможете объяснить на собесе, как у вас апгрейдится CNI и что это такое
- у вас нормальная зрелая компания, которая ценит время инженеров дороже 12% к счёту за EC2 и не страдает ИИстерией


Лично я бы всегда по умолчанию брал автомод.


#пятница

Ждём, чо.

А вообще да, заебали эти охринительно полезные новости с невероятными достижениями.


#kubernetes

- https://laravel-news.com/laravel-health-kubernetes-prometheus

Жаль, что такого пакета не было, когда я работал с Laravel.

Раньше приходилось городить костыли: самописные эндпоинты, несколько разрозненных пакетов, ручная настройка liveness/readiness-проб и прометиус-метрик.

Был spatie/laravel-health с хорошим набором проверок, но отдельных эндпоинтов под кубер и прометиус из коробки в нём (раньше) не было.

Теперь есть новый пакет (по ссылке от cboxdk):
- много проверок: БД, кэш, очереди, редис, storage, диск, расписание (через heartbeat шедулера), окружение, CPU и память
- отдельные эндпоинты под кубер: /health (liveness), /health/ready (readiness), /health/startup (startup)
- встроенные прометиус-метрики на /health/metrics: статус и длительность каждой проверки плюс системные метрики
- container-aware метрики из cgroups v1/v2: лимиты и потребление памяти, CPU quota, CPU throttling и OOM kills

Пакет совсем молодой, звёзд с неба не хватает на гитхабе пока мало, так что в прод я бы тащил его после внимательного взгляда на код. И сначала стоит проверить, что именно попадает в liveness: если туда входит проверка БД, то при падении базы кублет начнёт перезапускать все поды разом😁.
Однако авторы, если не ошибаюсь, это https://cbox.dk/, у них точно есть опыт с PHP/Laravel и я уверен, что пакет будет весьма успешным.

В целом хорошая новость для владельцев Laravel стека, кто в кубере живёт.

Требования:
- PHP 8.3+
- Laravel 11-13


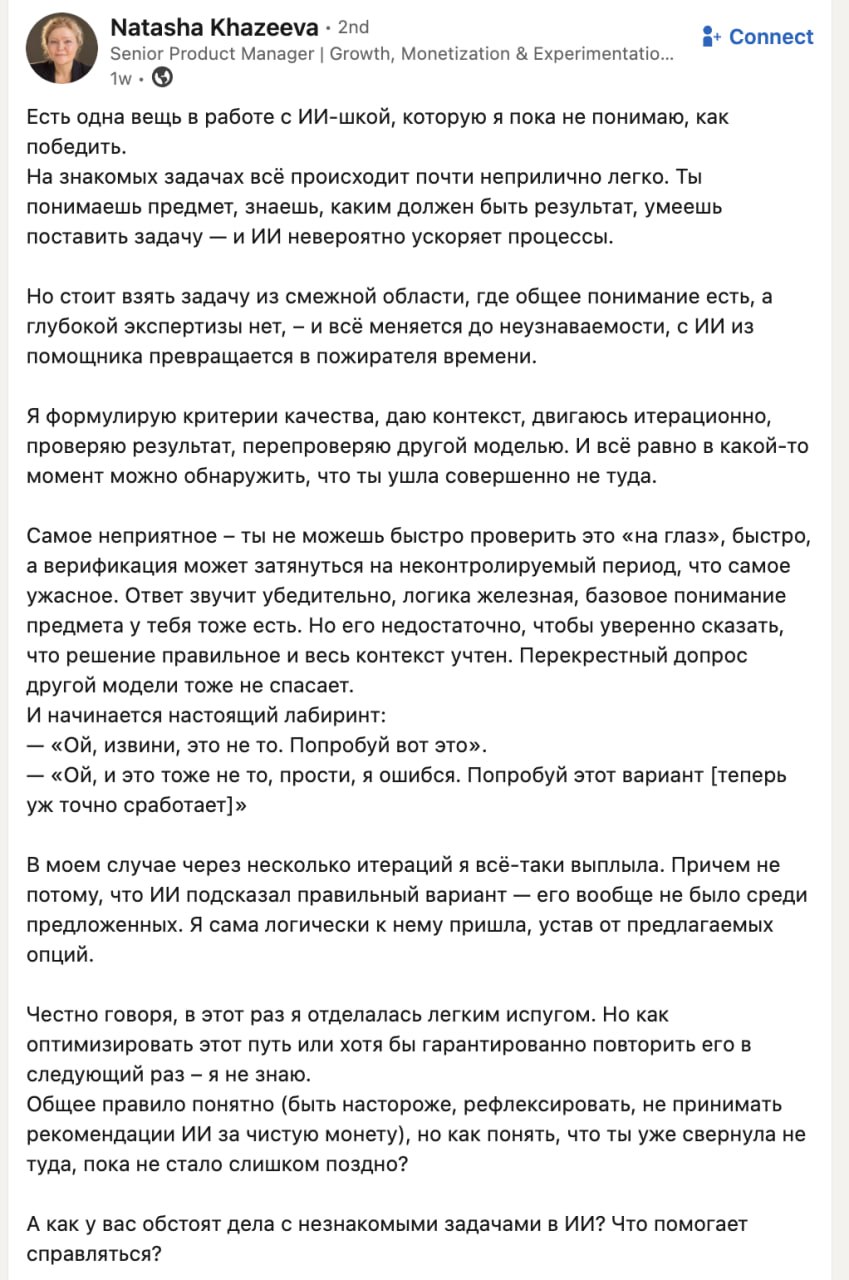
Но стоит взять задачу из смежной области, где общее понимание есть, а глубокой экспертизы нет, – и всё меняется до неузнаваемости, с ИИ из помощника превращается в пожирателя времени.


Действительно, а почему так выходит.😕
Непонятно, ведь ИИ всех заменит, а образование и экспертиза через время и опыт больше не нужны, да.

https://lnkd.in/p/d7JDGDdQ


В удивительнейшее время живём.

- https://typesafe.ai/blog/introducing-system-one-models-and-jev
TypeSafe анонсировали Jev, свою первую "System One" модель - быстрые типизированные решения вместо генерации текста.
- https://github.com/mizorewww/laya-mlx (на минуточку это уже опенсорс!)
а это похожая по духу модель, но от другой компании (Convai Innovations), уже в опенсорсе и с портом под Apple Silicon (eto ya со своим макбуком).
И она меньше гигабайта!

То есть Jev сам по себе проприетарный и закрытый, но концепция уже доступна в опенсорсе - я погонял именно Laya.

Поигрался - весьма интересно.

Пример использования (первым пришло в голову для тестов):

- установить этот опенсорс decision-модель
pip install laya-mlx
- залогиниться в hugging face
- запилить скрипт laya_triage.py
"""Local Laya (MLX) triage of a SQL query; escalate to a Hugging Face LLM only if needed.

Usage:
HF_TOKEN=hf_xxx python ~/laya_triage.py # uses the built-in sample query
HF_TOKEN=hf_xxx python ~/laya_triage.py query.sql # or a query from a file
Optional env: HF_MODEL (default below), LAYA_THRESHOLD (default 0.5).
"""

import os
import sys

import laya_mlx
from huggingface_hub import InferenceClient

HF_MODEL = os.environ.get("HF_MODEL", "Qwen/Qwen2.5-Coder-32B-Instruct")
THRESHOLD = float(os.environ.get("LAYA_THRESHOLD", "0.5"))

SAMPLE_SQL = """
SELECT u.id, u.name, COUNT(o.id)
FROM users u
LEFT JOIN orders o ON u.id = o.user_id
WHERE u.created_at >= '2026-01-01'
GROUP BY u.id, u.name;
"""


QUESTIONS = {
"needs_optimization": {
"type": "noul",
"instructions": "Does this SQL query contain potential performance bottlenecks "
"(full table scans, inefficient joins, missing filters on large tables)?",
},
"issue": {
"type": "choice",
"instructions": "What is the most likely performance problem in this SQL query?",
"criteria": {
"missing_index": "The query filters or joins on columns that likely need an index",
"heavy_aggregation": "The query uses GROUP BY / COUNT over very large tables",
"fine": "The query looks optimal",
},
},
}


def triage(agent, sql):
answers = agent.predict(sql, QUESTIONS)["answers"]
p_slow = answers["needs_optimization"]["noul"]
issue = answers["issue"]["choice"]
print(f"[laya] needs_optimization p={p_slow:.2f}")
print(f"[laya] issue={issue} probs={answers['issue']['probabilities']}")
return p_slow >= THRESHOLD and issue != "fine", issue


def optimize(sql, issue):
token = os.environ.get("HF_TOKEN")
if not token:
sys.exit("HF_TOKEN is not set; cannot escalate to Hugging Face")
client = InferenceClient(api_key=token)
resp = client.chat_completion(
model=HF_MODEL,
messages=[
{"role": "system", "content": "You are a senior database performance engineer."},
{
"role": "user",
"content": f"A classifier flagged this query as likely '{issue}'. "
"Explain the bottleneck briefly, suggest indexes, and give an optimized "
f"query if one exists.\n\n```sql\n{sql.strip()}\n```",
},
],
max_tokens=800,
)
return resp.choices[0].message.content


def main():
sql = open(sys.argv[1]).read() if len(sys.argv) > 1 else SAMPLE_SQL
agent = laya_mlx.load() # convaiinnovations/laya, downloaded once to the HF cache
needs_llm, issue = triage(agent, sql)
if not needs_llm:
print("[laya] query looks fine, no LLM call")
return
print(f"[hf] escalating to {HF_MODEL} ...\n")
print(optimize(sql, issue))


if __name__ == "__main__":
main()
- запускаем
HF_TOKEN=hf_Tgar5555555jlOS python ~/laya_triage.py
- и практически мгновенно получаем результат
[laya] needs_optimization p=0.19
[laya] issue=heavy_aggregation probs={'missing_index': 0.0781, 'heavy_aggregation': 0.6264, 'fine': 0.2955}
[laya] query looks fine, no LLM call
Магия магией.


Важно: это триаж локальной моделью (Laya), а не замена ревью!!!
Ни она, ни HF-модель при эскалации не трогают базу, они только советуют. Финальное решение (индекс добавлять или нет) всё равно за человеком!


#aws #elasticache #redis #kubernetes #troubleshooting #devops #sre #longread

Ничего не предвещало беды. Сижу, работаю, обычный день.
Прилетает алерт: CPU на редисе.

Открываю графики - ну офигеть, действительно много. CPUUtilization уже почти в потолке. Смотрю на историю подольше, не за последний час, а за пару недель - а она там не спонтанно скакнула, она туда шла целенаправленно, полз-полз-полз последние недели вверх, и вот сегодня наконец доехала до трешхолда, который у нас на алерт стоит. Красивая, спокойная, методичная деградация. Как будто специально ждала, чтобы я это заметил именно во вторник.

Стою на развилке, как обычно в таких случаях.
Вариантов, по сути, три сходу:
- поднять инстанс тип побольше - и вопрос закрыт. Минут на пятнадцать работы.
- копать почему нагрузка растёт - раз уж она растёт неделями, значит где-то есть тренд (мемори лик?), и если его не найти, он вернётся через месяц уже на инстансе побольше.
- полезть в релизы/код - может, кто-то тихо принёс что-то, что жрёт редис сильнее, чем раньше.

Времени в этот день было, под рукой прямых пожаров нет, так что решил нырнуть.

Начал копать. Смотрю на количество соединений к редису - и это тоже растёт. Причём растёт не гладко, а скачками.
Спустя время понял, что ровно в моменты редеплоев и скейлинга подов.
У меня в голове сразу щёлкает классика жанра: коннекшн лик.
Кто-то не закрывает соединения при рестарте пода, они копятся, some magic, редис в итоге не столько данные обрабатывает, сколько бегает между тысячами открытых, но по факту мёртвых клиентов.

Полез руками смотреть список клиентов - и что вы думаете, реально нахожу один клиент, зависший в цикле на одной и той же команде. Судя по времени коннекта - висит там натурально сутки, сука, с прошлого деплоя.
Убиваю его руками, CPU чуть проседает. Ага, думаю, вот он, зверь, поймал.

Порадовался я недолго. Потому что счётчик коннектов и без этого одного зомби-клиента всё равно был в районе четырёх тысяч, а нагрузка не сильно шевельнулась.

Сели разбираться вдвоём. У коллеги гипотеза жёстче моей: раз коннекты копятся, давай просто грубо перезапустим весь неймспейс с воркерами.
Убили все поды.

И - та-дам - нагрузка реально упала. Вот же оно, подумали мы, воркеры плодят коннекты при каждом релизе и не убирают их за собой, поэтому со временем только расти и расти.

Только вот через пару минут после того, как поды снова поднялись до штатного количества, коннекты вернулись ровно туда же, откуда были - к тем же четырём тысячам. Ни больше, ни меньше. Что как-то не очень бьётся с теорией "утечки": утечка накапливается со временем, а тут число просто вернулось на место и стабилизировалось.

Стали считать руками, вместо того чтобы верить на глаз. Взяли количество воркер-процессов на под, умножили на количество подов - и цифра сошлась с реальным числом коннектов почти впритык (разница пара процентов, спишем на процессы в момент рестарта). То есть на каждый воркер-процесс - одно соединение к редису на каждую используемую БД внутри инстанса. Это не утечка. Это ебаная архитектура. Просто у нас этих воркер-процессов оказалось значительно больше, чем реально нужно под текущую нагрузку - часть очередей держала по 20+ воркеров при спросе, близком к нулю.🤡

Осадочек неприятный: убийство подов "помогло" не потому что мы нашли причину, а потому что случайно совпало по времени с тем, что коннекты после ресета временно проседают, пока воркеры не долетят обратно до штатного числа. Классическая ловушка - совпадение по времени легко спутать с причинно-следственной связью, если не проверить цифры отдельно.

Ладно, коннекты - не утечка, они просто ожидаемо большие. Но CPU-то всё равно в потолке, и с этим ничего не сделало ни убийство подов, ни чистка зомби-клиента. Значит дело не в количестве соединений как таком, а в чём-то, что происходит с этими соединениями под нагрузкой.

Дальше - самая интересная часть. У ElastiCache есть слой "enhanced I/O" с io-threads, которые молотят входящий трафик отдельно от главного event-loop потока. И вот при определённом уровне конкурентных подключений без пайплайнинга этот флаг io_threads_active залипает в 1 - и тогда добрая половина основного (единственного, сука) engine потока улетает во busy-wait: не делает полезной работы, не в syscall, просто крутится в холостую, ожидая координации с io-потоками. Причём сама выполняемая команда - это 9-12% занятости потока, всё остальное - вот этот самый спин.

Проверили это экспериментально на реплике без прод-трафика: подняли конкурентные подключения без пайплайнинга - флаг щёлкнул с 0 на 1, и разрыв между "занят" и "реально делает команды" улетел с полутора процентов до пятидесяти. В 34 раза. Сняли нагрузку - всё вернулось на исходную позицию. Воспроизводится по требованию.

Самое обидное: нодовая метрика CPUUtilization в CloudWatch при этом показывала спокойные 44% - потому что она про весь инстанс с его 8 vCPU, а не про то, что творится именно в главном движковом потоке. EngineCPUUtilization - вот метрика, которая реально видит проблему, а на неё у нас не было алерта вообще. Ни одного. Полезная информация лежала в CloudWatch всё это время, просто мы на неё не смотрели.🤡

Дальше прогнали чек-лист на исключение всего остального, чем это могло быть: экспайры ключей - доли процента от жизни, evicted_keys - ноль, дефраг - ноль, решардинг хештейбла - ноль, keyspace-нотификации - учтены внутри команд и не создают отдельной нагрузки, скрипты/функции - вообще не используются, ни одной команды дольше 10мс за всё окно наблюдения. Это точно не медленный запрос и не утечка памяти. Это именно координационный оверхед в закрытом слое ElastiCache, который мы не видим и не можем настроить - параметр io-threads не выставлен наружу ни в одной из параметр-групп valkey, CONFIG SET для него заблокирован.

Раз рычага внутрь закрытого слоя AWS у нас нет - работаем с тем, что реально в наших руках:
- срезали количество воркер-процессов там, где спрос был почти нулевой, а супервизоров держали как для продакшна с полной загрузкой (одна из групп очередей - 22 воркера при спросе меньше десятка операций в сутки). Это прямо снижает число одновременных подключений, соответственно снижает шанс залипания флага в 1.
- добавили алёрт по EngineCPUUtilization, а не только по CPUUtilization - потому что нодовая метрика в принципе не видит этот тип насыщения.
- хардним ElastiCache client reaping и client-output-buffer-limit - отдельная гигиена, чтобы зомби-клиенты (тот самый, что я руками убил в начале) не жили сутками незамеченными.
- поправили notify-keyspace-events - было включено с флагами, генерирующими события, которые вообще никто не читает (180 тысяч событий в секунду в пустоту, лол). Не фикс основной проблемы, но лишняя работа редиса, от которой легко избавиться.

Первый подозреваемый почти никогда не виновник. Коннекты росли - я сразу подумал "лик". Убийство подов "помогло" - я почти поверил, что нашёл причину. А по факту оба раза я гонялся за симптомом, который просто совпал по времени с настоящим виновником, спрятанным на уровень ниже, там, куда обычная нодовая метрика вообще не смотрит.


Ссылки могут быть сейчас устаревшими, были актуальны на момент проблемы
- https://repost.aws/knowledge-center/elasticache-redis-high-cpu-usage
- https://medium.com/better-programming/redis-internals-client-sends-a-command-and-receives-a-response-9e3e8c463f7


Вся эта неделя была очень странной.

Опус отупел до уровня 3 модели.
Фейбл сжигает токены быстрее, чем Усейн Болт пробегает 10 метров.
Лимиты токенов на клодкоде 100% урезали, не хватало для простейших задач, на прошлых неделях на тех же промптах хватало всегда.
Модели начинают сами с собой спорить, входить в циклы, снова галлюцинировать.

На картинке типичная ситуация этой недели
"Когда дал клоду задачку с опусом и пришел спросить его как дела через 2 часа".


Apple наконец слила beta и release в один продукт и избавились от лишнего шага в релизном цикле. 🎉🎉🎉

https://www.reddit.com/r/MacOS/comments/1wgek2q/macos_27_golden_gate_bugs_and_issues_megathread/


#мысли #devops #aws

Куча людей перешли на искусственный интеллект, так и не освоив собственный.


Мне нравится, даже при наличии ЛЛМ, думать самостоятельно.
Не из принципа "ебаать, я не такой, как все", а потому что это чуть ли не единственный тренажёр для мозга, оставшийся при нынешней пониженной нагрузке на инженера.
И у этого тренажёра есть техника: не искать готовый ответ, а раскладывать вопрос на слои, пока каждый слой не станет проверяемым.

Вот как это у меня выглядит на практике.

Пример.
Есть AD-сервис, допустим MS Entra. Есть AWS и сервисы внутри него. У какого-то сервиса - пусть OpenSearch, не важно, хоть Redis - по дефолту ебанутое имя типа:
- dkjfh-hui-izda-dgigkhurda-aws.account.region.amazonaws.com

Через Entra-приложение настроили SSO.
Всё работает: люди ходят на некрасивый урл, логинятся через проклятый майкрософтовский аккаунт, все счастливы.

Усложняем.
Разработчики захотели красивые адреса - для UI и CLI-агентов.
Задача: добавить в Route53 (или другой DNS сервис)
- logs-prod.domain.com
- redis-stage.domain.com
Почему - да без разницы, просто захотели.

И вот тут вместо того, чтобы спросить ЛЛМ "как правильно", я по очереди раскладываю задачу на слои - каждый следующий вопрос вытекает из ответа на предыдущий, а не из общей интуиции "SSO - это сложно".

- DNS. Просто добавить запись - заработает? По идее нет: нового адреса нет в списке разрешённых redirect URI в Entra, он отвалится с ошибкой мисматча. И это не хардкод где-то в коде, а обычный allowlist.

- Коллбек vs UI. Это одно и то же? Нет, вроде разные слои. UI-адрес - то, что видит браузер. Коллбек - то, куда Entra шлёт ответ после логина. Можно спокойно жить на новом UI-адресе, а коллбек временно оставить на старом.

- Что я поломаю нахуй самим добавлением. Само добавление DNS-записи - ничего. Ломает либо снос старой записи/старого redirect URI сразу, либо TLS: у AWS managed сервиса сертификат зашит под их дефолтный домен, левый CNAME туда просто не пройдёт проверку сертификата без прокладки сверху (ALB, CloudFront - что угодно со своим сертификатом на новый домен).

- Алиасы в Entra. Redirect URIs / Reply URLs - это список, в него добавляют, а не заменяют существующее. А если это SAML, появляется третий слой - Audience/Entity ID, и с ним уже не всегда так просто: не каждый SP умеет несколько audience одновременно. Умеет ли ентра?

- А может, сразу дропнуть старое и переехать целиком? Ну уж нет. Это же чисто flag day cutover на SSO - способ уронить логин всем разом, если хоть один слой не совпал.

- Где реально терминируется сертификат. Что если вместо Route53 - Cloudflare: как быть с прокси и эджем, что если это Cloudflare ACM. Здесь я сознательно не даю себе ответа - это уже вопрос конкретной архитектуры, а не общей логики разбора.

- А может у AWS есть custom URL фича для этого сервиса и ничего выдумывать не надо?


Обычно у меня нет прямого ответа на вопрос, как и задачи такой, ведь всё это лишь размышления.

Зато есть метод, который я в процессе применяю: не спрашивать "заработает или нет", а спрашивать самого себя "какие независимые системы должны согласиться друг с другом, чтобы это заработало" - и проверять их по одной. DNS, TLS, redirect URI, SAML audience и порядок отключения старого - это разные системы, которые нужно свести по отдельности, а не одна абстрактная "настройка SSO".

Вот это разложение на слои и есть то, что деградирует, когда думать за тебя начинает модель.
Факты модель знает лучше меня. Определённо.

А привычку резать проблему на проверяемые куски - тренирует только ручная работа.


#aws и немного #всратость

Честно говоря я немного разочарован последними UI изменениями, произошедшими в AWS docs.

Возможно молодому, стильному и умному поколению инженеров интерфейс нравится, но мне с ним работать стало неудобно.

Возьмём к примеру случайную страницу.
https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/CHAP_Limits.html
Листаем до первой таблицы.
Визуально кажется - вот всё, что есть в таблице - это вся информация.
Ведь видно только этот элемент.
Однако при наведении мышки/тачпада на саму таблицу - появляется scrollbar и уже видно элементы таблицы вниз и вверх. (гифка)
Открывается новая инфа, ранее визуально недоступная.
Как я мог догадаться, что теперь там скрыт скроллбар?
Ну, наверное, должен был как-то.

Пойдем к другой случайной странице
https://docs.aws.amazon.com/AmazonRDS/latest/AuroraUserGuide/aurora-global-database.configuration.requirements.html
А вот тут, сколько ни елозь мышкой по первой таблице - ничего не открывается.
Вероятно я должен понять, что этих параметров достаточно и больше там ничего нет.
Чего я, как дурак картонный, тыкаю тачем по таблице - непонятно что-ли, что нет там больше ничего.

Идём дальше, например
https://docs.aws.amazon.com/service-authorization/latest/reference/list_securityhub.html
Тут же, наоборот, вниз таблицу сделали полностью, она, о-чудо!, уместилась, а вправо информации уже нет.
На этой странице у этой таблицы надо тачем елозить уже только вправо-влево по таблице.

Как я должен понять - на какой из таблиц мне елозить тачпадом во все стороны, а на какой нет - ну, вероятно, догадываться, проверяя каждый подобный элемент документации.☔️

Это произошло не вчера, а постепенно происходит с многими страницами документации. Может это даже современный тренд в дизайне.

Понятно, что лишь ворчу, но это немного печалит, ведь документация и интерфейс должны быть понятны и очевидны.
Сейчас же это стало затруднительнее.
Надо буквально "подрочить пальцами по тачпаду на каждой табличке" чтобы понять есть ли там ещё чего или нет.
Чем мешал ранее всегда видимый скроллбар - не понимаю.


Классный вышел тред и официальный платиновый ответ.😁

Чувствую много болей в ближайшие дни.
https://github.com/orgs/community/discussions/206581#discussioncomment-18269083

С некоторых комментов можно гиеной прокричать
So, just to make sure I understand this correctly: unauthenticated access to public repositories suddenly became unreliable, CI pipelines all over Europe started breaking, GitHub Status stayed green, and the official solution is basically “authenticate your public repository downloads and deal with it yourselves”?


Само решение:
git config --global http.version HTTP/1.1


#всратость

Ну-да, ну-да.
Это так и работает, ага.
Больше ничего не надо вводить.🥴

Похоже и правда пора в отпуск.🤡


#devops #tools

Просто набор интересных ссылок, которые у меня накопились для шаринга.
По каждой отдельно писать немного странно, так что всё вместе будет.


- https://blog.cloudflare.com/dns-cache-memory-optimization-1111/

Как клаудфлер сэкономил миллионы оперативной памяти за счёт оптимизации кода. Шикарно, по-инженерному. Меня такое прям вдохновляет, очень круто.

- https://www.youtube.com/watch?v=LX4YZeqXWck

Какие подводные камни были у ребят из airbnb при переезде на циллиум.
Молодцы, шарят такое.
Если нет знаний английского - в ютубе есть автоматический перевод аудиодорожки на русский. Слабенький, но его достаточно для усвоения материала.
Спойлер: а зачем тебе спойлер? Смотри и слушай видео, не ленись, ну.

- https://github.blog/news-insights/company-news/the-august-17-outage-and-the-work-ahead/
- https://www.githubstatus.com/incidents/zkxwbgr0cnmx

Постмортем гитхаба на один из крупных инцидентов.
Просто интересно посмотреть почитать изнутри.

Мне очень жалко инженеров гитхаба, на них свалилось много всего последние пару лет из-за увеличения нагрузки от вайбкодинга и всегда интересно читать, что же они делают, чтобы справиться со своей несовершенной архитектурой (на данный момент в век llm), чтобы совсем не пасть духом и статуспейджем.

- https://github.com/vorssaintapp/vorssaint-utils

Один из лучших утилит для MacOs.
❤️
Опенсорс бесплатный супер комбайн, который может отчасти заменить многие привычные всем утилиты. AltTab, Rectange etc.
Очень жалею, что купил лицензию AlbTab (для дополнительного функционала), лучше бы я раньше узнал об этой утилите.
Считаю, что моя лучшая находка в 2026 для мака.
На маке я работаю лишь с марта этого года.

- https://trendshift.io/monthly

Трендовые git репозитории по месяцам/неделям/дням.
Если вы прям любите быть на bleeding edge - это вам.
Всё самое модное и свежее - всякие скилл репо, агентик репо, фреймворки, харнессы и всё то, о чём будут писать лишь через несколько недель или месяцев, а вы это уже освоите сегодня.

- https://www.goncharov.xyz/it/devops-roadmap.html

Очень старая схема-роадмап девопса от Гончарова
К сожалению, я добрался до неё буквально недавно, упустил его публикацию.
Не буду говорить согласен ли я с этим планом на 100% или нет (сейчас век "ИИ" и всё сказанное мной будет не актуально через неделю), но почитать точно стоит.
Для общего развития, не брать основным планом развития.

- https://www.redhat.com/en/resources/oreilly-generative-ai-kubernetes-analyst-material

Бесплатная книга от redhat+oreilly, которую я определённо дочитаю по дороге в отпуск.
Сейчас начал читать - по мне так ок, закрою пробелы по базе.
Уверен на 90%, что это будущие вопросы на будущие собеседования 2027-2028, так что точно дочитаю.

Показано 20 последних публикаций.