Николай Тузов


Гео и язык канала: Россия, Русский
Категория: Блоги


Go Developer, автор YouTube канала по Go: https://www.youtube.com/@nikolay_tuzov
Live канал: @ntuzov_live
AI News: @tuzov_ai_lab
Go Digest: @golang_digest
Обратная связь: @justskiv
Поддержать:
https://boosty.to/nikolay.tuzov/
https://t.me/ntuzov/126

Связанные каналы  |  Похожие каналы
Гео и язык канала
Россия, Русский
Категория
Блоги
Статистика
Фильтр публикаций


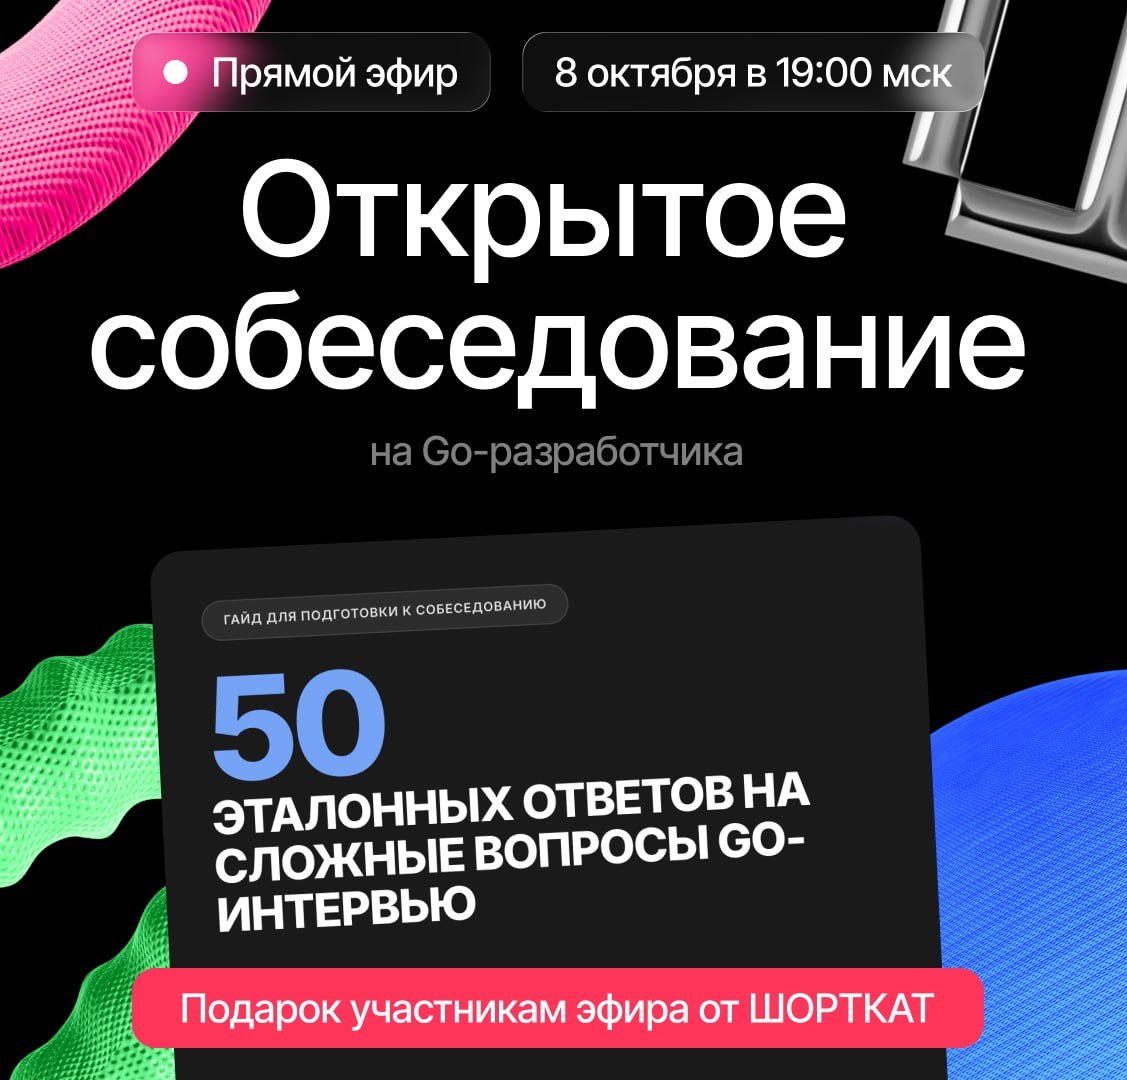
🎓 Тестовый собес с Go Senior из Гамбурга, ex-Yandex и ex-Uzum

Когда: четверг, 8 октября, 19:00 МСК, онлайн.

Интервьюер — Маруф Караев, Senior Software Engineer в Гамбурге. До этого работал в Yandex и Uzum.

Как это будет:

- Маруф задаст разработчику-добровольцу вопросы и задачи со своих реальных интервью. Заранее их никто не знает

- После каждого ответа будет обратная связь: что прозвучало сильно, а что стоило раскрыть иначе. Так понятнее, на что на самом деле смотрят на собесе

- В конце можно задать Маруфу любой вопрос

Эфир проходит в рамках менторской программы ШОРТКАТ для Go-разработчиков, которые хотят сменить работу и вырасти в грейде и зарплате.

Регистрация через бота @shortcut_go_bot. После неё пришлют файл с ответами на 50 вопросов с Go-собесов.

#промо #текст_прислан

4.7k 0 33 18 32

❤️Исследование рынка Go-разработчиков от DevCrowd

Традиционно, уже четвертый год не устаю вам напоминать о работе этих ребят. Рынок — сложная непонятная штука, а нам хочется чтобы эта штука стала прозрачной. Единственный способ этого добиться — проводить честные опросы среди всех его участников. Чем больше выборка, тем более полную картину мы увидим.

Вот эту ношу на себя и взяли DevCrowd, больше никто не делает подобные исследования на сопоставимом уровне. Наша же с вами задача — пройти подготовленный ими опрос.

Поэтому не проходите мимо — много времени это не отнимет, а результат интересен и полезен нам всем.

Я его уже прошёл, заняло минут 15.

Результаты прошлых лет можно посмотреть тут

————

Не реклама, честная рекомендация 🫶

6k 0 31 4 39

🥂Разбор Go 1.27 полностью дописан!

Вы уже, наверно, забыли о том, что вышла новая версия языка, и что я пишу о ней статью.. 😩

В статье появились разделы про аллокации и рантайм, net/http, портируемый SIMD и go fix, а в самом конце чек-лист на случай, если после апгрейда у вас упал CI. Всё новое читать отсюда.

А ещё я добавил в большинство запускаемых код-сниппетов, включая старые, переключатель версии, чтобы сравнить новое поведение с прежним (там, где это имеет смысл). Так ещё интересней щупать изменения.

Если запутались в истории обновлений этого обзора, можете тыкнуть на дату обновления (в шапке статьи), там будет хронология важных правок.

----

😩 Честно говоря, на эту статью я потратил неадекватно много времени. Релиз вышел 19 августа, а на дворе уже октябрь.

Каждый раз, когда я брал в работу новый пункт из release notes, упирался в вопросу «а почему?». Например, авторы пишут, что мелкие аллокации подешевели «до 30%» на микробенчмарке и примерно на 1% в реальном коде. Откуда такой разрыв? Пришлось лезть в исходники рантайма и гонять разные бенчмарки на трёх машинах. Оказалось, что ускорение выключается, пока сборщик мусора помечает живые объекты. Чем больше программа аллоцирует, тем чаще работает сборщик и тем реже ей достаётся ускорение.

А ещё мне хотелось, чтобы всё это читалось интересно и легко, даже сухие разборы бенчмарков. К примеру, я очень долго возился с графиками, пытаясь сделать их максимально понятными, наглядными и простыми.

Но оно того стоило. В итоге, обзор релиза превратился в небольшой, но глубокий экскурс во внутрянку актуального Go — как аллокатор раскладывает объекты по спанам, когда запускается сборщик мусора, как были устроены таймеры до 1.23, зачем процессору векторные регистры и др.

Так что, даже если сам релиз вам не особо интересен, статья — хороший повод углубить свои знания. Ну и на собеседовании про аллокатор будет что рассказать.

Надеюсь, вам понравится!

————

Теперь напьюсь отдохну, и пойду дописывать обновлённую серию статей про Планировщик. Работы непочатый край..

❤️ Если захотите поддержать мой труд, милости просим в наш закрытый клуб. Я сейчас занимаюсь контентом фуллтайм и ничего не продаю, моё творчество остаётся публичным и бесплатным. Поэтому ваша поддержка очень важна.


Дописал самый большой кусок статьи про Go 1.27 — раздел про постквантовые подписи.

В 1.27 приехал пакет crypto/mldsa и вся обвязка вокруг него (сертификаты, TLS). Обмен ключами добавили ещё в 1.24, а теперь очередь дошла до аутентификации — то есть на чистом Go наконец-то полностью собирается постквантовый хендшейк 🎉

Обычно этому разделу в обзорах уделяют незаслуженно мало внимания — многие плохо понимают в чём тут суть, и кажется, что это касается каких-то мифических "специалистов по безопаности". А те кто разбираются чуть лучше, думают что чесаться ещё рано, потому что достаточно мощных квантовых компьютеров ещё не существует. Но на самом деле, это касается всех нас уже сейчас.

В новом разделе я написал подробный ликбез про постквантовую криптографию, а также объяснил почему это актуально уже сейчас.

Также я там рассказал:

- Почему главная проблема ML-DSA — размер, а не скорость
- Зачем в crypto.Hash появилось значение MLDSAMu (которое хеш-функцией не является)
- Что со всем этим делать прямо сейчас

Сниппеты, как обычно, запускаются прямо со страницы статьи на актуальном go1.27. Можно сгенерировать ML-DSA-ключ, подписать сообщение и посмотреть, во что превращается минимальный самоподписанный сертификат: почти четыре килобайта против 217 байт у Ed25519. Бюджет TLS-хендшейка я нарисовал отдельным наглядным виджетом 🦄

Да, статья всё ещё не дописана, работаю над ней прямо сейчас. Остались рантайм, net/http, SIMD, тулинг и раздел про то, что может сломаться при апгрейде.

————

Возился с этим разделом дольше, чем с любым другим в статье: криптография — не та область, где можно писать по памяти, каждый абзац сверялся со стандартами, документацией и т.п.. Надеюсь, вам понравится ❤️

Начал писать про один пакет, а закончил рассказом про алгоритм Шора и решётки 😩

Кстати, если хочется отдельного разбора — как вообще устроены обмен ключами, подписи и шифрование, напишите в комментариях. Если тема востребована, сделаю. Ну и про постквантовую криптографию можно подробнее рассказать, раз уж я в это погрузился.


Нельзя мне браться за обзоры релизов... Вместо небольшого раздела по постквантновые подписи в Go 1.27, я написал по небольшой гайд постквантовой криптографии...

Сегодня-завтра постараюсь обновить статью и опубликовать этот раздел.

Ну ладно, зато было весело 👍


😐 Ультимативный разбор... Go 1.27?

Честно, не знаю зачем я это сделал, но я сделал.. Ну почти.

https://golang.guide/go-1-27/

Сначала я решил просто написать базовый обзор релиза. Но потом я увлёкся и не смог вовремя остановиться.

Мне хотелось не просто сухо рассказать об изменениях, а добиться глубокого понимания читателя — причины этих изменений, какие проблемы они решают, как реализовано, почему именно сейчас, какая история стоит за самыми интересными фичами. При этом, я старался писать так, чтобы всё это читалось интересно и легко.

В итоге, работа над статьёй так сильно затянулась, что когда она выйдет, сам релиз уже никому не будет интересен. Поэтому я решил опубликовать ту её часть, которая уже готова — это примерно 60%, и туда вошло всё самое интересное и важное:

- Дженерик-методы, которые десять лет обещали не добавлять
- Новый движок JSON v2
- Пакет uuid наконец-то в стандартной библиотеке
- Детектор утечек горутин, который переиспользует сборщик мусора — на мой взгляд, самое красивое, что есть в этом релизе

Во вторую половину войдут: постквантовые подписи, рантайм, net/http, SIMD и тулинг. Это я дописываю прямо сейчас, оно появится в той же статье.

Все код-сниппеты запускаются прямо из статьи на актуальном go1.27. Каждый из них можно редактировать и экспериментировать — не нужно открывать отдельный плэйграунд. А ещё я подготовил для вас наглядный виджет с демонстрацией механики работы детектора утечки горутин.

Я потратил на эту статью ОЧЕНЬ много времени. Возможно, стоило потратить на более фундаментальный гайд — тот же GC, над которым я также сейчас работаю. Но надеюсь, вам всё же понравится ❤️
Стоит ли писать подобные обзоры про новые релизы?

————

А ещё я прикрутил к сайту email-рассылку (и письмо про Go 1.27 туда ушло сильно раньше этого поста) и комментарии к статьям. Если вдруг заметите какие-то баги, пишите в комментариях, постараюсь оперативно поправить.

И не хулиганьте в комментариях на сайте!
👍

#article #go1_27

17.8k 2 187 63 430

👴 Посоветуйте хорошего бухгалтера на аутсорс в Казахстане, в идеале в Астане

Рынок у нас маленький, и хороших специалистов найти сложно. При этом, сейчас многие разработчики работают по ИП, и наверняка часто делегируют ведение бухгалтерии профильным специалистам.

Если у вас есть на примете хорошие проверенные специалисты, поделитесь контактом, пожалуйста. Можно в ЛС: @justskiv


🦄 Опубликовал платформу для гайдов и первую статью

https://golang.guide/

Надеюсь, вам понравится, я очень старался ☀️

Там всего один единственный гайд — первая часть серии статей про Планировщик. Даже если вы читали оригинальную статью, или смотрели ролик, всё равно советую перечитать — тут полный ремастер и режисёрская версия с интерактивом 👍

Остальные статьи уже в работе. Буду выпускать их по мере сил.

Советую читать с десктопа — там пока больше фич, чем на мобилке.

Если заметите какие-то баги или проблемы — пишите, поправлю.

16.9k 2 288 65 533

В последние дни работаю чуть ли не по 16 часов над этим проектом — мой перфекционизм не даёт мне покоя. Делаю одну правку, и тут же ещё десяток идей возникает в голове.

Сейчас мне всё более-менее нравится, второстепенное отложил на потом.

Планирую сделать релиз завтра в первой половине дня. Ну, я надеюсь на это 😩

10.8k 0 41 34 459

🦄 Платформа для гайдов, о которой я давно мечтал

Видение того, как должен выглядеть сайт с гайдами / курсами у меня сложилось довольно давно, и все эти годы продолжало эволюционировать.

Но вот в чём проблема — видение то было, но возможности реализовать его не было, потому что:

- Из меня ужасный дизайнер — я могу объяснить чего и как хочу, и сказать "красиво" или "не красиво, но сделать красиво самостоятельно не получается

- Я далёк от фронтэнда — что-то знаю, но опыта мало. На полноценный проект уйдёт много времени, а результат будет плохой

- Свободного времени было так мало, что лучше потратить его на что-то более приземлённое

Нанять настоящего верстальщика и дизайнера я бы не потянул, т.к. все мои проекты строятся на чистом энтузиазме, и почти не монетизируются.

Что ж, времени у меня теперь сильно больше, а дизайнера и верстальщика мне заменил Claude — с недавних пор он стал в этом невероятно хорош. Все блокеры сняты, наконец-то можно свободно творить. И я сотворил 👍

————

Как должна выглядеть "платформа моей мечты", чего мне все эти годы не хватало:

- 💅Дизайн строго по моему вкусу — я очень падок на визуал, и крутой дизайн очень меня мотивирует. Словами мне это сложно описать, чуть позже сами увидите.

- Лёгкая сборка — статичный сайт, который собирается из md-файлов — в идеале, Hugo, конечно же. Сайты получаются очень лёгкие и их поддержка почти ничего не стоит.

- Наличие интерактивных виджетов и пошаговой анимации. Часто бывает так, что какую-то концепцию проще "показать", а не описать словами и ли нарисовать. Дать читателю это "пощупать", поиграться. Это может заметно сократить размер статьи, и при этом сделать её понятней, интересней, наглядней. Мне этого очень не хватало, когда я писал статью про планировщик.

- Удобная работа с "сериями" статей. Опять же, на Хабре и других платформах таких механизмов нет вовсе, и поэтому мне проще написать монолитную статью, чем делать из неё неудобный сериал. Но наличие такого механизма сильно упростило бы жизнь как мне, так и читателям.

- Интерактивное содержание (TOC) — такое уже много где есть, но вот на Хабре, увы, нет. В случае больших статей без него вообще ни как.

- Минимализм. Да, после всего вышеперечисленного кажется, что слово "минимализм" тут неуместно. Но я под этим подразумеваю, что на сайте должно быть только то что действительно улучшает пользовательский опыт, и ничего лишнего

Это основные моменты. Кроме них, есть ещё множество мелочей, которые суммарно дают огромный вклад — удобный быстрый поиск по материалам, несколько цветовых тем на выбор (не всем удобно читать только на белой/черной теме), режим "фокусирования" (когда на экране нет ничего лишнего, кроме текста статьи) и др.

————

Что ж, на днях я полностью закончил разработку такой платформы, и сейчас активно наполняю её контентом.

Для начала, я хочу перенести в неё мои имеющиеся материалы — разбор планировщика, написание grpc / rest api сервисов, а также разбор каналов и map (по ним статей ещё нет, только ролики — теперь будут).

Все эти материалы я попутно актуализирую и дополняю — за годы я многому научился, есть что добавить. Кроме того, теперь мне не мешают "технические ограничения" других платформ.

Короче, мои старые работы скоро получат "режиссёрскую версию" 👴

Релиз первой статьи будет примерно на днях, а пока можете полюбоваться красивой заглушкой 💅

#анонс


☀️ Мой путь в IT — статья

https://tuzov.dev//posts/my-way-to-it/

Наконец-то закончил очередную переработку одной из своих серий постов в большую статью. Как и в прошлый раз, я не просто склеил посты, а проработал текст намного лучше.

❤️Хороший повод прочитать или перечитать, если вам нравится такой жанр

В посте упоминается, что я перенёс все свои старые детские программы в веб. Мне надо чуток причесать это дело, после этого опубликую и напишу отдельным постом.

#статья #live


В последнее время меня всё больше беспокоит одна вещь — все эти разговоры про применение LLM похожи на гадание на хрустальном шаре. Мы пытаемся с умным видом рассуждать о моделях, при этом всё что мы о них знаем — то что они каким-то хитрым образом рожают нам ответ. Колдунство, не иначе.

На старте, когда всё это только зарождалось, оно так сильно не беспокоило. Сейчас же мы выстраиваем очень сложные воркфлоу работы, делаем далеко идущие выводы, сравниваем модели, рассуждаем об их применимости — "большой контекст это плохо" (почему?), "это модель сильнее" (почему?),"с этой моделью правильно работать вот так" (почему?).

Ну то есть, мы машем руками, смотрим как эта штука себя ведёт, а дальше начинаем чувствовать себя экспертами, "специалистами в AI-инженерии". Мне кажется, это довольно опасная дорожка.

Поэтому я в последнее время стараюсь всё сильнее углубляться во внутреннее устройство LLM, чего и вам советую. Не обязательно становиться экспертами ещё и в этой области, но какое-то базовое понимание иметь стоит.

По мере моего погружения, буду стараться вводить и вас в курс дела такими вот постами. Как допишу серию, соберу её уже в большую статью.

————

🟢Это не упрёк к кому-либо, а просто мой личный дискомфорт. Возникают ли у вас такие же мысли?


Репост из: Tuzov AI Lab
🤖 LLM под капотом: трансформер. Часть 2

Серия #llm_internals

В прошлом посте мы разобрались, как промт превращается в набор векторов и потом прогоняется через стопку блоков, обновляясь под контекст. На выходе у нас та же последовательность векторов, но числа в каждом — уже совсем другие. Особенно интересен последний — в нём «спрессована» информация обо всём промте.

Теперь обсудим самое главное — как из этого вектора рождается следующий токен

Шаг 3. Генерация следующего токена

Итак, у нас есть исходная последовательность токенов из промта, и мы хотим сгенерировать следующий токен. Как это сделать?

На самом деле, у нас уже всё для этого есть — модель просто берёт наш последний вектор (соответствующий последнему токену промта) и сравнивает его со всеми векторами таблицы эмбеддингов. Грубо говоря, она перебирает все известные ей токены, и смотрит насколько близки их вектора к нашему последнему вектору.

В итоге, в качестве следующего токена, она выберет какой-то случайный — но чем ближе его вектор к нашему, тем выше его шансы.

Чтобы окончательно уложить это в голове, давайте снова упростим картину.

Вернёмся к нашему 3-мерному пространству. Представьте, что в нём раскиданы 100 точек — это таблица эмбеддингов модели. А ещё где-то в этом пространстве висит особая точка — это наш последний вектор после всех преобразований. Модель измеряет, насколько он близок к каждой из 100 точек таблицы. И чем ближе точка из таблицы к нашему вектору, тем выше её шансы стать нашим следующим токеном.

В реальности — пространство 12000-мерное, точек около 100k, но принцип тот же.

Итак, у нас есть оценка близости к нашему вектору для всех токенов словаря. Дальше из этого набора выбирается итоговый токен. По умолчанию — самый вероятный (то есть, ближайший).

Но можно специально внести случайность — за это отвечает параметр «температура».

На температуре 0 модель всегда берёт самый вероятный токен (детерминированный режим). Чем выше температура — тем чаще модель отклоняется от очевидного варианта в сторону менее вероятного. На 2+ это уже почти полная фантазия — повышается риск генерации полного бреда, зато ответы интереснее и креативнее 👍

Что дальше?

А дальше — повторяем цикл:

1. Выбрали следующий токен (генерация)
2. Добавили его в конец промта
3. Снова прогнали всё через все блоки (преобразования)
4. Получили новый последний вектор
5. Возвращаемся к п.1
....
И так до конца ответа.

То есть, для каждого нового токена ответа модель проделывает колоссальный объём вычислений:

1. Перебирает все токены словаря (генерация — сравнение с последним)

2. Прогоняет новый токен через все 80-120 блоков — это нужно, чтобы подготовить его вектор для следующей итерации. В каждом блоке attention сравнивает его со всеми предыдущими токенами — а их с каждым шагом всё больше.

И чем длиннее ответ — тем дороже становится генерация следующего токена. Именно поэтому большие LLM такие дорогие в инференсе.

————

Что ж, вот и весь трансформер. Оказывается, не так уж и сложно 👍

В следующем посте детально разберём сам механизм attention. Та самая операция, ради которой эта серия и пишется.

#llm_internals


📆Где я узнаю актуальные новости про AI

Новые модели и ИИ-инструменты выходят так часто, что стоит пару дней не следить за новостями, и всё — ты безнадёжно отстал.

Без преувеличения скажу, что AI for Devs — мой любимый новостной канал этой тематики. Я подписан на многие подобные каналы, но только здесь я до сих пор не отключил уведомления.

Читаю его довольно давно, канал авторский, все посты строго по делу, отличная подача (инженерный минимализм, ничего лишнего), и всегда свежие актуальные новости.

@ai_for_devs

🫶 Не реклама, честная рекомендация


🥂Новый сайт подкаста GoGetPodcast

Наконец-то я его доделал 😩

Я давно вынашивал множество интересных идей для сайта, но времени катастрофически не хватало. Сейчас же в компании ИИ-агентов, да ещё после увольнения, я в кои-то веки смахнул пыль со своего длиннющего бэклога, и началось...

Итак, что там нового и интересного:

1. Он наконец-то выглядит прилично!

Раньше это была просто топорная тема для блога на VuePress. Выглядело очень грустно, но изначально меня хватило только на "работает и ладно..". Нужен был хоть какой-то кривой-косой лэндинг для проекта.

Теперь же это полноценная платформа, заточенная именно под подкаст.

Ну и в целом, там очень много мелочей, над которыми я долго работал. Например:

- Встроенный плеер со всем необходимым функционалом, включая переход между главами
- Несколько тем внешнего вида (не только светлая и тёмная, чтобы угодить всем эстетам)
- Детально проработанные превьюшки для соц. сетей при шаринге ссылок

И многое другое. Всё это я описываю на странице обновлений (но я начал её вести только позавчера)

2. Полный список всех ресурсов, которые обсуждались в выпуске

Это ОЧЕНЬ не хватало.

Порой у нас в разговоре проскакивали буквально десятки разных сервисов, книг, проектов и других ресурсов. И слушатели постоянно просили собрать их в одном месте. Но в описание под роликом такое не впихнёшь, писать каждый раз отдельный пост в Telegram не хочется, да и просто читать глазами огромный текстовый список мало кому интересно.

Теперь у каждого выпуска есть удобная страница ресурсов — с фильтрами, поиском, сортировкой, пояснениями о том, кто и в каком месте что упомянул. К каждому ресурсу прилагается комментарий и ссылка на главу, в которой он обсуждался.

3. Разбор сложных понятий из выпуска

Это то, чего мне самому очень не хватает в других подкастах.

Список карточек с самыми интересными и сложными понятиями из выпуска, с разбором, пояснениями и комментариями. Эдакий конспект, который хочется перечитать, не переслушивая весь выпуск заново.

4. Статистика и аналитика 🦄

Честно — это больше баловство, но мне нравится ✨

Можно посмотреть, кто из спикеров больше всех говорил, насколько больше, посмотреть разные графики, метрики.. Полезного в этом мало, зато прикольно.

Для всего вышеперечисленного построен удобный пайплайн, благодаря которому я могу делать всю обвязку для новых выпусков в день их выхода.

Я планирую развивать его и дальше. Например, объединить ресурсы в большую библиотеку, а понятия в общую "энциклопедию" подкаста (хз как ещё это назвать 🗿), и добавлять новые фичи.

————

Списки ресурсов и понятий я формирую полуавтоматически: первые этапы выполняет LLM, а дальше я допиливаю всё руками, чтобы результат был интересным и полезным.

🟠Времени это занимает прилично, поэтому пока они доступны только для нескольких последних выпусков. Постепенно буду заполнять и остальные.

На сайте наверняка ещё есть баги и просто кривые места, особенно в мобильной версии, но я буду постепенно всё это допиливать.

#gogetpodcast


🥂Большой выпуск про PaaS — как Avito и Plata строят платформу для разработки / GoGetPodcast

- Видео
- Ссылки на аудио-площадки

Когда-то давно я часто ходил на IT конференции, и один из немногих запомнившихся мне докладов был про PaaS Авито. Очень впечатлило, как у них там по нажатию одной кнопочки происходят сложные автоматизации процессов.

К сожалению, поработать у них и пощупать это руками мне так и не довелось, поэтому я решил пообщаться с лидом команды DevSupport их платформы — Владом. А чтобы было ещё интересней, мы с моим бывших коллегой Ильдаром сравнили всё это с начинаниями в Plata, которая тоже активно строит свою платформу.

Участники:

- Владислав Сикач, тимлид команды DevSupport в Авито
- Ильдар Карымов  , инженер команды Developer Experience в Plata

🟢Все ссылки, упомянутые в выпуске, и разборы сложных понятий есть на сайте подкаста

#gogetpodcast


🏔Большая Алматинская Кругосветка — собираем группу

Я планирую ещё раз сходить в поход по горам Алматы, по тому же маршруту (подробнее здесь). В этот раз пойдём группой из одних только гоферов 🔨 (не считая гида). Группа практически собрана, осталось 2-3 свободных места.

🟢Если хотите присоединиться, оставьте заявку здесь

Когда: ориентировочно начало или середина августа. Точные даты согласуем вместе, когда группа полностью соберётся.

Да, маршрут довольно сложный. Без подготовки будет тяжеловато, но если ты в хорошей физической форме, то пройти его вполне реально. Специально готовиться не обязательно, но лишним точно не будет — меньше придётся страдать по пути 😩

В любом случае, с нами будет крутой опытный гид, который отлично знает этот маршрут. Во все свои горные походы я ходил только с ним.

Экипировку придётся покупать / искать самостоятельно, но мы с этим поможем — будет общий чат, плюс перед выходом вместе сходим в туристический магазин в Алматы и купим все необходимое. Из дорогого — палатка, хороший рюкзак и спальный мешок. Что-то из этого можно будет взять в аренду у гида, будем смотреть по ситуации.

Особенно будем рады местным алматинцам, которые тоже хорошо знают этот маршрут ❤️

Если есть вопросы, пишите в комментариях, отвечу.

————

БАК — это мой самый сложный, но самый любимый маршрут из всех, которые я прошёл. Дошёл с трудом, т.к. почти не готовился. Но это первый маршрут, который я очень хочу повторить.

Лучший способ отдохнуть от новостей, от работы и от ИИ, вдали от цивилизации. Связи там практически нигде не будет, так что информационный детокс получится добровольно-принудительный ✨


По мотивам 'https://t.me/ntuzov/898?comment=23329' rel='nofollow'>комментариев


🖥 Виртуальная vs Физическая память

Продолжаем говорить про память. В прошлых постах мы спроектировали Stack и Heap. Но то была картина изнутри программы. Теперь поднимемся на уровень выше и посмотрим, как всё это выглядит со стороны ОС.

————

Снова надеваем каску инженера. Наша команда проектирует операционную систему, и нам поручили разобраться с менеджментом памяти — нашей ОС доступен определённый её объём, и его нужно каким-то образом распределять между процессами.

Попытка 1: Нарезаем RAM — прямой доступ

Самое простое решение — поделить физическую RAM на кусочки: программе A отдадим адреса 0x0000–0x1000, программе B — 0x1000–0x2000, и так далее.

На первый взгляд, всё работает, но... Сразу же вылезает огромный букет проблем.

1. Безопасность: Что мешает Программе А обратиться к адресу программы Б и прочитать пароли из её памяти? Ничего. А если она туда что-то запишет, то Программа Б просто сломается.

2. Изоляция и адресация: Компилятору нужно заранее знать, по каким адресам будут лежать переменные, чтобы скомпилировать код. Но мы не можем заранее знать, какие физические адреса будут свободны в момент запуска программы 🗿

🟢Очевидно, что напрямую пускать процессы к железу нельзя. Думаем дальше.

Попытка 2: Иллюзия одиночества — базовый адрес и граница

Что ж, забираем у программы прямой доступ к адресам. Мы всё ещё будем присваивать ей какую-то область, но адресуем сами. То есть, каждая программа будет думать, что ей доступна вся доступная память: от 0x0000 до capacity. К примеру, [0x0000, 0x1000]. Мы же просто добавляем соответствующее смещение и следим, чтобы программа не вылезала за свои пределы.

Допустим мы выдали программе диапазон [0x3000, 0x4000]. Сама она при этом работает с адресами [0x0000, 0x1000]. Когда программа обращается к ячейке 0x0050, мы просто добавляем к ней смещение +0x3000 и получаем адрес: 0x3050. А если она просит больше, чем ей доступно, выдаём ошибку.

Это уже лучше! Но вылезает ещё более коварная проблема — фрагментация.

Представьте, что у вас 1гб памяти, и вы запустили 500 мелких программ, которым нужно ~2мб. В итоге, ваш гигабайт будет нарезан на 500 мелких кусочков.

Далее мы закрываем половину этих программ, чтобы освободить место для одной тяжёлой программы. И вот проблема: мы освободили 250 кусочков по 2мб, но они разбросаны рандомно по всему пространству! И у нас нет ни одного свободного промежутка хотя бы в 100мб:

[== Физическая память 1 ГБ ==]

1. Память забита (по 2 МБ):
|█|█|█|█|█|█|█|█|█|█|█|█|█|█|█|

2. Закрыли половину (ДЫРЫ):
|█| |█| | |█|█| |█| |█| | |█|█|
^ ^ ^ ^ ^ ^ ^
2мб 2мб 4мб 2мб 2мб 4мб 2мб

(Суммарно места много, но оно
разбито на мелкие куски)

3. Нужен цельный кусок 100 МБ:
Требуется: |██████████|
Результат: ОШИБКА! Не влезает...

Попытка 3: Страничная организация (Paging)

Очевидно, нам нужно уметь из мелких кусочков собирать большие. Давайте будем нарезать память на одинаковые мелкие кусочки — страницы (обычно по 4 КБ), а затем маппить запрошенные программой адреса с реальными через специальную таблицу (Page Table).

То есть, ОС будет вести полный учёт — кому какая страница принадлежит и правильно сопоставлять адреса с помощью таблицы

Программа же не догадывается об этой машинерии — она всё так же работает в своём виртуальном диапазоне, [0x0000,0x2000]. Например:

1. Программа пишет по адресу 0x1050

2. ОС смотрит в таблицу и сопоставляет: виртуальный адрес 0x1050 с физическим 0x8A3050

Что это нам даёт?

Безопасность: у каждой программы своя таблица страниц — свой изолированный мир. До чужой памяти физически не дотянуться, а попытка вылезти за пределы своего пространства — ошибка. Привет, Segmentation fault! 👍

Дефрагментация: виртуальные страницы программы могут идти строго по порядку, одна за другой. А вот в физической памяти ОС может раскидать их как угодно по любым свободным промежуткам.

Готово?! Да, концептуально оно работает, но есть нюанс.. 👀

На практике мы замечаем, что наша ОС жутко тормозит — топорный программный поиск по таблице, это слишком тяжёлая операция. В следующем посте будем это оптимизирвать.

#guide #memory

11.3k 1 197 16 169

Насколько вы хорошо знакомы с понятием "виртуальная память"
Опрос
  •   Слышу впервые 🌚
  •   Что-то слышал, но понимаю смутно 🗿
  •   В общих чертах — что у каждого процесса свое адресное пространство, и ОС это как-то разруливает 🦄
  •   Знаю про page tables, RSS vs VSZ и page faults 🧙
  •   Сам это объясняю джунам / спрашиваю на собесах 👴
2293 голосов

Показано 20 последних публикаций.