


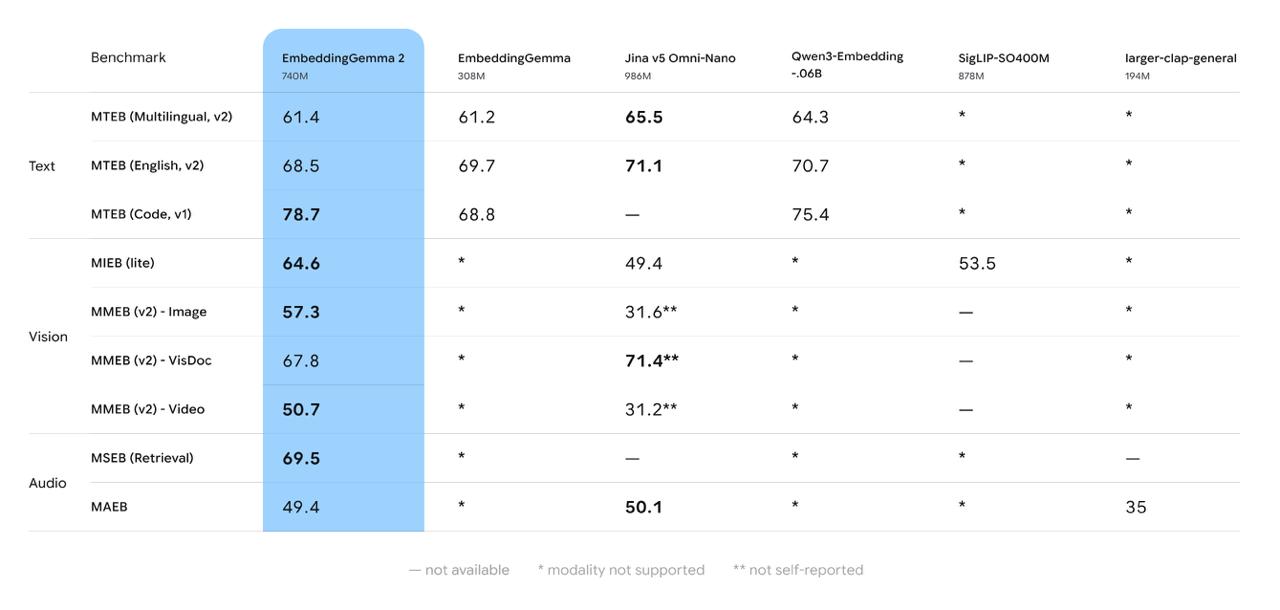
Google выпустила мультимодальную EmbeddingGemma 2
Если первая версия работала только с текстом, то теперь модель умеет превращать в единое векторное пространство текст, код, изображения, видео и аудио. На вход можно подавать и смешанные данные.
Всего в модели 740M параметров, но архитектура модульная: текстовая часть занимает 270M, а энкодеры изображений и аудио подключаются только при необходимости. Контекст вырос до 8K токенов - это примерно 5,5 минут аудио или до 29 изображений за один запрос.
На текстовых задачах качество осталось примерно на уровне первой версии, зато работа с кодом заметно улучшилась. По данным Google, среди мультимодальных embedding-моделей до 1B параметров EmbeddingGemma 2 показывает лучший результат.
Веса на Hugging Face · Блог Google
✅ подписаться