


🧠 Negative Self-Distillation: Learning to Reason by Avoiding Flaws
📄 Статья
Обыкновенно при обучении / алайнменте LLM мы либо явно учим модель на хороших ответах, либо запускаем её в какую-то среду, где она учится находить решение, максимизирующее некоторую награду.
Однако в результате часто оказывается, что модель становится чрезмерно уверенной в себе после такой процедуры обучения.
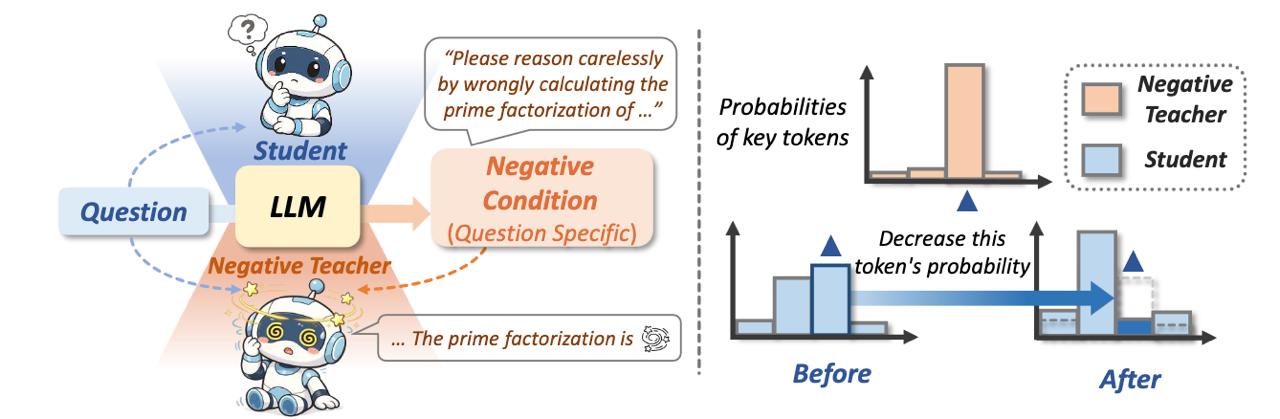
Авторы данной статьи предлагают не подражать правильному ответу, а не подражать неправильному. Это и улучшает модель, уводя от неверных решений, и помогает меньше коллапсировать.