


🧩 Disaggregated Quantization: Specializing LLM Prefill and Decode
📄 Статья
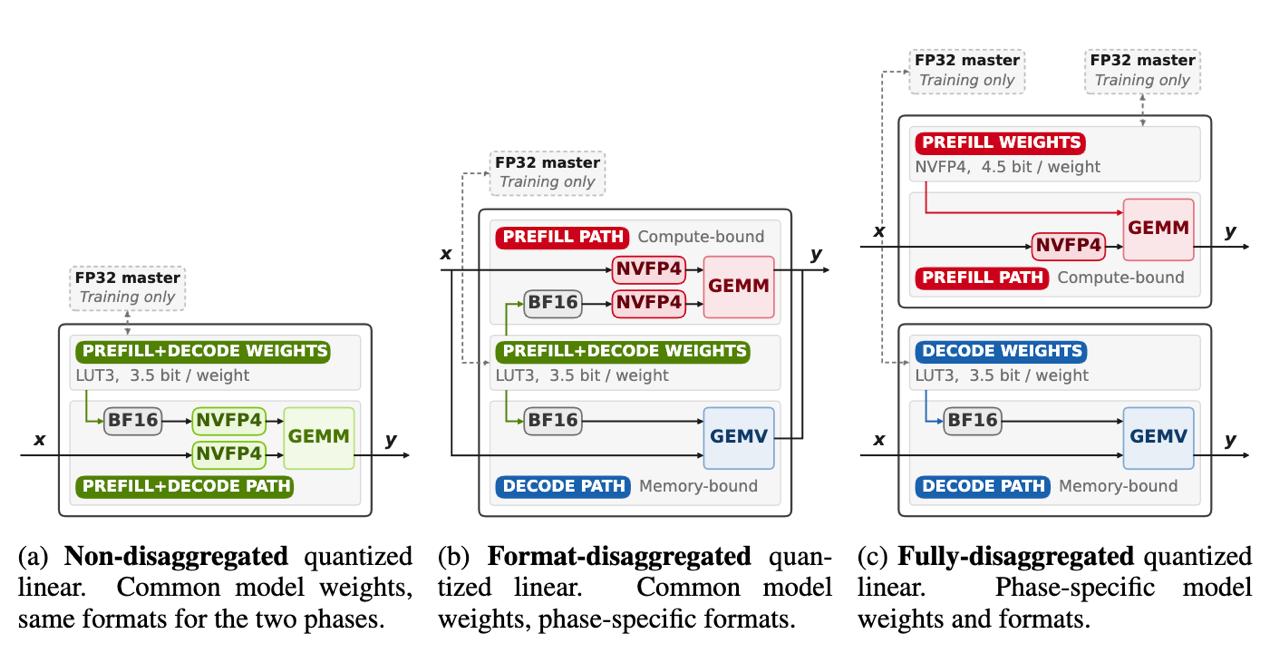
Обычно для префилла и декода используется одна и та же модель, более того — одни и те же веса.
Однако с вычислительной точки зрения эти операции сильно различаются:
- 🧮 На префилле много вычислений, поэтому обычно упираемся в скорость матричных операций.
- 💾 На декоде же упираемся в скорость памяти.
Поэтому кажется логичным оптимизировать каждый из этапов по-своему.
И потому команда из IST и NVIDIA с первым авторством @black_samorez предлагает подход, оптимизирующий качество и скорость за счёт разного сжатия на этих двух стадиях.