


PII-детекция в guardrails: почему NER + regex иногда недостаточно ❌
Когда мы смотрели на чужие решения детекции чувствительных данных, встречали одну и ту же связку: NER-модели ловят семантику, а регулярные выражения выстраивают структуру и формат.
Однако этого базового решения недостаточно для шумных текстов с цифрами, сокращениями и опечатками.
Например, строка из 16 цифр может быть как номером карты, так и суммой ваших накоплений в банке, а 10 цифр — это ИНН или паспорт? Без дополнительной валидации точность ответов проседает.
Мы пошли дальше ↗️
И добавили детерминированные проверки контрольных цифр — этот же принцип используется в платёжных формах и анкетах.
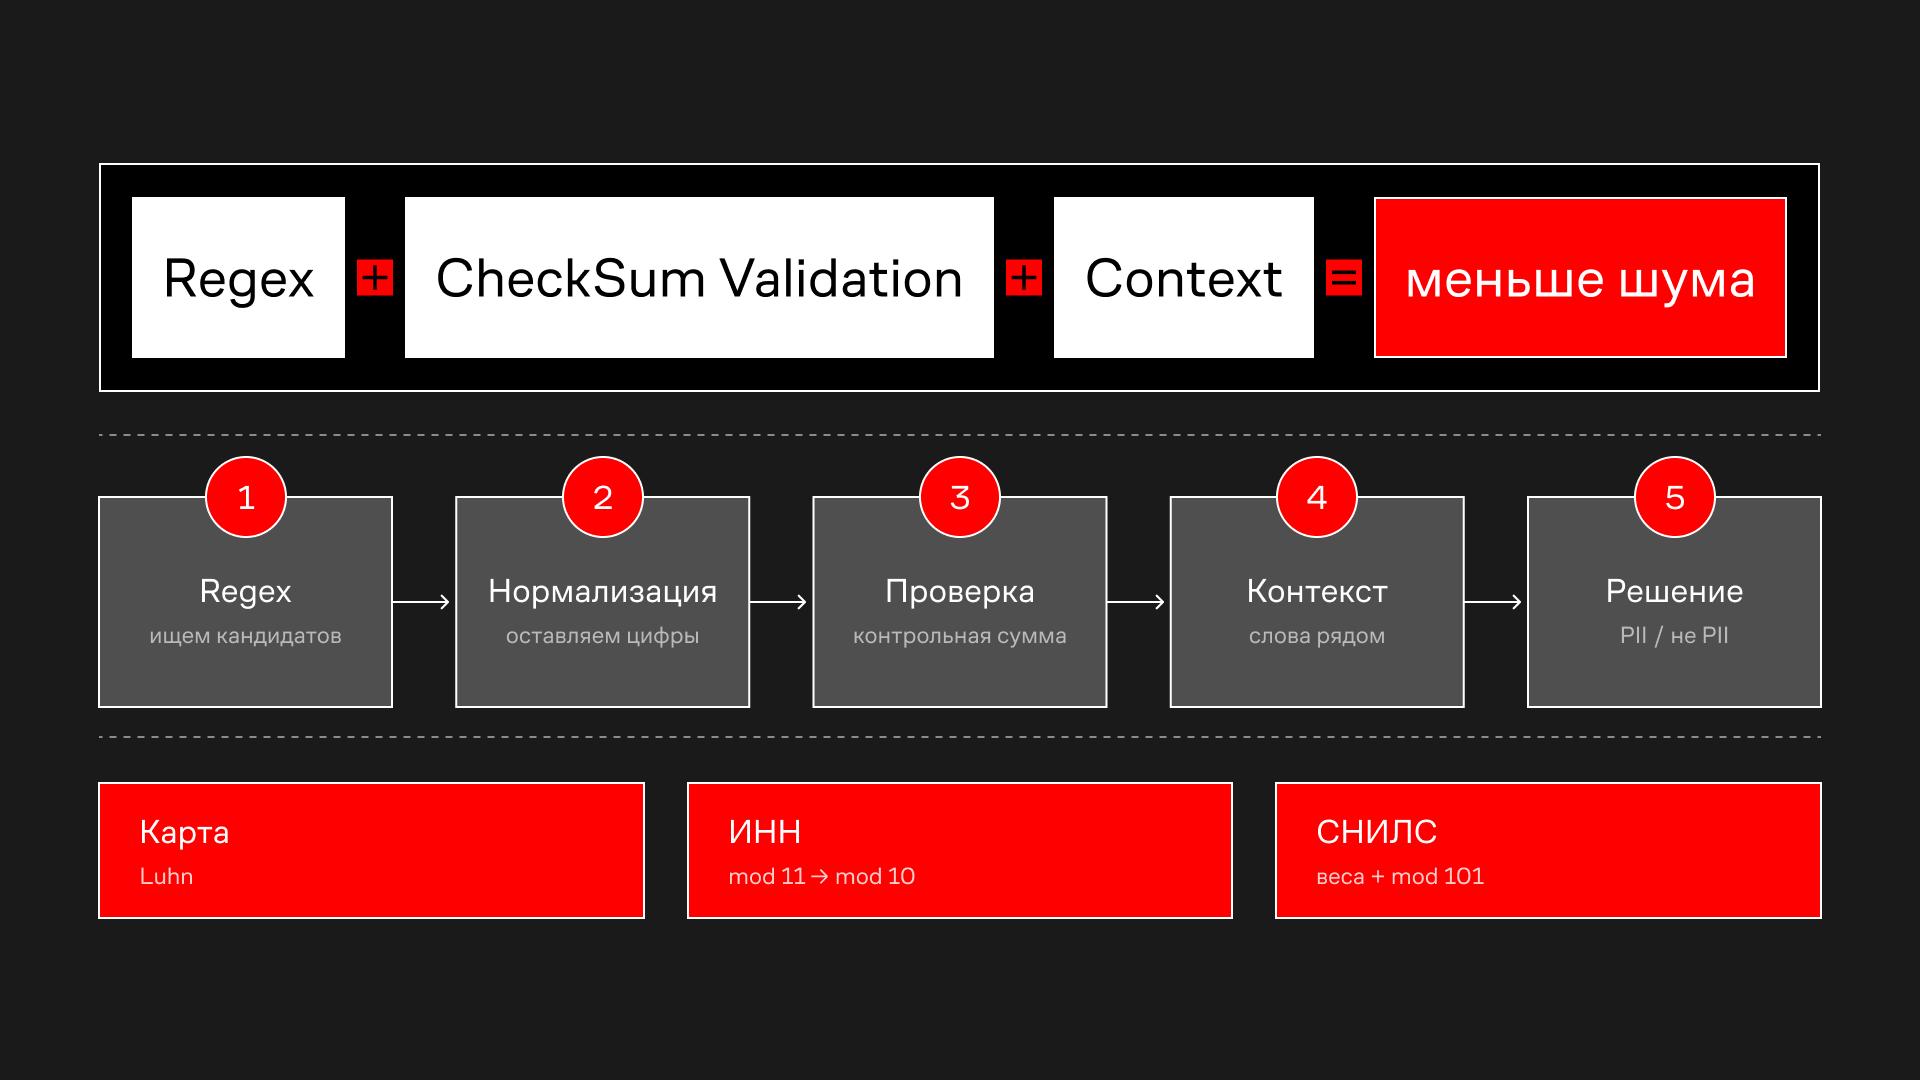
Пайплайн получился такой:
• извлекаем кандидатов через regex — учитываем пробелы, дефисы и другие дополнительные символы,
• нормализуем строку до цифр,
• проверяем валидность по алгоритму для конкретного типа сущности,
• анализируем контекст вокруг совпадения.
Какие проверки добавили?
🟥 Карты — алгоритм Луна (Luhn) отсекает большую часть случайных последовательностей.
🟥 ИНН — контрольные цифры через mod 11 с весами, затем mod 10.
🟥 СНИЛС — взвешенная сумма первых 9 цифр и mod 101, но если результат >100, контроль = 00.
Так стало меньше false positives на числовых последовательностях, внешне похожих на PII. И появилось объяснение — какую именно проверку прошло найденное значение.
Отдельно настроили контекст ✅
Даже валидная последовательность после проверки Luhn не всегда однозначна — один и тот же формат может встречаться у разных типов идентификаторов.
Поэтому мы добавили контекстные признаки и keyword-правила вокруг кандидата. Так получилось классифицировать сущности не только по длине и контрольной сумме, но и по окружению в тексте.
Если сталкивались с ложными срабатываниями на числовых идентификаторах — расскажите, как решали?
#Безопасность
Когда мы смотрели на чужие решения детекции чувствительных данных, встречали одну и ту же связку: NER-модели ловят семантику, а регулярные выражения выстраивают структуру и формат.
Однако этого базового решения недостаточно для шумных текстов с цифрами, сокращениями и опечатками.
Например, строка из 16 цифр может быть как номером карты, так и суммой ваших накоплений в банке, а 10 цифр — это ИНН или паспорт? Без дополнительной валидации точность ответов проседает.
Мы пошли дальше ↗️
И добавили детерминированные проверки контрольных цифр — этот же принцип используется в платёжных формах и анкетах.
Пайплайн получился такой:
• извлекаем кандидатов через regex — учитываем пробелы, дефисы и другие дополнительные символы,
• нормализуем строку до цифр,
• проверяем валидность по алгоритму для конкретного типа сущности,
• анализируем контекст вокруг совпадения.
Какие проверки добавили?
🟥 Карты — алгоритм Луна (Luhn) отсекает большую часть случайных последовательностей.
🟥 ИНН — контрольные цифры через mod 11 с весами, затем mod 10.
🟥 СНИЛС — взвешенная сумма первых 9 цифр и mod 101, но если результат >100, контроль = 00.
Так стало меньше false positives на числовых последовательностях, внешне похожих на PII. И появилось объяснение — какую именно проверку прошло найденное значение.
Отдельно настроили контекст ✅
Даже валидная последовательность после проверки Luhn не всегда однозначна — один и тот же формат может встречаться у разных типов идентификаторов.
Поэтому мы добавили контекстные признаки и keyword-правила вокруг кандидата. Так получилось классифицировать сущности не только по длине и контрольной сумме, но и по окружению в тексте.
Если сталкивались с ложными срабатываниями на числовых идентификаторах — расскажите, как решали?
Автор этого поста, как и недавней статьи про генетический алгоритм, Женя Андриевская — NLP-инженер в R&D red_mad_robot
#Безопасность