


OpenAI внедрит невидимый водяной знак во все тексты ChatGPT
Именно в такой формулировке тревожные телеграм-каналы побежали распространять эту новость. Мол все, приплыли, теперь все будет в метках и AI тексты смогут детектировать.
На самом деле новость про другое. С 5 октбяря и только в ЕС начинают раскатывать маркировку textGrain. Это не какие-то скрытые символы, или другая шифровка очищаемая копипастом через блокнот. Это статистический рисунок наиболее вероятного применения порядка слов.
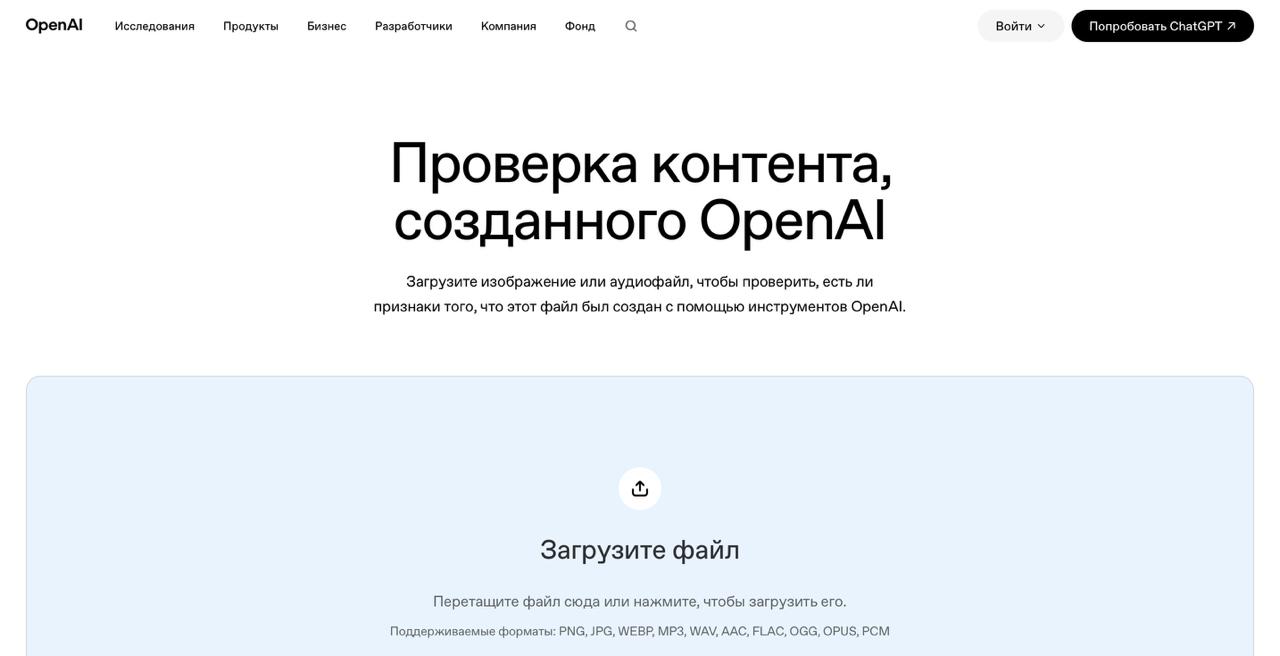
Детектор, зная ключ, проверяет тексты по этому рисунку и все. И он уже существует у Open AI https://openai.com/ru-RU/research/verify/ - тексты в нем появятся позже, а пока только видосики и фоточки.
В других регионах нет требования EU AI Act и поэтому данная маркировка не включается по умолчанию как глобальный стандарт.
Обойти можно либо глубокой переработкой и переписыванием текста, либо генерацией кусков до 200 токенов, это до 1000 символов с пробелами. По заверениям самой Open AI такие тексты не маркируются и на них сигнал не навешивается. Еще на мой взгляд нейронка перестанет обучаться на подобных материалах и будет для себе сегментировать именно авторский контент.
А вообще штука правильная и нужная. Глобально у нас у всех творческая импотенция развивается и мы перестаем искать инфу/думать своей головой/создавать что-то творческое и индивидуальное.
@seonica
Именно в такой формулировке тревожные телеграм-каналы побежали распространять эту новость. Мол все, приплыли, теперь все будет в метках и AI тексты смогут детектировать.
На самом деле новость про другое. С 5 октбяря и только в ЕС начинают раскатывать маркировку textGrain. Это не какие-то скрытые символы, или другая шифровка очищаемая копипастом через блокнот. Это статистический рисунок наиболее вероятного применения порядка слов.
«Исследование показывает / демонстрирует / свидетельствует / указывает…»
Детектор, зная ключ, проверяет тексты по этому рисунку и все. И он уже существует у Open AI https://openai.com/ru-RU/research/verify/ - тексты в нем появятся позже, а пока только видосики и фоточки.
В других регионах нет требования EU AI Act и поэтому данная маркировка не включается по умолчанию как глобальный стандарт.
Обойти можно либо глубокой переработкой и переписыванием текста, либо генерацией кусков до 200 токенов, это до 1000 символов с пробелами. По заверениям самой Open AI такие тексты не маркируются и на них сигнал не навешивается. Еще на мой взгляд нейронка перестанет обучаться на подобных материалах и будет для себе сегментировать именно авторский контент.
А вообще штука правильная и нужная. Глобально у нас у всех творческая импотенция развивается и мы перестаем искать инфу/думать своей головой/создавать что-то творческое и индивидуальное.
@seonica