SQL Ready | Базы Данных


Гео и язык канала: Россия, Русский
Категория: Технологии


Авторский канал про Базы Данных и SQL
Ресурсы, гайды, задачи, шпаргалки.
Информация ежедневно пополняется!
Cотрудничество: @energy_c
РКН: https://clck.ru/3QREBc

Зарегистрирован в РКН
Связанные каналы

Гео и язык канала
Россия, Русский
Категория
Технологии
Статистика
Фильтр публикаций


❤️ sqlite-postgres-cours — большой практический курс по базам данных!

Материал ведёт от первых SQL-запросов и проектирования схем до индексов, транзакций, оптимизации и работы с БД из Python через SQLAlchemy и Alembic. Особенно полезно, что SQLite и PostgreSQL изучаются параллельно: автор показывает различия между ними, типичные ошибки и ситуации, где выбор СУБД имеет значение.

Оставляю ссылочку: GitHub 📱


➡️ SQL Ready | #репозиторий


Почему UNIQUE допускает несколько NULL в PostgreSQL!

Ограничение UNIQUE гарантирует уникальность значений, но для NULL в PostgreSQL действует отдельная семантика. По умолчанию два NULL считаются различными при проверке уникальности, поэтому ограничение не запрещает несколько строк с неопределённым значением:
CREATE TABLE users (
id BIGINT PRIMARY KEY,
email TEXT UNIQUE
);

Повторное определённое значение email нарушит ограничение уникальности.
INSERT INTO users (id, email)
VALUES (1, 'user@example.com');

INSERT INTO users (id, email)
VALUES (2, 'user@example.com');

При использовании NULL те же правила не применяются: несколько строк успешно проходят проверку ограничения.
INSERT INTO users (id, email)
VALUES
(3, NULL),
(4, NULL),
(5, NULL);

Особенно важно учитывать это поведение в составных ключах, где один из столбцов может быть неопределённым:
CREATE TABLE contacts (
id BIGINT PRIMARY KEY,
company_id BIGINT NOT NULL,
external_id TEXT,
UNIQUE (company_id, external_id)
);

Одинаковые определённые значения (company_id, external_id) конфликтуют, но несколько комбинаций (10, NULL) по умолчанию допустимы:
INSERT INTO contacts (id, company_id, external_id)
VALUES
(1, 10, NULL),
(2, 10, NULL);

Начиная с PostgreSQL 15 это поведение можно изменить через NULLS NOT DISTINCT. В таком ограничении NULL считаются неразличимыми при проверке уникальности:
CREATE TABLE contacts_strict (
id BIGINT PRIMARY KEY,
company_id BIGINT NOT NULL,
external_id TEXT,
UNIQUE NULLS NOT DISTINCT (company_id, external_id)
);

Теперь сохранить две строки с одной комбинацией (10, NULL) нельзя: вторая вставка завершится нарушением уникальности.
INSERT INTO contacts_strict (id, company_id, external_id)
VALUES (1, 10, NULL);

INSERT INTO contacts_strict (id, company_id, external_id)
VALUES (2, 10, NULL);

Та же семантика поддерживается уникальными индексами, поэтому правило можно выразить непосредственно на уровне индекса.
CREATE UNIQUE INDEX uq_contacts_company_external
ON contacts (company_id, external_id)
NULLS NOT DISTINCT;

NULLS NOT DISTINCT не эквивалентен NOT NULL. NOT NULL полностью запрещает отсутствие значения, тогда как NULLS NOT DISTINCT разрешает NULL, но включает его в контроль уникальности.
CREATE TABLE identifiers (
id BIGINT PRIMARY KEY,
external_id TEXT,
UNIQUE NULLS NOT DISTINCT (external_id)
);

В такой таблице может существовать одна строка с external_id IS NULL, но вторая аналогичная строка уже нарушит ограничение.

🔥 UNIQUE в PostgreSQL по умолчанию допускает несколько NULL. Если отсутствие значения также должно быть уникальным состоянием, начиная с PostgreSQL 15 это можно явно зафиксировать через NULLS NOT DISTINCT.

➡️ SQL Ready | #практика


📂 Шпаргалка по паттернам распределённых систем!

Например, Replication повышает доступность и отказоустойчивость за счёт хранения копий данных на нескольких узлах, а Sharding позволяет горизонтально масштабировать систему, распределяя данные между независимыми шардами.

Эти паттерны помогают решать основные задачи распределённых систем: масштабирование, отказоустойчивость, распределение данных, асинхронное взаимодействие и согласованность.

Сохрани, чтобы не потерять!

➡️ SQL Ready | #ресурс


Проверяйте связи с учётом периода!

В PostgreSQL 18 связь может учитывать ещё и период его действия.

WITHOUT OVERLAPS не даст создать пересекающиеся периоды для одного product_id. По сути PostgreSQL сам обеспечивает проверку пересечения диапазонов.

А теперь интересная часть:
CREATE TABLE discounts (
product_id bigint,
valid_at daterange,

FOREIGN KEY (
product_id,
PERIOD valid_at
)
REFERENCES prices (
product_id,
PERIOD valid_at
)
);

Период скидки должен быть покрыт соответствующими периодами родительской таблицы. Причём покрытие может обеспечиваться несколькими соседними строками, а не обязательно одной.

Например, такую логику больше не обязательно проверять вручную перед записью:
INSERT INTO discounts
VALUES (
42,
'[2026-05-01,2026-05-15)'::daterange
);

🔥 В PostgreSQL 18 PERIOD позволяет проверять временные связи обычным FOREIGN KEY — без триггеров и ручных проверок.

➡️ SQL Ready | #совет


👍 Устройство PostgreSQL — подробная документация на русском языке!

Материалы посвящены не написанию SQL-запросов, а архитектуре СУБД и внутренним механизмам обработки и хранения данных. Подробно рассматриваются физическая структура базы данных, системные каталоги, управление транзакциями, блокировки, WAL и др.

📌 Оставляю ссылочку: database.diasoft.ru

➡️ SQL Ready | #ресурс


COUNT(*) в PostgreSQL: MVCC, visibility map и стоимость выполнения!

В PostgreSQL точный COUNT(*) требует определить количество строк, видимых текущему MVCC snapshot. Глобального счётчика, который можно было бы использовать для транзакционно корректного результата, у таблицы нет:
SELECT COUNT(*)
FROM orders;

На большой таблице планировщик часто выбирает Seq Scan, поскольку для точного результата всё равно требуется обработать множество видимых строк:
Aggregate
-> Seq Scan on orders

Наличие PRIMARY KEY или другого подходящего индекса не гарантирует его использование. Если модель стоимости считает путь через индекс дешевле, PostgreSQL может выполнить запрос через Index Only Scan:
Aggregate
-> Index Only Scan using orders_pkey on orders

Однако Index Only Scan не означает получение готового количества записей из индекса. Информация, необходимая для определения MVCC-видимости строк, находится в heap, а не в самом индексе.

PostgreSQL оптимизирует эту проверку с помощью visibility map. Если страница отмечена как all-visible, PostgreSQL может считать находящиеся на ней строки видимыми без дополнительного обращения к heap:
EXPLAIN (ANALYZE, BUFFERS)
SELECT COUNT(*)
FROM orders;

После изменения страницы её флаг all-visible сбрасывается и впоследствии может быть снова установлен VACUUM.

Поэтому на активно изменяемых таблицах даже Index Only Scan может требовать дополнительных обращений к heap:
Index Only Scan using orders_pkey on orders
Heap Fetches: 18427

Таким образом, производительность COUNT(*) зависит не только от размера таблицы и наличия индекса, но и от состояния visibility map, характера нагрузки, работы autovacuum, выбранного плана выполнения и состояния кэша PostgreSQL.

Если транзакционно точное количество строк не требуется, можно использовать статистическую оценку из pg_class:
SELECT reltuples::bigint
FROM pg_class
WHERE oid = 'orders'::regclass;

reltuples обновляется, в частности, при VACUUM и ANALYZE и остаётся приблизительной оценкой. Если статистика для таблицы ещё не собиралась, значение может быть -1.

🔥 Для больших таблиц это принципиально разные варианты: полный MVCC-корректный подсчёт или быстрое получение приблизительной статистической оценки.

➡️ SQL Ready | #практика


Проверяйте JSON без преобразования!

Если JSON приходит как text, необязательно делать ::jsonb и ловить ошибку преобразования. IS JSON просто вернёт true или false.
SELECT '{"id": 42}' IS JSON; -- true
SELECT '{broken}' IS JSON; -- false

Можно сразу потребовать конкретный тип JSON:
SELECT payload IS JSON OBJECT
FROM staging;

SELECT payload IS JSON ARRAY
FROM staging;

Есть и более интересная проверка — запрет повторяющихся ключей:
SELECT '{"id":1,"id":2}'
IS JSON OBJECT WITH UNIQUE KEYS;
-- false

Это можно использовать непосредственно в ограничении таблицы:
CREATE TABLE incoming_events (
payload text NOT NULL
CHECK (payload IS JSON OBJECT WITH UNIQUE KEYS)
);

🔥 IS JSON позволяет валидировать JSON как обычное условие SQL — без преобразований, исключений и регулярных выражений.

➡️ SQL Ready | #совет


Настройте оценку пользовательских функций!

Для пользовательской функции PostgreSQL позволяет явно указать стоимость вызова через COST, а для функции, возвращающей набор строк, — ожидаемое число строк через ROWS.

Причём пересоздавать функцию не обязательно:
ALTER FUNCTION find_orders(bigint)
ROWS 5;

ALTER FUNCTION expensive_check(jsonb)
COST 500;

Чем выше COST, тем дороже планировщик считает вычисление и тем сильнее старается не выполнять его лишний раз.

PostgreSQL прямо предоставляет COST и ROWS как информацию для оптимизации пользовательских функций.
EXPLAIN (ANALYZE, BUFFERS)
SELECT u.id, o.*
FROM users u
CROSS JOIN LATERAL find_orders(u.id) o;

🔥 Если пользовательская функция ломает оценки строк или вызывается слишком часто, проверьте COST и ROWS — иногда правильный план получается без переписывания запроса и новых индексов.

➡️ SQL Ready | #совет


😍 SQL-Tutorial — бесплатный учебник по SQL с практическими заданиями!

Онлайн-учебник для изучения SQL: от базовых запросов до более сложной работы с данными. Теория сопровождается примерами и упражнениями, поэтому изученные конструкции можно сразу закреплять на практике. Материал разделён на главы, что удобно для поэтапного обучения.

📌 Оставляю ссылочку: sql-tutorial.ru

➡️ SQL Ready | #ресурс

2k 0 76 1 29

🐱 PostgreSQL Course RU — курс по PostgreSQL и SQL для разработчиков!

В репозитории собраны материалы для изучения работы с базами данных: от основ SQL и проектирования таблиц до функций, индексов, транзакций, оконных функций, PL/pgSQL и продвинутых возможностей PostgreSQL. Отличный вариант, чтобы разобраться с базами данных и перейти от простых запросов к пониманию работы СУБД.

Оставляю ссылочку: GitHub 📱


➡️ SQL Ready | #репозиторий


📂 Шпаргалка по числовым функциям!

Например, ROUND() используется для округления значений, MOD() — для получения остатка от деления, а агрегатные функции AVG(), SUM(), MIN() и MAX() помогают выполнять вычисления по наборам данных.

На изображении собраны основные числовые функции: назначение, синтаксис, примеры запросов и особенности использования в разных СУБД.

Сохрани, чтобы не потерять!

➡️ SQL Ready | #ресурс


😎 Очень интересная статья на Хабре: «Как устроено шардирование PG в процессинге Яндекс Такси»!

В этой статье:
• Узнаете, зачем крупным системам переходить от одной базы к распределённому хранению данных;
• Разберётесь, как работает выбор шарда и какие архитектурные решения помогают масштабировать PostgreSQL;
• Посмотрите на инженерные подходы из высоконагруженного продакшена.

🔊 Продолжай читать на Habr!


➡️ SQL Ready | #статья


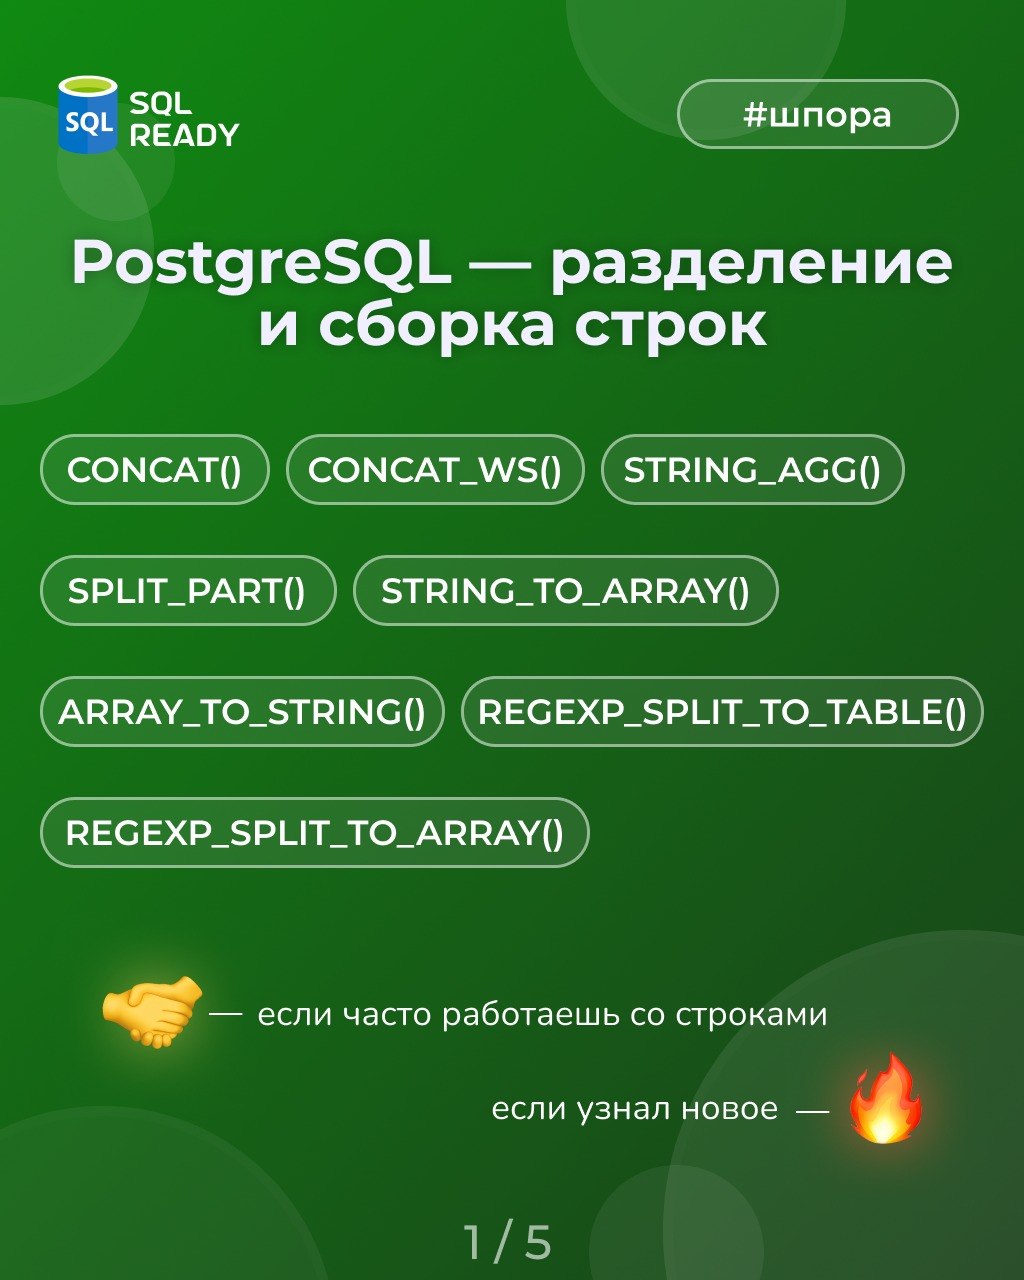
🖥 PostgreSQL — разделение и сборка строк!

Объединение значений с CONCAT и CONCAT_WS, агрегация строк с STRING_AGG, извлечение отдельных частей с SPLIT_PART, преобразование строк в массивы и обратно с STRING_TO_ARRAY и ARRAY_TO_STRING, а также разделение данных по регулярным выражениям с REGEXP_SPLIT_TO_ARRAY и REGEXP_SPLIT_TO_TABLE. Полезно для обработки списков, тегов, адресов и других текстовых данных.

➡️ SQL Ready | #шпора


Двойной NOT EXISTS: реляционное деление без подсчёта строк!

Задачи вида «найти сущности, удовлетворяющие всем условиям из некоторого набора» встречаются регулярно: все разрешения роли, все обязательные атрибуты товара, все зависимости конфигурации или все компетенции проекта. В реляционной алгебре такой класс задач связан с операцией деления.

Предположим, требования проекта и навыки сотрудников представлены отношениями:
project_requirements(project_id, skill_id)

employee_skills(employee_id, skill_id)

Требуется получить сотрудников, обладающих всеми навыками проекта 42. Один из распространённых вариантов — подсчитать совпадения:
SELECT e.id
FROM employees e
JOIN employee_skills s
ON s.employee_id = e.id
JOIN project_requirements r
ON r.project_id = 42
AND r.skill_id = s.skill_id
GROUP BY e.id
HAVING COUNT(DISTINCT r.skill_id) = (
SELECT COUNT(DISTINCT skill_id)
FROM project_requirements
WHERE project_id = 42
);

Запрос корректен, если skill_id не допускает NULL. DISTINCT необходим, если уникальность пар (project_id, skill_id) и (employee_id, skill_id) не гарантирована схемой.

Но условие «сотрудник имеет все требуемые навыки» можно выразить напрямую: не должно существовать требования, для которого у сотрудника нет соответствующего навыка:
SELECT e.id
FROM employees e
WHERE NOT EXISTS (
SELECT 1
FROM project_requirements r
WHERE r.project_id = 42
AND NOT EXISTS (
SELECT 1
FROM employee_skills s
WHERE s.employee_id = e.id
AND s.skill_id = r.skill_id
)
);

Внешний NOT EXISTS ищет отсутствие невыполненных требований, а внутренний проверяет отсутствие соответствующего навыка. Важное свойство — дубли не влияют на результат:
INSERT INTO employee_skills (employee_id, skill_id)
VALUES
(7, 10),
(7, 10),
(7, 20);

Если проект требует навыки 10 и 20, сотрудник 7 удовлетворяет требованиям независимо от числа повторений (7, 10). EXISTS проверяет наличие строки, а не их количество.

На практике такие дубли лучше запрещать ограничениями:
ALTER TABLE project_requirements
ADD CONSTRAINT uq_project_requirement
UNIQUE (project_id, skill_id);

ALTER TABLE employee_skills
ADD CONSTRAINT uq_employee_skill
UNIQUE (employee_id, skill_id);

Также skill_id в такой модели обычно следует объявлять NOT NULL. Иначе COUNT(DISTINCT skill_id) игнорирует NULL, а сравнение s.skill_id = r.skill_id с NULL не даст совпадения, что может привести к различию результатов двух подходов.

Если у проекта 42 вообще нет требований, двойной NOT EXISTS вернёт всех сотрудников: нет ни одного требования, которое сотрудник не выполняет. Если по правилам предметной области проект без требований не должен возвращать кандидатов, это нужно указать отдельно:
SELECT e.id
FROM employees e
WHERE EXISTS (
SELECT 1
FROM project_requirements r
WHERE r.project_id = 42
)
AND NOT EXISTS (
SELECT 1
FROM project_requirements r
WHERE r.project_id = 42
AND NOT EXISTS (
SELECT 1
FROM employee_skills s
WHERE s.employee_id = e.id
AND s.skill_id = r.skill_id
)
);

Двойной NOT EXISTS полезен тем, что выражает исходную задачу напрямую: вместо подсчёта совпадений мы проверяем отсутствие хотя бы одного невыполненного требования.

🔥 Для условий вида «выполнены все требования», «присутствуют все зависимости» или «есть соответствие каждому элементу набора» это одна из наиболее естественных форм реляционного деления в SQL.

➡️ SQL Ready | #практика


PostgreSQL Advisory Locks: синхронизация конкурентных операций!

Блокировок строк недостаточно, когда нужно синхронизировать не конкретную запись, а логическую операцию. Например, два воркера одновременно начинают генерацию одного и того же отчёта для пользователя. Даже если результат в итоге сохраняется с UNIQUE(user_id), это не предотвращает двойное выполнение дорогостоящей работы.

Для таких случаев PostgreSQL предоставляет advisory locks — блокировки, ключ и семантику которых определяет приложение:
SELECT pg_advisory_lock(1001);

Если другая сессия запросит lock с тем же ключом, она будет ждать его освобождения.

pg_advisory_lock() работает на уровне сессии: блокировка сохраняется до явного pg_advisory_unlock() или завершения сессии:
SELECT pg_advisory_unlock(1001);

Если критическая секция укладывается в транзакцию, обычно удобнее pg_advisory_xact_lock(): такая блокировка автоматически освобождается при COMMIT или ROLLBACK:
BEGIN;

SELECT pg_advisory_xact_lock(1, 1001);

-- Здесь выполняется операция, которую нужно сериализовать.

INSERT INTO reports(user_id, created_at)
SELECT 1001, now()
WHERE NOT EXISTS (
SELECT 1
FROM reports
WHERE user_id = 1001
);

COMMIT;

Важно то, что операция, которую нужно защитить от конкурентного выполнения, должна происходить после получения lock и до его освобождения.

Если дорогостоящая работа выполняется приложением вне транзакции и может занимать значительное время, держать ради неё долгую транзакцию обычно нежелательно. В таком случае можно использовать session-level advisory lock и гарантированно освобождать его после завершения критической секции.

Здесь 1 можно использовать как namespace операции, а 1001 — как идентификатор ресурса:
(1, 1001) — generate_report / user 1001
(2, 1001) — recalculate_stats / user 1001

Так независимые операции над одним ресурсом не будут случайно блокировать друг друга.

Если воркеру не нужно ждать освобождения lock, есть неблокирующий вариант:
SELECT pg_try_advisory_xact_lock(1, 1001);

Он сразу вернёт:
true — lock получен, выполняем работу
false — lock уже удерживается, работу можно пропустить

Это удобно для cron-задач и фоновых воркеров, где второй экземпляр работы не должен ждать завершения первого.

advisory lock не гарантирует уникальность данных. Он координирует только процессы, которые используют одинаковый протокол блокировок. Инварианты данных по-прежнему должны обеспечиваться самой БД:
ALTER TABLE reports
ADD CONSTRAINT reports_user_id_key UNIQUE (user_id);

PostgreSQL не знает, что означает (1, 1001). Для него это просто ключ блокировки. Поэтому все конкурирующие процессы должны одинаково формировать ключи и захватывать соответствующие locks.

🔥 Advisory locks полезны для генерации артефактов, фоновых задач, пересчётов, cron jobs и других операций, где критическая секция существует на уровне бизнес-логики, а не отдельной строки таблицы.

➡️ SQL Ready | #практика


👨‍💻 SQL PostgreSQL Patterns Library — большая коллекция готовых SQL-решений для PostgreSQL!

Здесь собраны практические запросы для работы со строками, JSON и массивами, поиска и оптимизации, массового обновления данных, индексов, миграций и администрирования БД. Есть решения для реальных задач: от UPSERT и поиска дубликатов до EXPLAIN, работы с миллионами записей, мониторинга запросов и обслуживания PostgreSQL.

Оставляю ссылочку: GitHub 📱


➡️ SQL Ready | #репозиторий


Почему 5 систем могут потребовать 10 интеграций, а 10 — уже 45?

Когда в data stack появляется несколько отдельных инструментов для хранения, обработки и аналитики, между ними приходится выстраивать обмен данными. Для пяти систем таких связок может быть до 10, а для десяти — уже до 45.

Yandex B2B Tech представила DataLens Platform на основе архитектуры lakehouse. Исходные и подготовленные данные хранятся в общей среде на S3 с использованием Apache Iceberg.

Из технических деталей — storage и compute масштабируются независимо. То есть рост объема данных не обязательно означает пропорциональное увеличение вычислительных ресурсов, и наоборот.

👉 Подробнее об архитектуре DataLens Platform — в материале СМИ.


Как атомарно резервировать лимит без SELECT FOR UPDATE!

При работе с квотами, остатками и лимитами важно не допустить, чтобы конкурентные запросы одновременно прошли проверку одного и того же доступного значения. Если проверка выполняется отдельно от изменения данных, между этими операциями появляется окно гонки:
SELECT used, quota
FROM accounts
WHERE id = 42;

Если два процесса одновременно получили used = 80 при quota = 100 и каждый собирается зарезервировать ещё 15, обе проверки в приложении могут успешно пройти.

Проверка ограничения должна выполняться непосредственно в операции изменения данных:
UPDATE accounts
SET used = used + 15
WHERE id = 42
AND used + 15


📂 Шпаргалка по SQL для разработчиков!

Например, SELECT используется для получения данных из таблиц, а CREATE, ALTER и DROP помогают управлять структурой базы данных. JOIN позволяет объединять данные из нескольких таблиц, а агрегатные функции (COUNT, SUM, AVG) — анализировать большие объёмы информации.

На картинке — шпаргалка с основными категориями команд, операторами, ключевыми словами, объектами базы данных, ограничениями, функциями агрегации, типами JOIN.

Сохрани, чтобы не потерять!

➡️ SQL Ready | #ресурс


Разворачивайте несколько массивов вместе!

Когда приложение передаёт несколько связанных массивов, не нужно отдельно делать unnest(), нумеровать элементы и потом соединять их по позиции.
SELECT *
FROM unnest(
ARRAY[101, 102, 103],
ARRAY['book', 'mouse', 'keyboard'],
ARRAY[2, 1, 4]
) AS x(id, name, qty);

PostgreSQL сопоставит элементы по позиции и сразу вернёт строки 101/book/2, 102/mouse/1, 103/keyboard/4.

Это удобно и для bulk-операций:
INSERT INTO order_items (product_id, quantity)
SELECT *
FROM unnest(
:product_ids::bigint[],
:quantities::integer[]
);

Можно обновлять пачку строк тем же способом:
UPDATE products p
SET price = x.price
FROM unnest(
:ids::bigint[],
:prices::numeric[]
) AS x(id, price)
WHERE p.id = x.id;

🔥 unnest(array1, array2, ...) объединяет связанные массивы в строки и позволяет массово добавлять или обновлять данные одним запросом.

➡️ SQL Ready | #совет

Показано 20 последних публикаций.