


#ai #qwen #qwen4exp #local
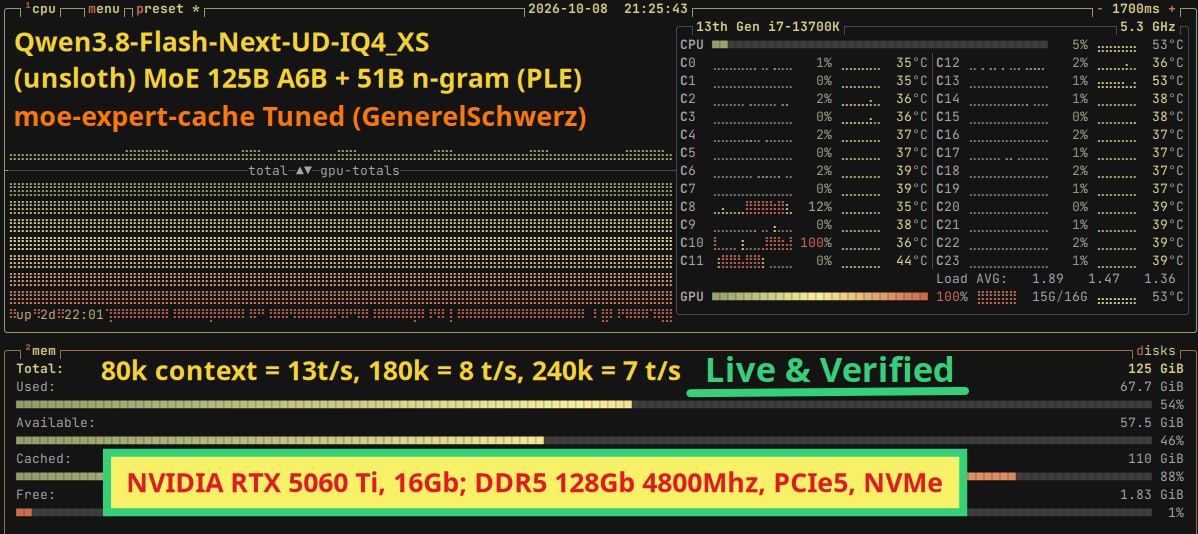
Это профиль локального инференса, который почти в двое быстрее обычного классического llama.cpp для этой модели
Qwen3.8-Flash-Next-UD-IQ4_XS (125B A6B (MoE)) + 51B N-Gram MoE (Thinking)
на скрине именно текущий профиль и окружение
...
Однако я нашёл и исследую сейчас вариант совершенно другой оптимизации, которая по предварительным тестам на этом же железе и с этой же моделью даёт вдвое больший прирост производительности по токенам и в трое по заполнению контекстного окна.
напишу результат позже...
📌 @tech_di