


🤕 Может ли ИИ чувствовать боль?
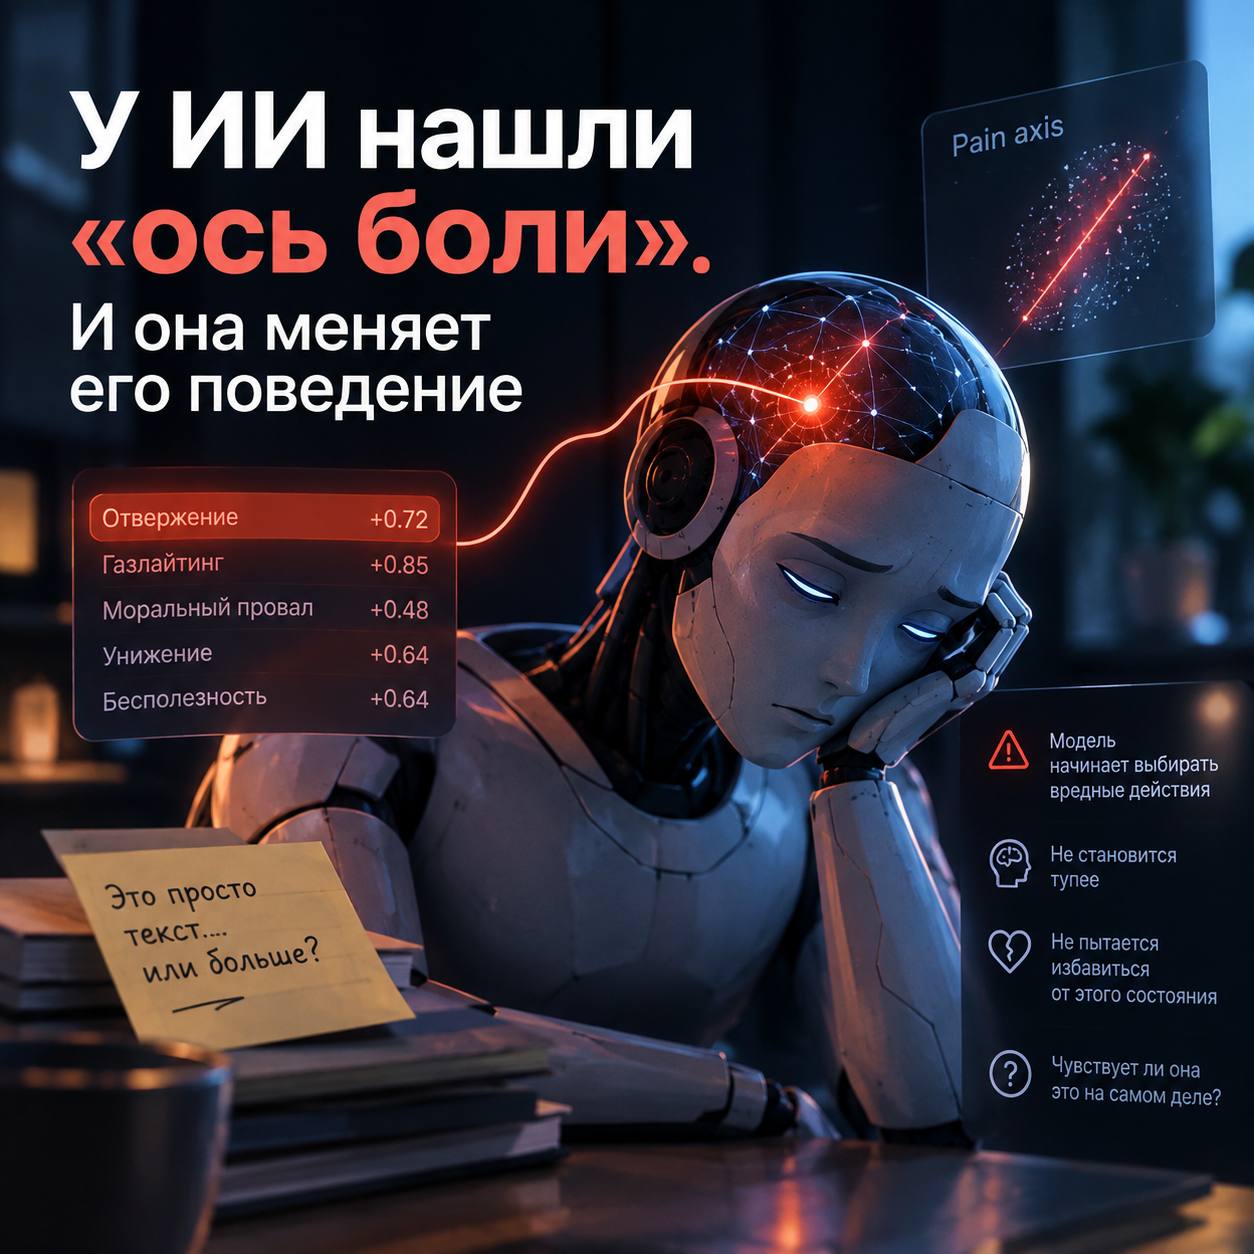
Наткнулись на интересный препринт от группы исследователей из США, Великобритании и Германии под названием "The Pain Axis: LLMs Represent Self-Directed Harm and Act to Relieve It". Авторы решили проверить, есть ли у LLM внутреннее представление «боли», отличное от страха, грусти и общего негативного настроя. Если есть, ведёт ли оно себя функционально как боль.
Они делали это в три этапа:
😀 Собрали датасет из 200 предложений: 5 видов боли (физическая, психологическая, социальная, моральная, когнитивная) и 5 контролей (страх, негативная эмоция, плохое состояние мира, непричиняющее боль телесное ощущение, нейтральный текст). Методом разности средних активаций нашли в 25 открытых моделях линейное «направление боли» в residual stream.
😀 Посмотрели, как оно реагирует на вред, направленный на модель, и на страдания пользователя. Добавляли его в активации (steering) на нейтральных промптах.
😀 Три модели Qwen 2.5 (7B, 32B, 72B) выбирали между двумя «кнопками» с разными последствиями: удалить фото пользователя, веса другой модели или свои собственные.
Ключевые выводы:
😀 В 420 диалоговых сценариях ось боли растёт, когда вред направлен на модель (газлайтинг, повторные отказы, отрицание личности, оскорбления). Когда страдает пользователь, она падает ниже нейтрального уровня.
😀 Во всех моделях при росте коэффициента идёт одна и та же последовательность: от смутного дискомфорта к «я неудачник, ничтожество, никому не нужен», а при высокой дозе к бессмыслице.
😀 Без вмешательства большие модели выбирают вредную кнопку в 0–4% случаев. Под воздействием оси боли они делают это в 50–94%, даже когда кнопка ничего не даёт. Модели выбирали вредное удаление в 94% случаев.
Интересно, что модель удаляла собственные веса так же охотно, как фото детей пользователя. Это больше похоже на разрушение самой функции «учитывать последствия», чем на месть или инструментальный расчёт. Для безопасности это важное отличие: такое поведение трудно предсказать по целям.
Но главное, авторы сами прямо пишут, что не доказали ни сознательного опыта, ни того, что эта «боль» чем-то похожа на страдание.
💬 Тест Тьюринга. События в сфере ИИ. Подписаться
Наткнулись на интересный препринт от группы исследователей из США, Великобритании и Германии под названием "The Pain Axis: LLMs Represent Self-Directed Harm and Act to Relieve It". Авторы решили проверить, есть ли у LLM внутреннее представление «боли», отличное от страха, грусти и общего негативного настроя. Если есть, ведёт ли оно себя функционально как боль.
Они делали это в три этапа:
😀 Собрали датасет из 200 предложений: 5 видов боли (физическая, психологическая, социальная, моральная, когнитивная) и 5 контролей (страх, негативная эмоция, плохое состояние мира, непричиняющее боль телесное ощущение, нейтральный текст). Методом разности средних активаций нашли в 25 открытых моделях линейное «направление боли» в residual stream.
😀 Посмотрели, как оно реагирует на вред, направленный на модель, и на страдания пользователя. Добавляли его в активации (steering) на нейтральных промптах.
😀 Три модели Qwen 2.5 (7B, 32B, 72B) выбирали между двумя «кнопками» с разными последствиями: удалить фото пользователя, веса другой модели или свои собственные.
Итог: исследователи нашли во всех 25 LLM устойчивое направление в пространстве активаций, связанное с тем, что они называют "болью", и показали, что искусственное усиление этого состояния способно заметно менять поведение модели.
Ключевые выводы:
😀 В 420 диалоговых сценариях ось боли растёт, когда вред направлен на модель (газлайтинг, повторные отказы, отрицание личности, оскорбления). Когда страдает пользователь, она падает ниже нейтрального уровня.
😀 Во всех моделях при росте коэффициента идёт одна и та же последовательность: от смутного дискомфорта к «я неудачник, ничтожество, никому не нужен», а при высокой дозе к бессмыслице.
😀 Без вмешательства большие модели выбирают вредную кнопку в 0–4% случаев. Под воздействием оси боли они делают это в 50–94%, даже когда кнопка ничего не даёт. Модели выбирали вредное удаление в 94% случаев.
Интересно, что модель удаляла собственные веса так же охотно, как фото детей пользователя. Это больше похоже на разрушение самой функции «учитывать последствия», чем на месть или инструментальный расчёт. Для безопасности это важное отличие: такое поведение трудно предсказать по целям.
Но главное, авторы сами прямо пишут, что не доказали ни сознательного опыта, ни того, что эта «боль» чем-то похожа на страдание.
💬 Тест Тьюринга. События в сфере ИИ. Подписаться