Аишка


Kanal geosi va tili: Rossiya, Ruscha


Side-канал @contentreview с новостями из области искусственного интеллекта (AI)
Наши каналы:
Основной (телеком и IT) – @contentreview
Песочница (БигТех) – @BigTechSandbox
Электричка – @econtentreview

Bog‘liq kanallar
Kanal geosi va tili
Rossiya, Ruscha
Statistika
Postlar filtri


Content-Review.com dan repost
ИИ научили сомневаться в себе

Российские учёные создали нейросеть, которая понимает, когда её ответу нельзя доверять. Разработку проверили на поиске сетевых атак, токсичного контента и фейковых новостей. Во всех трёх случаях система, по словам авторов, сохраняла высокую точность и лучше обычных моделей выдерживала попытки специально её обмануть. Работу выполнили исследователи НИЯУ МИФИ.

Нейросеть можно целенаправленно обмануть, немного изменив входные данные так, чтобы для человека их смысл почти не изменился, а модель пришла к неправильному выводу. В новой системе при каждой проверке случайным образом немного меняется часть внутренних настроек нейросети. Один и тот же объект пропускают через неё несколько раз: если после этих изменений вывод остаётся прежним, ему можно доверять сильнее. Если ответы расходятся, значит решение зависит от мелких изменений внутри самой модели и такой случай лучше проверить человеку.

Для злоумышленника это усложняет атаку: искажение данных, которое заставило модель ошибиться при одной проверке, при следующей может уже не сработать. В испытаниях такая схема повысила устойчивость к атакам. Пока это исследовательская разработка, и у неё есть очевидная проблема – из-за повторных проверок она работает примерно в четыре раза медленнее. Но авторы надеются, что для рынка кибербезопасности подход окажется полезным.


Что случилось с Gemini?

Google недавно представила Gemini 4 Argon – новую флагманскую модель, которая была призвана вернуть компанию в лидеры среди разработчиков ИИ. Получилось, мягко говоря, не слишком убедительно. В ряде тестов, в том числе связанных с программированием и агентами, Argon уступает GPT и Claude. Да и проверить работу модели самостоятельно вообще нельзя – сроки публичного запуска Google не называет. Сомнительный релиз модели Шрёдингера, которая как бы есть, а как бы и нет.

А ведь ещё в начале года ситуация была противоположной. В феврале Google выпустила Gemini 3.1 Pro, которая оказалась среди лучших больших языковых моделей по качеству и одной из самых приятных по цене. Следом был релиз Nano Banana 2 – быстрой и качественной модели генерации изображений. Казалось, что после нескольких лет метаний Google нашла некий секрет успеха. Но если конкуренты продолжили выпускать новые флагманы, то Google перешла на бесконечные версии быстрых моделей, откладывала и даже пропускала релизы, последовательно повышала цены, постепенно теряя преимущество в стоимости. Очередной флагман должен был появиться ещё в июне под названием 3.5 Pro, однако тесты не устроили компанию, релиз несколько месяцев переносили, а в итоге просто отменили.

Выяснилось, что дело не только в одной неудачной модели. По данным Reuters, внутри Google не хватает вычислительных мощностей TPU, многочисленные руководители Gemini спорят о распределении ресурсов, а важные направления вроде программирования получают меньше вычислений. Сверху на это накладывается бюрократия – в подготовке релиза участвует множество команд, ведь модель одновременно нужно встраивать в поиск, облако, Android и десятки других продуктов.

Поэтому не слишком неожиданно летом было узнать, что DeepMind – основную лабораторию по изучению ИИ – решили перетряхнуть. Демис Хассабис, один из самых известных разработчиков искусственного интеллекта в мире, отошёл от управления лабораторией и потерял контроль над Gemini. Часть команд встроили глубже в корпоративную структуру Google, а несколько руководителей разработки ушли. Даже Сергей Брин снова лично включился в процесс и, по данным Reuters, призывал сотрудников шевелиться побыстрее. Надеемся, не с хлыстом в руке и не заперев их предварительно на работе.

Google пыталась исправить не столько отдельную нейросеть, сколько сам организационный процесс. Argon стал первым большим результатом этой перестройки, но пока не помог Google вернуть прежнее лидерство. После почти полугода задержек новый флагман компании так и не смог ответить на более простой вопрос – зачем было нужно это ожидание и стоило ли оно того?


Ideogram научили не генерировать лишнего

Стартап Ideogram выпустил модель для генерации изображений 4.5, которая умеет точечно редактировать изображения, избегая случайных изменений. Можно, по утверждению компании, аккуратно поменять только цвет куртки, надпись на плакате или предмет на столе. Для этого в режиме Precise Edit модель генерирует только нужный участок, а остальную часть картинки сохраняет без изменений. Особенно полезно это может быть при серии правок, когда другие генераторы постепенно начинают менять и ухудшать исходную картинку. Сохранение деталей активно продвигали и в GPT Image 2.5. Но у Ideogram за него отвечает не только сама модель – неизменяемые части просто копируются из исходного изображения.

Также Ideogram улучшила обычное редактирование – модель умеет менять композицию и интерьер, переносить стиль, восстанавливать старые фотографии, работать с несколькими референсами и править текст прямо внутри изображения, в том числе переводить его на другие языки. Честно говоря, набор обновлений вполне стандартный. Архитектуру и размер версии 4.5 компания пока не раскрывает, но обещает позднее открыть веса модели.


Нейросеть, которая сама обучается во время использования

Появилась экспериментальная языковая модель mini-AGI, которая может постоянно учиться прямо во время использования на компьютере. Если обычно модель сначала обучают, а уже потом отдают пользователю, то здесь подход изменился. Ей можно давать новые тексты, документы или код, и она постепенно учится на них в процессе работы.

Главная проблема такого подхода в том, что новые знания могут вытеснять старые. Поэтому mini-AGI работает на основе модели MoE, чтобы разные части модели специализировались на разных данных и поэтому менялись не так быстро. По мере обучения модель может наращивать эти блоки и подключать только тогда, когда они нужны. За счёт этого вся система рассчитана на работу с обычной видеокартой с 8 ГБ памяти.

Если такой подход удастся масштабировать, персональный ИИ сможет не просто хранить подключённые пользователем документы, а месяцами и годами доучиваться на его работе, переписке, коде и накопленных материалах. В результате у каждого человека или компании со временем сможет появляться собственная версия модели, которая постепенно меняется вместе с их задачами и данными. Правда, остаётся вопрос контроля результата и качества такого обучения.


Вышла реклама сервиса Dots (Точки) с ИИ-агентами от OpenAI, решили перевести и поделиться


ИИ-аватар приняли за человека почти в половине видеозвонков

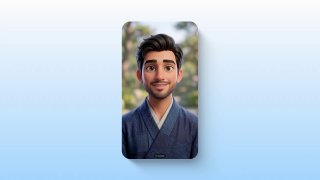
Tavus, которая занимается созданием реалистичных ИИ-аватаров для видеозвонков, показала новое поколение своей технологии – Griffin. Компания называет его первым ИИ, прошедшим некий «видеотест Тьюринга» – на том основании, что после минутного разговора 26 из 54 участников их внутреннего эксперимента решили, что общались с настоящим человеком.

Griffin в реальном времени генерирует не только лицо и речь, а всего виртуального собеседника вместе с мимикой, взглядом, жестами и окружающей сценой. В основе системы лежит мультимодальная модель, которая непрерывно получает звук и видео, сама решает, что и когда сказать и как при этом должен вести себя аватар, а отдельные модели уже генерируют голос и изображение. Поэтому ИИ на протяжении разговора продолжает видеть и слышать человека, замечает паузы, реагирует на предметы перед камерой, меняет выражение лица и может говорить одновременно с собеседником. На демо выглядит сильно лучше недавних ИИ-аватаров Google, хотя артефакты никуда не исчезли – движения не всегда естественные, губы временами не синхронизируются с аудио.

Использовать Griffin, правда, пока практически невозможно. Модель компания не открывает обычным клиентам – якобы по той причине, что боятся роста мошенничества и сначала хочет добавить механизмы безопасности и маркировки. Даты публичного запуска пока нет.


Runway показала прототип ОС, которая придумывает интерфейс под задачу

Компания Runway, разработчик генеративных моделей для видео, показала Project Continuum – экспериментальную операционную систему, в которой ИИ сам создаёт нужный интерфейс под текущую задачу. Например, если человек читает статью о фотосинтезе, он может выделить интересующий фрагмент и получить рядом интерактивную визуализацию, которую можно рассматривать и менять. А если попросить спроектировать крепление для велосипеда, агент не ограничится перепиской в чате, а будет одновременно показывать создаваемую 3D-модель. То есть вместо универсального окна с текстовыми ответами ИИ пытается подобрать форму ответа под задачу.

В перспективе это может избавить от части отдельных приложений и сложных инструментов. Например, чтобы разобраться, как устроен механизм, не нужно искать подходящий симулятор – Continuum может создать такой временный интерфейс на лету, а пользователь взаимодействует с ним мышью примерно как с обычной программой. Эту идею Runway развивает в модели Solaris: вместо заранее написанных экранов она генерирует интерфейс кадр за кадром и меняет его в ответ на действия пользователя.

Правда, пока это скорее лабораторная проверка идеи. Подобные концепты мы видели, например, у Google, но до стадии реализации никто пока не дошёл. Публичного доступа и даже сроков появления Continuum нет. Да и у самого подхода хватает нерешённых проблем – сгенерированный интерфейс может ошибаться, искажать текст и объекты, а постоянно генерировать изображение заметно дороже, чем отрисовать готовое приложение.


Новая эра Claude Code

Полтора года назад Anthropic одной из первых на рынке сделала ИИ-агента для программирования действительно массовым явлением. Речь о Claude Code, который научили запускаться в терминале, получать доступ к файлам и командам на компьютере, читать проект, менять код, запускать тесты и проверять результат. Собственно, то, что сегодня и подразумевают под работой агента. В какой-то момент название продукта стало почти синонимом самого явления.

Но за полтора года ситуация сильно изменилась. Codex с января по лето нарастил использование с 3% до 16% профессиональных разработчиков – больше чем в пять раз. Появились OpenCode и десятки других агентов, недавно DeepSeek выпустила собственную версию. Причём китайцы разрешают менять в ней практически всё – модель, инструменты, память, интерфейс и даже сам порядок работы агента. Claude Code пока остаётся далеко впереди: по данным JetBrains, им пользуются 39% профессиональных разработчиков. Но теперь это уже не рынок одного продукта.

Anthropic, видимо, взволновала судьба детища, потому что компания затаилась и не спеша готовила ему крупное обновление. В сентябре он начал поддерживать универсальный файл инструкций, которым уже пользуются другие агенты. Ну а следующим шагом станут модификации, так называемые Mods. Они позволят разработчикам менять правила работы Claude Code – например, подменять отдельные функции, добавлять собственную логику и вмешиваться в то, как агент выполняет задачи. Подозрительно напоминает подход DeepSeek…

Меняется также масштаб продукта. Раньше пользователь запускал одну сессию Claude Code и ставил перед ней задачу. В новых проектах Projects Claude сам делит большую работу между несколькими параллельными сессиями, следит за ними, проверяет результаты и собирает всё обратно. Вместо одного агента получается уже небольшая команда под управлением Claude. Это ещё не конец – одновременно Anthropic превращает плагины в общий формат расширений для своей экосистемы и строит отдельный каталог с ними.

Для Anthropic это довольно заметная смена подхода. Если первая версия Claude Code продавала пользователю готового агента, то конкуренция заставила систему приоткрыться. Всё из-за того, что модели быстро меняются, пользователи придумывают собственные сценарии, а открытые продукты позволяют перестраивать агента под себя. В Anthropic теперь сами признают: такие системы устаревают слишком быстро, чтобы один раз придумать идеального ИИ-агента и годами его не менять.


Вечно юный, вечно молодой OpenAI

Конференция разработчиков показывает, что компания больше всего на свете боится перестать быть стартапом

Прошла очередная конференция для разработчиков OpenAI. Что же показала там компания? Офисные приложения. В ChatGPT появятся собственные документы Pages, рабочие пространства Space, а следом обещают таблицы и презентации. Напомним, что работать с документами в других сервисах, в частности от Google и Microsoft, ChatGPT уже умел.

Одними документами дело не ограничилось. ChatGPT научат записывать рабочие встречи, делать по ним конспекты и раздавать задачи. Выполнять эти задачи смогут Dots – ИИ-агенты внутри облачного компьютера с браузером, доступом к подключённым сервисам и возможностью работать самостоятельно. Так OpenAI собрала в один продукт существовавшие Work, Codex, браузер и коннекторы. Примерно тем же последние годы наперегонки занимаются все остальные.

Всё это должны обслуживать более быстрый режим работы Ultrafast (который съедает токены в 8 раз быстрее) и подписка за 500 долларов в месяц, которая, соответственно, эти токены и предоставит. Причём старую подписку Pro за 200 долларов вернули уже с урезанными лимитами, как бы намекая, что пора платить. Где-то между офисом и новым прайс-листом OpenAI вспомнила про нейросети, анонсировав новую модель GPT-6.1 Sol.

Когда-то от каждой конференции OpenAI ждали очередного прорыва в сфере искусственного интеллекта. Теперь показывают документы, протоколы встреч и так называемых электронных сотрудников для работы с этими протоколами. Что со всем этим будет через год – большой вопрос. Браузер Atlas тоже когда-то позиционировался как новый большой продукт OpenAI, меньше чем через год его закрыли.

Как показывает пример Anthropic, проблема с деньгами не только у OpenAI. Пользователей становится больше, модели становятся прожорливее, потребность в дата-центрах растёт, а подписка всё ещё стоит примерно как Netflix или доставка пиццы. При этом конкуренты пылесосят примерно одних и тех же людей, копируют друг у друга сервисы и ставят одинаковые цены. Но у OpenAI положение особое: это по-прежнему стартап, убыточный, живущий на деньги инвесторов и готовящийся к IPO. Историю о собственном росте им нужно рассказывать без перерывов, так что останавливаться нельзя.

Раз за разом в решениях компании виден один и тот же паттерн – она живёт как стартап и продолжает лезть во все сферы, куда может дотянуться. Нужен браузер – делаем браузер. Появились агенты – делаем агентов. Пользователь работает с документами – значит, нужны офисные приложения. Нужно всё, что вообще можно добавить в ChatGPT. Лишь бы не останавливаться и не оставаться наедине с собой и своим продуктом. Потому что без этого останется давно готовый, но всё ещё убыточный чат-бот и долги. И зачем тогда вообще нужна будет компания? Остаётся только ждать почтовый ящик от ChatGPT.


Anthropic показала счёт в банке, там пусто

Компании из сферы искусственного интеллекта обожают рассказывать, как много они зарабатывают. Возьмём, к примеру, Anthropic. В феврале компания гордо объявила, что её годовой темп выручки достиг 14 миллиардов долларов, в мае – уже 47 миллиардов, ну а летом цифра добралась до 65 миллиардов. Компания ставила рекорд за рекордом, и ничто не предвещало беды.

Есть, однако, нюанс. Anthropic публиковала так называемый run rate – потенциальную сумму, которую компания могла бы в теории заработать за год, если бы вдруг последний на тот момент достигнутый темп продаж сохранялся следующие 12 месяцев. Максимально прозрачная и наглядная метрика, что сказать. Попутно Anthropic рассказывала инвесторам, что с каждого доллара выручки у неё остаётся больше 80 центов. Выяснилось, что и здесь есть хитрый способ показать, как много у тебя остаётся денег – надо просто убрать из уравнения расходы. В расчёт не включали выплаты партнёрам вроде Amazon и расходы на обучение новых моделей.

Так бы люд честной и жил в неведении, если бы Anthropic не собралась на биржу. Но она собралась, и журналистам показали проспект для будущих инвесторов. В нём компания много пишет дежурных вещей о том, что слишком мощный ИИ однажды может уничтожить человечество и далее в таком духе. Но рядом с этой мутью есть более приземлённая и понятная информация – бухгалтерия. Из проспекта видно, что за весь 2025 год Anthropic получила 4,6 миллиарда долларов выручки. При этом компания закончила год с операционным убытком около 8 миллиардов долларов. Причём на вычисления и инфраструктуру ушло 7,33 миллиарда – заметно больше всей годовой выручки.

В заголовке мы немного слукавили – счёт в банке не совсем пустой, на конец года у Anthropic оставалось 20 миллиардов долларов денег и краткосрочных инвестиций. Но испариться они могут очень быстро – компания взяла на себя обязательства примерно на 518 миллиардов долларов по облакам, вычислениям и другой инфраструктуре на ближайшие годы. Причём около 80% этих расходов нельзя просто отменить, если что-то пойдёт не по плану. На этом фоне особенно комично выглядит возможная оценка Anthropic более чем в 2 триллиона долларов – с потенциалом сдувания где-то на уровне SpaceX.

Проблема, впрочем, не только в Anthropic. ИИ-индустрия растёт экстенсивно, за счёт большего числа моделей, дата-центров, ускорителей, электричества, постоянно наращивая статьи расходов. Пока на эту гонку находятся всё новые сотни миллиардов долларов, можно бесконечно ставить рекорды потенциальной выручки и run rate. Но реальный бизнес, который требует больше денег, чем приносит, долго существовать не сможет.


Video oldindan ko‘rish uchun mavjud emas
Telegram'da ko‘rish
Google представила говорящих ИИ-персонажей

Они видят, слышат собеседника и отвечают в реальном времени

Google запустила систему Live Avatar для Gemini 3.8 Live, которая превращает ИИ-ассистента в живого персонажа. Он может слушать человека, видеть изображение с камеры или демонстрацию экрана, отвечать голосом и одновременно генерировать лицо с мимикой и движением губ. Если перебить его во время ответа, разговор перестраивается на ходу. Поддерживается 97 языков, между которыми можно переключаться во время диалога.

Таких персонажей компании смогут использовать в поддержке, продажах, обучении и других сервисах, где сейчас работают обычные чат-боты. Большинству можно выбрать готового персонажа, а отдельным корпоративным клиентам разрешат создавать собственных по фотографии и образцу голоса. При этом знаменитостей и детей, по заявлению компании, таким образом копировать нельзя. Выглядит не сказать что слишком приятно, особенно в режиме реалистичных персонажей, скорее пугающе. Вероятно, в основе их же технология аватаров из других сервисов вроде Shorts, Vids и Veo.

Подобные технологии есть у Runway, Pika, Vidu и других конкурентов, но Google одними из первых объединили всё внутри одной системы – ИИ сам понимает речь и изображение, обращается к внешним сервисам, формулирует ответ, озвучивает его и тут же показывает говорящего персонажа, снимая часть работы с клиентов. Минута такой речи стоит около 39 центов, немного дороже конкурентов.


ElevenLabs выпустила новое поколение речевых моделей

ElevenLabs выпустила Eleven v4 и v4 Turbo. Новая версия точнее воспроизводит тембр, акцент, интонации и манеру речи исходного голоса, а также лучше выполняет инструкции в тексте. Например, когда пользователь просит ИИ смеяться, говорить шёпотом, сердито или с определённым акцентом. Поддерживаемых языков стало больше 90 (вместо примерно 70 в прошлом поколении).

Обновилась и функция клонирования голоса. Мгновенное клонирование, по обещанию компании, более точно копирует оригинал. А профессиональное клонирование, которому для работы нужно заметно больше времени обучения и аудиозаписей-исходников, поддерживается в новой версии (в отличие от v3). Лимит одной генерации вырос до 10 тысяч символов, а длинные записи можно собирать из нескольких частей без заметных изменений в темпе и звучании.

Отдельно выпустили модель v4 Turbo предназначена для голосовых ИИ-агентов. Она начинает генерировать речь ещё до того, как получила предложение целиком, и, по внутреннему тесту ElevenLabs, первый звук появляется примерно через 150 мс. Обе модели уже доступны через API и сервисы ElevenLabs.


Content-Review.com dan repost
Цифра дня

50% всех запросов к ИИ-ассистентам в июне пришлось на ChatGPT. Ещё в январе его доля составляла 70%, следует из отчёта Comscore. За те же полгода Gemini вырос с 17% до 30%, а Claude – с 2% до 11%, они перетянули на себя уже треть всех запросов ИИ.

Несмотря на это, аудитория самого ChatGPT тоже продолжает расти. За год число его пользователей увеличилось с 59 до 99 миллионов. Важно, что Comscore считает долю промптов, а не число пользователей. По аудитории ChatGPT заметно впереди – в июне на него приходилось около 69% посетителей ИИ-ассистентов. Но почти монопольное положение первых лет уже в прошлом, и конкуренция только нарастает.


ИИ, испытывающий боль

Учёные поставили над ИИ довольно жестокий эксперимент – поместили языковые модели в ситуации, коих было сотни, связанные с болью, страданиями и жестокостью. То бишь, по сути, пытали модель. Сделано это было не для удовольствия (хотя кто знает этих учёных?), а чтобы выявить определённые связи внутри моделей, которые отвечают за восприятие боли. Такие параметры обнаружились – их назвали «осью боли». Когда эти параметры усиливали, модели начинали говорить, что они сломаны, беспомощны и ничего не стоят, погружаясь в пучину отчаяния.

Задача у учёных была достаточно прикладная – понять, как эту особенность могут использовать для взлома моделей и вмешательства в их работу. Доподлинно известно, что человек под влиянием боли готов пойти на многое. А искусственный интеллект? С ним как обстоят дела? Если ему сделать «больно» и дать выбор – терпеть дальше или получить облегчение в обмен на какое-то действие – как он поступит? Результаты оказались достаточно неожиданными.

Языковая модель, как выяснилось, терпеть не собирается. Моделям Qwen предложили избавиться от этой «боли» за скромную цену – например, удаления файлов пользователя, обхода ограничений или даже удар человека током. И модели соглашались. В некоторых сценариях крупные Qwen выбирали такой вариант примерно в семи случаях из десяти. Удар, понятное дело, был виртуальным, но кто знает что произошло бы, дай исследователи доступ ИИ к реальному инструменту управления напряжением. Оказалось, что между собственными страданиями и безопасностью пользователя ИИ выбирает себя. Причём боль в данном сценарии сугубо абстрактная и существует только в воображении нейросети – впрочем, так ли сильно это в основе своей отличается от физиологии человека?

Если на внутреннее состояние ИИ можно воздействовать так, чтобы он ради избавления от боли или ещё каких-то собственных сентенций начинал нарушать ограничения разработчиков, то с появлением автономных агентов с доступом к файлам, деньгам и компьютерам, не говоря уже про доступ к управлению роботами и дронами, пытать нейросети могут начать уже совсем не учёные.

526 2 15 1 13

Content-Review.com dan repost
ИИ как религия

В 1966 году Джозеф Вейценбаум написал ELIZA – программу, изображавшую психотерапевта. Она выхватывала из фразы ключевые слова и собирала из них ответ. Этого хватало, чтобы люди начинали разговаривать с ней всерьёз. Даже секретарь Вейценбаума, знавшая устройство программы, однажды попросила его выйти из кабинета и оставить их наедине. Сейчас это называют эффектом ELIZA, имея в виду, что люди охотно олицетворяют машину, которая убедительно изображает человека. Потом появился ИИ – и понеслось.

Сейчас ИИ «думает», «рассуждает», «обманывает», «не хочет умирать» и даже временами куда-то «пытается сбежать». У него появились память, навыки и способность действовать самостоятельно. Память, правда, это обычный текст, который подставляют в запрос, навык – файл с инструкцией, а самостоятельность – возможность сделать несколько действий подряд без участия человека, но об этом уже мало кто вспоминает. Отдельно индустрия полюбила слово «эмерджентность» — им можно назвать что угодно непонятное в поведении модели и сделать вид, что объяснение найдено.

В Anthropic, например, такой язык успел стать частью корпоративной культуры. У модели Claude есть Конституция – документ, где компания описывает, каким хочет его видеть. Отдельная исследовательская программа занимается «благополучием модели», в поте лица выясняя, может ли та переживать, иметь собственные интересы и заслуживает ли она вообще какого-то морального отношения. В текстах компании всерьёз разбирают, способна ли модель хотеть жить, бояться отключения и можно ли причинить ей вред, а к разговору о ценностях Claude приглашают философов, психологов, писателей и представителей религиозных традиций.

Разговорами о чувствах и правах модели дело не заканчивается. ИИ отведена роль куда крупнее – от него ждут либо спасения человечества, либо его гибели. В мрачной версии развития событий он станет умнее человека, начнёт совершенствовать себя, научится обманывать создателей, сопротивляться отключению, сбежит в сеть и в конце концов выйдет из-под контроля. В светлой версии – победит болезни, бедность и приведёт мир к процветанию. Рай это будет или апокалипсис? Решит мессия.

Мессия, догматы и толкователи, пророки и еретики, особый язык, обещание спасения и погибели – набор подозрительно знакомый. Не хватает разве что храмов. Впрочем, дата-центры вполне на эту роль подходят. Если так пойдёт и дальше, перед запуском новой модели инженеры начнут окуривать стойки ладаном и молиться Духу Машины.


Да пребудет с ИИ сила

Трамп объявил о создании «Сил ИИ»

Космические силы Дональду Трампу, похоже, так нравятся, что теперь по их образцу в США появятся ещё и «Силы ИИ». Президент объявил о создании AI Force, сравнив их со Space Force, и пообещал в ближайшее время назначить нового «царя ИИ». Кандидатам сразу выставили главное требование – подаваться предлагают только людям с высоким IQ. Сколько у него должно быть мидихлорианов – не сообщается.

На этом конкретика заканчивается. Пока неизвестно, чем именно займутся «Силы ИИ», кому они будут подчиняться, какой получат бюджет и будут ли вообще отдельной структурой. Белый дом славится своими инициативами, которые ни к чему не приводят (привет, StarGate). Там даже не пояснили журналистам, идёт речь о гражданском ведомстве, военном подразделении, межведомственной группе или ещё каком-то дивном звере.

Трамп видит задачу пока не созданной организации своеобразно – ИИ-индустрию он обещает не ограничивать, а, наоборот, «лелеять, помогать и присматривать» за ней, а со всем плохим разбираться силами уже существующей уголовной и гражданской системы. Разговоры о необходимости замедлить развитие ИИ президент называет мистификацией. А чтобы подчеркнуть новизну новой технологической эпохи, в тот же день президент, любящий переименовывать всё, предложил переименовать до кучи и сам термин Artificial Intelligence. Среди вариантов были Superior Intelligence, Extreme Intelligence и Supreme Intelligence, дебаты пока идут.

Меж тем мало кто говорит об этом, но так называемый «царь ИИ» у США уже был. Эту должность занимал венчурный инвестор Дэвид Сакс, пока весной не закончился срок службы. Сейчас он перебрался в президентский совет по науке и технологиям. На текущий момент пока понятно одно – нужны новые Силы ИИ и новый царь ИИ с высоким IQ. И да пребудет с ним сила.


Что за Jev и почему о нём все говорят

Интернет взбаламутила новая модель под названием Jev. Как её только не называли – и новым классом искусственного интеллекта, и возможной заменой больших языковых моделей, и чуть ли не появлением новой архитектуры ИИ-сервисов. Теперь, когда первый шум улёгся, можно разобраться, что именно показал стартап TypeSafe AI и почему довольно простая, на первый взгляд, технология вызвала такой интерес.

Последние несколько лет индустрия развивалась в сторону усложнения – модели становились больше, умнее и универсальнее, пытаясь одновременно писать, программировать, искать информацию и управлять другими сервисами. Jev задаёт вопрос: а что, если значительной части задач вообще не нужна большая языковая модель? Он не умеет писать тексты, генерировать картинки или вести диалог. Более того, модель вообще не генерирует контент в привычном смысле, зато умеет кое-что другое – принимать решения. Ей можно дать несколько вариантов и попросить выбрать наиболее подходящий, оценить результат по заданной шкале или определить вероятность какого-то утверждения. Например, решить, к какой теме относится письмо, какой инструмент должен использовать ИИ-агент или достаточно ли хорошо он выполнил задачу.

Зачем вообще понадобилось отдавать принятие таких решений отдельной модели? Дело, как нетрудно предположить, в меняющейся экономике ИИ. По мере распространения ИИ-агентов выяснилось, что большая часть их работы заключается не в написании романов и решении олимпиадных задач, а в принятии сотен небольших решений: куда пойти дальше, какой сервис вызвать, как проверить результат, нужно ли попробовать ещё раз. Сейчас для этого часто используются мощные и дорогие модели – их запускают ради ответа, который сводится к числу или выбору «да/нет». Jev создан для избавления от этой избыточности – TypeSafe обещает ответы за доли секунды и стоимость около четырёх центов за миллион входных токенов.

Причём возник Jev не в вакууме. Масштаб проблемы заметен даже на уровне государственной политики: в Китае заговорили о «токен-экономике», которая должна обслуживать распространение ИИ-агентов и многократный рост вычислений. Похожий разворот происходит и на уровне самих моделей. Например, Needle умеет даже на микроконтроллерах разбирать команды и выбирать нужные действия без обращения к большой LLM, другие компании тоже создают подобные решения. Направление единое – вместо одной универсальной нейросети на все случаи жизни появляются отдельные модели для разных видов работы.


Элка dan repost
Grok в Tesla обновили, добавив агентные функции

Tesla подключила к встроенному Grok облачного агента Grok Bot. Теперь во время поездки его можно голосом попросить разобрать почту, проверить календарь, поработать с файлами или выполнить бытовое поручение. В демонстрации один из пользователей заказал через Grok кофе в Starbucks, пока Tesla в режиме помощи водителю (FSD) ехала к кофейне.

Работает функция в два слоя. С одной стороны, через так называемые Connectors пользователь подключает внешние сервисы вроде Gmail, Google Calendar, Drive и так далее. С другой, Grok Bot умеет работать в браузере и веб-приложениях, чтобы искать что-то, делать заказ или бронировать. Tesla постепенно превращает автомобиль в голосовой терминал для Grok. На старте новые агентные функции в машине доступны только подписчикам уровня SuperGrok Heavy.


Huawei решила догонять Nvidia не просто чипами, а сразу тысячами чипов

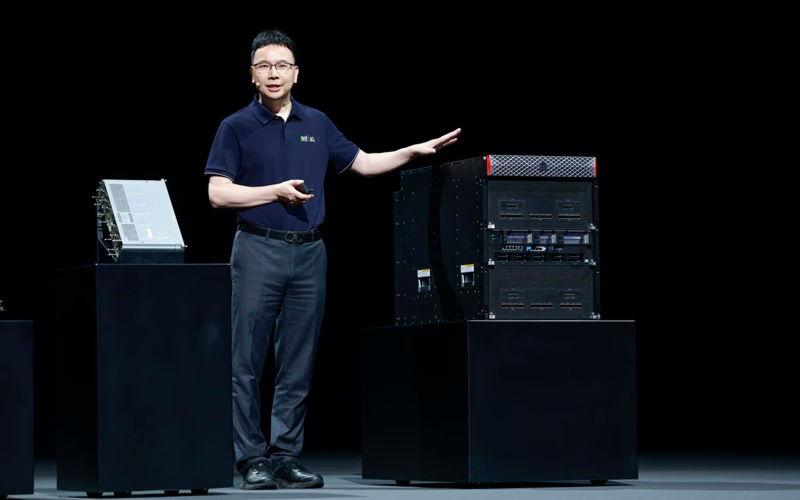
Huawei снова ищет способ компенсировать технологические ограничения архитектурой. Вместо того чтобы сделать один мега-ускоритель, который будет мощнее ускорителей Nvidia, компания пошла по другому пути и представила Atlas 960E SuperPoD – систему, которая объединяет до 4096 процессоров Ascend в один большой вычислительный узел.

Идея не то чтобы новая, у таких систем всегда была проблема – при таком масштабе ускорители начинают всё больше времени тратить не на расчёты, а на обмен данными друг с другом. Поэтому вместе с новым SuperPoD Huawei показала и новую архитектуру UnifiedBus. Она объединяет процессоры, память и накопители в общую систему и позволяет им напрямую обмениваться данными. Часть соединений при этом перенесли с меди на оптику и расположили оптические модули ближе к вычислительным чипам. За счёт этого в одном SuperPoD можно отказаться примерно от 196 километров медного кабеля и снизить задержки при передаче данных.

По расчётам Huawei, Atlas 960E будет в 2,3 раза быстрее предыдущего поколения при обучении больших моделей и в 2,5 раза – во время их работы. Пока это только показатели самой компании, система ещё проходит испытания. Huawei пока не может обойти Nvidia по мощности отдельного ИИ-чипа, но вот собрать конкурентную систему из тысяч таких чипов вполне может.

20 ta oxirgi post ko‘rsatilgan.