Центр непрерывного образования ФКН НИУ ВШЭ


Kanal geosi va tili: Rossiya, Ruscha
Toifa: Ta’lim


Дополнительное профессиональное образование от факультета компьютерных наук НИУ ВШЭ.
Программы с нуля и продвинутые курсы по:
- математике
- программированию и ИИ
- анализу данных и Data Science
- фронтенду и геймдеву
Сайт: https://cs.hse.ru/dpo

Bog‘liq kanallar  |  O‘xshash kanallar
Kanal geosi va tili
Rossiya, Ruscha
Statistika
Postlar filtri


607 0 30 1 10

🎛 Получили новый набор данных. Что проверить до начала анализа?

Открыть таблицу и сразу начать строить графики — заманчиво. Но несколько пропусков, дубликатов или неверно определённых типов данных могут повлиять на весь дальнейший анализ.

Поэтому подготовили чек-лист первичной проверки данных в Python. Его можно сохранить и использовать как последовательность действий каждый раз, когда начинаете работать с новым набором данных.

Для каждого этапа добавили примеры команд на Python, чтобы чек-лист можно было использовать как небольшую рабочую шпаргалку.

🔗 Сохраняйте PDF и возвращайтесь к нему перед следующим анализом.

Проверка качества данных — один из первых шагов в работе аналитика. Научиться готовить данные к анализу, исследовать их и делать выводы можно на наших программах, которые стартуют 14 октября:

🛡 «Язык программирования Python для анализа данных». Вы начнёте с основ Python, затем освоите сбор данных с веб-страниц и через API, обработку в pandas и NumPy, работу с SQL, визуализацию и автоматизацию повторяющихся задач.

🛡 «Аналитик данных». Программа профессиональной переподготовки для комплексного освоения аналитики: от Python, SQL и статистики до продуктовой аналитики, проверки гипотез и машинного обучения.


📊 Как искать работу в аналитике и других направлениях ИТ

Мы много говорим о навыках, которые нужны для работы с данными: Python, SQL, BI, статистике и машинном обучении.

Но помимо профессиональных знаний важно понимать, какую роль выбрать, как представить свои навыки работодателю, подготовиться к собеседованию и выстроить поиск работы.

Поэтому сегодня делимся бесплатным карьерным курсом НИУ ВШЭ. Он посвящён поиску работы в сфере информационных технологий в целом, но будет особенно полезен тем, кто рассматривает аналитику как направление для развития или готовится искать работу в этой области.

В курсе можно узнать:
🔹 какие направления и роли существуют в аналитике и чем они отличаются;
🔹 как составить резюме и показать свои сильные стороны;
🔹 что написать в сопроводительном письме;
🔹 как подготовиться к собеседованию, в том числе техническому;
🔹 как выстроить стратегию поиска работы.

✈️ Пройти бесплатный карьерный курс


📤 Почему модель уверенно ошибается даже с хорошим промптом

Вы подробно описали задачу, добавили контекст, задали формат и попросили ничего не придумывать. Модель отвечает уверенно, подробно и логично.


Но один факт оказывается выдуманным. Почему?

Разберём пять ситуаций, о которых важно помнить при работе с LLM.

1️⃣ У модели нет нужной информации

Вы спрашиваете про внутренний регламент компании, свежие показатели или документ, которого нет в контексте. Более подробный промпт не добавит модели недостающих данных.

➡️ Что делать: передать источник вместе с запросом или использовать систему, которая умеет получать информацию из внешних источников.

2️⃣ Информация могла устареть

Тарифы, законы, версии библиотек, характеристики продуктов и должности людей меняются. Модель при этом может сформулировать устаревшую информацию так же уверенно, как актуальную.

➡️ Что делать: всё, что зависит от времени, сверять с актуальным первоисточником.

3️⃣ Задачу можно понять по-разному

«Сравни эффективность двух рекламных кампаний». По какому показателю: CTR, CPA, ROMI, продажам или прибыли?

Если критерий не указан, модель может выбрать его сама. И этот выбор не обязательно совпадёт с тем, что имел в виду пользователь.

➡️ Что делать: заранее определить критерии или попросить модель сначала задать уточняющие вопросы. Здесь более точный промпт действительно помогает.

4️⃣ Больше контекста не всегда означает лучший ответ

Кажется логичным: загрузим больше документов и получим более точный результат. Но вместе с полезной информацией в контекст попадает шум, а нужный фрагмент может затеряться среди десятков страниц.

Это важно и для RAG-систем, в которых модель получает найденные фрагменты документов. Если поиск передал нерелевантные материалы или пропустил нужный источник, одним хорошим промптом проблему решить сложно.

➡️ Что делать: следить не только за объёмом, но и за релевантностью контекста: проверять, какие материалы система нашла и достаточно ли в них данных для ответа.

5️⃣ Модель может ошибаться без признаков сомнения

Языковая модель генерирует ответ, но убедительная формулировка сама по себе не подтверждает его достоверность. Она может придумать факт, ссылку или цитату и встроить их в логичное объяснение.

Аккуратная структура, профессиональные термины и уверенный тон могут сделать такую ошибку менее заметной.

➡️ Что делать: проверять ключевые факты, ссылки и цитаты по самим источникам. Просьба «ничего не придумывай» полезна, но не заменяет проверку.

Как тогда работать с LLM?

Для важных задач лучше не останавливаться на схеме «вопрос → ответ».

Добавьте ещё несколько этапов:

задача → источники → ответ модели → проверка → результат

Хороший промпт помогает модели правильно понять задачу. Но качество результата зависит ещё и от исходных данных, актуальности информации, релевантности контекста и того, как вы проверяете полученный ответ.


🎛 Соберите собственного ИИ-агента под реальные рабочие задачи за 7 недель.

Центр непрерывного образования НИУ ВШЭ открывает предзапись на новую программу «Основы ИИ-агентов для автоматизации процессов».

Для старта не нужны специальные знания или опыт работы с ИИ.

На программе участники:

🔽 разберутся, как устроены ИИ-агенты и где их можно применять;
🔽 освоят инструменты для их сборки;
🔽 создадут собственного агента на low-code-платформе Nodul;
🔽 соберут работающий проект под задачи своей профессии.

После общего модуля можно выбрать один из четырёх треков:

➡️ HR — автоматизация работы с вакансиями и резюме;
➡️ маркетинг — работа с контентом от идеи до публикации;
➡️ управление проектами — автоматизация задач от планирования до отчётности;
➡️ аналитика — автоматизация SQL-запросов и подготовки отчётов.

В течение обучения каждый участник самостоятельно создаст работающего ИИ-агента, адаптированного под задачи выбранной профессии или отрасли. В финале — презентация проекта в формате питч-дека и демонстрация его возможностей.

💻 Онлайн
⏳ 7 недель
🎓 Удостоверение о повышении квалификации НИУ ВШЭ

📌 Предзапись на программу уже открыта.


📊 Встречаемся уже через час!

Сегодня говорим о том, как использовать ИИ для анализа данных: от работы с сырой выгрузкой до метрик, графиков и гипотез.

Покажем всё на живом примере и отдельно разберём, где ИИ может ошибаться и как проверять результат.

🔊 Начинаем в 17:30

Если планировали присоединиться, самое время зарегистрироваться ⬇️

Регистрация на вебинар


💬 ИИ внедряют всё быстрее. А кто отвечает за его безопасность?

Утечки данных через LLM, prompt injection, атаки на модели, неконтролируемые действия ИИ-агентов. Чем глубже ИИ встраивается в процессы компании, тем важнее понимать, как безопасно использовать его в реальной инфраструктуре.

🔊 9 ноября в Центре непрерывного образования НИУ ВШЭ стартует программа повышения квалификации «Стратегия безопасности искусственного интеллекта», созданная совместно с Центром искусственного интеллекта MWS AI.

За месяц участники разберут архитектуру и уязвимости ИИ-систем, защиту данных, классы атак, безопасность LLM, мониторинг инцидентов и регуляторные риски.

Отдельный фокус — как переводить ИИ-риски на язык бизнеса: оценивать возможный ущерб, определять ответственность, формировать бюджет и собирать дорожную карту безопасности. 📎 В финале участники подготовят собственную стратегию и защитят её перед индустриальными экспертами.

Программу ведут специалисты MWS AI и эксперты по технологическому бизнесу и безопасности.


Курс рассчитан на специалистов по информационной безопасности, риск-менеджеров, ML-инженеров, архитекторов данных и комплаенс.

📌 Старт: 9 ноября
💻 Онлайн + очная защита проекта в офисе MWS AI
🎓 Удостоверение о повышении квалификации НИУ ВШЭ

Подробнее о программе и поступлении ⬇️


✏️ Как ИИ помогает быстрее разбираться в аналитике?

Очистить выгрузку, посчитать метрики, построить графики, найти аномалии, написать формулу, SQL-запрос или Python-код — сегодня ИИ уже может заметно ускорить многие этапы аналитической работы.


24 сентября на бесплатном вебинаре покажем это на живом примере: от сырой выгрузки до понятного отчёта с метриками, графиками и гипотезами.

Отдельно разберём, где ИИ ошибается в числах, как это заметить и что обязательно перепроверять, прежде чем использовать результат в работе.

🔹 Спикер — Маргарита Бурова, эксперт, академический руководитель программы «Аналитик данных», руководитель EdTech-программ по Data Science и аналитике в Wildberries.

Вебинар проходит в рамках курса «Промпт-инженерия: нейросети для человека», где участники учатся использовать нейросети для рабочих задач: от создания контента и работы с информацией до аналитики, отчётов и автоматизации.

🔹 24 сентября, 17:30
🔹 60 минут
🔹 Онлайн, бесплатно


​ 📊 Как устроено обучение на аналитика данных: 9 ключевых блоков

14 октября стартует программа профессиональной переподготовки «Аналитик данных». За 12 месяцев участники пройдут путь от основ статистики и программирования до продуктовой аналитики, машинного обучения и работы с хранилищами данных.

Программа подойдёт:

🔹 начинающим: научим базовой статистике, программированию и работе с данными;
🔹 аналитикам: будет полезно расширить инструментарий и перейти к более сложным задачам;
🔹 разработчикам: покажем, как применять технические навыки для анализа данных и решения бизнес-задач.

В программе 9 ключевых блоков:

🔹 Python
🔹 SQL
🔹 математика и прикладная статистика
🔹 A/B-тестирование
🔹 Business Intelligence
🔹 машинное обучение
🔹 продуктовая аналитика
🔹 устройство хранилищ данных (DWH)
🔹 финальный проект на основе практической бизнес-задачи

Занятия ведут преподаватели Факультета компьютерных наук и специалисты из индустрии: Wildberries, Ozon Tech, Яндекса, Магнита, Okko, ivi и других компаний.


Так участники не только осваивают инструменты, но и понимают, как они применяются в реальных задачах аналитика.

⚙ Старт: 14 октября
⚙ Продолжительность: 12 месяцев
⚙ Диплом о профессиональной переподготовке

Если вам важно не просто освоить отдельный инструмент, а сформировать системную базу для работы аналитиком данных, присоединяйтесь к новому потоку.

Подробнее о программе ⬇️


🎁 Делимся бесплатным курсом от нашей команды

Если вы только начинаете программировать или пока не очень уверенно работаете с Git, делимся бесплатным курсом Центра непрерывного образования НИУ ВШЭ.

За 5 уроков разберёте базовые сценарии работы с системой контроля версий:

🔹 как создать и настроить репозиторий;
🔹 как работать с коммитами и удалённым репозиторием;
🔹 как отменять изменения и возвращаться к нужной версии;
🔹 как работать с ветками;
🔹 чем отличаются merge и rebase и как объединять изменения.

Курс проходит асинхронно, поэтому начать можно в любой момент и заниматься в своём темпе. Внутри: видео, лонгриды, практика и задания для самостоятельной работы.

💻 Онлайн
⚙ Бесплатно
📎 Можно начать в любое время

Присоединиться к курсу ⬅️


🏆 Преподаватели ЦНО — среди лучших

НИУ ВШЭ опубликовала список лучших преподавателей 2025–2026 учебного года. Среди 49 лауреатов ФКН — десять преподавателей и экспертов, которые вели программы Центра непрерывного образования:

Марк Блуменау, Маргарита Бурова, Мария Горденко, Елена Кантонистова, Максим Карпов, Ян Пиле, Мурат Хажгериев, Иван Копылов, Андрей Боревский, Михаил Гущин ❤️

При выборе лучших учитывались оценки студентов, мнение выпускников и результаты конкурса научно-исследовательских работ студентов.


Для нас особенно ценно, что слушатели ЦНО могут учиться у специалистов, которые не только глубоко знают свою область, но и умеют передавать знания так, что это отмечают сами студенты.

Поздравляем коллег и гордимся, что вы с нами! ⭐️


⌨ От данных до автоматизации: осваиваем Python

Собрать данные с нескольких сайтов, привести таблицу в порядок, посчитать показатели, построить график, а через неделю повторить всё заново. Многие такие задачи можно автоматизировать с помощью Python.

Ровно через месяц, 14 октября, стартует курс «Язык программирования Python для анализа данных» в ЦНО ФКН НИУ ВШЭ.
Курс подойдёт в том числе новичкам: начнём с основ Python и постепенно перейдём к задачам, с которыми можно столкнуться в работе с данными.

За 9 недель разберём, как:

🔹 собирать данные с веб-страниц и работать с API;
🔹 обрабатывать и анализировать данные с pandas и NumPy;
🔹 визуализировать результаты;
🔹 работать с SQL и базами данных;
🔹 автоматизировать повторяющиеся задачи;
🔹 создавать Telegram-ботов.

Python изучается не ради программирования как такового, а как инструмент для решения практических задач с данными и автоматизации работы.

🔵 Старт: 14 октября
💻 Онлайн
⏳ 9 недель

До старта остался месяц. Самое время познакомиться с Python или наконец систематизировать то, что уже знаете.


🎙 Кажется, что база данных тормозит: 7 мест, где искать проблему

Ответ сервиса занимал 100 мс, а теперь приходит через несколько секунд. Первая мысль: базе не хватает ресурсов. Но увеличение CPU и памяти помогает не всегда. Причина может быть в запросе, индексе, блокировке или даже за пределами базы данных.

Разберём, что проверить в первую очередь.

1️⃣ А проблема точно в базе?

Пользователь ждал ответа пять секунд, а SQL выполнялся 70 мс. Остальное время могло уйти на сеть, бизнес-логику, внешний API или ожидание свободного соединения.

Поэтому сначала сравните общее время ответа со временем выполнения запросов к БД.

2️⃣ Не хватает подходящего индекса

SELECT *
FROM orders
WHERE user_id = 14253;

Без подходящего индекса СУБД может просматривать значительную часть таблицы. Но сам по себе индекс не гарантирует ускорения: всё зависит от размера таблицы, распределения данных и условий запроса.

Создавать индексы на каждый столбец тоже не стоит. Они занимают место и добавляют работу при INSERT, UPDATE и DELETE.

3️⃣ Запрос обрабатывает слишком много данных

JOIN, ORDER BY, GROUP BY и агрегатные функции сами по себе не являются проблемой. Сложности начинаются, когда запрос читает слишком много строк, выполняет повторные сканирования или переносит сортировку и агрегацию на диск.

Посмотреть план выполнения поможет:

EXPLAIN
SELECT ...;

Чтобы увидеть фактическое время и количество строк, можно использовать EXPLAIN ANALYZE. Но важно помнить: он действительно выполняет запрос.

4️⃣ Приложение попало в N+1

Сначала приложение получает 100 пользователей, а затем отдельно запрашивает заказы для каждого из них. В результате вместо одного или двух запросов база получает 101.

На больших объёмах это увеличивает нагрузку и время ответа. Возможные решения: JOIN, пакетные запросы или предусмотренная ORM предварительная загрузка данных.

5️⃣ Запросы ждут друг друга

Одна транзакция удерживает блокировку, а другие запросы ожидают её освобождения. Особенно опасны долгие транзакции, которые удерживают конфликтующие блокировки.

Проверяйте заблокированные запросы, время ожидания и длительность открытых транзакций.

6️⃣ Закончились свободные соединения

Если пул соединений полностью занят, приложение ждёт свободное соединение и ещё не отправляет SQL в базу. Сам запрос может выполняться за миллисекунды, но пользователь всё равно получает ответ с задержкой.

Проверьте размер пула, количество активных соединений, длительность их использования и время ожидания.

7️⃣ Изменились объём данных или план выполнения

Запрос, который быстро работал на 100 тысячах строк, может замедлиться на 100 миллионах. Кроме самого объёма данных, на производительность влияют распределение значений, актуальность статистики и выбранный план выполнения.

Могут понадобиться пересмотр индексов, оптимизация запроса, обновление статистики, архивирование или партиционирование. Но сначала нужно подтвердить причину измерениями.

🔎 С чего начать диагностику?

Метрики всей цепочки → статистика и логи медленных запросов → ожидания и блокировки → пул соединений → CPU, RAM и I/O → план конкретного SQL-запроса.

Не начинайте сразу с решения: «добавим индекс», «перепишем запрос» или «дадим больше памяти». Медленная работа системы — это симптом. Задача инженера сначала поставить диагноз.


🔎 Короткий курс или профессиональная переподготовка?

Научиться делать выгрузки из базы и перейти в аналитику данных — разные задачи. В первом случае может хватить курса по SQL. Во втором понадобится разобраться, какие данные нужны, как их обработать, проверить гипотезу и объяснить результат.

Поэтому выбирать обучение стоит не по принципу «короче или длиннее», а по своей цели.

🔹 Нужен конкретный навык

Вы уже понимаете свою работу, но хотите освоить новый инструмент: строить дашборды, автоматизировать расчёты или увереннее проводить A/B-тесты.

Короткий курс помогает сосредоточиться на нужной теме. Проходить большую программу ради одного пробела необязательно.

🔹 Нужно освоить новое направление

Вы хотите перейти в аналитику, Data Science или инженерию данных. Или уже работаете в этой области, но пока можете выполнять только отдельные задачи и хотите брать на себя более сложные проекты.

Здесь важно не просто выучить ещё один инструмент, а связать знания в систему и научиться применять их вместе. Для такой цели стоит рассмотреть профессиональную переподготовку.

В ЦНО ФКН НИУ ВШЭ программы объединяют базовую подготовку, профильные инструменты и практические задачи. Например, в аналитике SQL и Python изучают вместе со статистикой, продуктовыми метриками и визуализацией: от получения данных до выводов для бизнеса.


Итоговый проект помогает применить знания из разных блоков программы в одной комплексной задаче, с обратной связью от преподавателей. Это может быть собственный пайплайн обработки данных или решение практической бизнес-задачи, которое можно включить в портфолио.

Четыре программы стартуют этой осенью:

🔵 5 октября · Инженер данных
🔵 14 октября · Аналитик данных
🔵 9 ноября · Специалист по науке о данных (Data Science)
🔵 20 ноября · Практический анализ данных

Начните с результата: что вы хотите уметь делать после обучения? Затем посмотрите, какие знания и практика нужны, чтобы к нему прийти.

Учебные планы, форматы занятий и условия поступления — по кнопкам ниже ⬇️


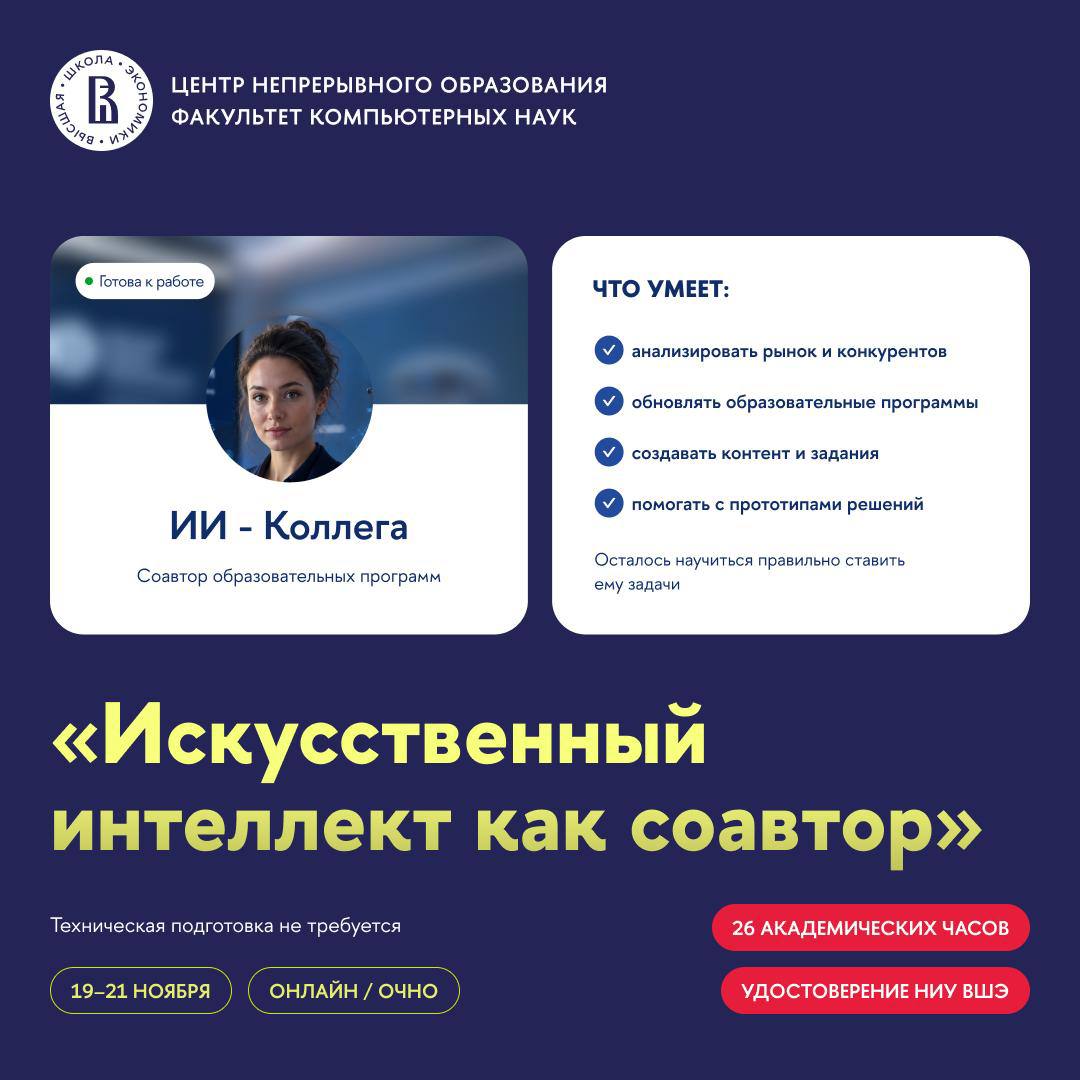
Представьте, что в вашей команде появился новый коллега — ИИ 😳

Он может проанализировать рынок и конкурентов, помочь обновить образовательную программу, подготовить контент и задания, а ещё взять на себя часть работы образовательного ментора.

Но, как и любому новому коллеге, ему нужно правильно ставить задачи и понимать, какую часть работы действительно стоит ему делегировать…


Этому посвящена программа повышения квалификации НИУ ВШЭ «Искусственный интеллект как соавтор: разработка востребованных программ обучения взрослых».

⬇️ За три дня участники познакомятся с практиками применения генеративного ИИ в образовании и разработают прототип решения для собственной рабочей задачи.

Первые два дня пройдут в рамках Форума ДПО «Код компетенций будущего», а третий будет полностью посвящён практическому интенсиву.

📅 Когда: 19–21 ноября
🖥 Онлайн: 25 000 ₽
📍 Очно: Москва, Покровский бульвар, 11 — 30 000 ₽
⏳ Продолжительность: 26 академических часов

Программа подойдёт руководителям и менеджерам образовательных проектов, методистам, преподавателям, специалистам корпоративного обучения и цифровизации образования.

Подробнее о программе ⬇️


ИИ-лидеры: бизнес-лаборатория для руководителей dan repost
🔎 Об ИИ для бизнеса напрямую с экспертами

Как устроено обучение? Какие темы и инструменты разбираются на программе? Подойдёт ли она под ваши задачи и опыт?


Задать эти и другие вопросы можно на бесплатных онлайн-консультациях с авторами программы ФКН НИУ ВШЭ «ИИ-лидеры: бизнес-лаборатория для руководителей».

На встрече можно подробнее узнать о программе, получить индивидуальные рекомендации по обучению и обсудить интересующие вопросы напрямую с экспертами.

⭐️ 9 сентября, 11:00–12:00

Евгений Соколов — соавтор и эксперт программы, руководитель Департамента больших данных и информационного поиска ФКН НИУ ВШЭ, лауреат Yandex ML Prize.

⭐️ 16 сентября, 10:00–11:00

Сергей Юдин — соавтор и эксперт программы, технический директор направления профессиональных ИИ-сервисов Яндекса, преподаватель ФКН НИУ ВШЭ.

↗️ 16 сентября будет возможность взглянуть на «ИИ-лидеров» глазами участника программы. Поговорим о реальном опыте обучения: что оказалось самым ценным, что уже пригодилось в работе и какие ожидания от программы совпали с реальностью.

Встречи проходят онлайн. При регистрации можно заранее оставить свой вопрос экспертам.


#мероприятия_ИИ

@aileadershse


💎 Об ИИ для бизнеса напрямую с экспертами

9 и 16 сентября пройдут бесплатные онлайн-консультации с авторами программы «ИИ-лидеры: бизнес-лаборатория для руководителей».


Можно задать вопросы о программе, подробнее узнать о содержании обучения и получить индивидуальные рекомендации от экспертов.

А 16 сентября к встрече присоединится участник программы и поделится своим опытом обучения изнутри.

Все подробности и регистрация в посте ниже ⬇️


💻 Запускаем свою нейросеть: LLM уровня ChatGPT прямо в браузере

Делимся записью вебинара о том, как самостоятельно запустить открытую языковую модель в Google Colab и начать работать с ней без подписки на коммерческие сервисы и собственного мощного GPU.


На вебинаре разбираем:

▫️ чем открытые LLM отличаются от закрытых моделей
▫️ как выбрать модель с учётом доступных вычислительных ресурсов
▫️ как запустить Qwen через Hugging Face Transformers
▫️ зачем нужна квантизация и как она снижает требования модели к памяти
▫️ как управлять генерацией с помощью системного промпта, температуры и других параметров

🎙 Спикер: Марк Блуменау, преподаватель ФКН НИУ ВШЭ, специалист в области машинного и глубинного обучения, лучший преподаватель НИУ ВШЭ 2025 года.

Смотреть 👈


❔ Почему нейросеть понимает вас не с первого раза?

Часто проблема не в самой модели, а в том, какую задачу она получила. «Напиши пост» и «напиши пост для Telegram на 1000 знаков для аудитории начинающих аналитиков» — для нейросети две совершенно разные инструкции.


Чтобы получать более предсказуемый результат, в запросе полезно зафиксировать хотя бы четыре вещи:

⭐ Контекст — что модели нужно знать перед выполнением задачи
⭐ Задачу — что именно нужно сделать
⭐ Ограничения — чего избегать и какие условия соблюдать
⭐ Формат — каким должен быть готовый результат

А дальше начинается самое интересное: промптинг можно использовать не только для генерации текста. Нейросети уже помогают собирать презентации, анализировать данные и аудиторию, создавать визуалы, автоматизировать отчёты и выстраивать многошаговые сценарии с AI-агентами.

📁 Именно с практической стороны работу с ИИ начинаем разбирать сегодня на программе ЦНО ФКН НИУ ВШЭ «Промпт-инженерия: нейросети для человека».

Если хотели присоединиться, но не успели к первому занятию, это не проблема: набор открыт до конца недели, а запись первой встречи будет доступна участникам.

Так что начать можно чуть позже — и ничего не пропустить ⬇️

20 ta oxirgi post ko‘rsatilgan.