дата инженеретта


Kanal geosi va tili: Rossiya, Ruscha


мелкое — крупно,
в глубоком разговоре
мудрость приходит
по вопросам сюда: @aigul_sea

Bog‘liq kanallar  |  O‘xshash kanallar
Kanal geosi va tili
Rossiya, Ruscha
Statistika
Postlar filtri


Lance

Недавно ковырялась в инструменте для обслуживания таблиц Apache Amoro и наткнулась на новый для меня термин - формат данных Lance

Lance - это колоночный формат хранения данных, созданный для AI/ML задач в лейкхаусе

⏰ Он появился еще в 2022 году, а первая стабильная версия вышла в декабре 2025. Примерно с того же времени нашла дискуссии в де сообществе. Разрабатывают ребята, которые создали LanceDB

Главные особенности:
🤩оптимизация под AI и векторный поиск
🤩доступ к данным за О(1)
🤩в одной таблице можно хранить обычные данные + медиа + векторы
🤩ядро написано на Rust
🤩построен поверх Apache Arrow
🤩time travel
🤩acid
🤩update/delete так же поддерживается

Lance позиционирует себя как замена Parquet, но к данным можно достучаться в 100 раз быстрее

Поддерживается много интеграций: DuckDB, Polars, Data Fusion, Spark, Doris, Trino, PyTorch, Flink. Но, например, Lance-Trino интеграция вышла из беты только 31 марта этого года, а Spark появился еще позднее, поэтому многие компоненты еще достаточно свежие

А помимо Lance, еще есть Nimble, Vortex, BtrBlocks, FastLanes😯

@data_engineerette


5 октября начнется 19-й поток программы Data Engineer от Newprolab

Программа для junior- и middle-дата-инженеров, аналитиков, backend-разработчиков, техлидов и тех, кто работает с data-командами и хочет лучше понимать современный стек DE

📌 Что внутри:
– 10 недель обучения
– 30 занятий: онлайн + записи
– 10 практических лабораторных работ
– облачный кластер и реальные данные
– чат участников и поддержка команды программы

📌 Что получите на выходе:
1. Научитесь решать типовые задачи DE на практике
2. Систематизируете знания и закроете пробелы в современном DE-стеке
3. Поработаете с реальными данными и инфраструктурой, а не только с учебными примерами
4. Соберете практический опыт, который можно обсуждать на собеседованиях и использовать в работе
5. Все записи и материалы останутся у вас после окончания программы

Преподаватели – практикующие специалисты из ведущих технологических компаний. На занятиях можно разбирать реальные кейсы, задавать вопросы и получать обратную связь

👉 Подробности и квиз – на сайте

Квиз покажет, насколько программа подходит именно под вашу роль и задачи, даст персональные рекомендации и промокод на скидку
___
По всем вопросам пишите Алексею @snitsa

Реклама. НОЧУ ДПО «НЬЮПРОЛАБ», ИНН 7729461098, erid: CQH36pWzJqVKq9rQaHuCzeGVyN7t33BtnXkZHE54vj73iv


Как прошла SmartData 2026?

Я вот перечитываю свои впечатления от прошлого года и понимаю, что в этом году было совсем не так🥲 Вижу, что писала про

Текущее состояние рынка даты
Presto/Trino + K8s + S3, Iceberg, StarRocks, Polars - движется сюда


А в этом году не было ни одного доклада про StarRocks или Polars

📚 Доклады

Конфу объединили с DS/ML, поэтому значительная часть докладов сразу отсеклась. Часть была супер нишевой: про китайский CubeFS, внутрянку pgvector, утечки памяти на контроллерах😫

Поэтому лично мне понравились всего 2 доклада:

1️⃣"Витрины данных на Data Lakehouse: маленькая история про большой переезд с Greenplum", Лемана Тех

Очень крутой чел рассказал про миграцию с Greenplum на dbt с yaml дагогенерацией, сэндбоксы, настройку ролевки, мониторинга, обслуживания. Пока они перенесли совсем немного и такое ощущение, что с многими проблемами просто не столкнулись

Вывод такой: витрины собираются дольше, функционала компонентов DLH не хватает, проблем и вопросов больше, чем решений и ответов

2️⃣"Контракты данных: когда схема становится договором", Uzum Market

Практически весь доклад мне казалось, что они живут в сказочном мире с единорогами и розовыми пони, настолько так все классно работает. На самом деле очень прикольно: сначала заводятся контракты данных, потом генерятся DDL, конфиги развертывания, автоматически разворачиваются кафка-топики, выставляются MR. DQ, Lineage - тоже все есть

На дискуссия была жесткая заруба по поводу ломающих изменений в контракте

Мне от спикера так понравились две фразы, пусть они тут останутся:

россыпь SDK
data quality ассорти


❓ Что по AI?

Опишите красиво ваши метрики и данные, сделайте семантический слой - и будет классный контекст для ваших агентов (база)

📍 Новости и ссылочки

Статья: How Anthropic enables self-service data analytics with Claude
Дэш из доклада про ADBC (Arrow Database Connectivity)
Яндекс вписался в разработку китайского Greenplum - Cloudberry, в который они добавили поддержку Iceberg
Одни ребята переехали на StarRocks уже в 2023 году
В Магните в июне были сокращения
Мысль - сейчас многие делают статичные AI-дэши, а что если навайбкодить BI, который реальными запросами ходит в данные?
21.10.2026 выходит DuckDB 2.0
AWS купили DuckLabs

@data_engineerette


Исследование data-people

Тут ребята из DevCrowd запустили ежегодное исследование специалистов по работе с данными и попросили поделиться, чтобы охватить больше крутых спецов😎😎

Отчеты у них получаются очень красивошные💅 Вот здесь можете глянуть за прошлый год: https://devcrowd.ru/ds25/

📒 Если не знакомы: DevCrowd делают независимые исследования IT-профессий уже несколько лет, за это время опросили больше 15 000 человек, отчеты выкладывают в открытый доступ

В этом году они смотрят на самое актуальное: что AI реально изменил в работе, где проходят границы в обязанностях между ролями, изменились ли наборы инструментов и задачи

✏️Опрос анонимный и займет 12–15 минут. В ноябре ребята опубликуют отчет со всеми данными, а также списками рекомендованных телеграм-каналов и курсов, собранными из ответов участников

Опрос тут: https://survey.devcrowd.ru/data-2026

@data_engineerette


Каким должен быть хороший DE?

Меня однажды спросили на собесе:

🤩Какие 3 качества важны для де?

В том числе:
🤩абстрактные качества, которые помогают в работе
🤩собственные качества, сильные стороны
🤩качества кандидата при собеседовании к вам в команду

Тогда я сильно замялась, потому что никогда мне такого вопроса не задавали и он прям заставил задуматься)) По-моему, я сказала что-то вроде:
🤩широкий кругозор, чтобы можно было критически оценивать и предлагать технические решения
🤩желание разобраться в проблеме и найти причину, поковыряться в логах, выяснить, почему упало
🤩третье я капитально забыла🙂

А как бы вы ответили на этот вопрос?

@data_engineerette


Mermaid-диаграммы

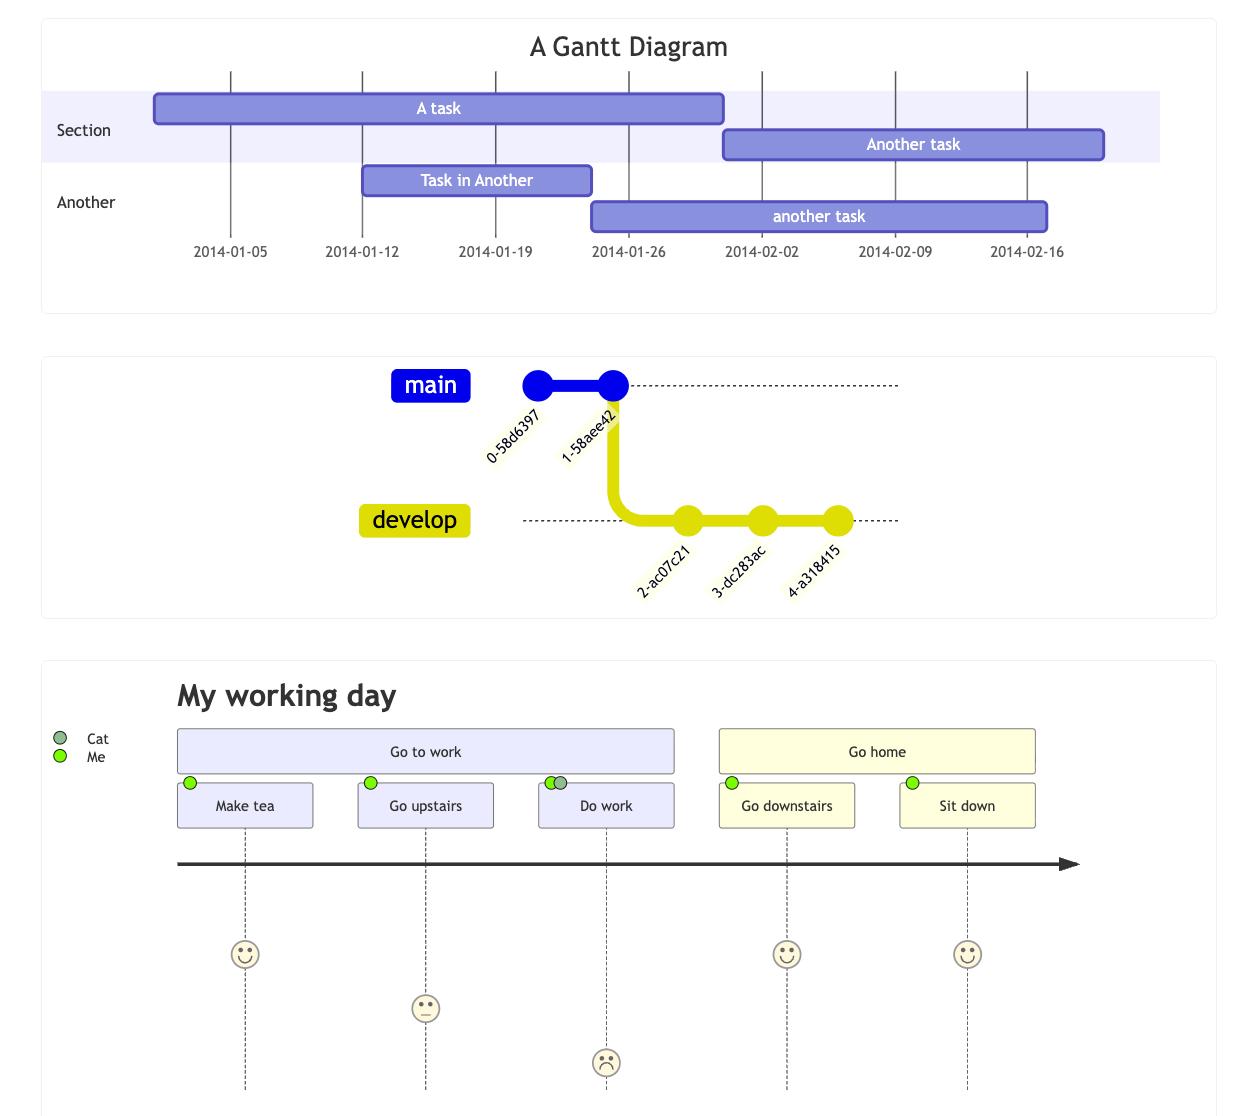
Наконец-то дошли руки поковыряться в mermaid-диаграммах, это что за имба вообще🔥🔥По сути это своего рода DaaS - Diagram as a Code, вы описываете диаграмму в нужном синтаксисе, потом она отрисовывается

Я полистала, что mermaid умеет вообще рисовать - там из прикольного: очень красивая диаграмма Ганта, граф с гит-коммитами, диаграмма Cynefin для принятия решений. Ну и всякие UML-ки, ER там тоже есть

Диаграммы имеют особый синтаксис, например, для ER-модели связи обозначаются вот так:


|o - 0/1
|| - 1
}o - >= 0
}| - >= 1

Напоминает корейский алфавит🇰🇷 А если нарисовать связь между двумя сущностями, то вообще получаются какие-то смайлики:


}o..o{
||--o{
|o--o{

В общем, удобная и полезная штука - не нужно рисовать самому в draw.io или где-то еще, оно само красиво отрендерится💅

@data_engineerette

2k 0 17 10 13

Iceberg — это внезапный бум или планомерная подготовка?

Заметили, как с определенного момента стало много айсберга в DE? Хотя я сейчас зашла чекнуть вакансии на hh, и iceberg упоминается в 68 из 455 дата инженерских вакансий - что около 15%. Но у меня есть стойкое ощущение, что все про него говорят, всем он нужен и везде его используют

🐱 Последний раз я обращала на это внимание в марте. Тогда мне казалось, что компании только-только переходят на лейкхаус и начали строить его 1 или 2 года назад. Но на самом деле это было гораздо раньше

Недавно я узнала, что в Т-банке развитие в сторону лейкхауса началось еще тогда, когда меня не было в де🥺 Да и MWS не смогли бы выкатить свою лейкхаус-платформу в середине 2025 года, если бы не стартовали еще тогда

☕️ Мы в Сбере тоже обсуждали табличные форматы, но мне казалось это таким нишевым и далеким от индустрии, поэтому я особо не изучала всякие айсберги/худи/дельты и отличия одного от другого. А ведь в то же самое время все остальные уже готовились...

🌱🌱🌱🌱

Так что получается, мы узнаем о технологическом тренде, когда другие уже презентовали свои результаты раньше всех. И теперь мне интересно: что прямо сейчас кажется нишевой штукой, на которую мы не особо обращаем внимание, но через год оно будет везде?

@data_engineerette


Как забытый ON CLUSTER поставил меня в тупик

Я создала таблицу ReplicatedReplacingMergeTree, потом переделала на обычный ReplicatedMergeTree. Дропнула таблицы, но тупо забыла ON CLUSTER, и вот что из этого вышло

🫤 Запускаю загрузку, она падает, я чищу табличку и гружу заново. Казалось бы, проблемы больше нет? Сверяюсь по каунтам - сильно отличается. Снова перезагружаю - вообще другие каунты стали. Что происходит? Смотрю инфу по репликам:


SELECT hostName(), pid, count()
FROM clusterAllReplicas('default', schema.table)
GROUP BY hostName(), pid
ORDER BY pid, hostName();


На двух хостах сходится, на третьем сильно меньше данных и вообще нет большого куска, при этом все цифры разъезжаются с источником…

Я делаю truncate - а с третьего хоста данные вообще не удаляются. Делаю truncate sync - снова ничего не происходит. SYSTEM SYNC REPLICA schema.table - то же самое

🤔 Иишка советует заглянуть в system.distributed_ddl_queue - но там все Finished. Потом смотрю zookeeper_path:


SELECT
hostName(),
zookeeper_path,
total_replicas,
active_replicas,
last_queue_update_exception
FROM clusterAllReplicas('default', system.replicas)
WHERE database = 'schema'
AND table = 'table';


Первые 2 хоста в одной репликационной группе:

/clickhouse/tables/9e0fe594-04f6-41ad-8137-385f08c2fbe5/shard1
total_replicas = 2

А третья живет отдельно:

/clickhouse/tables/faee8477-d2a6-47c9-8cc9-8a3f44972612/shard1
total_replicas = 1

Дальше смотрю DDL на разных хостах:


SELECT hostName(), create_table_query
FROM clusterAllReplicas('default', system.tables)
WHERE database = 'schema'
AND name = 'table';


Первые две - ReplicatedReplacingMergeTree
Третья - ReplicatedMergeTree

Поверх этих таблиц еще была Distributed, а она читает табличку на основе параметра load_balancing:


SELECT value
FROM system.settings
WHERE name = 'load_balancing';


В моем случае там был random, и он постоянно возвращал данные с третьей реплики (кроме random, есть еще несколько)

А почему данных на третьей реплике было меньше? Все еще помните про самый первый процесс, который упал? Так вот он записал кусок данных, но почистить их кх уже не смог. А при следующем запуске запись пошла в другую реплику

В общем, два забытых слова привели к тотальной смеси двух миров

@data_engineerette

2.5k 0 15 14 23

В начале лета я рассказывала, как начала проходить курс по алгосам, сейчас делюсь с вами промежуточными впечатлениями🙂

👩‍💻 Первый месяц я активно садилась за задачи раз или два в неделю - этого было вполне достаточно. Сам смысл курса подается не как "пока самостоятельно не решите 100 задач на литкоде, из-за компа не выходите", а как "сначала смотрим объяснение и решение, потом идем кодить, если не запомнили - смотрим еще раз и повторяем"

В рамках одного 10-минутного видоса разбирается одна задача, иногда с несколькими вариантами решения, в конце анализируется сложность по времени и памяти. Что я заметила - когда мне голосом объясняют суть задачи, мне становится в разы понятнее. Поэтому мой типичный флоу занятий такой: я смотрю 1-2 минутки с объяснением условия, иду решать сама, потом досматриваю

С какого-то момента действительно появился азарт, хочется решить как можно больше задач до момента усталости) Пока я отметила для себя всего 2 задачки, которые вызвали трудности, и я оценила их по сложности на 5/10 по сравнению со всеми остальными

📊 Для трекинга прогресса нам рекомендовали завести гугл табличку с решенными задачами, затраченным временем и комментами. Я туда еще вписываю свои впечатления по задаче, новые синтаксические конструкции и инсайты после объяснений. Пока из интересного - идея с выделением виртуального места в массиве, иногда полезно идти с конца, также понравился мой собственный подход с просмотром только 1/4 матрицы

📞 Лайв созвоны случаются в конце спринта, где кураторы вместе с учениками разбирают задачи на самостоятельное прорешивание, отвечают на вопросы. Но вопросы можно задавать и в чатике, там все очень активные, периодически кураторы присылают разборы на задачи с собесов

В июле с отпусками я подзабросила курс🤩 В текущем спринте начали темы связных список и стека, но я надеюсь быстренько все догнать

@data_engineerette


Походу салон нанял себе дата аналитика🤭

Или можно подключить аналитику у самого сервиса по записи?

В любом случае я теперь переживаю, что, если не запишусь сейчас, кому-то на дейли придется объяснять просадку retention rate😕

@data_engineerette


Анти чек-лист работы в DE

По ходу жизни собрала список того, что мне не очень нравится в работе. И вот что в него вошло:

1️⃣Канбан

У вас нет пула задач на ближайшее время. К вам могут приходить аналитики и менеджеры с адхоками, которым нужны отчеты еще вчера. Вы не можете спокойно распределить время на свои задачи. В канбане будут всегда прилетать новые задачи, которые нужно взять, как только закончите предыдущую. И вместе с этим постоянное ощущение напряга

2️⃣ Проектная работа

Проекты заканчиваются. Допустим, он длится год, потом вам обещают найти другой. А если проект свернут раньше года? А если другой проект не найдется?

3️⃣ Срочный трудовой договор

Он может быть короче даже самого проекта. А если договор не продлят? Не проще ли сразу найти нормальное место и не жить в страхе от приближения того самого дня?

4️⃣ Ты - единственный DE

Я в такое лезть не пробовала, но внутренне становится некомфортно. Представь, у тебя больше нет DEшной экспертизы в команде. Если не получается - надеешься только на себя (ну и на иишку)

5️⃣ В стеке только 3 инструмента

На рынке де столько всего требуется, как потом красиво преподать свой опыт, когда ты все последнее время писал только SQL и YAML?

6️⃣ Очень сложные задачи

А это я бы назвала другой крайностью 5го пункта) Делать настолько уникальное, что в других местах абсолютно не нужно. Или просто лично для меня непонятное, например, писать заливку данных на Rust

7️⃣ Уникальный стек

Молодец, ты освоишь инструмент, который нигде больше не используется

8️⃣ Нет созвонов

Вот вообще. Хотя бы раз в несколько дней. Просто заканчиваешь одну задачку и берешь следующую. В такие моменты складывается ощущение, что члены команды между собой не общаются. У кого-то такой подход может вызывать лишь восторг) Но для меня общение с коллегами - реально важная часть и чего не хватает на удаленке

9️⃣ Нет чатика с мемами

Это тоже в тему общения с командой и создания более прочных коммуникативных связей

💫💫💫💫💫💫💫💫💫💫💫

Здесь я привела свое субъективное мнение, вы можете поспорить или дополнить своими пунктами🥺

@data_engineerette


Ребят, а тут есть такие, кто идет на дата конфу в Лондоне?

https://www.bigdataldn.com

Она бесплатная, нужно просто прилететь🙂 По темам очень похоже: лейкхаус, AI агенты, data fabric, data governance. И сессии от топовых компаний: Databricks, Microsoft, Google, JetBrains, dbt Labs, Snowflake…

Я вот зарегалась и даже на некоторое время задумалась над подачей визы🤭 Но потом как вспомнила, что ИМЕННО В ЭТИ ДАТЫ у меня конфа в Москве

Так что ищу шпиониро😎

Полную программу конференции можно хотя бы полистать тут

@data_engineerette


пупупу
у меня всего 9 с половиной😚

3k 0 24 11 60

Отгадайте с первой попытки, за какой это было период и что случилось😁😁

@data_engineerette


Сеньорские вопросы

🤵 Чем круче вы становитесь, чем в более highload сторону вы идете, чем быстрее развиваются ллмки, тем вопросики к вам становятся все серьезнее

Собрала для вас подборку таких вопросов по технологиям:

✨ Spark

Из чего состоит executor memory?
Что такое spark.memory.storageFraction?
В чем разница между Sort-Merge Join и Broadcast на маленькой таблице?
Каким образом уменьшить количество шафла?
Зачем нужен data spill?
Как работает AQE?
Какие проблемы спарка в кубере?

🧊Iceberg

Как айсберг работает с параллельным изменением одного файла и нескольких?
Почему при записи из старой таблицы в новую в айсберге джоба бежит очень долго? 
Почему при перекладке в айсберг забивается кэш?
Какие проблемы с айсбергом, кроме maintenance?

🌺 Airflow, Python

Что такое TYPE_CHECKING?
Как добавить шаблонизированное поле, если оператор не поддерживает jinja?
Что такое dynamic task mapping?

🖥 ClickHouse

Если данные писались в одну ноду клика, то при ее падении какие данные будут лежать на остальных?
Какие проблемы с Replacing Merge Tree при вставке 5тб данных?
300 колонок, 8 ключей - в чем проблема такого подхода и как лучше поменять?

🧘Kafka

Как интеграция Spark-Kafka умеет обеспечивать exactly once?
Как будет читать спарк из кафки, если 10 коров, 5 партиций? Сколько будет простаивать экзекьюторов?
Как будет читаться таблица в спарке, если 1ТБ один файл, 20 коров? Сколько будет простаивать экзекьюторов?
Как будут читать 10 инстансов приложения из 5 партиций?

@data_engineerette

4k 0 138 35 46

Всем привет! Возвращаюсь на связь, на прошлой неделе была в отпуске😌

А пока на нашем рынке я такого не видела, но на зарубежном после HR-интервью присылается очень подробное и информативное саммари: о чем говорили, что нужно спросить в следующий раз, ваши плюсы/минусы, соответствие вакансии

@data_engineerette


Кажется, я уработалась😕

Это моя первая мысль, как только я села в такси


Раскрываю тайну

Наверняка у многих был такой момент, что вы заходите в YARN, находите Hive-запрос, хотите в него провалиться, но Tez UI недоступен?

Теперь вы знаете, как он выглядит

@data_engineerette


19 ta oxirgi post ko‘rsatilgan.