


Файнтюнинг LLM можно делать на обычной GPU — вот с чего начать
Вот набор, который реально закрывает почти все задачи:
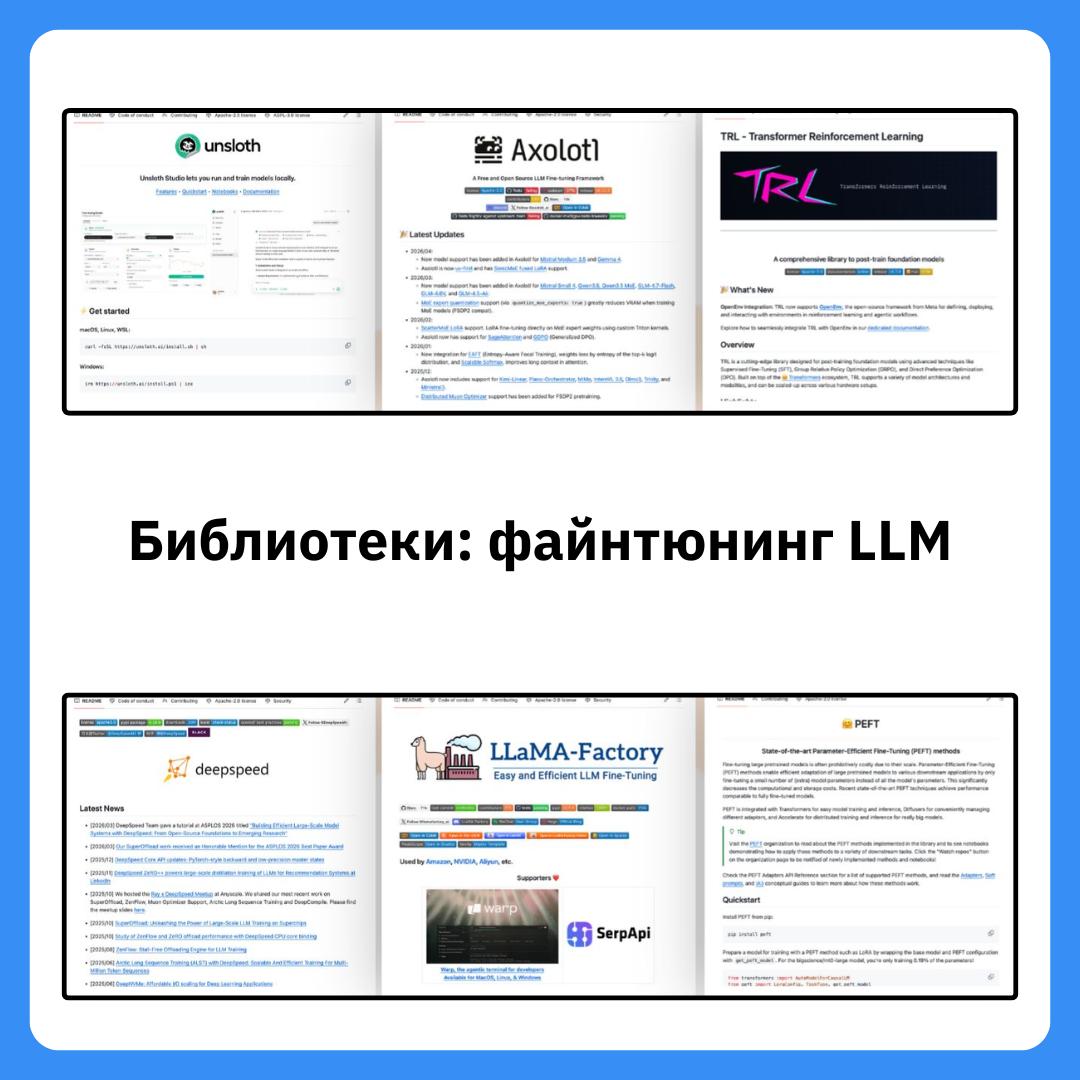
🦥 Unsloth
Ускоряет обучение и заметно снижает требования к памяти. Можно запускать даже в Colab, без мощного GPU.
🏭 LLaMA-Factory
Универсальный комбайн: десятки моделей, WebUI или CLI, поддержка LoRA/QLoRA/DPO — без необходимости писать код с нуля.
⚡ DeepSpeed
Если нужно масштабироваться: несколько GPU, кластеры, оптимизация памяти (ZeRO). Используется в продакшене крупными командами.
🐙 Axolotl
Минимум лишнего: описали конфиг в YAML — получили обученную модель. Один из самых удобных DX сейчас.
🤗 TRL
Библиотека от Hugging Face для пост-тюнинга: SFT, DPO, PPO, GRPO и reward-модели.
🔧 PEFT
Основа всего: LoRA/QLoRA позволяют обучать большие модели на обычном железе и хранить веса в мегабайтах.
📍 Навигация: Вакансии • Задачи • Собесы
Библиотека дата-сайентиста
#буст