ML будни


Kanal geosi va tili: Rossiya, Ruscha
Toifa: ko‘rsatilmagan


Пишу здесь про работу, учебу и немного о своей жизни)
Мой контакт: @leffffffffffff
Мой GitHub: https://github.com/leffff
Мой LinkedIn: https://www.linkedin.com/in/lev-novitskiy-022289261/

Bog‘liq kanallar  |  O‘xshash kanallar

Kanal geosi va tili
Rossiya, Ruscha
Toifa
ko‘rsatilmagan
Statistika
Postlar filtri


AGI?


Институт AIRI dan repost
Объединяем исследователей для обучения ИИ долгосрочному планированию

Владислав Куренков, руководитель научной группы «Адаптивные агенты» Института AIRI, запустил открытое сообщество людей, работающих над системами планирования ИИ, чтобы вместе решить одну из самых неподатливых для искусственного интеллекта игр — NetHack.

У каждого участника будет свой способ получить программу, свои инструменты и своя стратегия, а общая инфраструктура позволит видеть результаты друг друга, сравнивать их между собой и продолжать разрабатывать решения друг друга.

Владислав рассказал, почему NetHack весьма полезна для обучения ИИ:
«Одна партия в NetHack — это десятки тысяч ходов. Жизнь у героя одна, сохранений нет, подземелье каждый раз новое, а игра по дороге ничего не подсказывает. Если вы сыграли плохо, то выясняется это тогда, когда ничего исправить уже нельзя. Когда мы запускаем наших ботов играть, то вторая по частоте причина их "смерти" — голод, потому что они не позаботились о еде за несколько тысяч ходов до финального момента. На таких же ошибках спотыкаются ИИ-агенты, когда пишут код: отдельный шаг они выполняют прекрасно, а на длинную дистанцию держать планку не могут. И NetHack в этом плане становится весьма полезной для обучения ИИ».


📎Подробнее про сообщество, игру и «интеллект» агента — в интервью «Ъ-Науке».


Я в этом году очень мало постил в канал, потому что я делал очень много работы о которой не говорил или рано было говорить.

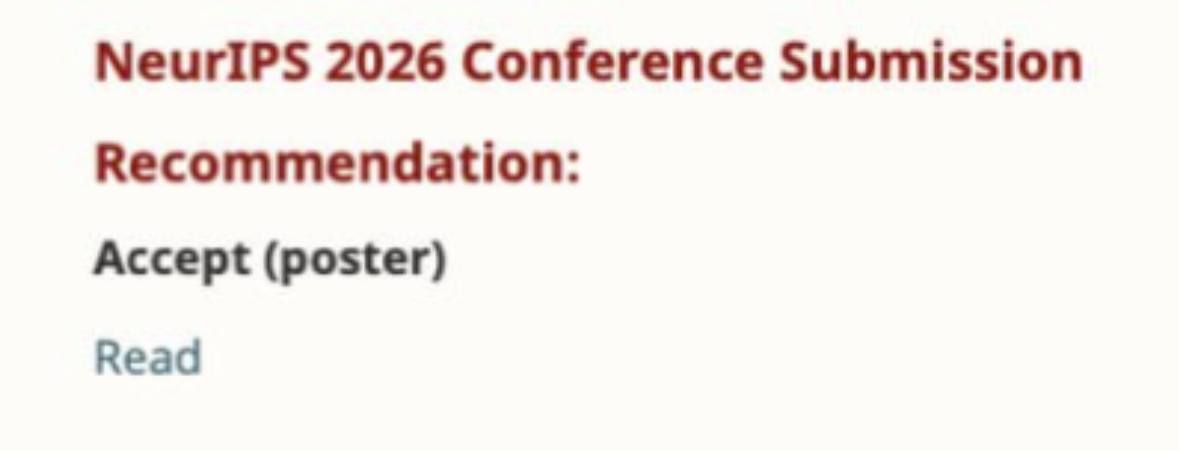
За этот год я поучаствовал в Сколтехе в 3х исследованиям
И мне повезло, что старшим товарищам пришла в голову гениальная идея, по которой мы написали статью!

Буду ждать письма и все расскажу!


Кенгуру трепещите 😈😈😈


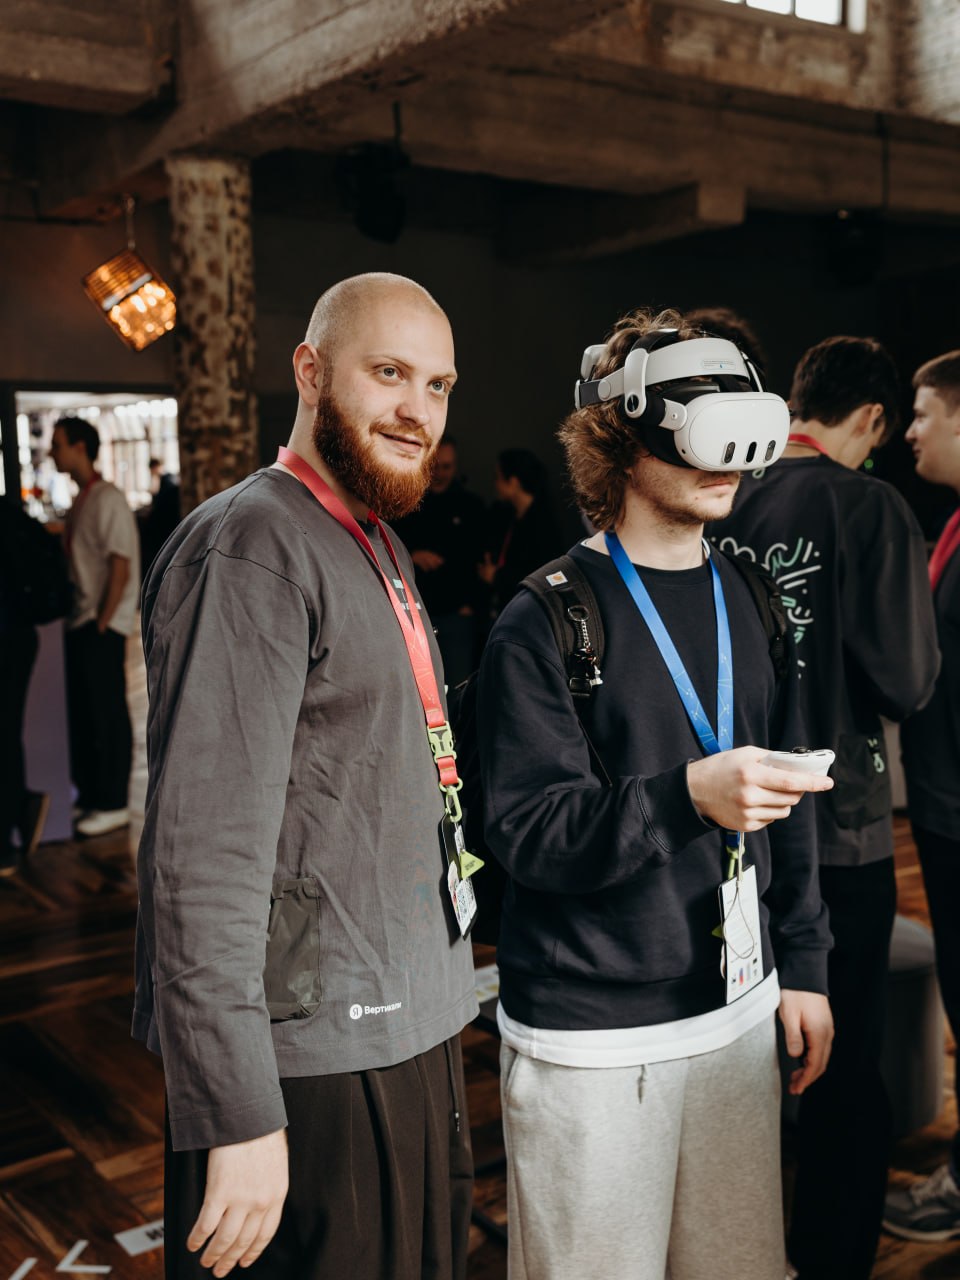
В прошлую субботу побывал на PML и это определенно самое крутое мероприятие на котором я был за год!

Во-первых было много крутых докладов:
* Доклад про DSpark/DFlash от @minimalistic_cheese (11/10)
* Доклад от GigaChat'a про RLHF фреймворк (мне было особенно интересно, тк хочется переносить крутые фишки в диффузию)
* И абсолютно случайно доклад про стриминговый перевод в наушниках (я даже задал 2 вопроса, но потом понял что приза за лучшие вопросы не будет, а я прям выложился там, весь доклад ману копил)

И еще немного фоток:
1) Играю в VR игру угадай стоимость хрущевки
2) Лутаю стикеры
3) Понятно что делаю
4) Тут уже Раша + Чайна = ❤️
5) Пытаюсь вернуть Игоря
6) С друзьями (не захантились (НЛП + Сырки, а у меня ни того ни другого :( ))


Данило - монстр!
Крутое выступление!
Всем советую! За дуплексом будущее!

RnD ML Team dan repost
🎙 Full-duplex voice mode

Наша команда ведет исследования в речевых технологиях, и одна из задач, которую мы решаем — это создание полнодуплексного голосового режима. Это такой класс моделей, которые могут одновременно слушать и говорить, не разбивая диалог на последовательные вызовы.

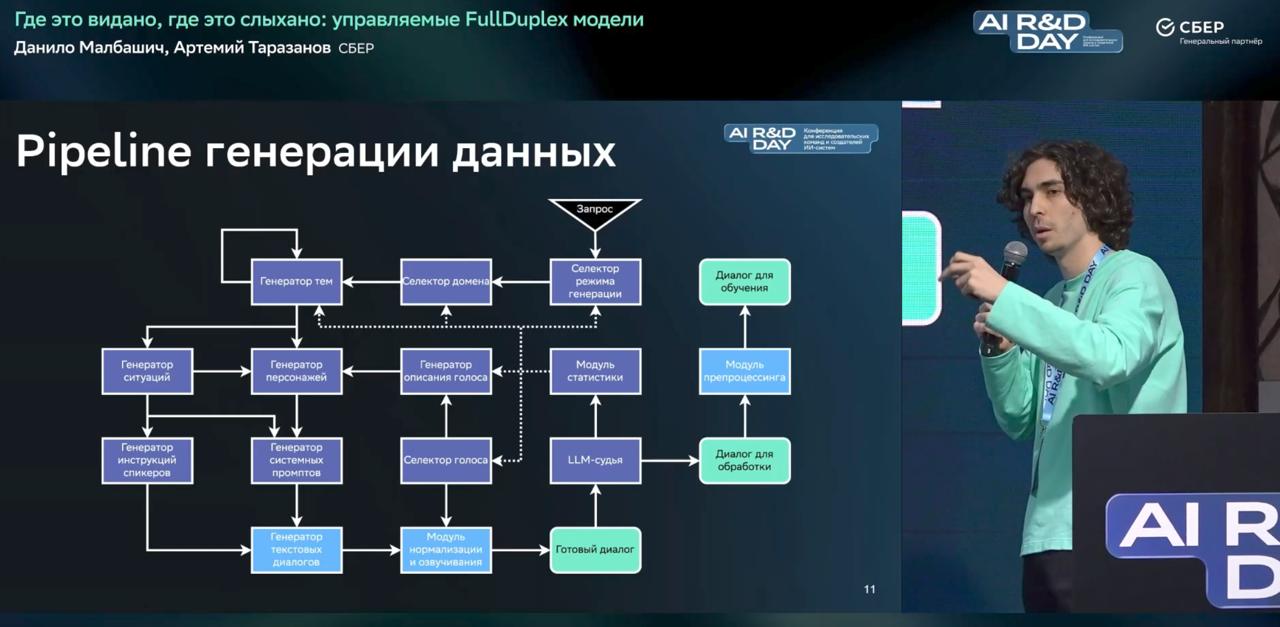
В рамках прошедшей AI RnD Day наши ребята Артемий и Данило рассказали, как это всё устроено и куда движется мир.

📌 TLDR
Классический голосовой ассистент — это каскад ASR → LLM → TTS + VAD. Пользователь говорит, VAD ждёт конец реплики, ASR переводит речь в текст, LLM думает, TTS озвучивает ответ. Задержка у такой системы складывается из нескольких компонент, а диалог с моделью не нативен. Full-duplex устроен иначе: модель может слушать пользователя, говорить, реагировать на перебивания и менять свою реплику прямо во время разговора.

Главный вызов — сделать такую модель не только естественной, но и управляемой: задать ей роль, характер, голос и при этом не потерять качество основной LLM. А в самом продвинутом варианте добавить мультимодальность, ризонинг, тулколинг и прочий "обвес", включая опции для решения VLA-задач в роботах. 🤖

🧭 Откуда всё началось
В 2022-2023 году появились GSLM и AudioLM — работы, показавшие, что речь можно моделировать непосредственно аудио-токенами, без обязательного промежуточного текста.
В 2024 году Moshi от Kyutai сделал следующий шаг — открытая full-duplex модель, которая одновременно слушает и говорит, моделируя аудио пользователя и модели вместе с текстовым внутренним представлением. В начале 2026 появились подходы вроде PersonaPlex от NVIDIA 🖥 (надстройка над Moshi), где к full-duplex добавляется управляемость: текстовый prompt задаёт персонажа, а аудио-референс — голос.

А дальше индустрия начала двигаться к более общему подходу: разделению реалтайм взаимодействия и мышления на части. Эту идею, в частности, развивает Thinking Machines, стартап Миры Мурати.

⚙️ Что не так с обычным Full-duplex
Исходная модель действительно умеет разговаривать, но для продукта этого недостаточно: каждый запуск с новым голосом, персонаж и манера речи не фиксированы, нельзя задать бизнес-роль ассистента. И самое важное: модель "тупеет" при улучшении качества речи, и наоборот, а компромиссного варианта нет.
.
🧠 Thinker + Duplex Talker
Чтобы не заставлять одну модель делать всё сразу, мы перешли к тандемной архитектуре. Thinker — большая LLM, которая отвечает за содержание и сложный ризонинг. Duplex Talker — лёгкая RQ-трансформерная "говорилка", работающая в full-duplex режиме. Talker продолжает слушать и говорить в реалтайме, а Thinker своевременно подсказывает, что стоит сказать.

Ключевой момент — обмен идёт в общем текстовом домене. Благодаря этому основную LLM можно менять независимо от голосового слоя.

🔚 Выводы
Тандем Thinker + Duplex Talker позволяет разделить задачи и сохранить главное преимущество full-duplex-систем — realtime-взаимодействие без возврата к классическому каскаду. А в конечном счёте, он расширяется до нативной омнимодальности со всей мощью ризонинга, тулколинга и действий в среде.

🔗 Более подробно смотрите в презентации ребят (оставим в комментариях файлом) и в записи выступления (6:29 тайминг).

#speech #voice #fullduplex #paperwatch


Al Talent Hub dan repost
📺 #ОткрытаяЛекция: почему нейросети генерируют видео так долго?

Чем быстрее работает видеомодель, тем чаще страдает результат. Но команда Kandinsky нашла способ ускорить генерацию в разы и при этом получить модель лучше учителя.


Как? Расскажем уже на следующей неделе на Открытой лекции, где практики делятся реальным опытом.

30 июля в 18:00

Лев Новицкий — руководитель направления по исследованию данных в Сбере, расскажет и покажет:

⭐ Почему видео от нейросетей генерируются так долго — и можно ли это ускорить, не потеряв в качестве?
⭐ Какие способы ускорения вообще существуют — и почему большинство из них жертвуют качеством ради скорости?
⭐ Как раньше в Kandinsky ускоряли модель — и что в этом подходе не устраивало?

🎙«Расскажу, как мы смогли ускорить генерацию видео в Kandinsky в разы и при этом получить модель, которая обошла по качеству своего учителя. Как всё устроено внутри, что сработало, а что нет — без лишней теории, на реальном опыте команды».


🔗 ЗАРЕГИСТРИРОВАТЬСЯ

🔥 — хочу больше таких тем

@AITalentHubNews
#ITMO #NapoleonIT


А поч я так раньше не делал


Я проплыл 3км кролем! Несколько раз хотел сдаться, но не сдался и наконец проплыл! Очень довольный


13 ta oxirgi post ko‘rsatilgan.