Нескучный Data Science


Kanal geosi va tili: Rossiya, Ruscha


Рассказываю как применять AI на практике
ex. Managing AI Director at Sber,
👨‍💻ex. Head of ML LAB at Alfa
https://www.linkedin.com/in/smirnov-evgeny/
По вопросам сотрудничества @datascience_assist
Регистрации в Роскомнадзор № 5278866657

Зарегистрирован в РКН
Bog‘liq kanallar  |  O‘xshash kanallar

Kanal geosi va tili
Rossiya, Ruscha
Statistika
Postlar filtri


Video oldindan ko‘rish uchun mavjud emas
Telegram'da ko‘rish
🤖 Как дать AI-агенту кошелёк и не уехать в тюрьму

Посмотрел второй выпуск «ПРОДАКТовой корзины» и поймал себя на мысли: мы слишком долго обсуждали, умеет ли AI нормально отвечать на вопросы. Теперь пора решать, можно ли давать ему деньги.

В выпуске разбирают AI-поиск, научные эксперименты с участием нейросетей, персональные цены, роботакси, магазины-склады и кошельки для агентов.

Ведёт шоу стендап-комик Сева Ловкачёв, а вместе с ним новости обсуждают:

— Артём Петренко, CPO «Магнит Плюс»;

— Александра Прокшина, руководитель Security Development в «Авито»;

— Антон Сачков, CTO MAGNIT OMNI;

— Даниил Гаврилов, руководитель научной лаборатории T-Банк AI Research и специалист по LLM.

Больше всего мне запомнилось обсуждение кошельков для AI-агентов. Агенту предлагают выделить ограниченный бюджет, чтобы он самостоятельно покупал API, MCP-инструменты и контент.

Разговор довольно быстро дошёл до идеи сказать агенту: «Братан, теперь содержи себя сам». А затем — до агентского сетевого маркетинга, сомнительных схем и вопроса, кто понесёт ответственность, если автономный помощник решит зарабатывать наиболее маржинальным способом 😅

Не менее интересным получился спор о персональных ценах.

Предложить конкретному человеку скидку — звучит как забота. Показать ему цену выше, потому что модель поняла, что он готов заплатить, — уже как повод возненавидеть продукт. Хотя данные и модель могут быть теми же: меняется только бизнес-правило.

В итоге получился нормальный разговор о технологиях без восторгов в стиле «AI завтра изменит всё». Здесь пытаются разобраться, где уже появляется реальный продукт, а где пока есть только громкая новость и красивая презентация.

Смотреть выпуск:
🎞 YouTube:
😄 VK Видео:


💩 Как улучшить F1-micro и насрать рекламодателю — в прямом смысле

Вас тоже бесит, когда вы ищете один товар, а рекламный алгоритм настойчиво подсовывает совсем другой? Обычно мы видим эту проблему со стороны пользователя. А сейчас покажу, как она выглядит со стороны рекламодателя, которому алгоритм привёл совсем не тех пользователей.

В @mirabistro нет-нет да заходят люди исключительно ради туалета. Мы находимся в центре, пешеходный трафик огромный. Я думал, что это неизбежные издержки локации. Туалет у нас — комплиментарная услуга для гостей.

👀 Неделю назад сижу в бистро и наблюдаю: заходит человек и сразу направляется в туалет.

У этого сегмента, кстати, есть устойчивый поведенческий паттерн. Они закрывают не только дверь туалета, но и дверь в зону с раковиной. Как будто пришли не руки помыть, а помыться целиком.

Через минуту заходит второй.

Два одинаковых события подряд меня уже насторожили.

💡 И тут меня осенило: дело в таргетинге.

📈 Недавно я купил продвижение в одном картографическом сервисе. Как аналитик, первым делом полез смотреть, как люди находят бистро и по каким запросам переходят в карточку.

Среди запросов был «туалет», хотя мы вообще-то кафе.

Давайте разберёмся, что пошло не так при обучении поискового алгоритма. Достоверно я этого не знаю, но с большой вероятностью — всё было именно так.

1️⃣ Поставили цель на квартал выбить XX% по F1-micro.
2️⃣ В датасет поискового движка долили запросы про туалеты.
3️⃣ Кафе, в которых есть туалет, разметили как релевантные ответы — то есть на уровне таргета фактически приравняли кафе к туалету.
4️⃣ При micro-усреднении все true positive складываются в общую копилку, поэтому новая категория помогла вытянуть итоговый F1

Классический случай: офлайн-метрику оптимизировали, заборы успешно покрасили, менеджеры получили бонусы, а на рекламодателей оказалось насрать — в прямом смысле слова, но хотя бы чужими силами.

😆 Публиковать статистику сервиса я не хотел, но 8% туалетного трафика это уже не смешно.


Как научиться предсказывать что угодно? 🔮

На видео спикер рассказывает, что его команда научилась за три дня до расставания предсказывать, что девушка бросит парня.

Когда я впервые увидел это в трансляции, то понял только часть проблемы: спикер вообще не шарит, а команда решает странные задачи и пилит такие же фичи 😅 Тогда моего руководительского опыта не хватило, чтобы задуматься о процессах внутри компании — меня просто поразил уровень абсурда.

Причём настолько, что эта история догнала меня даже спустя семь лет.

Но сейчас, когда я строю собственную компанию, меня гораздо больше беспокоит другой вопрос: какие процессы внутри компании привели к тому, что топ-менеджмент рассказывает об этом на конференции как об успешном кейсе? 🤔

Начнём с самого кейса.

Пока я не пересмотрел видео, у меня были разные гипотезы о том, как они собрали целевую переменную:

— может быть, провели опрос?
— спарсили социальные сети?
— а как тогда собрали хард-негативные сэмплы?

Но нет.

Судя по видео, аналитики придумали сегмент на основе набора косвенных признаков.

С какой точностью этот сегмент отражал реальность?

Правильно: никто не знает 🙃

Дальше, вероятно, построили модель, которая научилась предсказывать эту синтетическую целевую переменную.

И здесь появляется ещё один уровень неопределённости.

Сначала мы с неизвестной точностью восстанавливаем целевую переменную по косвенным признакам. Затем с некоторой точностью обучаем модель предсказывать уже эту восстановленную переменную.

То есть модель предсказывает не само расставание, а предположение аналитиков о расставании.

На ошибку при создании таргета накладывается ошибка самой модели. Поэтому итоговое качество относительно реального события становится ещё менее понятным 🎯

Следующий вопрос: как проверяли лики?

Не протекли ли в модель те же признаки, на основе которых изначально восстановили целевую переменную? 🫠

Ну и самое интересное: как измерили эффект?

Никак.

Модель встроили в рекомендательную систему, в которой, судя по рассказу, нет прозрачно рассчитанного финансового эффекта 💸

Итак, рецепт, как научиться предсказывать что угодно:

1. Конструируете целевую переменную с неизвестной точностью.
2. Обучаете модель предсказывать этот синтетический таргет.
3. Получаете два слоя ошибки: в разметке и в самой модели.
4. Встраиваете модель в продукт, где невозможно оценить её эффект в деньгах.
5. Рассказываете об успешном кейсе на конференции.
6. Готово — вы великолепны! 🚀

Всё это звучит смешно ровно до того момента, пока вам самим не приходится собирать такие фантастические сегменты и обучать на них модели.

Напишите в комментариях, если знаете достоверный источник данных для такого сегмента. Особенно интересно, где взять качественные хард-негативные сэмплы 👇


Конференция, на которой точно не соскучишься🎙️

26 сентября Яндекс празднует 10-летие Data Driven, и празднует с размахом: доклады про AI-first-аналитику, стенды с экспертами, Random Coffee с топовыми аналитиками, а вечером — афтерпати с музыкой, закусками и IT stand-up от аналитиков про наболевшее.

Из докладов особенно ждём: Роман Халкечев расскажет о том, как AI переписывает правила игры при работе с данными, Артём Солоухин покажет MARS — первую мультиагентную рабочую среду Яндекса, а Максим Стаценко поделится, как собрать агента-аналитика, которому можно доверять, — с конкретными шагами.

Москва + онлайн💻, 26 сентября.

Мест офлайн немного — регистрируйтесь по ссылке

Новости конференции


🎙 Мини-интервью с руководителем ML-департамента рисков в Яндекс Финтехе

Владимир Ершов — ex. Visa, Сбер и Alfa-Bank, выпускник МГИМО и IE Business School.

Четыре интересных факта про героя интервью:

1️⃣ Пришёл в ML из экономики: после МГИМО выбрал магистрату по Big Data в испанской IE Business School.
2️⃣ Успел поработать во всех ML-направлениях бизнес-группы Персональных сервисов Яндекса.
3️⃣ Сейчас его команда отвечает за порядка 50 моделей для Сплита, кредитной карты, кредита наличными и B2B-кредитования.
4️⃣ Практически не пишет код уже четыре года, но иногда сам ревьюит самые важные куски.

👉 Подробнее — на карточках.

Ставьте 🔥, если хотите больше интервью с ML-руководителями. Вопросы Владимиру оставляйте в комментариях 👇

#мини_интервью


🤣 Как за год заработать банку 50 тысяч

👼 После того как я стал руководителем, мне хотелось решить как можно больше задач силами своей команды. Мы умели работать с текстами, и эту экспертизу хотелось применить в продуктах банка.

📈 Одна такая задача нашлась в инвестиционном продукте. Новости без категорий было неудобно читать. По крайней мере, так казалось мне — человеку, который умел их классифицировать. Решение выглядело очевидным: давайте сделаем классификатор. Я убедил бизнес, собрал первую модель и передал её джуну на доработку. Мы разметили данные, улучшили качество и показали результат заказчику. Тексты хорошо раскладывались по категориям, заказчик был доволен — договорились внедрять в мобильное приложение.

🗓️ А дальше приложение переделывали, команда менялась, приоритеты уезжали. Так прошёл год.

🎉 Наконец классификатор внедрили, запустили A/B-тест и ещё через месяц подвели итоги. Оказалось, что он приносит банку 50 тысяч рублей в месяц — примерно зарплату джуна, который его допиливал.

🤦‍♂️ Где мы облажались?

- Не спросили, какую продуктовую метрику хотим изменить, за счёт чего и насколько. Мы просто решили, что категоризированные новости — это хорошо.

- Заранее не договорились, как будем измерять эффект. В итоге продакт что-то как-то протестировал, а мы что-то как-то посчитали.

Этот печальный опыт усилил мою аллергию на внедрение технологий по мотивам русских сказок: «Пойди туда, не знаю куда. Внедри затем, не знаю зачем». После этой истории у меня закончился нейросетевой недотрах. 😅

🎯 Прежде чем делать модель, ответьте на два вопроса: какой бизнес-эффект она должна дать и как вы его измерите. До продакшена классификатор мы довезли. До бизнес-эффекта — нет.

А как думаете вы, почему классификатор удалось внедрить только через год? Пишите свои версии в комментариях 👇


✈️ Альфа оплатит до 20 000 рублей на обеды состоятельным сотрудникам Сбера

🍽 У премиальных клиентов Альфа-Банка есть привилегия: банк компенсирует еду в ресторанах российских аэропортов.

Чтобы не заключать договор с каждым заведением вручную, Альфа подключила дата-сайентистов 👨‍💻 Как рассказали в статье на РБК, алгоритм анализирует карточные операции, сопоставляет их с координатами терминалов и определяет, прошла ли покупка на территории аэропорта.

📱 Подходящие операции автоматически появляются в приложении. Загружать чек обычно не нужно, хотя банк оставляет за собой право запросить билет или подтверждение покупки. Запомним этот момент)

Но недавно у алгоритма обнаружился интересный побочный эффект 😅

Ресторан в офисе Сбера на одном из верхних этажей определяется как ресторан в аэропорту. Возможно, терминалу присвоили неправильные координаты. Возможно, подвели исходные данные. А может быть, ресторан просто оказался слишком близко к небу ☁️

В итоге премиальные клиенты Альфы могут компенсировать там обычные рабочие обеды — как будто едят перед вылетом 🛫

💸 За один чек можно вернуть до 5 000 рублей. При остатках свыше 12 млн рублей количество визитов не ограничено, но действует общий лимит компенсации ресторанов — 20 000 рублей в месяц.

Работаешь в Сбере, держишь деньги в Альфе, а обеды в Сбере оплачивает Альфа. Получается не просто выгодно, а Альфа-Выгодно ❤️

😅😅😅 Если вы работаете в Сбере и соответствуете условиям премиального обслуживания, оформляйте карту Альфа-Банка, пока дата сайентисты в Альфе не исправили баг

А теперь два вопроса:

1️⃣ Технический: какую метрику или алерт вы бы поставили на мониторинг, чтобы быстро выявлять случаи неправильной геопривязки терминалов?

2️⃣ Бизнесовый: как бы вы поступили на месте Альфы — закрыли бы лазейку и исключили ошибочно привязанные терминалы или превратили бы баг в PR-ход для привлечения клиентов с крупными остатками?

👇 Пишите свои варианты в комментариях.


🐍 Как сделать автоматизацию поддержки 100% одной фразой

🎤 В 2018 году в одной крупной компании проходила презентация чат-бота. Команда защищала метрику автоматизации.

Один из топ-менеджеров выслушал доклад и сказал:

— Я знаю, как одной фразой довести вашу автоматизацию до 100%.

📊 В 2020 году уже в другой крупной компании топ-менеджера уволили за то, что он слишком успешно растил автоматизацию.

Автоматизацию растили. Топ-менеджера сократили. Баланс всё-таки нашёлся — просто не там.

🤖 В 2026 году помощь понадобилась одному AI-директору. Он обратился во внутренний хелпдеск, но ответа не получил: годом ранее компания успешно выполнила цели по внедрению AI и сократила поддержку.

AI внедрили. Помогать стало некому.

Когда-то я уже выпускал статью о том, как сделать контактный центр автономным. Похоже, кто-то воспринял слово «автономный» слишком буквально: теперь контактный центр не зависит ни от операторов, ни от обращений, ни от необходимости кому-то отвечать.

Что общего у этих историй?

У метрики автоматизации есть неприятная особенность: она не умеет отличать ситуацию «клиенту помогли» от ситуации «клиент не смог ни до кого достучаться». В обоих случаях оператор не понадобился.

Поэтому автоматизацию нельзя растить без второй метрики, которая показывает, не стало ли клиентам хуже. Иначе вместе с автоматизацией можно незаметно вырастить отток, а повторные покупки и кросс-продажи — так же незаметно сократить.

🐍 Говорят, на змею не действует собственный яд. Но в этой истории в конце концов подействовал. Правда, это был яд других гадюк.

💬 А теперь вопрос: какая одна фраза может сделать автоматизацию чат-бота 100%?

Пишите свои версии в комментариях 👇


BigData Team (BDT) dan repost
🚀 50 грантов Tech Orda: специализация AI Agents Engineer

Уникальная возможность для граждан РК от 18 до 45 лет:
1. Получить грант 400 000 ₸ от государства на обучение в IT;
2. С вероятностью 60+% достичь карьерных целей в ближайшие 6 месяцев при обучении с BigData Team.

📌 Как подать заявку? До 6 сентября:
1. Нажать "подать заявку" на портале Astana Hub
2. Зарегистрироваться и пройти тестирование на Learn BDT
3. Подписаться на наш Telegram, чтобы не пропустить новости.
Результаты отбора — на почту; анонсы — здесь.

Особенности 2026

1️⃣ Конечно же ИИ (Agentic Coding и AI Agents)
Не банальный prompt engineering, а фундаментальная база: tools, skills, MCP, окружения (*code*, *claw) или harness. Управление памятью (context, memory, fine-tuning vs RAG, embeddings vs Zettelkasten) и качеством (MAS, ralph-loop, evals, понимание LLMs).

2️⃣ Стоимость
Разработали программу доступную каждому:
— стоимость программы (level 1): 595 000 ₸
— грант Tech Orda: 400 000 ₸
— остаток: 195 000 ₸. Если поделить на 6 месяцев обучения:
🔥 32 500 ₸/месяц

3️⃣ Аналитика зарплат и выпускников от Astana Hub
По нашим выпускникам программы Tech Orda в Казахстане:
— 44% пришли без профильного ИКТ-образования
— 61% достигли карьерных успехов уже в период обучения
💰 1+ млн ₸ средняя зарплата выпускника
Откуда цифры — из налоговой (но анонимно). Подробности читайте в гайде по Data-профессиям.

📌 Ключевая информация
В AI-native эпоху в IT профессии базовых навыков Computer Science уже недостаточно — важно уметь ускорять процессы разработки и аналитики в десятки раз с помощью автономных ИИ-агентов, не теряя контроля над кодовой базой и архитектурой. В 2026 году мы трансформировали программу BDMLE в новый стандарт — AI Agents Engineer (AIE).

🗓 Старт обучения: сентябрь–октябрь
▶️ Видео о школе и программе (10 минут)
🔄 Волны отбора
— I волна — до 23 августа, 23:59 🔥
— II волна — до 30 августа, 23:59
— III волна — до 6 сентября, 23:59

Last, but not least

Поспешите! (почему)

📩 Вопросы: личка, комментарии или techorda@bigdatateam.org
🤗 Лайк и репост — у кого-то из ваших знакомых сейчас закроется вопрос "а на что учиться".

BigData Team: the way you learn best
AI Agents | Py4BDA | Python | Machine Learning | Big Data

#study #BigDataTeam #TechOrda #AstanaHub #BDMLE #AIE


🤣 Яндекс сам себя забанил

Помните, я писал, как Тинькофф защитил меня от собственного спама?

Похоже, тг-боты Яндекса это прочитали, решили повторить успех и применили тот же подход к рекламе.

🍽 Хотел купить рекламу для @mirabistro на Яндекс Картах. Написал в чат-бот поддержки. Бот объяснил, что нужно отправить письмо на указанный им адрес, добавить номер телефона и логин — всё сделал по инструкции.

✉️ Причём для надёжности отправлял письмо из Яндекс Почты на аккаунт Яндекса. Текст — практически тот же, который предложил бот.

🛡 Но письмо не ушло: Яндекс решил, что оно похоже на спам, и временно заблокировал отправку.

Итого: бот Яндекса написал инструкцию, я ей последовал, а другой бот Яндекса защитил Яндекс от покупки рекламы в Яндексе.

Вот она — настоящая сквозная автоматизация бизнес-процессов 😅

P.S. @yandex свяжитесь со мной)


🧠 10 бит в секунду, или Почему люди тупые

Когда я учился в университете, мой сосед любил повторять:

— Люди тупые. В том числе и я.

Вторая часть фразы нравилась мне гораздо больше первой. В ней была полезная мысль: свои когнитивные ограничения лучше учитывать заранее, а не обнаруживать постфактум.

💾 Позже я попал к научному руководителю, у которого одновременно со мной было ещё несколько десятков студентов. Он честно предупреждал:

— Женя, я обещаю, что забуду всё, о чём мы сегодня говорили.

Он просто хорошо понимал ограничения собственной памяти и не делал вид, что способен удержать в голове всё.

🔬 Ещё в 1952 году психолог Уильям Хик оценил скорость обработки информации в задачах выбора примерно в 5 бит в секунду. Спустя семь десятилетий исследователи из Caltech проанализировали самые разные виды человеческой деятельности — от чтения и печати до игр и запоминания — и получили величину того же порядка: около 10 бит в секунду, или 1,25 байта.

⚠️ Это не скорость всего мозга. Сенсорные и двигательные системы работают значительно быстрее. Скорее, речь об узком канале, через который информация превращается в осознанный выбор и контролируемое действие.


🤔 Отсюда простой вывод.

Если вы задали человеку сложный вопрос, а через секунду получили уверенный ответ, возможны три варианта:

1. Перед вами гений.
2. Человек уже долго думал об этом раньше.
3. Он озвучил первое, что пришло в голову.

Чаще, чем нам хотелось бы, срабатывает третий вариант.

🤖 Для GPT мы специально включаем thinking mode и соглашаемся немного подождать. А от человека почему-то ожидаем качественного решения немедленно — желательно прямо на созвоне, между двумя уведомлениями и вопросом «ну что тут вообще думать?».

Но человеку тоже можно включить thinking mode.

📝 Поэтому сложные вопросы лучше задавать заранее, а важные договорённости — записывать. И не стоит путать скорость ответа с качеством мышления.

🗂 Кажется, единственный выход с учётом наших ограничений — учиться структурировать знания и сохранять их так, чтобы потом быстро находить. Такая внешняя память медленнее оперативной, но гораздо быстрее, чем каждый раз вспоминать или придумывать всё заново.

🛡 И тут начинается самое интересное: если мы понимаем ограничения естественного интеллекта, становится понятнее, как работают некоторые виды атак на него — и как от них защищаться.

Возможно, об этом поговорим в следующих постах.


Конференция Ozon Tech, уже успевшая заслужить высокоранговую славу, обещает и в этом году собрать много интересного для тех, кто работает с ML&DS. Программа E-CODE 2026 еще пополняется, но трек уже выглядит вполне серьезно: сложный индустриальный ML, генеративные подсказки, уровни дообучения и агентский Cotype.

Такое нам определенно надо. Еще и участие бесплатное - осталось только зарегистрироваться: https://ecode.ozon.tech/

Ну и в рамках соблюдения work-life balance вечерком прям там же можно и под «Хлеб» с «Нейромонахом Феофаном» отжечь 😅


ИИ крадёт у нас или учится у нас? 🧠

Недавно сидел на панельной дискуссии. Во время вопросов из зала прозвучало примерно следующее:

— Как быть с тем, что ИИ будет обучаться на наших данных? Как защитить то уникальное, на создание чего человек потратил столько времени?

Но тут возникает неудобный вопрос: а в чём именно заключается эта уникальность?

Я люблю сравнивать работу ИИ с ЕИ — естественным интеллектом. Такое сравнение помогает лучше замечать некоторые паттерны человеческого мышления и обучения.

Так вот: ЕИ тоже учится на чужих данных 📚

Человек читает книги, слушает преподавателей, разбирает чужие работы, наблюдает за другими людьми и запоминает удачные решения.

В творческих профессиях это называют насмотренностью и начитанностью. А затем человек комбинирует знания и приёмы, придуманные до него, — и создаёт нечто, что мы считаем уникальным.

Даже гены в некотором смысле можно рассматривать как накопленный поколениями опыт 🧬

Это, конечно, не обучение в обычном смысле, а результат эволюционного отбора. Но принцип сохранения успешных решений здесь тоже просматривается.

Поэтому мне немного странно слышать от ЕИ, что ИИ обязательно что-то у него «украдёт». Ведь ИИ обучается на созданном людьми примерно так же, как сам человек когда-то учился на наследии предыдущих поколений.

Возможно, главное, чему ИИ пока не научился, — это вкус 🎨

Не просто способность скомбинировать знакомые элементы, а умение почувствовать: что действительно стоит создавать, зачем и для кого.

Хотя и вкус, если честно, тоже формируется не в вакууме.

На фото мы с Радославом @girafe_ai — довольные тем, что обсудили эту тему и поняли друг друга с полуслова 🤝

💬 Как думаете, что на этом изображении создано с ИИ?


Как понять по письму, что задача не выполнена? 📨

За годы работы в крупных компаниях мне пришлось прочитать очень много писем. Иногда их приходит до сотни в день. Поэтому навыки анализа данных приходится применять и здесь.

Представьте: вы поставили кому-то задачу, подошёл срок — и вам присылают отчёт. Это может быть один абзац, а может быть целый лист А4. Вы читаете про процесс, коллег, сложности и то, как все героически преодолевали препятствия. Первый абзац, второй, третий… Очень интересно. Все явно вспотели 😅

Письмо заканчивается, а вы так и не поняли: задача выполнена или нет? 😅

Чем выше вы поднимаетесь в компании, тем сильнее вас интересуют две вещи: какой результат получен и сколько пользы он принёс бизнесу в рублях 💰

Письма с результатом обычно короткие:

✅ «Задача выполнена. Конверсия выросла с X до Y. Эффект для компании — N миллионов рублей».

Но даже если письмо длинное, при наличии результата о нём напишут в первом абзаце. В крайнем случае — в последнем.

Поэтому длинные письма можно читать по простому алгоритму 🔍: сначала первый абзац, затем последний. Если ответа нет ни там ни там, скорее всего, внутри будут процесс, сложности и оправдания.

А если вам сложно писать короткие и ёмкие тексты, советую прочитать книгу «Пиши, сокращай: Как создавать сильные тексты» 📘 Она хорошо учит убирать лишнее и сразу доносить главную мысль.

Конечно, бывают исключения. Но в классификации статусных писем и отчётов длина письма — топ-фича 🎯 Если результата нет в первом или последнем абзаце, с большой вероятностью его нет. Более того, если такие письма вам приходят постоянно от одного и того же оправителя, то результат можно вовсе не ждать.


Rad’s ai dan repost
На конференциях только и разговоров, что об агентах.

Вообще, я бы назвал это harness'ами. Они могут приносить кучу пользы, и их огромное количество: Claude Code, Codex, pi, Hermes, OpenClaw, Cursor, Muse Code...

Хорошая новость в том, что под капотом +- одни и те же механизимы, и если в них разобраться, почти не важно, какой harness у вас под рукой.

Поэтому проведу в понедельник, 10 августа в 18:30 открытый вебинар «Агенты без магии».

Разберём:
* как правильно ставить задачи агенту
* что такое скиллы, MCP и зачем они нужны
* в чем разница с пайплайнами, и почему для повторяемых задач они лучше подходят (например, n8n)

И с теорией, и с примерами. Свои подписки не требуются (но точно не будут лишними :) )


Участие, как и в предыдущий раз, свободное. Но нужно будет заполнить формочку (чтобы я знал, сколько вас будет).

А если есть вопросы или кейсы, которые хочется разобрать – пишите в комментарии.


А для тех, кто хочет глубоко погрузиться в ИИ и стать магистром AI ☕️ – у нас целая программа в МФТИ есть, с которой успешно выпустилось пять потоков. Онлайн, на английском, совместимо с работой, в небольшой группе. Подача документов через Госуслуги до 11 августа, вам достаточно оставить заявку, дальше мы проведем по шагам. Присоединяйтесь!


P.s. Долго думал, какие аналогии провести, получилось вот такое:
Claude Code – для храбрых
Codex – для спокойных
Goose – для желающих пропатчить KDE2 под FreeBSD
Hermes – для отаку
pi – 🐭


❓ Научитесь отвечать на вопрос «зачем?», прежде чем ставить задачу ИИ

Моё знакомство с Codex началось, когда появилась вполне конкретная задача: собрать сайт для @mirabistro.

Сайты я делал и раньше — первый написал на PHP ещё в восьмом классе. Но никогда не вайбкодил и относился к этому довольно скептически. Несмотря на десять лет работы в анализе данных, мне казалось, что нормальный рабочий продукт всё равно придётся долго собирать руками. А тратить время на проект без понятной цели я не хотел.

🌐 Здесь наконец появилась конкретная цель. К тому же все «эксперты по ИИ» в соцсетях уже рассказывали, что теперь такие вещи можно собрать чуть ли не за один вечер. Я решил проверить — и сайт действительно получился. Напишите в комментариях, как он вам 👇

После этого я начал вайбкодить почти каждый день. 😁

Но именно тогда я понял главное: когда ИИ позволяет очень быстро собрать практически любой MVP, становится особенно важным ещё до начала работы ответить на вопрос: «зачем?»

🏠 Недавно у меня появилась новая «задача».

Дома стоит старый видеодомофон Tantos. У него есть приложение vhOme, которое работает довольно медленно, не присылало уведомления о звонках на iPhone и просто не нравилось мне визуально.

Приложения под Android я тоже писал — как вы помните. Правда, это было ещё в 2014 году. И самое смешное, что vhOme выглядело примерно так же, как мои приложения того времени. Но у меня хотя бы не было дизайнера. Точнее, дизайнер был — я сам 😅

Я такой:

— Сейчас сделаю своё приложение.

📱 Закинул в Codex APK Android-приложения. Он разобрал его, вытащил используемые методы, нашёл механизмы подключения к домофону и получения видеопотока. Ещё немного — и можно было начинать писать полноценное приложение под iOS.

Можно было упороться окончательно: сделать системный экран входящего звонка, после ответа сразу открывать видео, добавить две кнопки — «Открыть» и «Не открывать», оформить аккаунт разработчика и попробовать выложить всё это в App Store.

В целом многие приложения теперь действительно можно допиливать и переделывать под себя. Если есть работающий клиент, ИИ способен исследовать его поведение, разобраться с протоколами и собрать свое решение.
В итоге я потратил несколько часов на исследование vhOme.

🤔 Но перед тем, как переходить к полноценной разработке и публикации в App Store, я всё-таки остановился и задумался: а точно ли эту задачу нужно решать таким сложным способом? Нет ли чего-то проще?

И главное: зачем мне вообще собственное приложение?

Мне было нужно не приложение само по себе. Мне было нужно не пропустить звонок в дверь.

🔔 А потом выяснилось, что проблема была не в домофоне: пришлось поиграться с режимами «Фокусирование» на iPhone и правильно настроить допуск уведомлений.

После этого они начали приходить.

Собственное приложение с быстрым переходом к видео и двумя кнопками всё ещё было бы удобнее. Но когда пуш уже работает, потенциальный аплифт от разработки резко снижается.

🎓 Если, конечно, перед вами не стоит образовательная цель. Тогда ответ на вопрос «зачем?» тоже есть: разобраться в чужом приложении, исследовать протоколы и научиться собирать собственные продукты под iOS. В этом случае само исследование уже становится результатом.

🤔 Но изменилось ли что-то с появлением вайбкодинга?

В вопросе целеполагания — ничего. Ведь и раньше существовало огромное количество бесполезных стартапов, научных статей и корпоративных проектов, которые пятый год подряд делают одно и то же второй раз.

ИИ не решает проблему целеполагания. Он помогает быстрее написать код и дешевле проверить гипотезу, но не способен решить за вас, какой результат действительно нужен и стоит ли вообще браться за проект.

🎯 Поэтому главный навык сейчас — умение отвечать на вопрос «зачем?».

Так было всегда: на вопрос «зачем?» должен уметь отвечать заказчик и любой руководитель, который несёт ответственность за результат. Но теперь, когда вы ставите задачу ИИ и с его помощью пишете код, вы тоже становитесь руководителем — как минимум собственного проекта.

А значит, теперь и вам нужно уметь отвечать на главный вопрос:

«зачем?»

3.1k 1 13 10 35

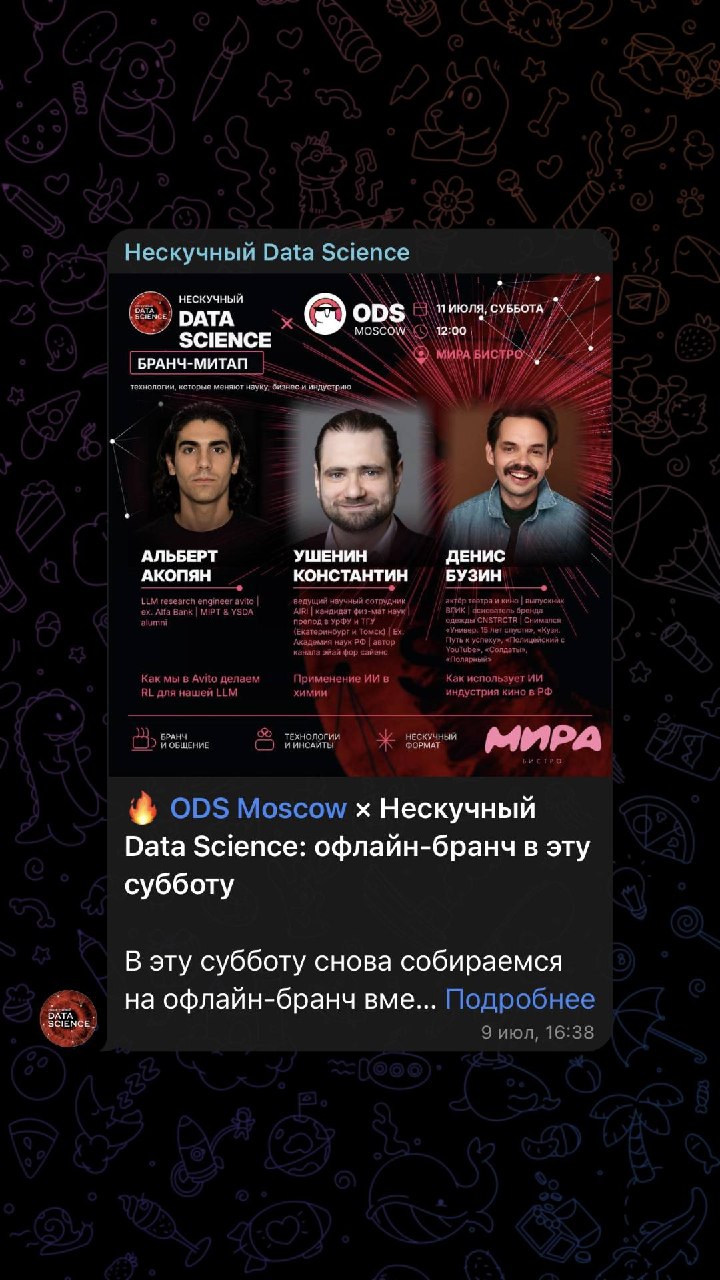
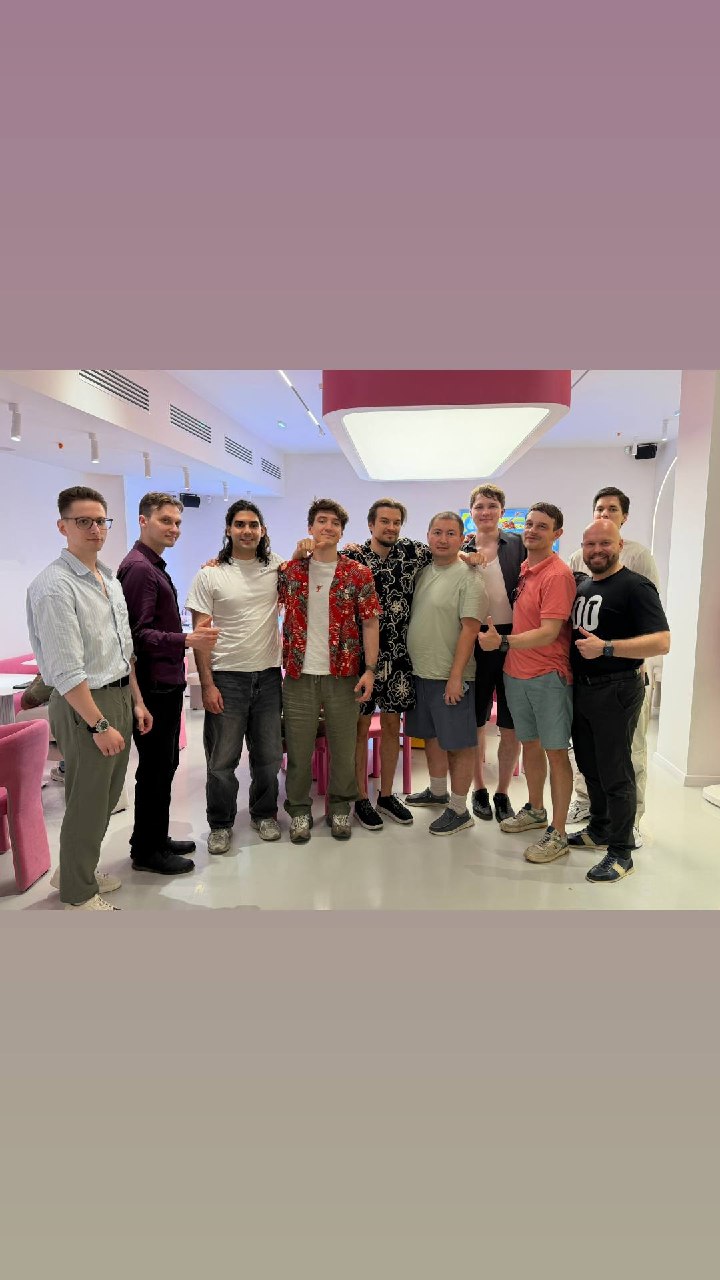
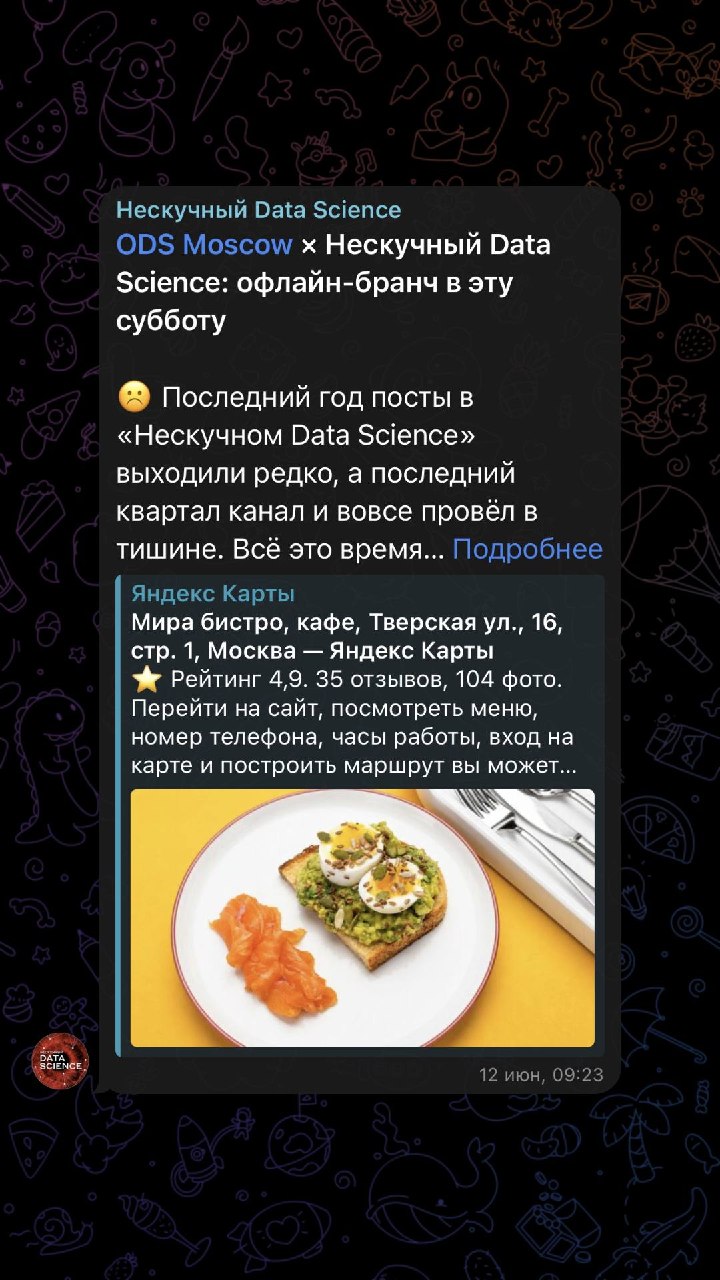
🔥 'https://t.me/ods_msc/433/14298' rel='nofollow'>ODS Moscow × Нескучный Data Science: бранч в эту субботу

После поста про МИРА можно уже не делать вид, что выбор места — случайное совпадение и не очень нативная рекламная интеграция 😅

В эту субботу снова собираемся там на офлайн-бранч вместе с ODS Moscow.

Будем знакомиться, есть и обсуждать ИИ, Data Science, карьеру и собственный бизнес. Заодно можно будет посмотреть на тот самый «очень дорогой pet-проект» из предыдущего поста и спросить, что в нём уже удалось оцифровать, а где операционка пока побеждает ИИ.

📆 Когда: суббота, 8 августа
🕛 Время: 12:00
📍 Место: @mirabistro, МИРА бистро, Тверская ул., 16, стр. 1
Вход со стороны метро «Тверская» / «Пушкинская»

Бронь на имя Даниель ODS.

Ставьте 👍, если планируете прийти — будет полезно понимать примерное количество людей.

Буду рад увидеться!


🎉 Мы запустили МИРА бистро — это очень дорогой pet-проект 😅

👀 Внимательные читатели уже могли что-то заподозрить: последние бранчи ODS Moscow × Нескучный Data Science проходили именно там.

Пора признаться — это было не случайное совпадение и не очень нативная рекламная интеграция.

🏦 Четыре с половиной года назад, когда мой банковский стаж уже перевалил за пять лет, в самом первом посте я признался, что никогда не собирался работать в крупных компаниях, тем более в банках.

К настоящему моменту стаж приблизился к десяти годам, а я прошёл путь от джуна до управляющего директора с командой из 150 человек. Прогноз оказался неточным, зато обучающая выборка получилась отличной.

🤖 Все эти годы главной темой канала было практическое применение ИИ в бизнесе — ровно то, чем я занимался в финтехе: находил точки применения ИИ, оценивал потенциальный эффект и встраивал решения в бизнес-процессы.

Теперь похожую задачу мы уже решаем в собственном бизнесе.

🏪 Главное отличие — в начальной точке: в бигтехе и финтехе данные обычно собираются и логируются, хотя используются далеко не всегда, а в небольшом офлайн-бизнесе их обычно не собирают системно.

📊 Но в главном небольшой бизнес ничем не отличается от крупного: путь к AI-native компании начинается с data-driven фундамента.

Сначала мы описываем и оцифровываем процессы, организуем сбор данных и выстраиваем систему метрик, а затем внедряем ИИ.

🔬 Основные принципы при этом остаются прежними: начать с изучения бизнес-процесса — подобно тому, как физик изучает природу, понять, как его можно улучшить и где ИИ принесёт измеримый эффект, а затем довести решение до внедрения.

👨‍🏫 Этим же принципам я учил руководителей на курсе «Принятие решений на основе данных», а теперь применяю их уже в роли владельца компании.

В МИРА мой опыт в данных, ИИ и построении процессов соединился с ресторанной операционкой — на том самом стыке ортогональных областей, о котором я писал в посте про настоящий аплифт от ИИ.

🚀 Для подписчиков это будет кейс о том, как перенести опыт из ИИ и крупного бизнеса в собственную компанию.

В предыдущем посте я писал, что работодатель больше платит тем, кто помогает ему больше зарабатывать. Но эта сделка работает в обе стороны: когда вы относитесь к чужой компании как к своей и выбираете сложный путь, который приносит ей дополнительный результат, вы одновременно накапливаете опыт и инструменты.

Теперь проверим, насколько хорошо этот опыт переиспользуется уже в собственном бизнесе.

🎁 Но прежде чем рассказывать о применении ИИ, нужно понять сам продукт и изучить его процессы. Только после этого станет ясно, где и зачем нужен ИИ.

Поэтому в следующем посте будет первая коллаборация с каналом @mirabistro и акция для подписчиков. Сначала познакомлю вас с продуктом, а уже потом перейдём к данным, метрикам и применению ИИ.

18 ta oxirgi post ko‘rsatilgan.