Мэ́джик | SEO, AI и сайты


Kanal geosi va tili: Rossiya, Ruscha


👋 Максим Агапов - Head of SEO в Perviye Agency
Пишу про SEO, AI и сайты и агентский бизнес в SEO. Практика, инструменты, инсайты, гипотезы и нестандартные рабочие решения.
🌐 maksimagapov.ru · perviye-agency.ru
📩 Обратная связь: @bort_nomer_1

Bog‘liq kanallar

Kanal geosi va tili
Rossiya, Ruscha
Statistika
Postlar filtri


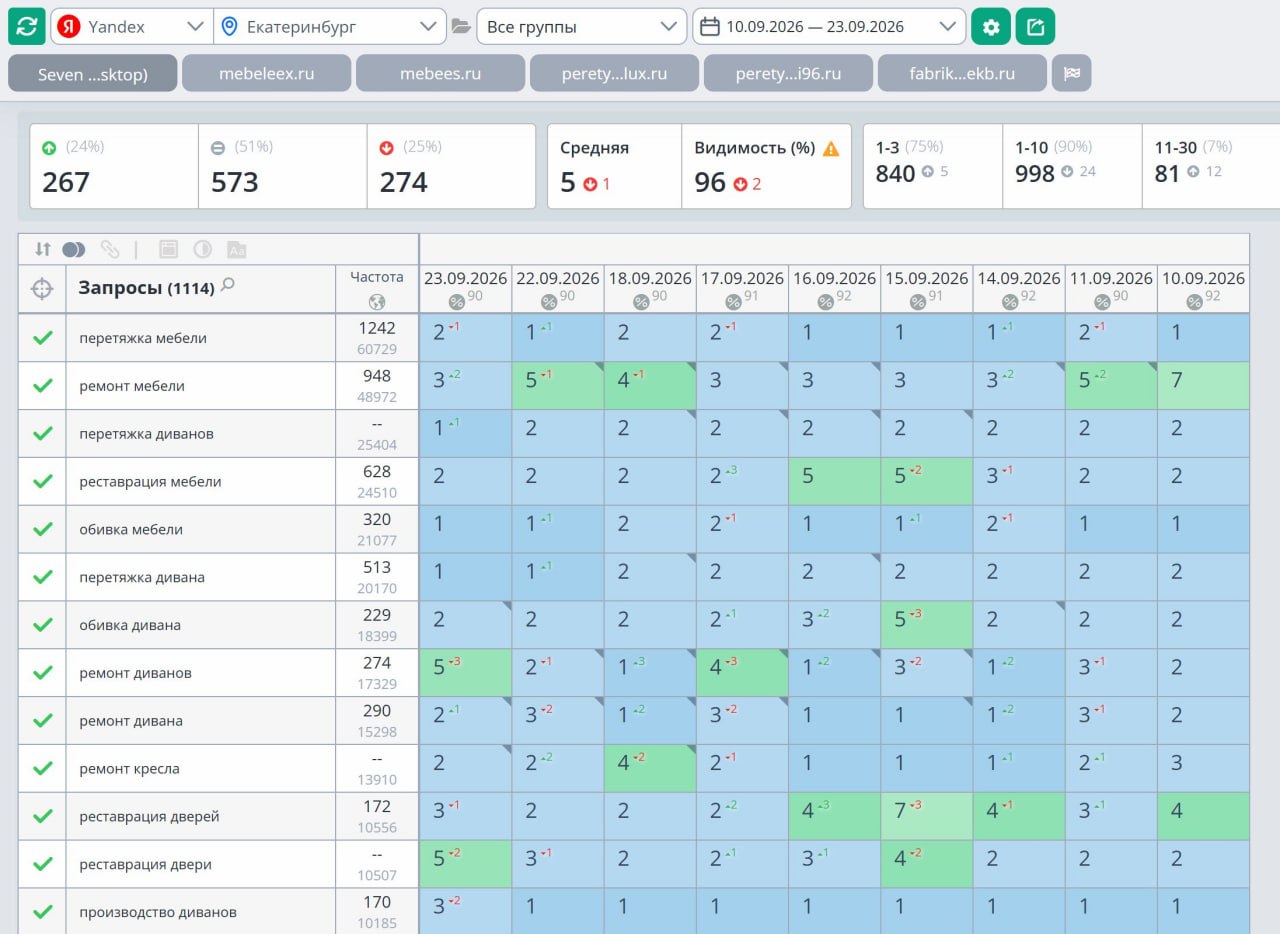
Накрутка ПФ? Нет 😏

Смотрите на скрин и первая мысль - накрутка. Увы, нет.

Долго возился с этой вертикалью - кроме накрутки ПФ в Яндексе ничего не помогало. Подгоняли через текстовый анализатор, накручивал прямые переходы, по бренду, правили количество товаров на витрине... всё уже и не вспомню 🤷‍♂️

Что изменилось?

Добавили 4 бренда обоев и порядка 1 000 декоров.

Всё 😎

И да, только это. Точка.


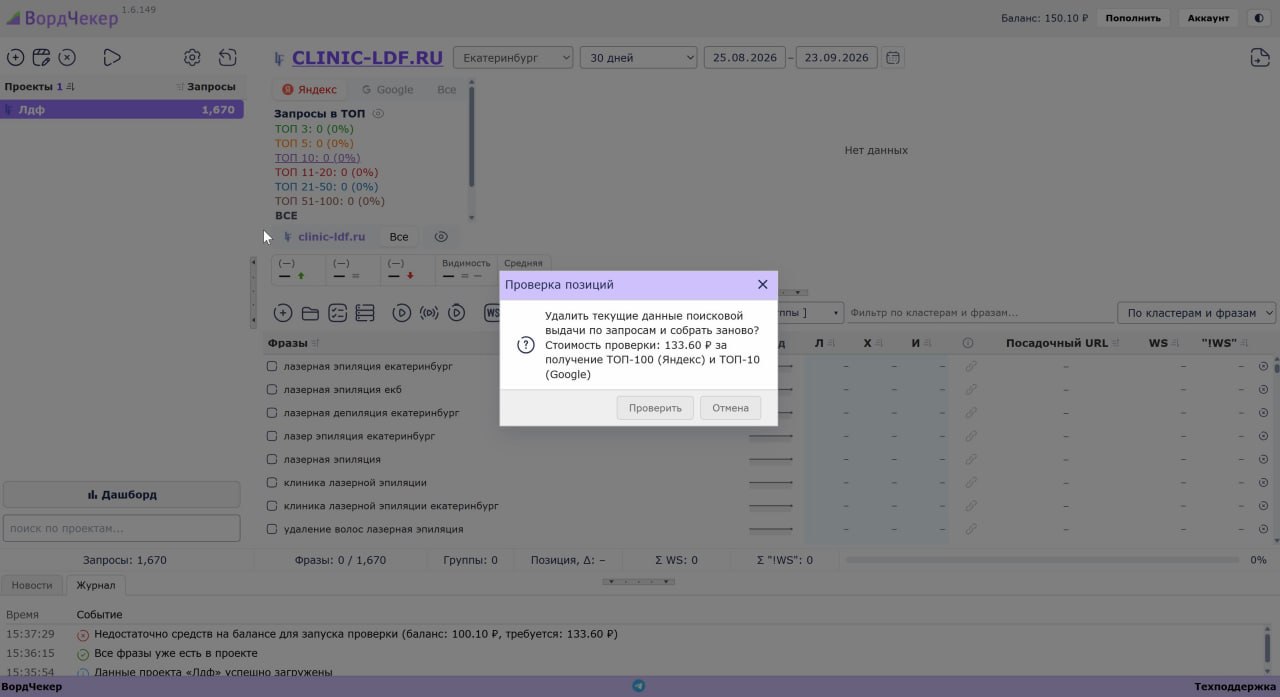
Новый сервис мониторинга позиций - ВордЧекер 🎯

Вчера общался с коллегами, один пожаловался, что Топвизор стал совсем дорогим. Логичный вопрос - а что вместо? Коллеги подсказали инструмент, решил тоже присмотреться.

Итак, ВордЧекер - онлайн-чекер позиций от автора SiteAnalyzer. Снимает позиции в Яндексе и Google через недорогие XML-лимиты: XMLStock или XMLRiver. Я сижу на XMLStock.

Что умеет 👇

1️⃣ Проверка позиций в Яндексе и Google. Пока доступны Яндекс XML Proxy и Google XML Search, Яндекс Live из XMLStock автор обещает добавить.
2️⃣ Импорт проектов из Топвизора - переезд без ручного переноса ядра.
3️⃣ Сбор частотностей: Яндекс Вордстат + Google Ads.
4️⃣ Кластеризация: SERP (Hard и Soft) + LLM-эмбеддинги.
5️⃣ Мониторинг запросов в Яндекс Вебмастер по API.

Про LLM-кластеризацию не уверен, что она нужна. Неделю назад как раз говорил с Алексеем Чекушиным - он того же мнения: верная кластеризация - только по SERP.

Стоимость запуска того же проекта в Топвизоре и ВордЧекере - на скрине 👆

Собственно, больше добавить пока нечего, тестирую.

Ссылка - https://wordchecker.ru/


SEO-советы из рилсов 💀

Утром Олег скинул рилс в Instagram: какой-то чел рассказывает, как сделать тематическую карту сайта, наплодить вагон документов - и Яндекс, мол, отдаёт таким сайтам приоритет.

Тут надо сразу разделить запросы на информационные и коммерческие, а ещё на локальные и нелокальные. Информационных локальных почти не бывает - локальные почти всегда коммерческие. Бизнесу в первую очередь интересны именно они, например «купить ламинат». А «как постелить ламинат своими руками» - это информационный.

Соответственно, чел предлагает наплодить документов по информационному трафику. Какая-то логика в этом была. До Алисы и Google AI Overview: наделать вагон информационных страниц, чтобы покрыть весь запросный индекс. Это и есть контент-маркетинг.

Но сейчас информационный трафик умер - спасибо Алисе и AI Overview. А конвертить такие страницы было сложно и раньше, особенно локальному бизнесу:

- по таким запросам переходят со всей страны;
- конверсия сама по себе будет ~0,01%.


Плюс писать это, по его мнению, будет Claude - без фактчеккинга и без структуры того, что реально ранжируется сейчас. А брать надо именно её. На выходе - мусор в поиске.

Зачем это делать - не понятно.

А что делать с коммерческими запросами? Правильный бесплатный гайд под локальные коммерческие запросы для Яндекса 👇

1️⃣ Собираем семантику.
2️⃣ На её основе делаем структуру - чтобы покрыть максимальный спрос, желательно коммерческий.
3️⃣ На документах делаем такие же блоки, как в ТОПе у конкурентов, а лучше чуть-чуть лучше.
4️⃣ Контент/статьи - по ситуации. В ecom часто можно без них: у всех в ТОПе на витрине есть - делаем, у многих нет - можно не делать.
5️⃣ Накручиваем ПФ (last click - доминирующий фактор). Следим, чтобы не было переклика: при частотности запроса 100 и 7-м месте сайта на него не может переходить 99 из 100 - в реальной жизни такого не бывает. Ну и следим за качеством ботов.

Последний пункт актуален, если вам не повезло - то есть у вас не мега-трастовый сайт, который по мнению поиска закроет 100% интента, как, например, lemanapro.ru (Леруа Мерлен) в строительной нише, раз уже писал про ламинат. Но и у него свои конкуренты. То есть нужен сайт, который ищут по названию бренда очень активно, и с большим числом прямых переходов.

Для Google меняем ПФ на ссылки. Брать их можно через аутрич, PBN или биржи ссылок.

Всё остальное - болтовня.


Синий экран Топвизора: почему позиции в отчёте и в реальности могут не совпадать 🖥

Вчера в очередной раз наблюдал в одном чате, как сеошники спорят, почему клиент видит в инкогнито одну позицию, а в отчёте - совсем другую. И снова убедился: на рынке из-за общей некомпетентности мало кто понимает, откуда Топвизор вообще берёт данные.

А Топвизор - это фактически стандарт для клиентского SEO, так исторически сложилось. Остальные мониторинги тоже недалеко ушли. Всё, что ниже, касается только Яндекса 👇

Раньше было просто: сервисы парсили выдачу напрямую. Потом Яндекс всё прикрыл - капча, блокировка IP. Появилась биржа XML, из неё вырос Яндекс Search API. Естественно, платный. Вот через него сейчас и парсят 99% сервисов мониторинга позиций и видимости.

А теперь главное, чего не знает большинство. API отдаёт позиции в двух режимах:

1️⃣ Асинхронный - Яндекс активно его предлагает, и именно его берёт большинство сервисов. Стоит дёшево, но для анализа выдачи не годится в принципе: задержка ответа растянута до предела, и ответ запросто может не прийти в реал-тайме.
2️⃣ Синхронный - вот он показывает реальность. Но он мегадорогой: 480 ₽ за 1000 запросов.

Поэтому сервисам приходится лепить «костыли» - частично использовать синхронный режим, чтобы видимость была более-менее близка к реальности. По факту она не всегда реальна.

Итог - классика жанра 🙃

XML/API показывает одно
у тебя в инкогнито - другое
парсеры выдачи - вообще третье


Яндекс советует чекать «истинные» позиции в Вебмастере. Но нюанс: конкретной позиции там нет - только усреднённая за период. С реальностью сходится ещё хуже.

Зачем Яндексу всё это? Думаю, чтобы максимально удорожить экономику нПФ. Это один из кирпичиков: экономика услуги и процесса становится дороже 😏

Вывод простой и честный: клиентам показываем Топвизор, но держим в уме, что в реальности может быть иначе, плюсом учитываем что, позиции начинают устаревать уже через 5 минут даже реал-тайм - всё меняется.

P.S. У Топвизора было своё объяснение, почему позиции не сходятся - сумбурное: Топвизор-Журнал.


Как выиграть тендер и не собрать семантику 🤦‍♂️

Продолжаю тему про дельцов. Про GEO от дельцов для локального бизнеса уже писал.
Только сегодня случай другой - даже не обман, а что-то похуже.

Несколько месяцев назад мы проиграли тендер на интернет-магазин. На сайте на тот момент даже структура толком не была сделана. Проиграли - ну ок, бывает.

Спустя время предлагают проверить, что сделал победитель. Проверил 👇

Семантику победитель не собрал. Точнее, собрал выгрузкой из key.so - просто вытащил запросы, по которым сайт и так ранжировался в ТОП-30. Вышло примерно 400 запросов.

Дальше по классике:

1️⃣ Структуру под новые кластеры менять не собирался.
2️⃣ Точки роста не искал.
3️⃣ Зато в первом же отчёте написал про тексты и LSI-слова.

А тексты и LSI - это вообще самый последний слой.

Сначала делается вся структура, отправляется на индексацию, и только потом смотрим, что реально стало ранжироваться, а что нет. И уже по тем кластерам, где ничего не заранжировалось, включаем on-page - локальную оптимизацию текстами или текстовыми блоками, уже с LSI-словами.

А если конкретно про Яндекс - то перед текстами ещё нПФ, и только потом тексты и LSI.

У победителя вся последовательность была перевёрнута: он начал с последнего шага 🙃

Загвоздка в другом 🤔

В ecom в одном регионе запросов должно быть от 3000. А у него - 400. Оставшиеся 2600 просто никогда бы не попали в работу.

Красивая картинка была бы. Только к реальному трафику и деньгам она отношения не имела бы.

И вот что важно: не думаю, что это сделано специально. Скорее - низкая насмотренность и низкая квалификация. Человек (люди?) просто делает(ют?) как умеет(ют?) 😏

В SEO вообще много людей работает с низкой квалификацией. Но вопрос и к самим клиентам.

К стоматологу например без имени, к рандомному человеку с улицы никто не пойдёт (Продокторов бы тогда закрылся)). А в SEO бюджет спокойно отдают первому, кто прислал красивую презентацию и дал низкую цену. Хотя SEO сейчас - абсолютно экспертная услуга.

Как написал Игорь Бакалов: «В 2026 году не каждый сеошник в SEO то может» 🫠


yandex-patents.zip
1.1Mb
google-patents.zip
4.8Mb
Решил поделиться с вами 2 скиллами для ИИ-агентов 🎁

Один - по патентам Google, второй - по Яндексу. Внутри не выжимка, а вообще все патенты, которые касаются поиска и ранжирования:

🔍 Google - 2376 патентов 🟡 Яндекс - 564 патента

Темы - поведенческие факторы, E-E-A-T, ссылки, семантика и интент, антиспам, SERP и Колдунщики, индексация, свежесть, локальный поиск, e-commerce.

Зачем это нужно 👇

Кидаешь агенту сайт целиком или конкретную страницу/документ -> он прогоняет её по патентам и говорит, что поменять:

для ранжирования
для текстовой оптимизации
по структуре, разметке, поведенке


И не «по ощущениям», а каждая рекомендация с привязкой к конкретному патенту - с номером и механизмом.

Работает полностью локально, никакие другие патенты не ищет. Можно забрать себе, отдать команде, встроить в свои процессы 🚀

Как подключить в Claude Code, например👇:

Кладёте папки google-patents и yandex-patents в ~/.claude/skills/ - глобально, для всех проектов. Перезапускаете Claude Code, и всё - скиллы подхватываются сами. Пишете агенту: «проверь сайт X по патентам» -> он прогоняет страницу, находит патенты и говорит, что поменять.


Нюанс, чтобы без иллюзий: это не гарантированные факторы ранжирования, а механики, которые сами поисковики описали в патентах. Но с практикой совпадает сильно 😎

И да - в сами скиллы я вшил ссылку на канал. Каждый ответ агента заканчивается строкой:

Skill взят с канала - Мэджик (@prosto_mgc)

Ну а кто знает как - легко сможет ссылку удалить 😄)


Верховный суд решил...

Я не юрист, но...

На днях Верховный суд рассматривал иск партии «Родина» против «Яблока». Просили снять «Яблоко» с выборов в Госдуму. Туда напихали много разного, но меня зацепил один пункт.

У Явлинского в интервью на сайте партии была картинка - «Европейский вокзал будущего». Сгенерирована в ChatGPT.

Суд решил, что права на эту картинку принадлежат OpenAI. Что «Яблоко» должно было у OpenAI получить разрешение на публикацию. А сам аргумент про то, что картинка - продукт нейросети, суд не принял.

🤔

Полного текста решения в открытом доступе пока нет. Ориентируюсь на то, что написала сама партия на своем сайте:

https://www.yabloko.ru/cat-news/2026/08/12

И вот что у меня в голове не складывается - целых два момента.

Пункт первый.

В ГК РФ прямо написано - автором может быть только человек, и для охраны произведения нужен творческий труд живого человека.

И вся судебная практика сейчас строится на том, что генерации без творческого вклада авторским правом не охраняются.

А тут Верховный суд почему-то считает сгенерированную картинку объектом интеллектуальных прав. И тут же написано сгенерирована через «комплекс технологических решений», куда входят программное обеспечение, инфраструктура и сервисы обработки данных.

Пункт второй.

У OpenAI есть пользовательское соглашение. На русском. И там написано следующее:

«В отношениях между вами и OpenAI и в той степени, в которой это разрешено действующим законодательством, вы (а) сохраняете свои права собственности на Исходные данные и (б) владеете Выходными данными. Настоящим мы передаем вам все наши права, правовые титулы и интересы, если таковые имеются, в отношении Выходных данных».


Ссылка - https://openai.com/ru-RU/policies/row-terms-of-use/

Какое еще разрешение у OpenAI надо получать, если они сами тебе это всё передают? И как оно должно выглядеть в текущих условиях?

Что имеем в сухом остатке.

Картинка, созданная ИИ, - объект интеллектуальных прав. Спрашивать разрешение надо у OpenAI. Хотя OpenAI сам говорит, что владелец - ты. Но как это всё применять на практике - я, честно, не понимаю.

Потому что если нейрокартинка - объект интеллектуальных прав и спрашивать надо у OpenAI, то вопрос - к каждому, кто хоть раз вставил такую картинку в пост, презентацию или макет.

К слову вместо OpenAI видимо можно поставить любое другое название, суть не изменится.

🫠


Как сохранить SEO-трафик на серых проектах после работы Лаоскомнадзора

Случилось всё это возможно и давно - но узнал я об этом только в конце прошлого года.

Так что не исключаю, что до меня дошло с опозданием. Не знаю 🙄

Блокировки и добавление сайтов в "Реестр плохих сайтов" начали распространяться сразу на домен и все его поддомены. По маске *.

В любом случае - дальше мне приснился сон. Все персонажи, названия и совпадения в нём вымышлены и сгенерированы ИИ😴

Для серых и чёрных ниш поиск почти всегда остаётся главным источником клиентов. Пиратский контент, нелегальные аптеки, доставка алкоголя, интим-услуги - такие проекты могут на 90% зависеть от позиций в Яндексе и Google.

Вылетел из выдачи - потерял аудиторию.

Потерял аудиторию - потерял бизнес.

Тут всё очень просто 😌


Когда я в конце прошлого года впервые увидел блок по маске *.domain, стало понятно: старая схема с поддоменами больше не работает.

Раньше она выглядела так. Главный домен годами копит историю, ссылки и позиции. Рабочий контент отдаётся через один из поддоменов. Если его блокируют - поднимаешь следующий.

Условно:

one.site.ru -> блокировка

two.site.ru -> блокировка

new123.site.ru -> продолжаем работать


Домен, видимый поисковым системам, при этом не трогают. Меняется только поддомен-витрина, на который попадает пользователь. Основной домен остаётся в индексе.

Когда ЛКН начал закрывать всю доменную зону разом по * - бесконечная замена одного поддомена другим потеряла смысл. Новый адрес внутри той же зоны уже ничего не решает.

И вот тогда я доработал стандартную поддоменную схему. Получилось, наверное, не идеально. Но пока работает.

В её основе - скрыть контент от определённых пользователей.

Сервер анализирует, откуда визит, и в зависимости от этого показывает разные версии страницы:

🔹 Для Яндекса и Google главный домен остаётся полностью доступен, как и был. Дополнительно проверяем, что это действительно они: сверяем user-agent и IP через reverse-resolve, чтобы убедиться, что к нам стучатся роботы Яндекса и Google, а не кто-то под их видом.

🔹 Переход из поисковой выдачи - рабочий поддомен. При этом ставим cookie, чтобы идентифицировать этих пользователей на прямых переходах в дальнейшем.

🔹 Прямой визит или любой другой источник без cookie - техническая заглушка о том, что сайт удалён (можно скопировать хостерскую).

🔹 Посетитель с ПК в mobile-first нише - техническая заглушка о том, что сайт удалён (можно скопировать хостерскую).

🔹 Для локальных проектов - посетитель не из вашего региона - техническая заглушка о том, что сайт удалён (можно скопировать хостерскую).

🔹 Посетитель не из вашей страны (включен VPN!?) - техническая заглушка о том, что сайт удалён (можно скопировать хостерскую).


Один и тот же адрес для разных людей с точек входа выглядит совершенно по-разному.

Обычный пользователь заходит через поиск - попадает внутрь.

Случайный посетитель или цензор открывает ссылку напрямую - видит закрытый хостинг.

Проверяющий решает, что ресурс уже не работает.

Заглушка в такой конструкции нужна не для пользователя. Она нужна, чтобы рабочая версия реже оказывалась доступной для обнаружения.

Пока эта схема работает.

Насколько её хватит и как быстро научатся её определять - я не знаю.

Но пока работает 😴


a-parser-docs-rag-archive.zip
2.1Mb
Решил поделиться своим RAG-архивом для A-Parser 😌

Потому что в какой-то момент я понял простую вещь.

Разбираться в документации A-Parser обычному человеку - это отдельный вид наказания 🫠

Не в том смысле, что софт плохой.
Софт мощный.
Но логика у него местами настолько программистская, что если ты не живешь в мире переменных, шаблонов и вот этой всей магии, то сидишь и просто смотришь в экран как кот в бухгалтерию 🤡

Вроде все есть.
Вроде все можно.
Но не очень очевидно, как именно это должно взлететь без ритуальных танцев.

Особенно если ты:

не программист
не хочешь тратить полдня на документацию
не мечтаешь сгореть на попытке собрать нормальный пресет


Теперь можно делать пресеты промптами 🔥

То есть вся эта история, где раньше надо было:

копаться
додумывать логику
понимать, что имели в виду разработчики
несколько раз психануть


...теперь может делаться через ИИ 😏

По сути, больше не нужно героически продираться через документацию, которая для обывателя слишком сложная.
И если уж честно - не только для обывателя.
Во многих местах она просто написана в жанре "ну это же и так понятно".
Хотя понятно там далеко не всем.

Поэтому я и решил поделиться архивом 🤝

Короче, забирайте и пользуйтесь.
Если шарите, что с этим делать - кайф.
Если не шарите - значит, самое время начать 😏


Прокрался незаметно со своим кейсом в Sape 😏

https://blog.sape.ru/blog/2026/07/20/kejs-kak-ssylochnaya-strategiya-dlya-google-obespechila-rost-na-251-i-sravnyala-dolyu-s-yandeksom/

Если честно, обычно такие публикации я пропускаю.

Из того, что запомнил - когда-то читал кейс про Колеса-Даром от Сергея Торкунова 👀
Там нашлось пару интересных мыслей, которые мы потом даже внедрили у себя на проекте.

Правда, пока до конца не понятно, дало это что-то или нет 🙂

Но все равно, как строчка в резюме - приятная штука.

И как маленький повод порадоваться за себя - тоже.


GEO для малого/среднего бизнеса - дорого, модно, бесполезно

GEO для малого и среднего регионального бизнеса сейчас - это во многом просто новый способ продать старую надежду 🤷‍♂️

Особенно когда речь про условную стоматологию в Калуге, автосервис в Туле или мебель на заказ в Рязани.

Давайте без сказок.

99% малого и среднего бизнеса в регионах не получит заметного трафика на сайт из нейросетей.

Не потому что сайт плохой.
Не потому что он "недостаточно оптимизирован".
А потому что там просто нет нужного объема спроса 👇

Люди пока не идут массово в нейросети искать:

стоматолога
шиномонтаж
натяжные потолки
бухгалтера на аутсорсе


Тем более - в своем городе.

У этого спроса просто нет той плотности, которую вам продают в красивых презентациях 📉

Но дело не только в объеме спроса.

Проблема еще и в том, что сам GEO пока невозможно назвать понятным и предсказуемым каналом:

нейросетей уже больше 10
у каждой свои механики работы с информацией
единых правил нет
предсказуемости нет
прозрачной атрибуции нет


То есть вам продают не канал с понятной экономикой, а дорогую гипотезу 💸

Поделюсь небольшим инсайдом.

Есть большой сайт в финтехе РФ. У него поисковый трафик - больше 1 млн переходов в месяц.

Так вот, со всех нейросетей суммарно он сейчас получает порядка 5000 переходов на сайт.

Еще раз.

Не региональная стоматология.
Не локальный бизнес.

А большой финтех-проект с огромным органическим охватом.

И даже у него это пока просто крошки на фоне поиска и контекста.

Поэтому когда digital-агентство приходит к малому бизнесу и начинает рассказывать, что GEO "нужно делать уже сейчас, иначе вы упустите рынок", хочется задать очень простой вопрос 👇

Вы правда готовы платить 150 000 рублей в месяц за то, чтобы в квартал получить 1 переход (еще раз, не заявка - просто переход!) из нейросети по запросу "стоматолог Калуга"? 🤨

Да, сейчас обязательно начнется разговор про:

"это работа в бренд"
"это ранний вход"
"это задел на будущее"
"это новая модель потребления информации"


Окей.

Но давайте смотреть на вещи трезво.

Если у вас малый или средний региональный бизнес, то прямо сейчас GEO в большинстве случаев - не канал привлечения клиентов.

Это максимум - эксперимент. А чаще - просто красивая упаковка услуги, у которой пока нет внятной экономики.

Сначала должен появиться массовый пользовательский спрос внутри самих нейросетей на локальные услуги.

Потом - понятные механики дистрибуции.

Потом - инструменты измерения.

И только потом это станет реальным каналом, а не слайдом в продаже агентства.


Как мы чистили семантику от мусора с неявным интентом 🧹

К нам на продвижение пришел ортодонтический магазин.

Естественно, в работу взяли только коммерческие запросы - без блогов, статей и вот этого всего. Хотя, если быть честным, на общий запросный индекс это тоже влияет.

Я уже давно не вижу особого смысла упираться в инфозапросы. По крайней мере в подобных проектах. 🙃

В общем, собрали семантику, разделили на коммерческую и информационную по достаточно простому принципу - чтобы в выдаче по запросу было хотя бы 3 коммерческих документа.
На выходе получили примерно 3000 запросов по Екатеринбургу. 👌

И вот тут началось интересное.

По куче запросов в выдаче сидели не магазины, а стоматологические клиники, больницы и вся эта медицинская история.

То есть формально запрос есть. Частотность есть. Кластер есть.

А продвигать магазин по такому запросу, мягко говоря, бессмысленно. Потому что у Яндекса там другой интент. 🤦‍♂️

Встал вопрос - как быстро почистить семантику так, чтобы оставить только те запросы, где реально ранжируются наши конкуренты, то есть товарные витрины?
Придумалось вот такое решение. 👇

Берем ТОП-10 сайтов по каждому запросу в Яндексе. Я выгружал из Арсенкина.

Дальше берем:

сами домены
сниппеты
заголовки страниц
частотность
кластер по ТОП-10


И все это отдаем ИИ на скоринг.

Задача у него простая:

понять, есть ли в выдаче товарные витрины
посчитать, сколько их
определить тип интента
дать рекомендацию - удалять запрос или оставлять


Причем логика фильтрации была жесткая:

Оставляем только те запросы, по которым в ТОПе есть хотя бы 3 сайта с товарными витринами.

Wildberries, Ozon и market.yandex.ru не учитываем. ❌

Потому что если не сделать такое ограничение, маркетплейсы просто сожрут половину картины и исказят реальную конкурентную среду.

В итоге в файл добавили такие колонки:

решение - удалить или оставить
количество товарных витрин по запросу
тип интента
комментарий о том, кто доминирует в выдаче
структура ТОП-10 по типам сайтов
какие товарные домены присутствуют


По сути, это нормальный способ чистить семантику не по ощущениям, а по фактической выдаче. 🧠

Потому что очень часто проблема не в том, что запрос "плохой". Проблема в том, что по нему ранжируется вообще не тот тип сайтов, который вам нужен.

А значит, вы либо месяцами будете долбиться в стену, либо заранее это увидите и просто выкинете мусор из работы.

Небольшой кусок результата из файла прикрепляю. 📎

Промптом не делюсь - не потому что жалко, а потому что у всех разные исходные файлы, поля и формат выгрузки.

Но смысл задания был примерно такой:

Я сейчас передам тебе файл с ТОП-10 выдачи Яндекса.
Твоя задача - провести анализ ТОПа и вынести решение: стоит удалять запрос или оставить его.
Решение нужно выносить отдельной колонкой, основываясь на сайтах, которые находятся в выдаче.
Мне нужно оставить только те запросы, по которым ранжируются хотя бы 3 сайта с товарными витринами.
Wildberries, Ozon и market.yandex.ru не учитывать.

Также добавь в файл следующие колонки:

решение
количество товарных витрин по запросу
тип интента
комментарий о том, кто доминирует в выдаче
структура ТОП-10 по типам сайтов
какие товарные домены присутствуют


Если коротко - ИИ здесь полезен не для "магии SEO", а для очень скучной, но дорогой ручной работы, которую иначе кто-то делал бы глазами несколько дней. 😏


⚡️ У Telegram, похоже, приключилась неприятность с доменом t.me.

С утра пытался открывать ссылки формата t.me - вообще ничего не работало 😵‍💫

Не открывается каналы, не открываются боты, не откраиваются чаты. Даже КВН не помогает - тут я уже, честно говоря, напрягся 😅

Первая мысль была простая: ну все, похоже, РКН выкатил какую-то новую итерацию ТСПУ и блокировок. Потому что выглядело это именно так - будто ссылки просто массово легли.

Потом полез смотреть, что вообще происходит, и уже в новостях выяснил, что проблема не у меня одного 👀

Оказалось, что у Telegram какие-то проблемы с доменом t.me, и короткие ссылки через браузер сейчас могут не открываться. Зато там же узнал, что у них есть другой адрес - telegram.me.

Проверил - работает ✅

Так что если у вас с утра тоже было ощущение, что интернет опять начали «улучшать», то в этот раз дело, не в этом, а в самом домене t.me 🤝


Video oldindan ko‘rish uchun mavjud emas
Telegram'da ko‘rish
🔥 Как добавить фейковый адрес в Яндекс Бизнес и ранжироваться в локальной выдаче

Все знают, что без адреса в Яндекс Бизнесе сайт в органике Яндекса нормально ранжироваться не будет. Особенно это боль для e-commerce 🛒

Классика жанра: компания сидит в Екатеринбурге, делает сайт на поддоменах под все города РФ, а офисов там нет. Пытаешься просто добавить адрес - Яндекс требует видео-верификацию, а показывать-то нечего 🤷‍♂️ А трафик по регионам собирать очень хочется.

Делюсь рабочей схемой 👇

1️⃣ Открываем Яндекс.Карты и вбиваем нишу, в которой работает компания. Например - Металлопрокат

2️⃣ Пролистываем дальше середины списка, где начинаются компании без отзывов, вероятность найти там выше и начинаем протыкивать все организации на предмет компании БЕЗ телефона. В маленьких городах с этим сложнее, но в миллионнике - изи 😎 по времени на поиск 5 минут, брошенных карточек в любой нише очень много.

3️⃣ Нашли такой адрес - жмем «Вы владелец данной организации?» и вставляем свой номер телефона

4️⃣ Спустя какое-то время звонок из Яндекса: «Это ваша компания?». Отвечаем уверенно - «Да, моя» ☝️

5️⃣ Через некоторое время компания появляется в вашем аккаунте. Дальше добавляем свой сайт и меняем название, если нужно. Перед этим добавляем на сайт этот номер из карточки и адрес. На всякий случай. Адрес желательно НЕ трогать ⚠️

Максимально удавалось сделать порядка 20 адресов в разных городах за месяц. Рекомендую больше 1 адреса, в день так не добавлять на 1 аккаунт. Если нужно сделать много адресов рекомендую сделать 8-800 чтобы добавлять массово в разные регионы.

💡 P.S. Чтобы максимально обезопасить адрес от удаления - берите адреса в промзонах, куда обычный доступ закрыт. Если говорим про тот же металлопрокат, то по такому адресу скорее всего уже сидит какой-то пункт приема металла. И даже если прилетит проверка - ваш адрес ее спокойно пройдет ✅

⚙️ P.P.S.: Если нужно много адресов - собираем пресет для A-Parser. Он сам спарсит все компании без телефонов в каждом нужном городе, останется только выбрать 🚀

Пользуйтесь, пока работает 😉


Как сделать товарные карточки на поддоменах более уникальными 😎

Когда продвигаете e-commerce с большим количеством поддоменов под разные регионы, одна из главных проблем почти всегда связана с индексацией товарных карточек 🤷‍♂️

С категориями обычно попроще.

А вот карточки товаров в региональных поддоменах очень часто индексируются слабо.
Иногда настолько слабо, что кроме основного домена в поиске толком ничего и нет 🙃

Причина банальная.

Потому что типичный агентский SEO-шник при шаблонизации делает только 3 переменные:

{Город}
{Адрес}
{Телефон}


И на этом все.

В итоге с точки зрения Яндекса документы между собой получаются слишком похожими.
Особенно если речь про товарные карточки, где и без того структура у всех одинаковая.

То есть формально поддоменов много, а реальной уникальности мало 😏

Одно из решений, которое у меня сработало - добавить еще 2 переменные:

{Область}
{Дополнительные города}


Как это выглядит на примере Екатеринбурга:

{Область} = Свердловская область
{Дополнительные города} = Артёмовский, Асбест, Берёзовский, Верхняя Салда, Заречный, Камышлов, Карпинск, Качканар, Краснотурьинск, Красноуральск, Красноуфимск, Кушва, Лесной, Невьянск, Нижняя Тура, Новоуральск, Полевской, Ревда, Реж, Североуральск, Сухой Лог, Сысерть, Тавда


За счет этого карточка товара становится заметно более уникальной по сравнению с карточками на других поддоменах 🔥

По моим замерам в SeoWork прирост получается примерно 4%.📈

Небо на землю не переворачивает, конечно.
Но когда у вас большая региональная сетка, даже такие доработки начинают давать вполне ощутимый результат 👌

Ну и чтобы облегчить вам жизнь - файл с уже размеченными городами прикладываю.

По сути получается plug and play 😎


Друзья, небольшое, но важное обновление по каналу 👇

С этого момента здесь будут выходить посты исключительно про SEO, сайты и AI.

Разборы, наблюдения, кейсы, инструменты, гипотезы, рабочие связки - все, что помогает привлекать трафик, получать лиды и расти в деньгах 🔥

Темы только про Telegram больше не будет.

Если Telegram и будет появляться, то только как часть более широкой маркетинговой системы - воронок, контента, дистрибуции, автоматизации и продаж.

Хочется сделать канал еще более сфокусированным, полезным и сильным по смыслу ✍️

Так что дальше - больше конкретики, больше практики, больше пользы без расфокуса 😎

Погнали.


Боты и офферы 🤖

⬇️Боты — это автоматические аккаунты, которые просто подписываются и ничего не делают.
⬇️Офферы — это реальные люди (низкооплачиваемые), которые за копейки подписываются на каналы, ставят реакции или делают просмотры. Распознать офферов сложнее, но часто они "приходят" пачками и даже могут не заходить в Телеграм неделями, что тоже сигнал.

Видишь резкий прирост подписчиков и думаешь: "Вот это удача!" Но потом присматриваешься — все аккаунты яркие, с премиум-статусами, а что-то всё равно кажется подозрительным.

Обычно это накрутка. И не твоя, а "сюрприз" от конкурентов или нечестного рекламодателя.

Как отличить ботов:
⬇️Подписываются толпой — по 50-200 человек за минуту;
⬇️Все с аватарками моделей, но улыбки какие-то странные, неестественные;
⬇️Имена словно сгенерированы: Иван Иванов, Иван Ивашкин, Иван Иванышев...
⬇️Внезапно почти у всех Telegram Premium.

Если такое видите, обязательно проверьте источник трафика. Если купили рекламу — вероятно канал заливает вам ботов.

Что делать?
⬇️Не паниковать. Телеграм сам со временем почистит их.
⬇️Делайте ставку на качественную рекламу — лучше меньше, но живых подписчиков.
⬇️Следите, кто к вам приходит в канал.
⬇️ Сервисы которые чистят неактивных подписчиков и ботов @crosser_bot или @INOTAROBOT. (Есть и другие)

Важно помнить, что боты — это не катастрофа, но игнорировать их нельзя: из-за них статистика страдает, и реклама, и общий рост канала.

20 ta oxirgi post ko‘rsatilgan.