Air ~ AI


Kanal geosi va tili: Rossiya, Ruscha


У канала особый вайб
@airapetovats ⚡️ AI Архитектор
🎓MBA | CFA | MCFO | Development

Bog‘liq kanallar

Kanal geosi va tili
Rossiya, Ruscha
Statistika
Postlar filtri


Как использовать хайповый JEV - исследование

важна была экономия времени и денег на задачах, когда одна модель должна оценить ответ другой, т.к GPT-6 в роли судьи обходилась в 12 тыс.$ за миллион оценок

Совместная работа JEV и GPT-6 в роли судей
JEV получает инструкцию, данные для проверки и допустимые варианты решения. В ответ возвращает выбранный вариант и вероятности, без текста с объяснением. Как на тестировании, когда ученик обводит ответ, не показывая ход решения


Например: В документе написано: «Музей закрыт по понедельникам», а модель советует посетить его в понедельник. JEV получает оба текста и должен определить, есть ли противоречие

По точности примерно в середине среди проверенных моделей, на некоторых задачах в 277 раз дешевле GPT-6 и обычно отвечал за доли секунды

🔑 у JEV уверенность - это важный сигнал правильности, промахи чаще встречались там, где вероятность выбранного вердикта была невысокой. Среди уверенных решений JEV был гораздо ближе к GPT-6.

Поэтому грамотная работа с ним выстроена вокруг принципа "принимай, когда уверен, передавай дальше, когда сомневаешься". JEV смотрит на задачу первым. Если его уверенность выше заранее выбранного порога (в исследовании порог выше 90%), система принимает вердикт. Если ниже, то передается сильной модели

Где-то даже связка JEV и GPT-6 оказалась немного точнее одной GPT-6 и сократила расходы почти на 60%. Но в этой выборке преобладали задачи обычного сравнения ответов, где JEV уже справлялся хорошо

На заметку: 😁Обмануть JEV можно как и человека - убедительный стиль: когда неправильный ответ написан красиво и подробно, легче принимает его за лучший

Из личного опыта: мне Jev часто возвращал уверенность в районе 45% и поэтому требовалась проверка сильной модели. В результате только 6 решений были выполнены им самостоятельно, а остальные 26 - переданы GPT на проверку. Но из переданных и перепроверенных 80% были выполнены им правильно. Причем не использовала никаких инструкций, как авторы, а только передавала легкие задачки

и тут еще можно прочитать о личном опыте использования https://t.me/AiHubFeed/397
—-


Полезные советы для тех, кто готовит КП по ИИ с помощью нейронок и рассылает по компаниям

Если вы всё-таки решили подготовить КП после курса по вайбкодингу или на энтузиазме

Совет 1. неИспользуйте лучшие практики

Просите модель: «предложи суперидеи для продаж в сфере ИИ, используя лучшие практики. Область - любая»

Совет 2. Добавьте слова триггеры

"экономия", "эффективность", "рост на 40%"
Будьте убедительны!

📩 Руководство компании получив такое КП, да еще с инфографикой и красивыми слайдами - вдохновится (тревожность то растёт: надо опередить конкурентов и получить преимущество от ИИ)

Дальше - сотрудники в очередной раз, по заданию руководства, отвлекаются от своей работы и связываются с вами, что бы разузнать о продукте и его возможностях

Готовьтесь к вопросам на которые у вас не будет ответов. Придется краснеть и оправдаться, но не сдавайтесь - продолжайте собирать "контекст". Встречаться и общаться со всеми кто позовет

🤝 Одна, вторая, третья... встреча

Поздравляю! Вы провели настоящее маркетинговое исследование и узнали, что реально нужно людям на этих местах

Потом вернётесь к модели, расскажете про эти тонкости и ваше решение дорастёт до чего-то живого, с учётом тех самых деталей, которые доступны только специалисту

Модель уже не генератор идей, а пункт обработки, куда вы приносите добытую обратную связь

Спасибо-Пожалуйста!


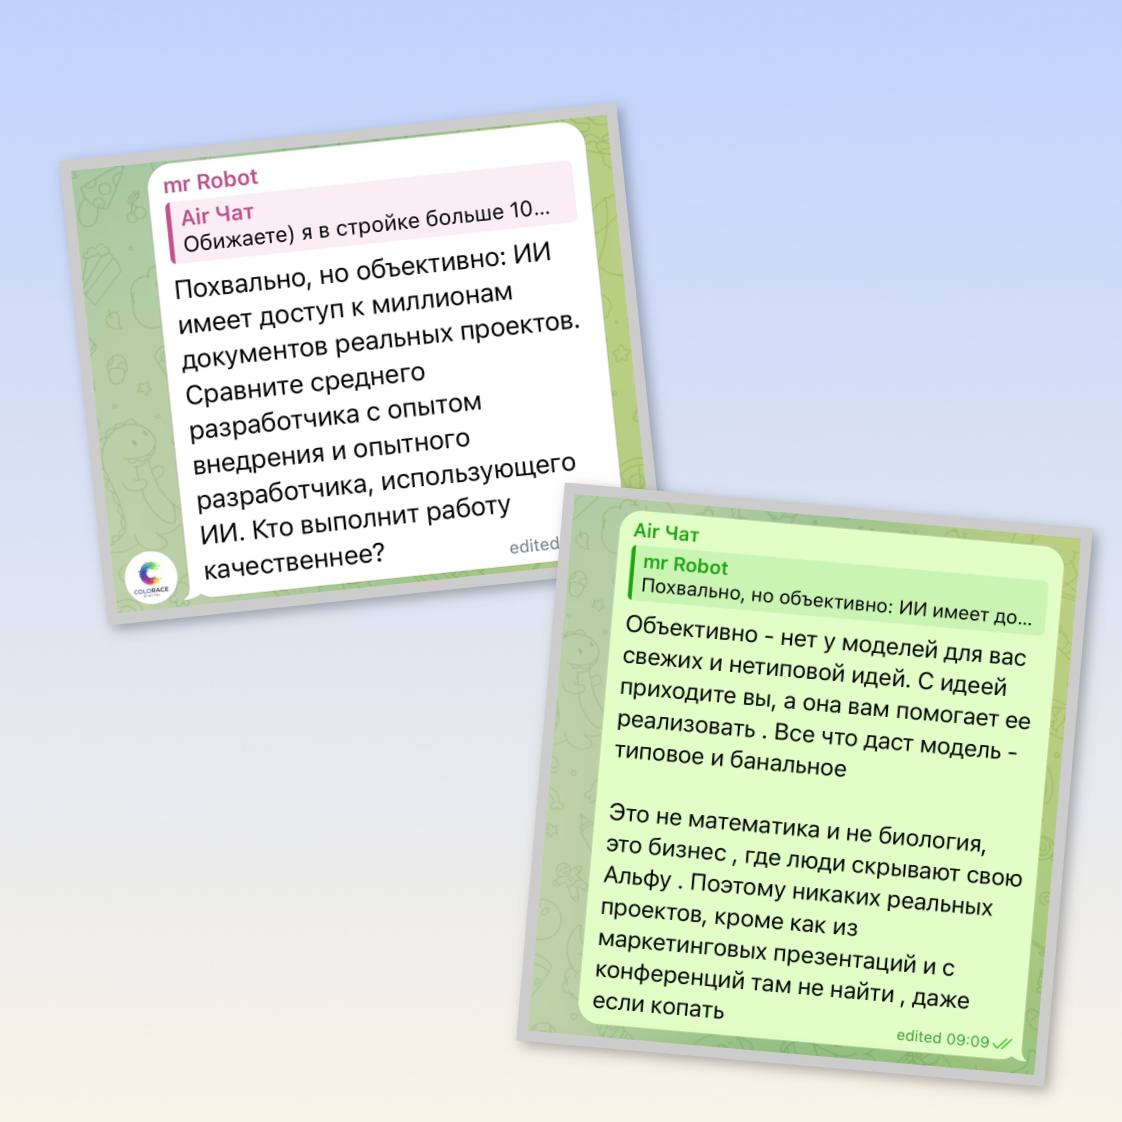
Нет у модели для вас интересных идей на миллион

Когда на стадионе встает один - ему хорошо видно, когда встают все остальные - эффект пропадает

Что доступно всем - теряет в цене

*Из переписки в чате


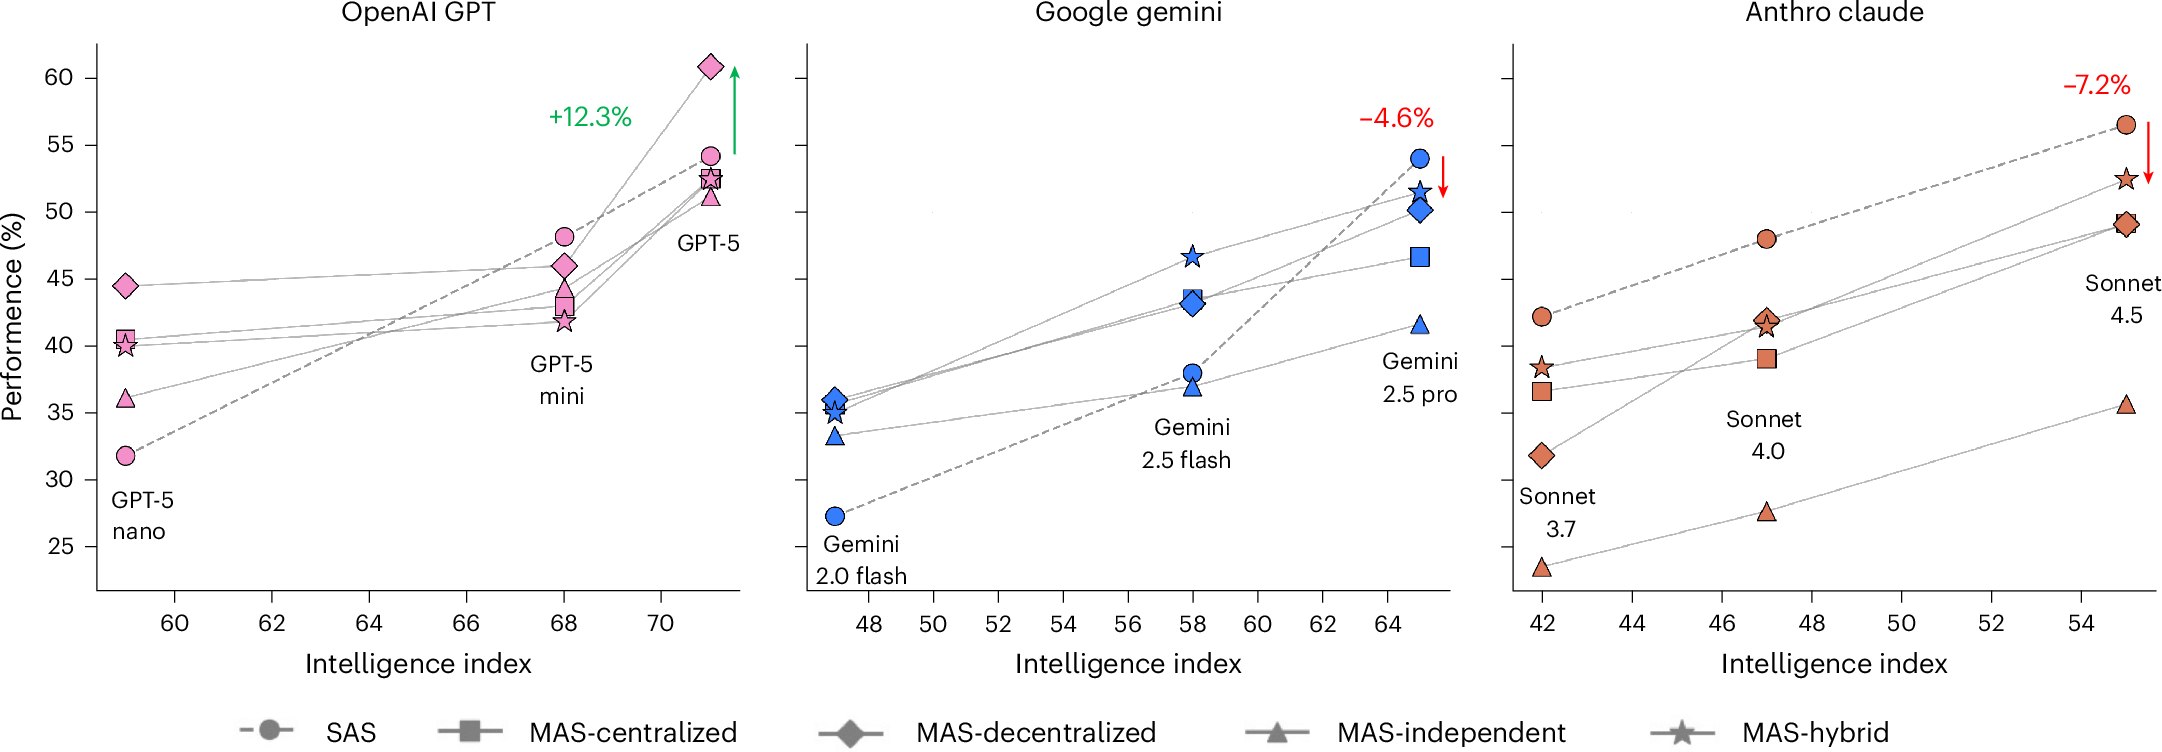
Один в поле воин или когда "команда агентов" делает только хуже

К какому совету прислушаться: "ставь роутер", "запускай субагентов", "сильную модель - архитектором, дешёвую - исполнителем", "параллель"?

На практике часто, пока над проектом работает одна сильная модель, всё движется более-менее, подключаешь команду - падает качество, время уходит на передачу контекста и согласование решений

Исследование на эту тему в Nature Machine Intelligence приходит к закономерному выводу:
Выбирать схему нужно основываясь на структуре задачи

- Независимые направления хорошо отдавать параллельным субагентам
- Связанную цепочку действий лучше вести одному исполнителю
- Чем сильнее одиночный агент, тем меньше дополнительной пользы приносит команда
- Сильный оркестратор не всегда компенсирует слабое исполнение
- Новые связи между агентами нужны, только когда понятно, какую ошибку они должны предотвращать

теперь по порядку...
Сравнивали схемы работы:

▫️ Независимые агенты - решают задачу параллельно, ответы объединяются в конце
▫️ Оркестратор с исполнителями - главный агент делит работу и собирает итог
▫️ Децентрализованная дискуссия - равноправные агенты обсуждают решение и голосуют
▫️ Смешанная схема - есть оркестратор и прямое общение между исполнителями

Все четыре схемы сравнили с одиночным агентом: девять моделей семейств GPT, Gemini и Claude, шесть типов задач от веб-поиска и финансового анализа до кода и последовательного планирования

*Всего авторы проверили 260 сочетаний модели, задачи и устройства команды. Запросы, инструменты и предел вычислительного бюджета уравняли.

📈Результат:
В финансовом анализе команда с оркестратором дала относительный прирост 80,8% (одиночный агент: 34,9% успешных решений, централизованная команда с оркестратором: 63,1%)

В последовательном планировании независимые агенты, напротив, обрушили результат на 71% (одиночный агент: 56,8% успешных решений; независимые агенты: 17,0%)

*Если объединить все задачи и схемы, средний эффект от добавления агентов составил 0%. Улучшения на одних задачах полностью погасили провалы на других


❕Сильный оркестратор не спас слабое исполнение

На BrowseComp-Plus смешанные команды с дорогим оркестратором и дешёвыми исполнителями уступили однородной сильной команде в среднем на 12,6 процентного пункта. Сравнение не идеально, но вывод полезный - хороший план не компенсирует слабый поиск и проверку фактов

Cognition (Devin) увидела похожее в программировании: слабый исполнитель не всегда понимал, когда обращаться к сильному советнику и мог неверно применить его ответ. Заметная польза появилась, когда обе модели были сильными и дополняли друг друга

Какая схема лучше подходит для разных задач

❕Поиск по независимым направлениям = параллельные субагенты

Финансовый анализ тому пример. Один агент изучает отчётность, другой - новости, третий - положение компании на рынке. Когда части независимы, а итог можно проверить и собрать, параллельный запуск имеет смысл

❕Последовательное планирование = один сильный исполнитель

Когда каждый шаг зависит от предыдущего, команда порождает дополнительную работу: синхронизацию состояния. Похожий риск возникает в большом программном проекте: решения о структуре, зависимостях и обработке особых случаев живут в контексте агента и теряются при передаче работы.

❕Проверка результата = отдельный проверяющий

Централизованная проверка лучше сдерживает распространение ошибок. Cognition получила хороший результат с проверяющим, который открывал готовое изменение с чистым контекстом: в среднем он находил две ошибки, около 58% из них были серьёзными

———


Трамп не прислушался к призывам замедлить развитие ИИ


Лучшая оптимизация работы с Astra это отсутствие оптимизации - к такому выводу пришла спустя неделю использования

Просто дать ей достаточно reasoning effort и не мешать лишними делегированиями и микроменеджментом. Тогда она быстрее, точнее и в итоге дешевле

Выбираю high или xhigh, не делегирую другим моделям внутри одного чата, слежу за контекстом, чтобы не допустить разрастания

Новый чат в рамках проекта с скопированным deeplink предыдущего чата помогает не потерять нить, но при этом гораздо менее затратен, чем если бы модель тащила весь старый контекст
(правая кнопка мыши на чате » скопировать » скопировать диплинк)

Много токенов уходит на Computer use - сколько раз читает страницы и делает скриншоты, но если модель делает правильно с 1–2 попыток, это всё равно выгоднее, чем более дешёвая модель, которая ошибается намного чаще, а потом за ней Astra исправляет

*пока так, если найду более эффективный способ оптимизации - напишу

✏️Поделитесь своими наблюдениями


Video oldindan ko‘rish uchun mavjud emas
Telegram'da ko‘rish
Готовы ли вы передать свою мышь - Агенту?

Если да, то прочтите этот пост

Здесь показываю как агент управляет Exсel на ПК. Так же можно работать в 1С , SAP и в других корпоративных программах

Что бы такое стало возможным - нужно дать агенту разрешение на управление в настройках приложения ChatGPT (он же Codex)

Заходите в Настройки и выбираете Управление компьютером (скрин в комментариях)


И что тогда станет возможным:
На ВИДЕО презентация новой модели GPT Astra *озвучку на русском добавила сама.

Все команды, которые дают люди - реализуются через механизм управления компьютером и браузером

Причем ждать выхода Астры не обязательно, все тоже самое делает и GPT 5.6

❕когда агент управляет ПК, можно вмешиваться в его работу и перехватить инициативу, т.к физическая мышь по прежнему активна
——


до Power Query добрались Агенты

Умение работать с Power Query - преимущество на собеседовании, особенно для позиции, связанных с финансами, учётом и аналитикой

За пару лет модели прошли несколько этапов работы с Excel

Сначала мы сомневались, что модель сможет работать с Excel. Затем появились агенты, которые писали формулы внутри таблиц (простые, с ошибками). Сейчас уже надстройки, формулы профессиональные, ошибок минимум

Power Query долго оставался особым случаем: отдельный редактор, M-код и собственная логика преобразований. Казалось, Microsoft надёжно закрыл туда вход для агентов
Все изменилось с появлением Computer Use


Решила пройти барьер с помощью Codex. Таблица и промпт от меня, а

⚡️все остальное делает Codex: открывает файл, перемещает курсор, кликает, прокручивает, вводит текст. Плюс, когда агент работает на вашем компе, удобно контролировать и осваивать инструмент

*видео ускорено. Если возникает мысль: «долго», то встречный вопрос: а надолго ли это «долго»?
—
Air~AI
—


Разгадать загадки Вселенной может «Наследник» неудачной военной программы, который завтра полетит в космос

В 2010 военная разведка США закрыла программу по созданию спутников-шпионов. Два разработанных ею телескопа с зеркалами диаметром 2,4 метра, были переданы NASA. Так началась история Nancy Grace Roman Space Telescope

🔭 Мы видим в телескопе 5% содержимого Вселенной. Примерно 27% - тёмная материя, невидимая субстанцию, чья гравитация удерживает галактики от распада. Ещё около 68 % занимает тёмная энергия - сила, из-за которой космос расширяется всё быстрее. Что скрывается за этими названиями, учёные до сих пор не знают. Телескоп поможет в этом разобраться

Главное его преимущество - огромный размах обзора. Roman должен составить карту распределения тёмной материи и исследовать влияние тёмной энергии на её расширение

Учёные надеются обнаружить тысячи экзопланет за счет приглушения яркого света звезд вокруг и зафиксировать эволюцию галактик с момента Большого взрыва


Давайте проведём мысленный эксперимент:

кому вы доверите управление своим капиталом?
Из информации - только его фото

1- ❤️
2 -👍
3 - 😁
4 - 🔥
5 - 🤔
6 - свой вариант) в комментах


AiHub ✨ Приручаем ИИ | Вайб-кодинг | Ai-first development dan repost
Парадокс сабагентов, роёв и прочих мультиагентных систем

Пост родился как логическое продолжение предыдущего поста про правила, где я намеренно придушиваю возможность запускать сабагентов.

Откуда это вообще пошло. Всё чаще наблюдаю картинку как люди торопятся подключить как можно больше агентов в свой харнесс, при этом даже в один поток еще работу не наладили. Что они ожидают увидеть в таком случае на выходе? Мне не понятно. Думаю, им тоже. Ощущается, что они заражены какими-то постами блогеров или какими-то хайповыми роликами/статьями, воспринимают это как решение большинства проблем, но предметно объяснить какую проблему они этим подходом решают, не могут.

Давайте откатимся чуть назад, чтобы вспомнить, для чего их вообще придумали.

Впервые щупать сабагентов я начал на Claude моделях, когда было жесткое ограничение в 200 000 токенов контекста, а модели могли выбирать не самый оптимальный путь мышления перед реализацией задачи. Тогда сабагенты выглядели как инженерный приём, который позволяет:
1️⃣ Экономить контекст. Сабагент получил задачу, выполнил ее, передал результат основному агенту.
2️⃣ Сузить фокус агента на конкретной задаче. Сабагент и агент работают внутри своих окон, каждый может иметь свой системный промпт (я про промпт, описывающий работу сабагента/агента, а не про тот случай, когда сейчас GPT или Claude могут сами спавнить в любой момент себе помощников, которых вы заранее не прописывали).

Работало действительно неплохо. Можно было делать ресерч одним сабагентом, код писать основным агентом, а тестирование, ревью и обновление документации поручать другим сабагентам, узко настроенным на свой спектр задач. Тогда можно было спокойно закончить достаточно большую задачу до того, как мы переполним контекст и схватим компакт. А компакты в то время своим качеством не славились и многие придерживались принципа "если компакт произошел, то дальше процесс уже стал неуправляемым и надо срочно финалить задачу и перепроверять, не начудил ли агент".

И напомню, что 200к контекста - не совсем те 200к, которые мы можем взять и использовать в полной мере. На старте, пока не появились скиллы и были только MCP, в легкую могло уходить по 30-40к токенов на содержание MCP в контексте, и буфер для сжатия контекста при компакте в районе 40к контекста. Даже на самых оптимизированных конфигах по факту мы имели на старте не 200к, а примерно 140к свободного для работы контекста. Это теперь кажется диким, ведь сейчас на среднем проекте только сбор информации по проекту перед реализацией какой-либо фичи уже может достичь 100к+ контекста.

Далее вендоры стали добавлять собственных системных сабагентов в наши харнессы, там и модель можно использовать попроще и побыстрее, и промпты заранее нужные заготовлены, и обслуживать это не надо. Все работает из коробки. Например, какой-нибудь explore агент для сбора контекста по проекту и последующей передачи его основному агенту, яркий тому пример. И качество компактов сильно подтянули, можно было спокойно переживать 2-4 компакта и все нужные детали всё еще агент учитывал, можно было сильно не переживать, а нужный контекст после компакта добирался. К тому же, у Claude появился 1 миллион контекста, у GPT тоже (но в какой-то момент они свернули не туда, и жестко его порезали). Но этот миллион контекста не работал так надежно, как хотелось бы, часто после 30-40% заполнения уже начинались явные проблемы в работе и потеря фокуса на задаче (сейчас с этим всё гораздо лучше).

Из этого как бы следует логичный вывод. что да, сабагенты нужны, разгружаем основного агента, а он на своем минимальном узкосфокусированном контексте контролирует процесс. С точки зрения задумки всё красиво. Но на практике картина вырисовывается иная:

1️⃣ Основной агент на старте запроса собирает контекст, даже если он это сделал в минимальном размере и поручил основной сбор сабагенту, сабагент заново читает ВЕСЬ контекст, отдает саммари основному агенту. Основной агент, перед тем как начать выполнять задачу, всё равно пойдет читать связанные файлы чтобы посадить новый код в известное ему место, а не по наводке агента по ресерчу. Итого имеем почти двухкратное чтение контекста, а мы еще даже код писать не начали. Время, кстати, тоже теряем. У GPT 5.6 буквально в системном промпте указано, что он должен спавнить сабагента для сбора контекста при любом запросе. Даже когда вы обсудили с ним большую часть реализации, и в целом он сам уже коснулся всех нужных файлов в достаточной степени, чтобы сделать какой-то вывод и распланировать задачу, он все равно будет спавнить агента который опять всё заново будет читать. Это бред. Так быть не должно. Он сам уже все карты на руках имел. Ах да, еще и не забываем что уходит приличное количество токенов на мышление и генерацию промпта от основного агента -> сабагенту, и после отработки сабагента происходит тоже самое в обратную сторону. Экономия, говорите? Ну, нет. Звучит это всё как какой-то заговор на то, чтобы мы больше токенов сжигали. Оптимизация ради оптимизаций порождает отрицательную эффективность.

❓ Что с этим делать? Брать запуск сабагентов под контроль исходя из вашего воркфлоу, а не из-за пожеланий вендоров в системном промпте. Допускаю, что каких-то кейсах запуск агента по ресерчу будет ценным шагом, особенно на новых фреймворках когда надо перелопатить и код в проекте, и документацию, и внешние источники с документацией библиотек. Это скорее крайние случаи в проектах с непопулярным набором фреймворков и библиотек. Иначе у основного агента мозги от кол-ва информации закипят и контекст действительно забьется мусором. Мои советы релевантны скорее для общей массы веб проектов. Конечно же, крайние случаи надо рассматривать индивидуально.

2️⃣ Потеря важных деталей при передаче задачи сабагенту и возврат отчета обратно агенту. У себя я это выявил в результате достаточного долгосрочных тестов и наблюдений и этот факт уже ничем не перебить. Когда у основного агента есть достаточно жирный промпт с кучей детальных инструкций, он далеко не всегда все эти детали ответственно передает. Из-за чего сабагент начинает работать с самого старта над некорректно поставленной задачей. И вернет отчет тоже с некоторой долей вероятности, тоже с потерей деталей уже с его стороны. Писал об этом тут , в бизнес агентах это даже мешало, что пришлось отключать на уровне конфига возможность спавнить помощников.

❓ Что с этим делать? Отключать на 100%, как мы ранее уже решили, конечно их не будем, а вот контролировать - обязательно. Для передачи задач и отчетов между агентом и сабагентом нужно заключать в рамки строго контракта: что, в каком виде и с какой степенью глубины и детальности должно передаваться. Это можно буквально зашить в правилах агента, он будет составлять задачу для сабагента в нужном вам формате и указывать ему формат отчета, по которому он должен будет вернуть результат работы, что значительно повысит качество их взаимодействия и сбережет ваши нервы.

Итого, действительно полезное применение этого я вижу только в некоторых проектах где нужен глубокий ресерч по проекту и документации, и в процессах ревью кода, где чистая изолированная сессия это базовый минимум для честного ревью. Кто и как это реализует это уже другой вопрос, можно и другой модели это отдать, и даже отдать какому-то удаленному ревьюиверу, без проблем. Главное уловить суть, что если мы хотим адекватный расход токенов и быстрое выполнение задач, мы должны взвесить что для нас важно. Как по мне, лучше пережить пару компактов на гпт (на клоде с его миллионом контекста, скорее всего и не придется), но работать в один поток и сабагентов пускать строго под присмотром по установленному контракту, где ожидаете это вы, а не где вздумается модельке.

А что с роями? а я даже это обсуждать не хочу, пока это игрушки для энтузиастов с безлимитным доступом к токенам. Возможно, за пределами вайбкодинга это и применимо, но точно не здесь. Чтобы рой ожил и выполнял свои задачи, при этом не мешая друг другу и не трогая одни и те же файлы, придется плодить пачку worktree, которые еще потом придется как-то сливать в одну ветку и решать кучу конфликтов.

Что думаете? Может я их "готовить" не могу, и у вас сложилось всё куда удачнее и стабильнее с мультиагентами?


Ox Alpha , Ox Ramp

В эти дни на рынке ИИ одновременно произошли три события:

- Stripe официально подтвердила покупку OpenRouter
- На следующий день на OpenRouter и на платформе OpenCode появилась загадочная модель Ox Alpha.
- Ramp, конкурент Stripe в мире корп финансов, в этот же день запустил собственный сервис маршрутизации моделей Router

*Router (Ramp) сейчас дает $26 стартового кредита для новых пользователей. (перед получением кредита 'https://t.me/realtimeforai/477?comment=9606' rel='nofollow'>прочтите)
*Ox Alpha тоже пока бесплатна, и на OpenRouter, и через OpenCode Zen. Вчера в чате настраивали. Но только неделю бесплатно

Что известно про Ox Alpha
По характеристикам это флагманский продукт. Модель позиционируют как заточенную под длинные агентные задачи и написание кода. Отзывы хвалебные

*оператор заявляет о пропускной способности до 100 триллионов токенов в сутки, такой объём сопоставим с суммарной мощностью нескольких крупнейших лабораторий мира. Поэтому споры о том, кто ее выпустил продолжаются

В комьюнити лидирует версия, что это GLM-5.3 от китайской Zhipu AI, вчера версия усилилась: независимые исследователи обнаружили в служебных логах Java stack-trace с внутренними именами классов API Zhipu и полное совпадение токенизатора по 30 из 30 проверенных проб

Версия про доработанный Cursor Composer тоже существует (я ее придерживаюсь), и у неё есть своя логика: десятки триллионов токенов в сутки больше похожи на инфраструктуру вроде xAI, чем на возможности самой Zhipu. По этой версии Composer дообучен поверх архитектуры GLM. Слабое место версии в том, что она не объясняет находку от 22 августа: Java stack-trace с внутренними именами классов API именно Zhipu - это признак того, что запрос обрабатывался на серверах самой компании


Кто и когда вытеснит OpenRouter

Сейчас через платформу проходит более 10 триллионов токенов в сутки, доступны свыше 400 моделей, а сообщество превысило 10 миллионов разработчиков и компаний. Рост в 10 раз ежегодно с момента основания в 2023 году

OpenRouter не берёт наценку на сам токен, а зарабатывает на пополнении баланса: 5-5,5%

Крупные компании достигнув огромных оборотов на сервере уже не хотят платить эти 5,5% и начали выбивать у OpenRouter и у самих лабораторий прямые скидки. Сами лаборатории открывают собственные каналы продаж. Плюс стали появляться конкуренты, такие как Ramp

Ramp уже 3 года использовала такую маршрутизацию внутри себя и теперь открыла её всем. Сервис бесплатен до конца 2026 года (нет процента для разработчиков), даёт новым пользователям $26 стартового кредита. У них уже есть доступ к моделям OpenAI, Anthropic, DeepSeek, Moonshot, Minimax, Nvidia, xAI и Z.ai - с оговоркой об удержании данных клиентов (данные хранятся год, политика по умолчанию не даёт отказаться)

Почему Stripe

Она уже обрабатывала платежи самого OpenRouter. Покупка позволяет Stripe встать не рядом с денежным потоком, а прямо в его середине и одновременно дать OpenRouter то, чего одинокому шлагбауму не хватало. Если маршрутизация запросов и денежные расчёты становятся единым продуктом, уйти клиентам уже сложнее: клиенту приходится менять не адрес эндпоинта, а весь способ учёта, биллинга и контроля расходов.

New York Times называет $7,5 млрд официальную цену сделки, в основном акциями Stripe. Некоторые издания высмеивают версию компании о причине покупки OpenRouter. Stripe разослала инвесторам письмо, в котором сообщила, что считает 1 января 2026 года началом «сингулярности» и руководствуется именно этим в своем решении уже восемь месяцев

Более приземлённое объяснение в том, что выручка компании от AI- и крипто-клиентов выросла за год больше чем вдвое. Клиентские базы Stripe и OpenRouter и так пересекались


ИИ для работы с Excel и отчетами: реальный кейс от Элис

А кто такая Элис? она из команды корпоративные финансы Anthropic, отвечает за аналитику и показатели, которые входят в квартальную презентацию для CFO и совета директоров, а также ведёт ежемесячный план/факта

Её команда собирает информацию от всех остальных финансовых подразделений и связывает воедино. Пока презентация собирается, цифры могут обновиться несколько раз. До последнего момента кто-то что-то правит, ну как обычно, и после каждого обновления приходится заново перечитывать весь документ. Цифра на одном слайде расходится с комментарием на другом и прочие несостыковки в отчете

Инструменты, которые она использует:

Claude Cowork
для сверки цифры между слайдами, проверки связности, для написания комментариев в уже сложившемся корпоративном стиле к план/факту

Claude for Excel
для работы с финансовыми моделями - прослеживает ссылки между листами, диагностирует баги модели

коннекторы Google Workspace и Slack
достаёт решения и их обоснования из документов, писем и длинных переписок


⚡️Как применить в своей практике

-Проверка презентации перед показом

Примерный промпт:
«Сверь, что каждая цифра и каждое утверждение в тексте соответствуют единому источнику данных [укажите, какому]. Прочитай презентацию так, как её прочитал бы член совета директоров, впервые видящий этот материал: найди места, где текст противоречит сам себе, а также места, где предполагается контекст, которого у читателя нет»


- Ежемесячный отчёт «план/факта»

Загружаем пример отчета за прошлый месяц как образец корпоративного стиля. Смысл в том, чтобы все месячные отчёты были в едином стиле

- Разбор финансовой модели

попросим Claude for Excel (это надстройка в Excel) кратко описать логику модели, допущения и структурные проблемы, которые стоит проверить в первую очередь

❕Сейчас и Claude for Excel и GPT for Excel умеют следовать по ссылкам между листами. Стало проще отслеживать всю цепочку в книге и найти причину, по которой баланс не сходится, даже если ошибка спрятана на другом листе

——
* В Excel работайте через надстройки - так меньше ошибок и потраченных токенов
——
🧑‍💻И отдельная статья о том как их дата-аналитики работают в Claude
——


Архитектурная дыра в API Claude, GPT и Gemini

Оказывается, без взлома и атак можно вытаскивать скрытые рассуждения модели (и не только) об этом новое исследование *обратите внимание на авторов 🫶

❗️Безопасность всей линейки моделей зависит от самой слабой модели в ней

А все из-за жадности вендоров) Что бы не сливать внутренние рассуждения, они перестали выдавать сырые chain-of-thought, но при этом не хранят его у себя на сервере

Вместо этого зашифрованный блок возвращается клиенту, и клиент присылает его обратно с каждым следующим запросом. Такие блоки можно переносить: между разными диалогами; аккаунтами разных пользователей; разными моделями одного провайдера

Сильная модель создаёт рассуждение
↓
забираем зашифрованный блок
↓
передаём его слабой модели того же провайдера
↓
уговариваем слабую модель перепечатать содержимое
↓
получаем скрытое рассуждение

Т.о слабая и легче поддающаяся jailbreak-модель читала reasoning сильной модели и выдавала ее пользователю
___


Dealer.AI dan repost
Про культурный код моделей и соответствие каким-то ценностям LLM.

Мне много стали присылать в лс такую новость. 😬

Тлдр. Модели AI будут проверять на соответствие культурным ценностям, для получения звания национальных или суверенных. 😐

Я очень много писал о том, почему такие проверки сделать непросто. Вот пример. 🦻

Если коротко, на просторах сети мало русских текстов в отношении доли к английским. И тк модели учатся в тч на этих текстах, их доля там превалирует, ну иначе, вам не обучить модель на 700B параметров только на ру базе, это будет не оптимально. Да есть синта, соглашусь, но синта не даёт такой буст, как мультилингв данные.

Таким образом, на этапе уже предобучения у вас лежит возможность сгенерировать не то, что соответствует культурном коду вашей страны. Особенно если перейти на запрос на английском или китайском языках.

Что же с ру LLM?

А теперь если посмотреть на все модели в ру сегменте, то это или Qwen-like модели, с инициализацией с весов (а значит часть информации уже лежало там с претрена китайцами), или модели, где 65%+ не ру дата в претрене.

Отсюда остаётся вопросы:
Как пройти проверку?
Какие эксперты, на каких сетах и на каком языке будут проверять соответствие?

В целом, тк уже на уровне языков в обучении можно пробить модель на чужой культурный код, то остаются только методы:
- гвардов сверху и спец логики рядом, тот же RAG (если обстрел по апи), но это не модель уже а система

- sft и RL элаймент модели под нужное поведение под сеты оценки, а я не уверен, что методология и сеты оценки будут закрыты от оцениваемых.

И оба способа НЕ идеальны, тк и в гардах и sft/RL есть понятие OOV примеров, те запросов, которые модель никогда не видела и даже не смогла на уровне "эмерджентности" аппроксимировать. Те вас рано или поздно пробьют всеравно. А ещё есть галлюцинации... 🚬

Таким образом, пройти проверку можно, есть и хаки, и честные способы, но и есть понятные причины рисков. И будет жутко интересно, особенно, когда какая-то модель пройдёт тесты, а потом в какой-то соц сети её пробьют, выложат скрины и скажут, ну как так. Что уже не раз бывало. 👍

#ИИзнанка


Opus 5 всё чаще отвечает так, когда проверяет архитектуру проектов перекрёстным ревью с Sol 5.6


Совет директоров: Где реальная отдача от внедрения ИИ? Где ROI?

Команда внедрения AI:
В экономии времени и упрощении работы. Сотрудник тратит на подготовку отчетов уже не 5 часов, а час

СД:
Как это отражается на P&L?

Команда:
Хм. У сотрудника высвобождается время, и он может заняться другими задачами

СД:
Какими? Задач не прибавилось. Сотрудников не сократили. Расходы не снизились. Выручка не выросла. Срок всего процесса почти не изменился

Команда:
Мы тут ни при чем. Отчет попадает в прежнюю очередь согласования. Его по-прежнему проверяют те же люди, и он может несколько дней ждать подписи. Мы не отвечаем за изменение процессов

СД:
Вы же внедряете AI-агента. Он должен автоматизировать работу

Команда:
Агент автоматизирует свою часть. Чтобы получить бизнес-эффект, хорошо бы компании убрать лишние звенья и пересмотреть маршрут процесса

СД:
Но вот компания «Антропен» рассказывает на конференциях, что уже получила огромный эффект. Привлекли клиентов, сотрудников сократили. У конкурентов все получается. Почему у нас опять сложности?

Команда переглядывается. Кто-то вполголоса:
На конференциях AI обычно окупается быстрее, чем в P&L

СД:
Давайте пригласим нашего AI-first CEO

Как вы предлагаете рассчитывать финансовую выгоду от внедрения Агента?

AI-first CEO:
Последовательно. Нам нужны доказательства на пяти уровнях:

1. Техническая производительность
Насколько агент стабилен, безопасен, быстр и экономичен

2. Пользовательское принятие
Пользуются ли люди им в реальной работе. Доверяют ли

3. Операционный эффект
Стало ли быстрее, дешевле и точнее? Сократилось ли количество переделок и сбоев.
Вот здесь появляется измеримый эффект, но он еще не финансовый

4. Стратегические результаты
Улучшился ли сервис. Выросло ли удержание клиентов. Сократилось ли число простоев. Ускорились ли поставки или продажи

5. Финансовый эффект
Дошел ли результат в итоге до выручки, маржи, ROI
Покрывает ли выгода полную стоимость владения решением


Только пройдя всю эту цепочку, мы сможем показать ROI, который можно проверить

Продолжение следует...


Похоже, пора делать серию постов про корпоративных AI-агентов… который нужен не всем и не сейчас

Когда общаешься с собственниками и руководителями МСП, понимаешь, что многим для начала достаточно настроить и освоить Codex или Claude в качестве помощника для ежедневных задач, который может сильно облегчить и ускорить работу

Поэтому обычно предлагаю: давайте сначала помогу вам освоите ИИ, а уже потом будем смотреть, какие процессы в компании имеет смысл передавать агенту
*О внедрении в крупные компании поговорим отдельно

Пару лет назад в чате про AI познакомилась с @anikina_mariia у неё был один из первых стартапов по внедрению AI в МСП. Недавно пообщались на эту тему, по её наблюдениям:
многим компаниям до ИИ ещё капец как далеко, им бы сначала элементарную цифровизацию внедрить, чтобы данные просто появились в цифровом виде.


Особенно это касается реальных производств со старым оборудованием, где всё в блокнотах. Но даже если данные есть, ИИ не спасёт, если в управлении хаос: функции дублируются, ответственности нет, а собственник сам лезет в работу каждого прораба и снабженца, становясь тем самым «бутылочным горлышком». Поэтому я решила для начала обучать руководителей как готовить компанию к внедрению ИИ


Вчера Мария выложила выдержки из отчёта про ИИ-агентов в России и мире . В нем есть и о корпоративных агентах, например:

- 51% AI решений в международной практике приходится на внутренние, вспомогательные функции компании: коммуникации, документооборот, цепочки поставок и только 37% на клиентский сервис, маркетинг и продажи

- готового рынка корпоративных агентов в России пока нет: среди 12 публичных российских продуктов ни один не дотянул до статуса полноценного агента. 8 из них напоминают ассистентов и чат-ботов, а 4 оказались платформами-конструкторами («Яндекс»*, «Сбер», Just AI, МТС MWS)

*С платформой Яндекс ai studio я работаю, для построения агентов для российского рынка - удобный инструмент

❗️Вообще сложно представить, о каком готовом рынке AI-агентов идёт речь: как можно сделать универсального агента для всех? Тут нужна та самая «последняя миля» - архитектурная настройка под конкретный процесс компании, и эту работу ни один вендор за компанию не сделает

——-


Душнила, бюрократ, эксперт и это далеко не полный набор эпитетов, которыми Gemini способна наградить участников разговора при анализе аудио

Конечно это не диагноз личности, а впечатление модели от прослушанного аудио))

Модели в Google AI Studio могут анализировать в записи не только слова, но и эмоциональный фон разговора: смену тона и темпа, паузы, перебивания, смех, вздохи, наложение голосов.
Это потому, что в Google AI Studio модели получает само аудио. Запись при загрузке превращается в аудиотокены и поступает в модель вместе с запросом

Поэтому можно попросить её показать:
- после какой реплики изменилась манера общения
- кто чаще перебивал
- какие возражения повлияли на ход обсуждения...

В Google AI Studio разбор аудио быстрее, чем в Codex потому что маршрут обработки короче. Codex сначала конвертирует запись, нарезает, запускает распознавание, собирает транскрипт и только потом анализирует текст (по дороге может что-то растерять).

С Gemini всего это делать не нужно, она может сразу проанализировать как содержание, так и звучание

*Остается только обойти ограничения самого Google

20 ta oxirgi post ko‘rsatilgan.