


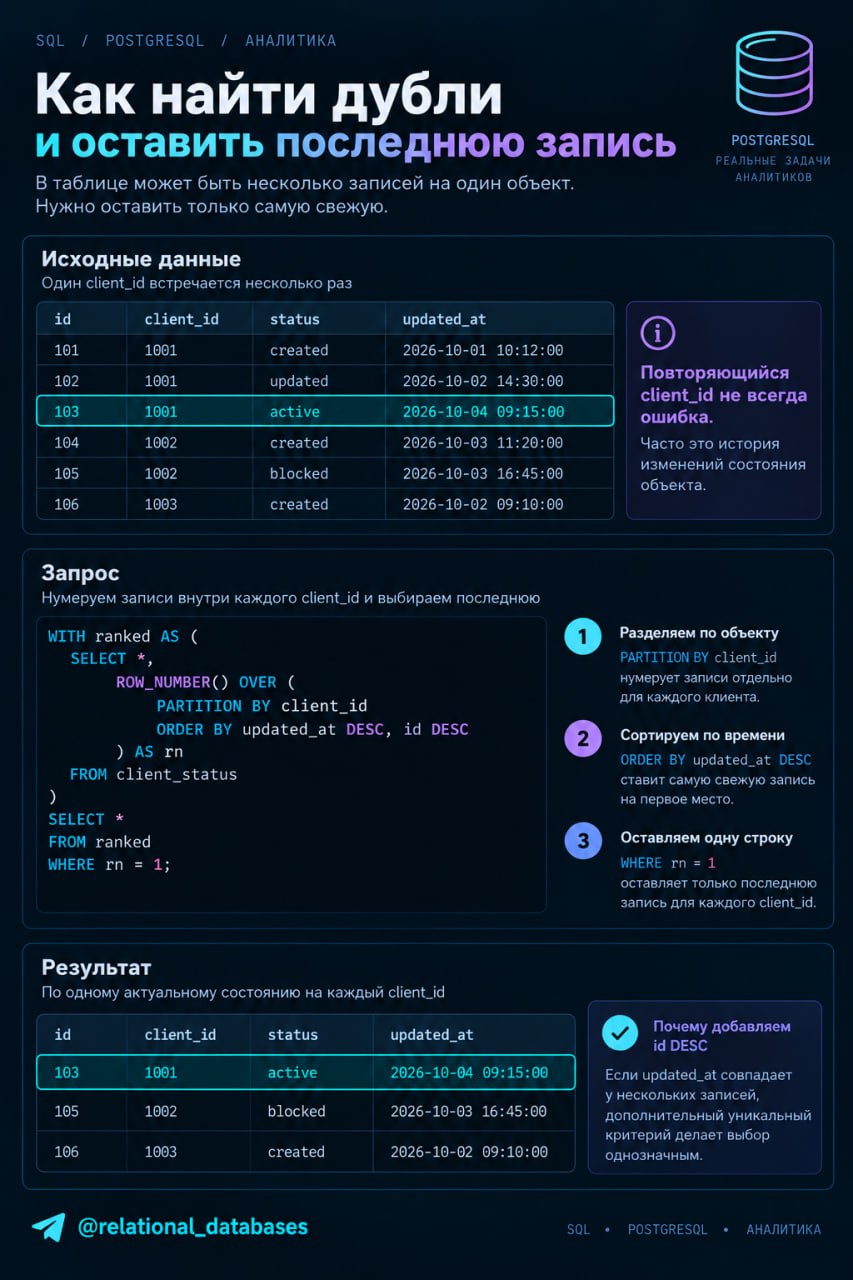
❗️ Как найти дубли и оставить последнюю запись
Одна из самых частых задач аналитика, это получить одну актуальную (последнюю) запись на каждый объект.
Например, в таблице по одному клиенту хранится несколько состояний: создан/проверен/одобрен/заблокирован.
Формально client_id повторяется. Но это не обязательно ошибка - таблица может хранить историю изменений (см. пикчу)
Давайте, разберем, как выполнить эту задачу (на примере постгре)
❗️ Сначала найдём повторяющиеся ключи
SELECT
client_id,
COUNT(*) AS cnt
FROM client_status
GROUP BY client_id
HAVING COUNT(*) > 1;
Такой запрос покажет клиентов, у которых больше одной записи. Он не обязателен, а выполянется скорее для диагностики, чтобы понять у каких client_id вообще есть несколько строк и сколько таких случаев.
Но если нам нужно актуальное состояние клиента, просто удалить повторные строки нельзя.
Нужно определить, какая запись считается последней.
❗️ Выбираем последнюю запись через ROW_NUMBER()
WITH ranked AS (
SELECT
client_id,
status,
updated_at,
id,
ROW_NUMBER() OVER (
PARTITION BY client_id
ORDER BY updated_at DESC, id DESC
) AS rn
FROM client_status
)
SELECT
client_id,
status,
updated_at
FROM ranked
WHERE rn = 1;
Здесь происходит три вещи.
➖ PARTITION BY client_id - Записи нумеруются отдельно для каждого клиента.
➖ ORDER BY updated_at DESC - Самая свежая запись получает первый номер.
➖ WHERE rn = 1 - В результате остаётся только одна актуальная строка на каждого клиента.
❗️ Зачем нужен дополнительный критерий сортировки
У двух записей может совпасть updated_at.
Если сортировать только по времени, порядок между такими строками будет неоднозначным.
Поэтому нужен дополнительный критерий, который делает выбор стабильным.
В примере используется id DESC, но в реальной системе лучше опираться на поле, которое действительно отражает порядок изменений: номер версии, последовательность события или другой бизнес-критерий.
❗️ Почему не использовать просто MAX(updated_at)
MAX(updated_at) действительно найдёт максимальную дату.
Но он не вернёт автоматически status, id и остальные значения именно из нужной строки.
А если потом соединять результат обратно с исходной таблицей, одинаковые значения updated_at могут снова вернуть несколько записей.
❗️ И главное правило:
Прежде чем удалять дубли, сначала определите бизнес-ключ и смысл повторных записей. Повторяющийся client_id может быть ошибкой данных. А может быть совершенно нормальной историей изменений.
#sql #postgresql
📱 Подписаться на канал
💻 Курс автора по SQL DDL