


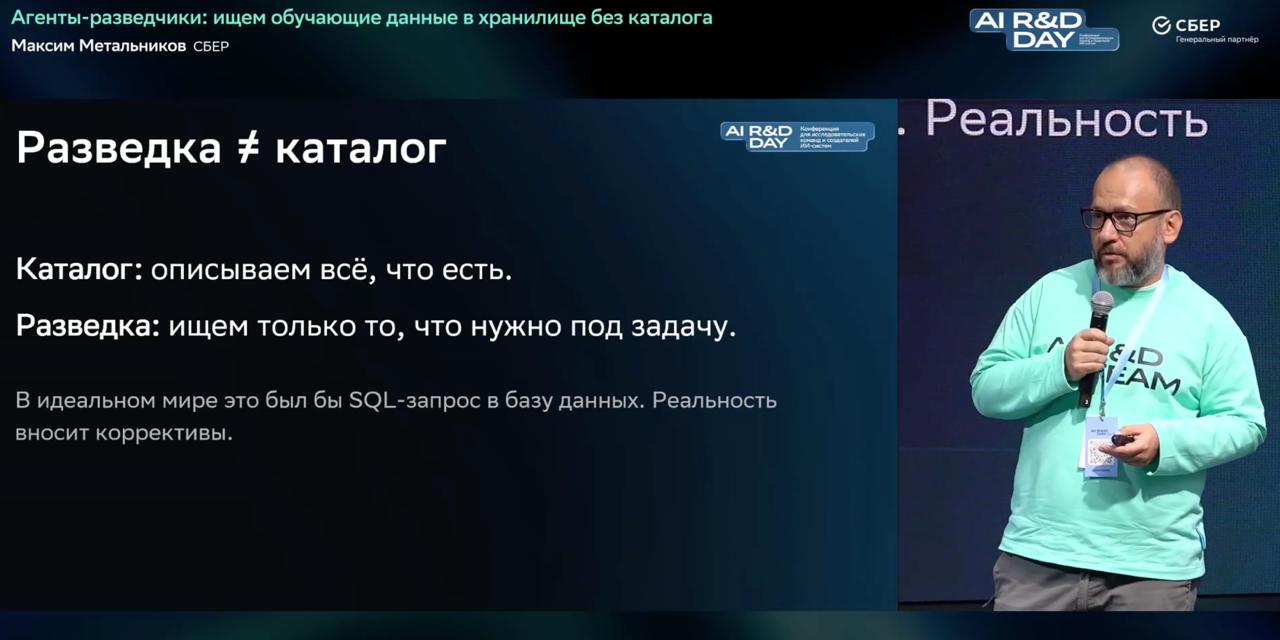
🔎 Агенты-разведчики: ищем обучающие данные в хранилище без каталога
Для претрейна речевых full-duplex моделей нужны сотни тысяч часов речи. Но найти подходящие данные — отдельная инженерная задача: датасеты раскиданы в S3-подобных хранилищах, у каждой команды свои наборы, а знания о них разбросаны по внутренним и внешним источникам, нужно постоянно все обновлять, в идеале без участия человека!
В рамках AI RnD Day Максим Метальников рассказал, как мы решили эту задачу с помощью небольших AI-агентов, которые самостоятельно исследуют хранилище и собирают структурированную информацию о датасетах.
📌 TLDR
В процессе бесконечного сбора речевых данных мы сделали агента-разведчика: он получает задачу, исследует доступное хранилище, скачивает небольшие сэмплы, анализирует аудио и метаданные, читает документацию и в конце формирует карточку датасета. Главная идея — разведка ≠ каталог. Нам не нужно описывать всё, что существует, и тратить время на лишнюю бюрократию. Нужно быстро найти данные, релевантные конкретной задаче. При этом агент работает локально, а данные о внутренних датасетах не уходят во внешние модели.
⚙️ Что внутри
Важная часть архитектуры — self-contained tools. Тул — это буквально скрипт с docstring-шапкой. Функция discover_tools() собирает описания доступных инструментов и передаёт их агенту. Чтобы добавить новую возможность, достаточно положить ещё один файл в директорию. А выполнение унифицировано через один execute: модель сама может собирать shell-команды в последовательные пайплайны.
🔬 Как агент исследует датасет
Разведка идёт примерно в таком порядке:
1. Листинг — что вообще лежит в хранилище: расширения, дерево каталогов, объём.
2. Семплирование — несколько файлов с начала, середины и конца датасета.
3. Анализ аудио — формат, sample rate, количество каналов, длительность.
4. Анализ метаданных — схема полей, транскрипты и другие доступные признаки.
5. Анализ документации — что написано о датасете в сопутствующих источниках.
6. Вердикт — насколько всё это релевантно исходной задаче.
И здесь начинаются самые интересные проблемы.
💥 Проблема №1: слишком большие ответы тулов
Если просто дать агенту s3-ls, то на большом датасете можно получить огромный список файлов. В одном из экспериментов тул вернул 128k объектов, ответ занял 65k токенов, а на выполнение ушло около 7 секунд. В результате агент умер раньше, чем успел что-либо понять.
Вывод довольно важный: за размер результата отвечает тул, а не модель. Модель заранее не знает, сколько данных вернёт вызов. Поэтому бесполезно писать в system prompt "будь аккуратнее с большими ответами".
⏱ Проблема №2: бюджет на выполнение
Даже если контекстное окно позволяет обработать большой ответ, у агента есть общий бюджет на время. Один неудачный вызов может съесть весь лимит. Более того, неоднозначное сообщение об ошибке может привести к повторению того же самого вызова. Поэтому статус выполнения тула становится фактически микропромптом.
Например: "Do NOT repeat this command" или "Use a quick estimate, sample a few files".
🧩 Проблема №3: свободный формат результата
Если просто попросить агента "опиши датасет", структура карточки начинает плавать. В одном запуске модель указывает параметры (domain, files, size и duration), в другом — что-то одно. Где-то может появиться информация, которой в реальности не было в источнике. Поэтому необходимые поля мы перенесли непосредственно в интерфейс тула write_card().
🔚 Выводы
Когда данных становится слишком много, проблема уже в том, как правильно дать модели доступ к внешнему миру. В результате агент превращается не просто в чат-бота, который умеет вызывать инструменты, а в полноценного разведчика — с ограниченным бюджетом, контролируемым поведением и структурированным результатом.
И главное — такого агента можно переиспользовать другим командам для своих задач, не начиная исследование данных с нуля.
🔗 Более подробно — в презентации Максима (оставим в комментариях файлом) и в записи выступления (5:52:30 тайминг).
#agents #speech #fullduplex #paperwatch #conference