


⚡ Как ускорить LLM на длинном контексте
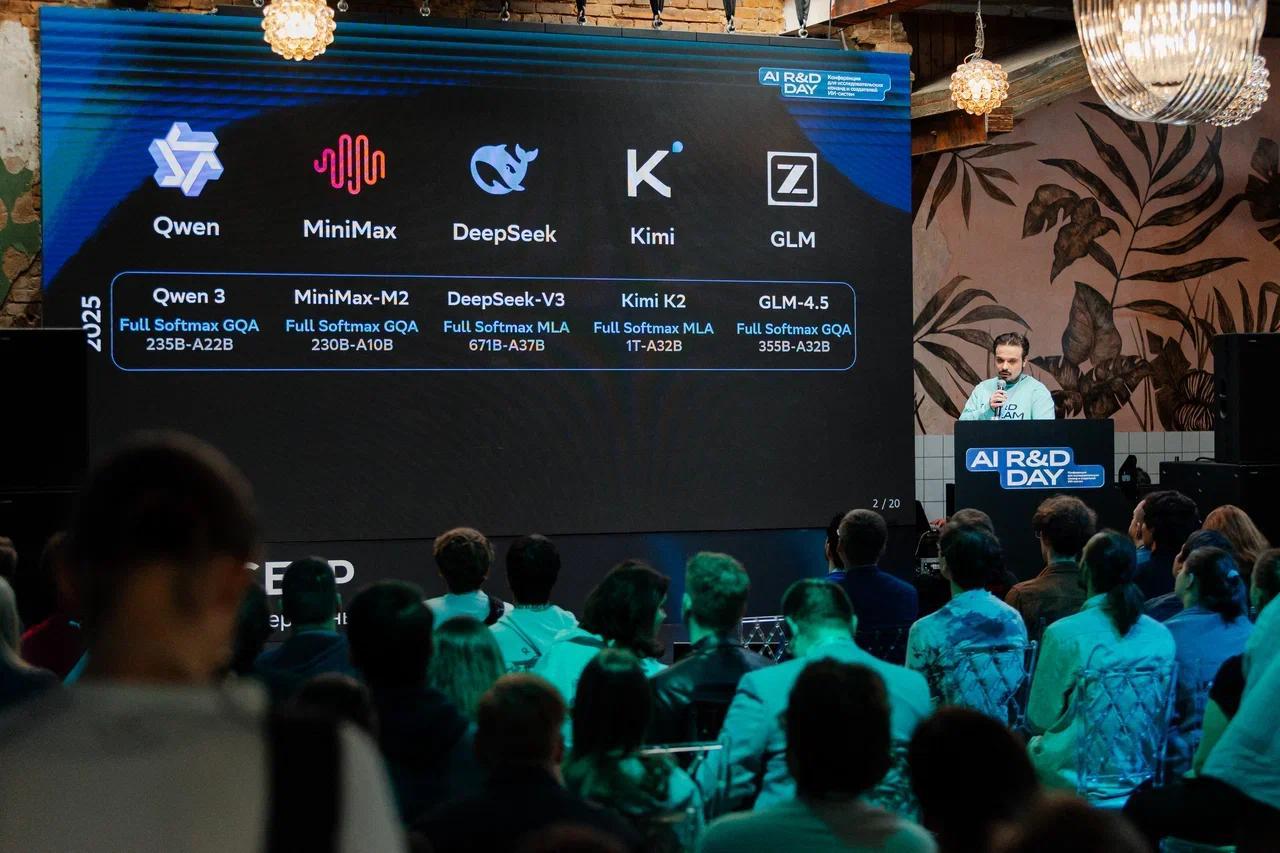
На AI RnD Day Никита Арсенин разобрал альтернативы классическому механизму внимания и показал результаты экспериментов команды. Он рассказал, как современные LLM избавляются от главного ограничения обычного attention — квадратичной зависимости стоимости от длины контекста, и почему в новых моделях всё чаще появляются гибрные подходы.
📌 TLDR
Ускорять внимание можно двумя способами: выбирать из контекста только нужные токены или сжимать историю в состояние фиксированного размера. Первый подход сокращает дорогую агрегацию, второй убирает растущий KV-кеш. Но у обоих есть ограничения по доступу к деталям, поэтому их комбинируют с полным вниманием. В экспериментах команды sparse attention дал ускорение генерации в 4,8 раза на длинном контексте, а гибрид GDN + Attention Residuals — отдельно +6,2 п. п. на MMLU.
🔎 Sparse attention: сначала найти, потом прочитать
В классическом трансформере query сравнивается со всеми keys, затем модель агрегирует соответствующие values. А в показанной схеме разреженного внимания дешёвый индексатор просматривает контекст и выбирает top-k позиций. Дорогая агрегация выполняется только по ним. Для последовательности длины L её стоимость снижается с квадратичной O(L²) до O(Lk). Но поиск не бесплатный: в этой схеме индексатор всё ещё даёт квадратичный член. Выигрыш в том, что он заметно дешевле полного внимания.
🧠 Linear attention
Отдельные key/value всех прошлых токенов не хранятся. Они последовательно обновляют матрицу состояния S. В простейшей схеме со слайда: Sₜ = Sₜ₋₁ + vₜkₜᵀ
При фиксированных размерностях состояния память и стоимость одного рекуррентного шага не растут с длиной контекста: O(1) вместо O(L). Суммарная работа механизма внимания для L шагов становится O(L), а не O(L²).
Обратная сторона медали — история сжата. Нельзя просто обратиться к отдельному старому KV, как в full attention. Поэтому гибрид может чередовать, например, три линейных блока с одним полным: большую часть слоёв сделать дешевле, но оставить доступ ко всем позициям контекста.
🛠 Инфраструктура
Наивные реализации DSA и линейного внимания поверх LLaMA-3.1-8B-Instruct показали ускорение в 2,6–3,75 раза на длинном контексте. А при сравнении PyTorch-реализации Gated DeltaNet с FlashAttention-3 линейное внимание стало быстрее лишь примерно на 200K токенов.
Наша команда не ограничилась заменой слоя: адаптировала cuDNN-ядра для DSA/NSA, написала Triton-ядра для DSA и DSA + sliding window attention, оптимизировала линейные механизмы и Attention Residuals. Последние меняют смешивание выходов по глубине сети, а не отбор токенов контекста.
📊 Что получилось
Модель с разреженным вниманием MSA справилась с генерацией примерно за 1,9 секунды, а базовый вариант с обычным вниманием MQA — за 9,2 секунды. Ускорение — в 4,8 раза.
В отдельном эксперименте гибрид GDN + Attention Residuals обошёл full-attention baseline на 6,2 п. п. по усреднённому MMLU после примерно 110В обучающих токенов. Важно отметить, что это результаты конкретных конфигураций, а не гарантия для любой LLM.
🔗 Более подробно — в презентации Никиты (в комментариях файлом) и в записи выступления (тайминг: 1:07:00).
#llm #attention #conference #paperwatch