


И еще одно видео по теме Jev CEO: I made ChatGPT, now I'm building what's next, оно датировано 1 июля 2026 года, еще до релиза Jev.
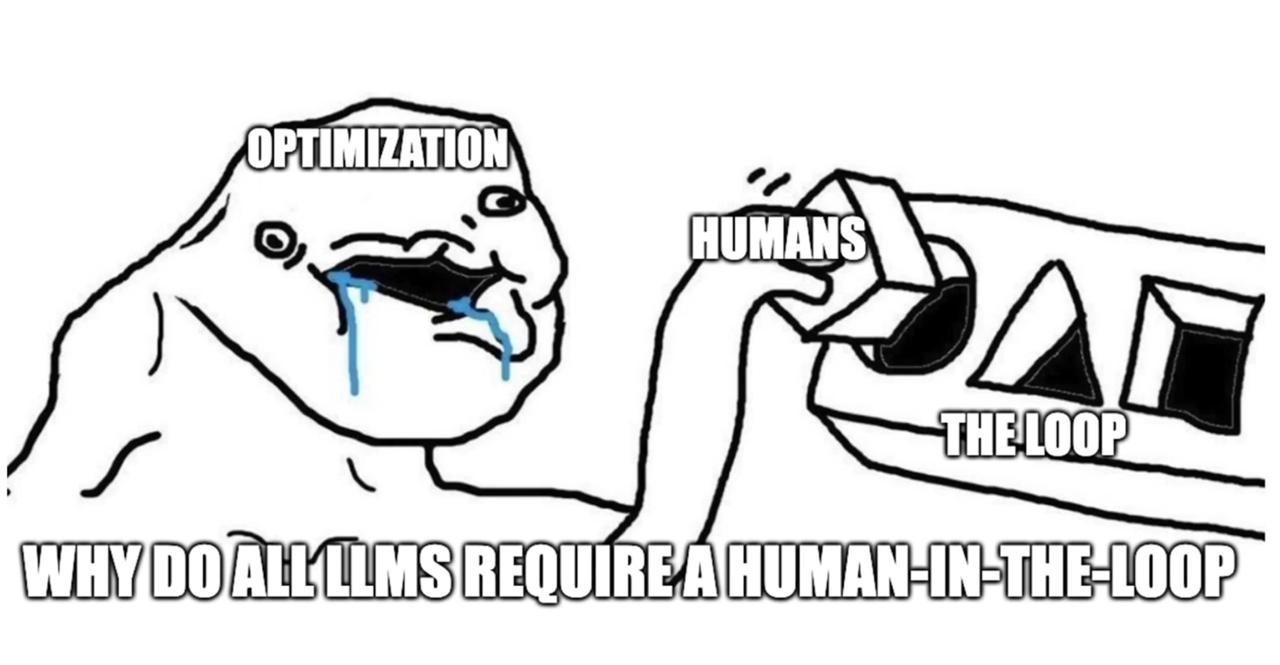
В нем очень хорошо рассказывают про проблемы с современными моделями - "Why do all LLMs require a human in the loop? The simple answer is we literally put them in the loop" — то есть человек буквально был встроен в процесс обучения
через RLHF (Reinforcement Learning from Human Feedback).
Надеюсь вам стало понятней, как и мне.
Думаю в скором времени у Anthropic и OpenAI появятся свои модели System 1 и нам не нужно будет в ручную строить решения, как в прошлом посте.
В нем очень хорошо рассказывают про проблемы с современными моделями - "Why do all LLMs require a human in the loop? The simple answer is we literally put them in the loop" — то есть человек буквально был встроен в процесс обучения
через RLHF (Reinforcement Learning from Human Feedback).
Логика RLHF проста: собрать человеческие предпочтения о том, какие ответы модели нравятся людям, а затем оптимизировать модель так, чтобы она давала ответы, которые получают высокую оценку по этим предпочтениям. Цель этого цикла — понравиться человеку, а не автономно и надёжно выполнить программный процесс без присмотра.
Отсюда вытекает ключевая проблема: модели, обученные через RLHF, отлично умеют "выглядеть правильными" (look right), но это не то же самое, что "быть правильными" (be right). Алмейда прямо называет это дизайн-фичей, а не багом: "overpromising is a feature, this is by design" — модель обучена звучать уверенно независимо от того, насколько она права, потому что именно уверенные и убедительные ответы получают более высокую оценку от людей-разметчиков.
Вместо RLHF, Jev обучается новым методом — RLCD (Reinforcement Learning for Calibrated Decisions). Цель этого метода — не понравиться человеку, а научить модель выдавать эпистемически честные, калиброванные вероятности: если модель говорит "70% уверенности", это должно реально означать, что она права в 70% подобных случаев
Благодаря этому Jev не генерирует текст, а выдаёт типизированные решения (choice, score, noul) с прикреплённой откалиброванной вероятностью, которые код может использовать напрямую — без человека, проверяющего каждый вывод. Разработчик сам задаёт порог уверенности: если вероятность выше порога — программа выполняет действие автоматически; если ниже — передаёт решение человеку. Так неопределённость становится управляемым параметром программы, а не источником непредсказуемого поведения.
Надеюсь вам стало понятней, как и мне.
Думаю в скором времени у Anthropic и OpenAI появятся свои модели System 1 и нам не нужно будет в ручную строить решения, как в прошлом посте.