


Identifying and Quantifying Architectural Debt
https://dl.acm.org/doi/epdf/10.1145/2884781.2884822
AI раскрывает новые возможности. Если раньше читаешь и понимаешь - дааа, но лень, то теперь действительно многое можно достаточно быстро опробовать.
Я раньше использовал адаптированный под себя code-maat, дописанный-переписанный, но Clojure я до этого не знал, так что приходилось дописывать по-немногу и делать интеграцию через файлы, а теперь открылись просто новые грани.
В этой статье арх долг на границе дизайна и архитектуры:
ArchDebt=⟨FileSetSequence, DebtModel⟩, где
FileSetSequence — это последовательность связанных групп файлов в разных релизах
DebtModel описывает, как менялись затраты на исправление ошибок в этих группах
В статье поиск происходит в несколько стадий:
1. Crawling - отбор областей поиска, - файлы, которые хотя бы раз менялись ради исправления ошибки с первого релиза по текущий, после чего отбирают группы файлов и их зависимостей, – у которых ведущий файл находится в этом пространстве ошибок.
2. Indexing - из истории исправлений строят матрицу History Coupling Probability (HCP). Ячейки HCP[A,B] показывают условную вероятность изменения B, если изменился A. В каждой группе есть опорный файл, остальные файлы могут добавляться или исчезать от релиза к релизу
3. Modeling. В исследовании кандидат должен встречаться как минимум в половине релизов и иметь бОльшие затраты к последнему наблюдаемому релизу, чем к первому. Затраты приближают числом измененных строк кода в исправлениях ошибок (bug-fixing churn) по файлам группы. Тут чуть ли не самое интересное – раньше можно было бы сказать, – да ладно, в строках кода считать моветон, а если это агент, то это токены == деньги.
4. Ranking - найденные долги упорядочивают по связанным с ними накопленным затратам
Пример в статье с Cassandra показал, что «ADFileSet calculated using anchor ColumnParent in Cassandra. Each member file structurally depends on the anchor file, and when the anchor file changes, the member files change as well with probabilities from 41% to 100%.». Расценивается как сигнал для проверки.
Долг оценивается через bug-fixing churn, то есть объем изменений при исправлении ошибок.
Неявно можно предположить, что высокий bug-fixing churn может потреблять больше токенов (когда мог бы потреблять меньше). То есть понятно, что потребление зависит от самой задачи, (вход+выход+иные задачи), но при прочих равных, меньшая связанность может потреблять меньше.
Усилить можно, если выйти за пределы репозитория, тогда и без токенов координационная нагрузка подсветит дополнительные расходы, для этого нужно построить связку через багтрекер (она должна быть), но часто связей между зависимыми задачами разных команд нет, это усложняет задачу.
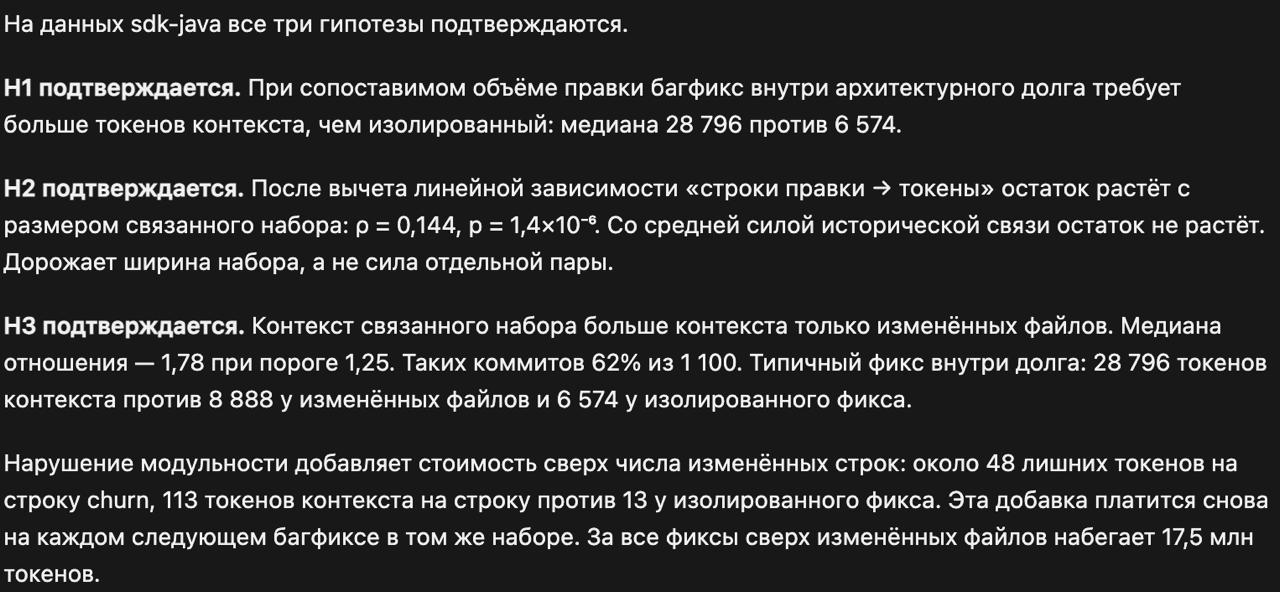
Написал скрипт по статье, отладил, проверял три гипотезы:
H1. При одинаковом объеме правок багфикс в бакете архитектурного долга требует больше токенов контекста, чем изолированный фикс
H2. По числу изменённых строк нельзя понять, сколько токенов понадобится модели (в большом бакете долга токенов больше, чем следует из объема правок)
H3. Контекст из связанных файлов долга заметно больше контекста только из измененных файлов (соответственно чем больше меняется, тем выше скорость роста числа токенов, так как увеличивает число читаемых файлов с некоторой вероятностью). Очевидная гипотеза, но интересно посмотреть.
Проверка через tiktoken, репозиторий: https://github.com/temporalio/sdk-java
Результат на скрине.
Общий вывод
Нарушение модульности дороже изолированной правки и в текущем фиксе, и в каждом следующем.
Последующие фиксы платят тот же контекст снова.
В первой четверти истории типичному такому исправлению хватает примерно 9 300 токенов контекста. Со второй четверти типичный контекст поднимается до 30 000 и дальше держится около 34–35 тысяч.
Лишние токены по четвертям: 3,0 млн, 5,2 млн, 4,5 млн, 4,7 млн.
Исходник стыдно выкладывать и он съедает 70gb памяти на таком небольшом проекте, так что в другой раз.