


Как работают языковые модели?
Когда я изучал программирование, то нас учили простому правилу. Функция при одних и тех же входных данных возвращает один и тот же результат. Два плюс два всегда равно четыре. Это называется детерминированность.
Языковая модель работает по-другому. Она вероятностная, поэтому при одинаковых входных данных может пойти разными путями. Но как модель выбирает путь, по которому пойти?
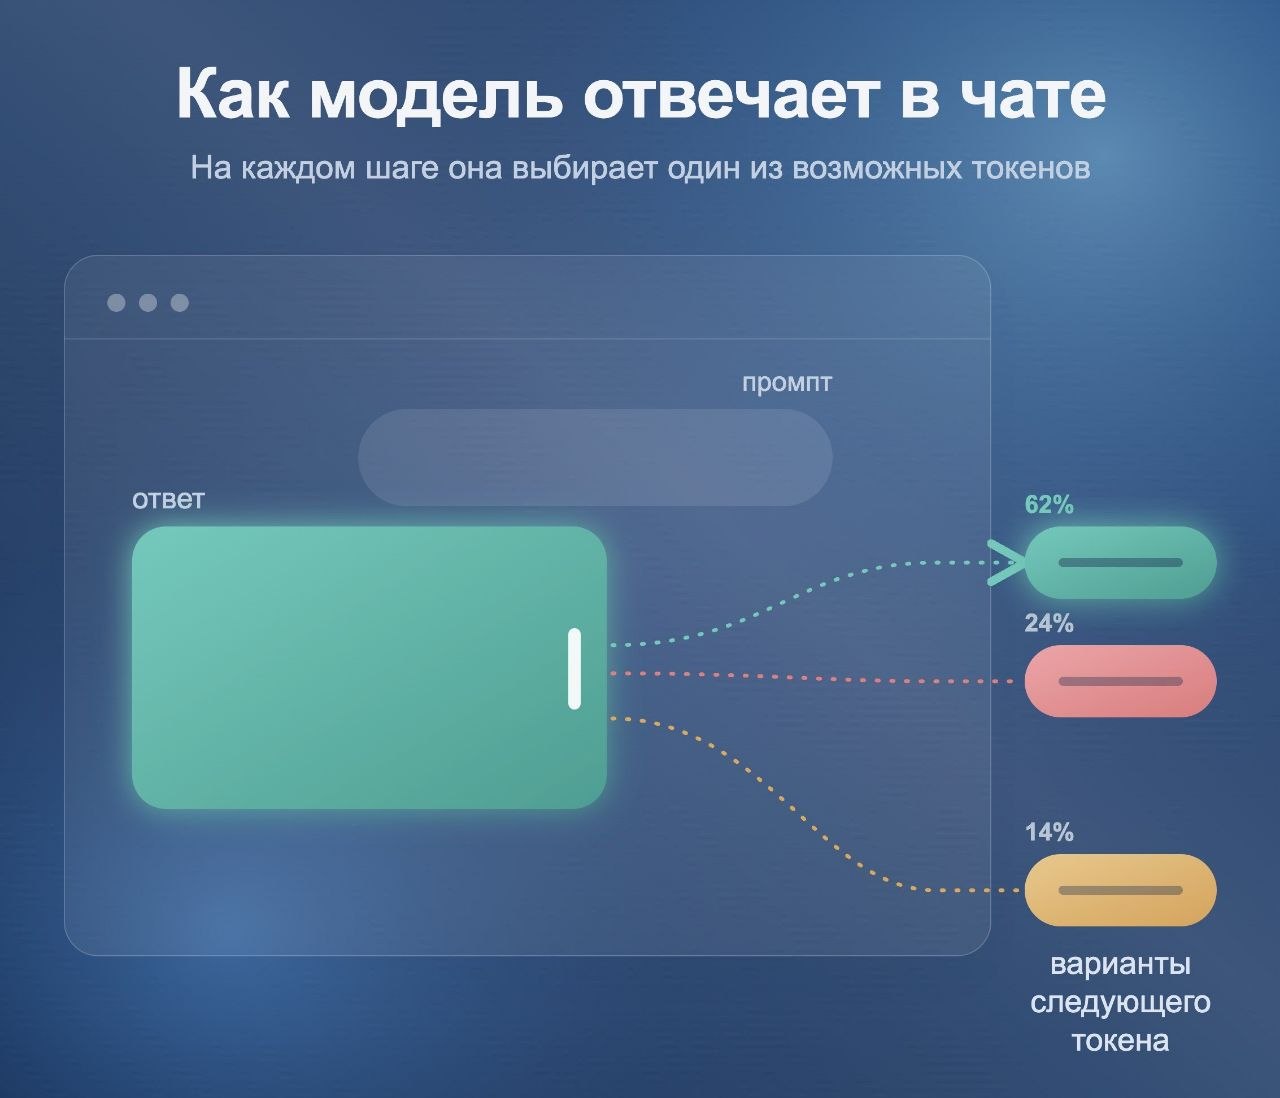
Под капотом она предсказывает следующий фрагмент текста (токен) на основе двух факторов:
▪️Информации, на которой модель была обучена;
▪️Того, что вы передаете ей на вход (промпта).
Далее на каждом шаге она оценивает, насколько вероятен каждый следующий токен. Более вероятные она выбирает чаще, но может выбрать и менее вероятные. Угадала кусок, показала его на экране и уже от него угадывает следующий. Вы можете наблюдать за этим процессом при диалоге в чате, когда печатается ответ, как будто его при вас набирает живой человек. Каждый выбранный токен меняет вероятности для следующего. Поэтому один и тот же вопрос, заданный дважды, может дать два разных ответа.
Теперь давайте разберемся с тем, что такое токен. Токен - это не слово. Иногда это действительно целое слово, но чаще лишь часть слова, знак или пробел.
На английском 1 токен занимает примерно 4 символа, сто токенов - около 75 слов. В русском иначе - 1 токен занимает 2-3 символа, сто токенов это 30-40 слов. Одна и та же мысль на русском часто тратит в 1.5-2 раза больше токенов.
Почему так происходит? Токенайзер собирает словарь из самых частых кусков в данных, на которых модель учили. Чем чаще последовательность встречалась, тем выше шанс, что она станет одним токеном. Английского в обучающих данных было гораздо больше, поэтому целые английские слова часто лежат в словаре одним куском. Русский исторически дробился сильнее, иногда до отдельных букв. Сейчас ситуация стала лучше, но русское слово все равно чаще режется на 2-4 токена, английское на 1-2.
На практике это влияет на стоимость, поэтому один и тот же запрос на русском выходит дороже, и в лимит модели русского текста влезает гораздо меньше, а значит, долгий диалог упирается в потолок раньше.
Можете проверить сами: вставьте одну и ту же фразу по-русски и по-английски в любой токенайзер и сравните счетчик.
С базой вроде разобрались. Теперь, если модель на один и тот же вопрос ответит по-разному, вы знаете почему.
#эйяй