Elastic Stack recipes


Гео и язык канала: Россия, Русский
Категория: Технологии


Платные консультации, администрирование, поддержка, обучение ElasticSearch/OpenSearch в России, Казахстане и других странах — @galssoftware
Consulting and implementation for ElasticSearch/OpenSearch. Ask @galssoftware
Web: gals.software

Связанные каналы  |  Похожие каналы

Гео и язык канала
Россия, Русский
Категория
Технологии
Статистика
Фильтр публикаций


OpenSearch для тех, кому уже мало базовой настройки

С 19 по 21 октября проведём трёхдневный практический тренинг «OpenSearch Продвинутый».

Он рассчитан на инженеров, администраторов, DevOps/SRE-специалистов и архитекторов, которые уже работали с OpenSearch или Elastic Stack и хотят разобраться в сложных промышленных сценариях.

За три дня разберём и отработаем на лабораторных стендах:

🚀 отказоустойчивую и распределённую архитектуру OpenSearch;

🚀 кросс-кластерный поиск и репликацию;

🚀 подокументную и сегментную репликацию;

🚀 ролевую модель, DLS/FLS, аудит и интеграцию с LDAP;

🚀 ISM, снапшоты, восстановление и searchable snapshots в S3;

🚀 оптимизацию индексов, маппинга и хранения данных;

🚀 загрузку данных через Vector, Logstash, Data Prepper, OpenTelemetry Collector и Kafka;

🚀 поиск с помощью PPL, DQL, SQL и DSL;

🚀 мониторинг, Observability, визуализации и оповещения.

Отдельно в программу добавили актуальный блок по работе OpenSearch с ИИ-моделями и чат-ботом. Рассмотрим, как подключить модель с OpenAI-совместимым API через ML Commons и OpenSearch Assistant, создавать агентов, преобразовывать вопросы на обычном языке в PPL-запросы, сохранять контекст диалога и объяснять отдельные события с помощью LLM.

Формат обучения:

📅 19–21 октября

⏰ с 10:00 до 18:00

💻 Онлайн, через Zoom

🧪 Собственные лабораторные стенды

📚 Методические материалы и записи занятий

🏅 Именной сертификат

💬 Учебный чат и поддержка после тренинга

Если хотите не просто администрировать OpenSearch, а уверенно проектировать, оптимизировать и развивать его в production — присоединяйтесь.

👉 Программа тренинга и заявка на участие

@elasticsearch_ru


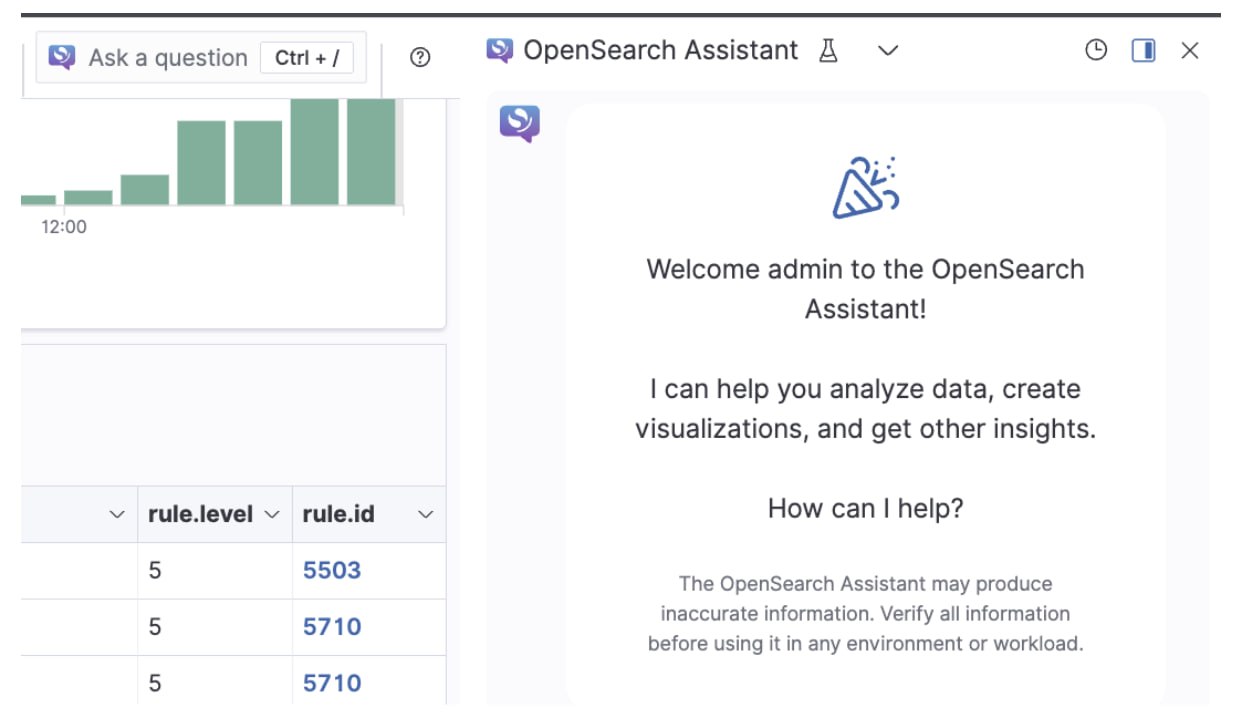
Спросить SIEM словами: подключаем LLM‑ассистента к Wazuh

Wazuh собирает множество событий безопасности, но для поиска нужной информации аналитик должен знать структуру индексов и язык запросов. Авторы статьи предлагают добавить к SIEM LLM-ассистента на базе штатных плагинов OpenSearch.

После настройки в интерфейсе появляются три инструмента:

🚀 чат для вопросов к данным на естественном языке;

🚀 Query Assistant, который переводит вопрос в PPL-запрос и показывает результат в Discover;

🚀 кнопка Explain Document, объясняющая алерт или уязвимость: что произошло, насколько это серьёзно и что проверить первым.

Можно подключить любую модель с OpenAI-совместимым API, включая развёрнутую в собственном контуре. В статье приведена пошаговая установка для Wazuh 4.14.7, настройка коннектора и агентов, сборка кнопки для интерфейса, а также разбор частых ошибок и ограничений.

Читать статью на Хабре →

@elasticsearch_ru


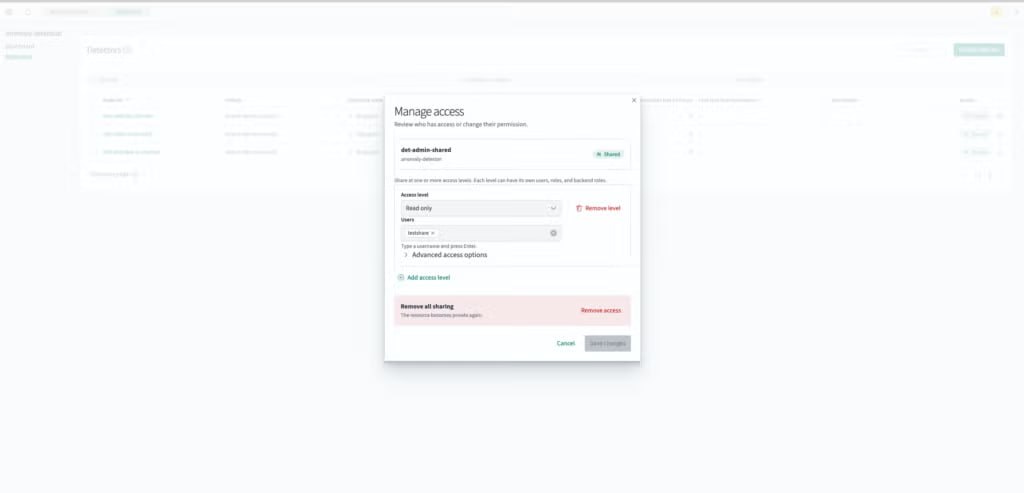
🔐 Managing resource access from a plugin page in OpenSearch Dashboards

В OpenSearch 3.9 настройку совместного доступа перенесли непосредственно на страницы плагинов. Теперь рядом с детектором, монитором, группой моделей или другим ресурсом сразу видно его статус — приватный или общий — и можно открыть диалог управления правами, не переходя в отдельный раздел.

Ресурс разрешается предоставить пользователям, ролям и backend-ролям с поддерживаемым плагином уровнем доступа, а при необходимости снова сделать приватным. Новый интерфейс работает с Alerting, Anomaly Detection, ML Commons, Notifications, Reporting, Security Analytics и Flow Framework.

Для разработчиков плагинов интеграция тоже минимальна: достаточно добавить в нужное место специальный HTML-элемент. Кнопку, проверку разрешений и работу с несколькими источниками данных возьмёт на себя Security-плагин — жёсткая зависимость от него не требуется.

Подробнее в блоге OpenSearch →

@elasticsearch_ru


Вышел OpenSearch 3.9

В релизе улучшили векторный поиск, мониторинг и работу кластеров под нагрузкой.

Главное:


🚀 Быстрее нейросетевой разреженный поиск. Добавлен опциональный движок на C++. В тестах разработчиков на 8,8 млн документов он обеспечил на 39% большую пропускную способность и ускорил построение индекса в 3,3 раза.

🚀 Больше вариантов сжатия векторов. Поддержка half_float, bf16 и 2-/4-битного квантования позволяет выбирать баланс между потреблением памяти и качеством поиска.

🚀 Единое окно алертов. Представление объединяет оповещения по логам OpenSearch, метрикам Prometheus, аномалиям и прогнозам.

🚀 Устойчивость под нагрузкой. Адаптивные ограничения регулируют число параллельных запросов. Для поиска по времени появилась возможность пропускать целые индексы, не попадающие в выбранный диапазон.

🚀 Гибкое управление доступом. Механизм совместного доступа позволяет делиться мониторами, детекторами аномалий и группами моделей с пользователями и ролями.

Подробнее в блоге OpenSearch →

@elasticsearch_ru


OpenSearch Kubernetes Operator 3.0 is now generally available

OpenSearch Kubernetes Operator 3.0 вышел в GA. В новой версии переработали управление обновлениями, масштабированием и ротацией TLS-сертификатов — операциями, от которых зависит стабильность кластера после первого запуска.

Ветка 2.x больше не поддерживается. Переход на 3.0 выполняется без пересоздания кластера, но включает rolling restart, поэтому миграцию стоит сначала проверить на тестовом окружении.

Что изменилось и как подготовиться к обновлению — в статье команды OpenSearch.

@elasticsearch_ru


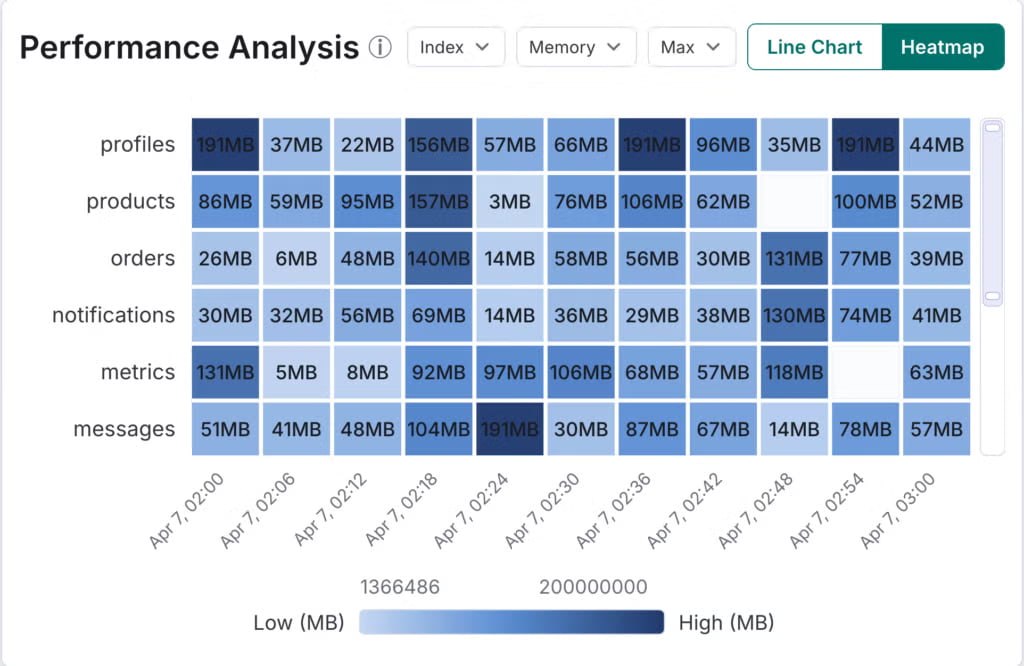
A visual guide to troubleshooting search performance using Query Insights dashboards

В статье рассмотрены варианты визуализаций Query Insights и показано как использовать их для диагностики и устранения реальных проблем с производительностью.

Query Insights — специализированный плагин, который позволяет отслеживать производительность кластера OpenSearch в режиме реального времени.

Ссылка в блог OpenSearch

@elasticsearch_ru


Online index migration and shard scaling in OpenSearch with the AOSC plugin

AOSC — это open-source плагин от Atlassian для OpenSearch, который автоматизирует онлайн-миграцию индекса внутри одного кластера. Он позволяет перенести live-индекс в новый индекс с другими маппингом, настройками, количеством шардов или изменённой структурой документов. При этом исходный индекс большую часть времени продолжает принимать записи.

AOSC решает ключевую проблему с _reindex, который копирует только текущее состояние данных и сам по себе не умеет докопировать новые записи и учитывать удаленные документы, появившиеся во время миграции. _split и _shrink тоже имеют ограничения, которые не позволяют перенести данные онлайн.

Миграция в AOSC проходит по нескольким фазам: проверка источника/цели/алиасов, подготовка целевого индекса, заливка существующих документов, повтор новых операций и удалений, финальная проверка количества документов и переключение alias на новый индекс.

Во время заливки документов AOSC использует retention lease, чтобы история операций не была удалена, а затем воспроизводит изменения, которые произошли в источнике во время копирования. Это позволяет целевому индексу постепенно догнать live-индекс перед переключением.

Обратите внимание, полностью бесшовной миграция не является. Продолжительность окна зависит от размера индекса, нагрузки, числа шардов и скорости валидации.

Ну, и основное ограничение, AOSC работает только внутри одного OpenSearch-кластера и требует, чтобы приложение работало через alias, а не обращалось напрямую по имени индекса.

Статья в блоге OpenSearch

Репо на Гитхабе

@elasticsearch_ru


Wazuh без ограничений дашборда: работаем напрямую с индексами

Wazuh хорош ровно до тех пор, пока вам хватает того, что умеют его штатные дашборды. А потом внезапно выясняется, что все нужные данные уже давно лежат в обычном OpenSearch.

В статье — как работать с Wazuh Indexer напрямую: читать алерты и состояния, строить агрегации, выгружать большие объёмы данных, делать свои отчёты, алертинг и обогащение.

Отдельно полезен разбор того, чем отличается Server API от Indexer, как не положить кластер тяжёлыми запросами и к чему готовиться в Wazuh 5.0, где схему индексов заметно поменяли.

Ссылка на статью

@elasticsearch_ru


Поиск в глубину: какие инструменты помогают работать поиску в Uzum Market

Интересная статья про подход к поиску в Uzum Market (маркетплейс из Узбекистана). Под капотом там ElasticSearch, но не только он. Они как раз и рассказывают как устроен поиск до момента непосредственного запроса в ElasticSearch.

@elasticsearch_ru


Проведем аудит систем логирования Elasticsearch / OpenSearch

Системы централизованного логирования редко ломаются в один день. Обычно проблемы накапливаются постепенно: растут индексы, увеличивается нагрузка на CPU и диски, ingestion начинает отставать, очереди переполняются, а часть логов незаметно теряется. В итоге компания платит больше за инфраструктуру, а в момент инцидента может оказаться, что нужных данных либо нет, либо система логирования сама недоступна.

Мы предлагаем услугу комплексного аудита систем логирования на базе Elasticsearch и OpenSearch.

В рамках аудита мы анализируем не только сам кластер, но и весь путь данных — от источника до индекса:
— архитектуру и конфигурацию Elasticsearch / OpenSearch;

— распределение ролей, shards и replicas;
— sizing CPU, RAM, heap и дисковой подсистемы;
— политики ILM / ISM, rollover и retention;
— mappings, templates и структуру индексов;
— использование compression и эффективность хранения;
— скорость indexing и search workloads;
— риски отказа отдельных узлов и потерю доступности кластера;
— snapshot / backup strategy и возможность восстановления;
— конфигурации Filebeat, Vector и OpenTelemetry Collector;
— pipelines Logstash и Vector;
— batching, buffering, retry, backpressure и очереди;
— ситуации, при которых данные могут быть потеряны между источником и Elasticsearch / OpenSearch.

Что это даёт вам?

Во-первых — возможность снизить стоимость инфраструктуры. Очень часто кластер потребляет больше CPU, RAM и дисков не потому, что данных действительно много, а из-за неэффективной структуры индексов, слишком большого количества shards, неправильного rollover или избыточной обработки событий.

Во-вторых — понимание реальной надёжности pipeline. Например:

Vector/Filebeat → Kafka → Vector/Logstash → ElasticSearch/OpenSearch

может выглядеть надёжно на схеме, но достаточно неправильно настроенного memory buffer, отсутствия persistent queue или некорректного retry — и при кратковременной недоступности OpenSearch или ElasticSearch часть логов просто исчезнет.

В-третьих — снижение риска ситуации, когда во время аварии система логирования становится недоступна именно тогда, когда она нужна больше всего.

По итогам аудита вы, как заказчик, получите в удобном формате PDF список найденных проблем, оценку рисков и конкретные рекомендации по оптимизации архитектуры и конфигурации — с приоритетами, что нужно исправлять в первую очередь.

Наша цель — ответить на три простых вопроса:

Не переплачиваете ли вы за хранение и обработку логов?

Не теряются ли ваши данные по дороге?

Переживёт ли система логирования реальный отказ?

Если у вас Elasticsearch или OpenSearch уже давно работает в production и никто системно не пересматривал его архитектуру — аудит обычно быстро показывает, где находятся самые дорогие и самые рискованные места.

Вопросы можно задать @galssoftware или на почту hello@gals.software.


Вышел Elastic 9.5

Уж не знаем договаривались они или нет, но анонс по новым релизам у Elastic и OpenSearch случился в один и тот же день — вчера.

Обновления Elastic более масштабные:

🚀 Elasticsearch теперь умеет хранить данные аки колоночная база данных

🚀 Появился режим индексирования VectorDB и автоматическая калибровка векторного поиска

🚀 Появилась встроенная поддержка Prometheus и PromQL

🚀 Реализован принцип «нулевого почтового ящика» — очередь важных событий со встроенным анализом событий

🚀 Улучшенный Elastic Agent Builder , включая мониторинг и отслеживание действий агентов, а также расширенные возможности утверждения с участием человека

🚀 и несколько других улучшений.

Подробности в блоге Elastic

@elasticsearch_ru


Вышел OpenSearch 3.8

Что нового:

🚀 Расширение MCP-интеграций на большее количество типов агентов

🚀 Потоковая передача результатов машинного обучения с меньшей задержкой с использованием транспортного протокола gRPC

🚀 Ускоренная обработка векторов в 4,16 раз быстрее и повышение производительности радиального поиска до 2,1 раз

🚀 Масштабирование оценки релевантности поиска за счет доступа к большему количеству крупных поставщиков LLM

🚀 Оптимизация анализа логов с помощью визуального конструктора языка конвейерной обработки (PPL), SQL-запросов и шаблона

🚀 Формирование, преобразование и сравнение данных временных рядов с помощью новых команд PPL

Подробности в блоге OpenSearch

@elasticsearch_ru


OpenSearch Demystified

Знакомьтесь — удобный путеводитель по возможностям OpenSearch. Здесь вы можете ознакомиться с разными возможностями системы в интерактивном формате. Подойдет тем, кто только начинает знакомство с OpenSearch.

opensearch.9cld.com

А если вы хотите изучить OpenSearch в простом и удобном формате — приходите 📅 23-25 сентября на наш 3-дневный интенсив 🎓 OpenSearch База, где вы познакомитесь с этой системой. Программа интенсива.

@elasticstack_ru


Два полезных плагина VSCode для OpenSearch и OpenSearch

OpenSearch DevTools & Support

Elasticsearch DevTools & Support

Оба плагина поддерживают выполнение запросов и команд, автодополнение, оборачивание фрагменты запроса логическими условиями (filter, should, must_not), проверка типа поля
анализ влияния на производительность. и содержат генератор фиктивных данных.

@elasticstack_ru


Проведем тренинг ElasticSearch 8-10 июля

Освойте Elasticsearch на практике за 3 дня, научитесь уверенно использовать его в промышленной эксплуатации и быстро погрузитесь в тему.

За 3 дня вы:

✅ Разберётесь с архитектурой Elasticsearch и принципами работы кластера.

✅ Научитесь правильно проектировать mappings и выбирать типы данных.

✅ Освоите Query DSL — от простых запросов до сложных агрегаций и полнотекстового поиска.

✅ Поймёте, как работают анализаторы, токенизаторы и скоринг.

✅ Настроите отказоустойчивый кластер, репликацию, резервное копирование и восстановление.

✅ Разберёте ILM, Data Streams, Ingest Pipelines и другие механизмы жизненного цикла данных.

✅ Выполните десятки лабораторных работ на готовой инфраструктуре и получите опыт, максимально приближенный к реальным задачам.

Тренинг уже на следующей неделе! Следующий такой только в октябре.

Программа ElasticSearch 8-10 июля

Вопросы можно задать @galssoftware или через форму обратной связи на странице с программой тренинга.


ES|QL Workshop

Регистрируйтесь на воркшоп от Elastic, который состоится 23 июня в 11 часов по московскому времени.

ES|QL вскоре будет основным языком запросов для Elasticsearch. Он разработан таким образом, чтобы его было легко освоить и использовать конечным пользователям, командам SRE, аналитикам безопасности, разработчикам приложений и администраторам. Используя ES|QL, вы сможете находить конкретные события, проводить статистический анализ и создавать визуализации.


@elasticstack_ru


Вышел OpenSearch 3.7

Пролетели 2 месяца и вот уже следующая версия подоспела.

Что нового:

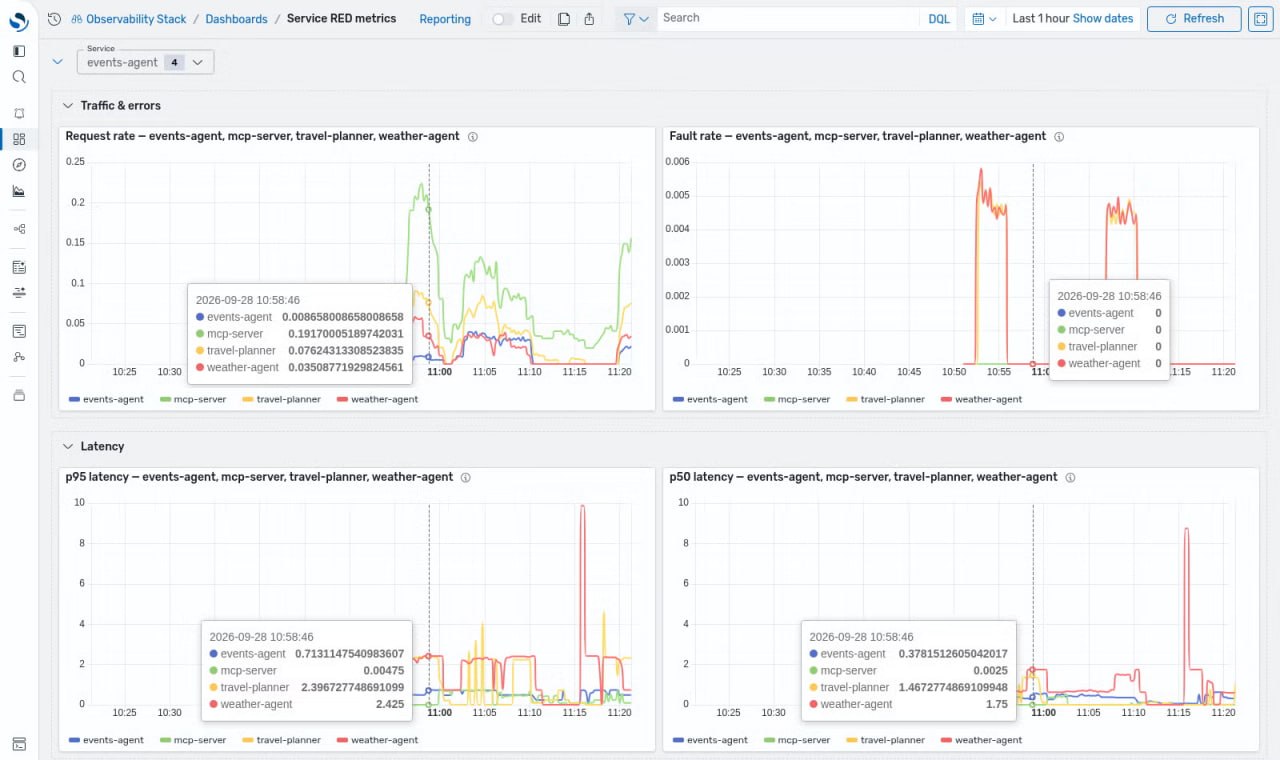
➡️ Метрики Prometheus теперь можно запрашивать при помощи PromQL непосредственно из OSD

➡️ Новое представление Explore Metrics позволяет выполнять запросы в Prometheus и визуализировать эти данные

➡️ Новый унифицированный интерфейс оповещений: мониторы OpenSearch + правила оповещений Prometheus

➡️ Новый каталог SLO с бюджетом ошибок с указанием скорости расходования бюджета

➡️ Появились переменные дашбордов, что позволяет параметризовать панели мониторинга с помощью многократно используемых переменных вместо поддержания практически идентичных копий для каждого набора данных.

➡️ Появился конвейер преобразований на уровне визуализации при выполнении PPL-запросов.

➡️ Появилась симуляция выполнения ISM-политики

➡️ В интерфейс Query Insights добавились инструменты профилирования (ранее для профилирования запроса приходилось переходить в отдельное представление)

➡️ Появились API-ключи, предоставляющие разрешения для кластера и индекса, непосредственно связанные с ключом.

И многое другое. Подробнее в блоге OpenSearch.

@elasticstack_ru


Спасибо за ваши голоса🙏

На этой неделе анонсируем вебинар по оптимизации хранения. Следите за анонсами 🔥


Хотим провести вебинар по OpenSearch в ближайшие недели. Выберите какая тема была бы интереснее.
Опрос
  •   безопасность (ролевая модель, разграничение доступов)
  •   репликация (документная, сегментная, удаленное хранилище)
  •   оптимизация хранения (кодеки, маппинг полей)
25 голосов


8-10 июня тренинг OpenSearch Advanced

Приходите на 3-дневный интенсив по продвинутой работе с OpenSearch для тех, кто уже с ним знаком. На интенсиве вас ждет погружение в расширенный функционал системы, у вас будет возможность поработать в лабораторном окружении с функциями, которые вы, возможно, раньше не использовали.

🚀 Безопасность в OpenSearch (ролевая модель и уровни доступа).

🚀 Распределенная архитектура (кросс-кластерный поиск и репликация).

🚀 Продвинутая репликация (распределение нагрузки, удаленное хранилище и поиск по снапшотам).

🚀 Оптимизация хранения данных (продвинутый маппинг и другие настройки индексов).

🚀 Работа с Vector, DataPrepper, Ingest Pipeline и Kafka (загрузка и обработка данных).

🚀 Работа с PPL, DQL и SQL (эффективный поиск по данным).

🚀 Мониторинг кластера (методы и инструменты).

🚀 OpenSearch Dashboards (ролевая модель, Workspaces, Tenants, отчеты, Data Sources и визуализации).

В лабораторном окружении мы развернем два кластера OpenSearch, Prometheus, Vector, Kafka и много чего другого, чтобы вы смогли поработать с перечисленным выше функционалом. Приходите и познакомьтесь с OpenSearch поближе!

Программа тренинга OpenSearch Advanced

Дополнительные вопросы можно задать через hello@gals.software или @galssoftware.

Показано 20 последних публикаций.