


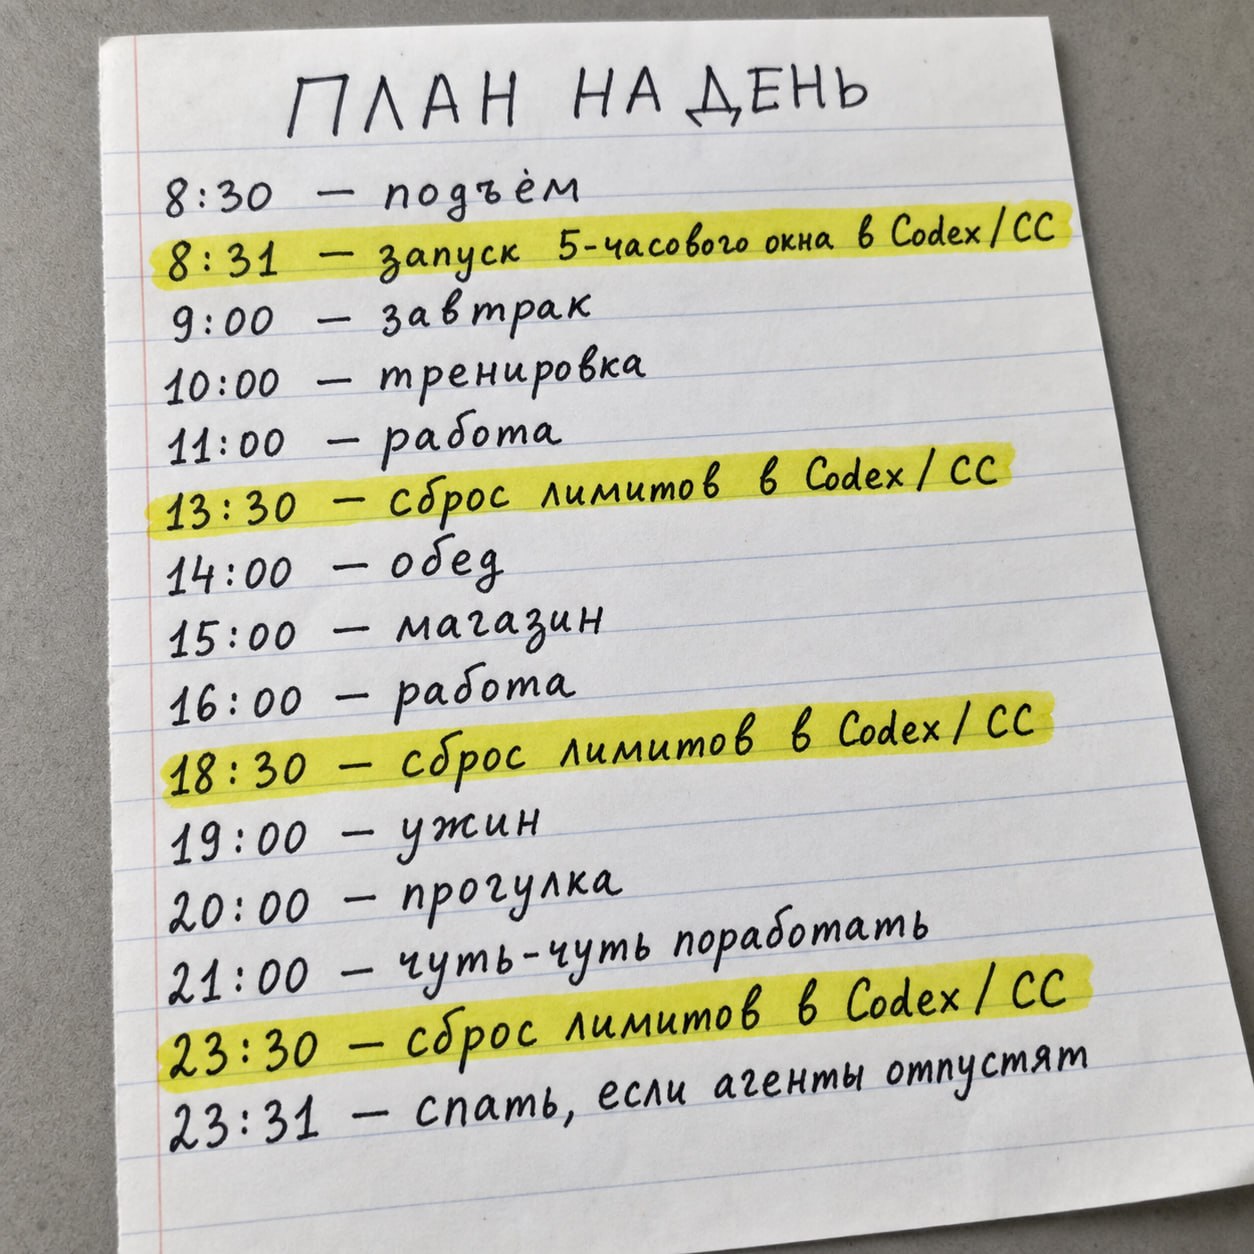
После переезда на Codex и Claude Code появилась новая проблема — лимиты токенов 🔫
Если совсем просто: токены — это валюта, которую агент тратит, когда читает, думает и пишет код.
Я использую Codex и Claude Code по подпискам. В них дают N токенов на 5 часов, и если потратил их раньше — жди.
Лимиты живут в скользящих окнах. Отсчет начинается только после первого сообщения агенту. До этого окно не запускается. Не потратил токены за 5 часов — они сгорели. В новом пятичасовом окне будут новые.
Раньше я садился работать и за 2–3 часа тратил все лимиты. Это бесило, потому что приходилось тупо ждать.
Но, подписки всё равно в 10+ раз выгоднее, чем использовать эти же модели по API с оплатой за токены.
Пришлось перестраивать рабочие процессы под эти гребаные токены.
Вот как у меня сейчас это работает:
1️⃣ Я запускаю лимит заранее.
Так как пятичасовое окно стартует только после первого сообщения, я стал распределять день так, чтобы успевать плотно поработать, а потом заниматься чем-то полезным, пока жду следующего окна.
Например, если хочу плотно работать с 10 утра, я не жду, пока сяду за комп. Я просыпаюсь в 8:30 и кидаю агентам любое сообщение: «hi» или прошу сводку по задачам.
Это запускает окно. К 10:00 у меня до конца окна остаётся уже ≈3 часа. Сажусь и работаю на максимум. Мое расписание теперь, как на картинке👆🏼
2️⃣ Я начал жестко следить за контекстным окном внутри каждого диалога.
Контекст — это всё, что агент «помнит», пока делает задачу: переписку, файлы, рассуждения, инфу из других программ.
Проблема в том, что на каждый новый запрос он перечитывает всё, что было до этого. Чем больше мусора в контексте, тем быстрее сгорают токены и тем ниже качество ответа.
Поэтому я держу контекст до 50-70% от максимума. Как только наполняется, я сжимаю его, закидываю главное в лог файл по проекту и запускаю новый диалог.
3️⃣ Дроблю большие задачи на маленькие и запускаю под каждую субагента.
Например, если одному агенту дать задачу найти 1 000 YouTube роликов, убрать shorts, отфильтровать темы, вытащить заголовки, транскрипцию и описания, то его контекст быстро раздуется до максимума. Результат будет плохой, а токенов он сожрет много.
Поэтому я создаю одного агента оркестратора. Он знает все этапы задачи и желаемый результат, а отдельные подзадачи раздает субагентам: один ищет видео, другой вытаскивает инфу и т.д.
У каждого субагента свое свободное контекстное окно. Он делает маленькую задачу качественнее и приносит оркестратору только готовый результат, без мусора.
4️⃣ Всю важную инфу, инсайты и результаты по проекту я вытаскиваю из диалогов и храню в md-файлах.
Инструкции, скилы, статусы, логи, контекст — всё лежит в текстовых файлах и рассортировано по папкам. В каждом проекте есть своя структура и отдельный агент, который следит за порядком.
Это нужно, чтобы любой агент мог быстро найти нужный файл, прочитать только нужное и не забивать контекст мусором.
При этом, я могу запустить любого агента в свои папки, хоть Kimi, и он подхватит задачу с нужного места, весь контекст у него уже будет.
5️⃣ Любой важный результат проверяет отдельный агент.
Агент, который делал работу, не должен сам себе быть редактором и критиком. Он будет делать себе поблажки и пропускать слабый результат дальше.
Поэтому один агент делает, второй проверяет. Так итоговый результат получается качественнее, его не надо переделывать, и это экономит токены.
6️⃣ Конечно, я активно использую skills и workflows.
Сейчас почти для любой задачи можно найти готовый процесс: с инструкциями для агента, проверками и порядком работы.
Например, готовый воркфлоу сначала задаст тебе правильные вопросы, упакует их в план работ, разобьет на подзадачи и начнет выполнять их субагентами. А каждый результат будет ревьюить, тестить и только потом показывать тебе.
Таких баз сейчас много в открытом доступе, поэтому можно найти скилы почти на любую задачу.
Давайте нажмем тут на огонек 40 раз🔥 и в следующем посте я соберу ссылки на базы, где сам ищу скилы и воркфлоу для разных задач ☕️