Data jobs feed


Гео и язык канала: Россия, Русский
Категория: Карьера


Data Engineers
Обсуждение https://t.me/datajobs
Для связи: @krivdathetriewe
Реклама: https://telegra.ph/Reklama-v-Hadoop-Users-10-28
РКН № 6061028631

Зарегистрирован в РКН
Связанные каналы  |  Похожие каналы

Гео и язык канала
Россия, Русский
Категория
Карьера
Статистика
Фильтр публикаций


#вакансия #LLM #MLengineer #DataScience #PyTorch #NLP

Ищем LLM / ML Engineer с практическим опытом обучения языковых моделей.

Задача — обучение с нуля специализированных моделей на 1–10 млрд параметров. Основные направления: разработка ПО, понимание сложных русскоязычных текстов и function calling.

Проекты для заказчиков под NDA — подробности обсудим лично.

Задачи:
– Подготавливать данные и выстраивать пайплайны обучения.
– Проводить эксперименты с архитектурами, методами и режимами обучения.
– Обучать модели с нуля и адаптировать их под целевые задачи.
– Оценивать качество моделей, анализировать ошибки и улучшать результаты.

Ожидания:
– Практический опыт обучения языковых моделей: от подготовки данных до оценки результата.
– Опыт аналогичных проектов либо адаптации готовых моделей методами, выходящими за рамки SFT.
– Уверенное владение Python и PyTorch.
– Понимание принципов обучения трансформеров и опыт работы с GPU.

Будет плюсом: опыт распределённого обучения, оптимизации памяти и скорости обучения, работы с моделями для кода и вызова инструментов.

Если у вас есть такой опыт или можете кого-то порекомендовать — пишите @askomaev. Будет здорово, если кратко расскажете о проектах и своей роли в них.


#вакансия #datascience #mlengineer #python #machinelearning #airflow #pyspark #sql #fulltime

Компания Centicore 💙 находится в поиске ML Engineer / Data Scientist.
Мы занимаемся продуктовой разработкой проектов наших заказчиков под ключ.

Вакансия: ML Engineer / Data Scientist
Формат работы: Москва, гибрид 1 раз в неделю офис
Вилка: 380 000–400 000 ₽ на руки

💙 Задачи:
– Исследовать и прототипировать новые методы контроля качества данных на наших данных.
– Проектировать ML- и статистические контроли для выявления аномалий, дрейфа распределений, деградации свежести данных, нарушений сезонных паттернов и нетипичных комбинаций метрик.
– Строить базовые ожидания по DQ-метрикам: row_count, null_rate, unique_count, свежесть данных, доли категорий.
– Подбирать подходящие методы под конкретную задачу: от простых правил и статистических проверок до ML-моделей.
– Валидировать контроли без готовой разметки: проверять их на исторических данных, использовать синтетические аномалии, shadow mode и анализ ложных срабатываний.
– Интегрировать решения в production-пайплайны: Airflow, PySpark, Hive/Hadoop.
– Настраивать алертинг для операционных команд и сопровождать решения в production.

💙 Ожидания:
– Опыт в ML / Data Science от 3 лет.
– Уверенное владение Python (pandas, numpy, scikit-learn) и SQL.
– Ключевой стек: Python, SQL, Airflow, PySpark, Hadoop/Hive, MLflow.
– Сильная база по математической статистике и классическому машинному обучению: линейные модели, деревья, бустинги.
– Опыт с методами выявления аномалий и/или обнаружения дрейфа данных.
– Опыт работы с временными рядами.
– Опыт вывода моделей в production, их мониторинга и версионирования.
– Понимание, где действительно нужен ML, а где достаточно правила, SQL-проверки или статистического базового контроля.

Критично: Знание ML + Airflow.

💌 Для вопросов и отправки резюме пишите в личные сообщения: @ktvsk_d
Буду рада познакомиться! 💙


Вакансия: ML-инженер (LLM / Python)

Мы в поиске Senior / Middle+ ML-инженера на аналитический проект.
Работа в офисе (Москва), оффлайн-контур (Air-Gapped). Мощнейшее железо: Mac Studio 512GB + Ubuntu (NVIDIA RTX PRO 6000 96GB).

Обязательные требования:
• Python, vLLM, Ollama, llama.cpp.
• Опыт локального развертывания LLM-моделей (Llama-3, Qwen) и работы с форматами GGUF / FP8 / AWQ.

Будет плюсом:
• Опыт дообучения (Fine-Tuning, LoRA, QLoRA) и построения RAG-систем (ChromaDB / Qdrant).
• Умение писать парсеры (Selenium, Playwright).

Формат работы: офис / гибрид (Москва)
Есть тестовое задание, для его выполнения необходимо подъехать в офис.


Оплата: кэш/крипта, выше рынка.
Узнать подробности и отправить резюме: @konoovylinkaa


#vacancy #job #вакансия #удаленка #remote #DataEngineer #senior #fulltime #BigData #AI #LLM

Вакансия: Senior/Staff Data Engineer
Компания: Playrix
Опыт работы: от 5 лет
Город: Remote, есть офисы в Грузии, Армении, Казахстане, Сербии и на Кипре
Формат работы: полная удаленка
Занятость: full time
Зп: от 5000 USD net

💚 Playrix — одна из самых успешных компаний по разработке мобильных игр, входит в топ-3 компаний-разработчиков мобильных игр в мире. Наши игры установили 2,3 миллиарда раз (треть населения Земли), каждый день в них играет более 30 миллионов людей!

Мы в поисках Senior Data Engineer в AI Platform — одна из наших наиболее перспективных команд. Она отвечает за общую инфраструктуру и платформенный слой, на которых строится работа с AI во всей компании: от использования и оценки LLM до систем знаний и поиска, построенных поверх них.

✅ Наш стек:
- PySpark, Databricks, dbt, Redshift, RDS, PostgreSQL;
- AI: Claude, KimiK3, Codex с настроенными правилами репозиториев, растущим каталогом специализированных скиллов и агентских режимов под конкретные задачи.

✅ Задачи:
- Разрабатывать и развивать пайплайны данных и платформенный слой, от которого зависят AI-продукты компании;
- Анализировать использование LLM: стоимость, экономику токенов и кеширования, финансовую отчетность по расходам на AI;
- Развивать RAG-системы: контекстные базы знаний, инфраструктуру векторного и семантического поиска;
- Обеспечивать эксплуатационную надежность платформы: профилирование, мониторинг и observability пайплайнов, за которые вы отвечаете;
- Разрабатывать интерфейсы и сервисы поверх данных, а не только обеспечивать их загрузку: авторизацию, API и интерактивный доступ для пользователей данных.

✅ Мы ожидаем:
- Сильный коммерческий опыт в Data Engineering с современным стеком: Databricks, dbt, Airflow, Dagster, Greenplum, Snowflake, или аналогичными технологиями;
- Уверенное владение Python и понимание backend-разработки: как работает авторизация, как сервис предоставляется пользователям и как с ним взаимодействуют;
- Практическое понимание профилирования и мониторинга data-систем в production;
- Глубокое понимание AI/LLM-стека: векторных баз данных, embeddings, контекстного и семантического поиска, RAG-архитектур и принципов работы автономных агентов.
- Опыт работы с облачными технологиями, в идеале — AWS.

✅ Мы предлагаем:
- Гибкость в работе: Для большинства позиций у нас гибкий график и удалённый формат работы. Мы ориентируемся только на результат.
- Забота о здоровье и well-being: Предоставляем ДМС для сотрудников, их партнеров и детей, компенсируем онлайн-сессии с психологом, компенсируем занятия спортом.
- Развитие и обучение: Оплачиваем участие в профильных конференциях и курсах, проводим внутренние конференции. Компенсируем изучение иностранного языка.
- Ивенты и мерч: Регулярно проводим развлекательные и рабочие мероприятия в офлайн режиме: встречи команд, крупные корпоративные вечеринки и более лайтовые пати в офисах.

📲 За подробностями стучитесь в tg @sasha_builova


Всем привет!
Мы ищем талантливого Data Engineer, который готов столкнуться с непростыми задачами в области хранения и обработки больших данных в масштабах петабайт!
У вас будет уникальная возможность поучаствовать в развитии платформы данных для работы с телеметрией автономного транспорта Москвы - трамваев и метро, в том числе: в разработке архитектуры DWH, подключении новых сервисов, повышении производительности и стабильности работы платфонмы.

Что предстоит делать:
- Превращать телеметрию автономного транспорта в данные, удобные для анализа: разрабатывать и запускать Spark-пайплайны, продумывать преобразования и проверки качества
- Подключать новые источники данных: разрабатывать интеграции с различными системами и обеспечивать надёжную загрузку данных в хранилище
- Развивать архитектуру Data Lake / DWH
- Вместе с командой формировать общие подходы к разработке, мониторингу и сопровождению пайплайнов

Что ожидаем:
- Практический опыт разработки и сопровождения пайплайнов данных
- Опыт работы с PySpark, Python и SQL
- Опыт работы с Data Lake / DWH и понимание принципов построения ETL/ELT-процессов
- Понимание принципов распределённой обработки данных

Будет плюсом:
- Опыт работы с Trino+S3
- Опыт оркестрации пайплайнов с помощью Airflow
- Знакомство с Data Vault 2.0
- Знание Scala и опыт её использования для обработки данных
- Опыт развития платформы данных на ранних этапах: от выбора решений до их внедрения и сопровождения

Контакт для связи:
@HR_Svetik


🔼 This stack needs a Senior

В 01.tech открыта позиция Senior DataOps Engineer

Distributed systems, MPP, Python / Go, AWS, Karpenter, Istio, database infrastructure и задачи, в которых можно влиять на то, как все работает вместе

Remote или офис с релокацией за счет компании, поддержка профессионального развития и много свободы в технических решениях

➡️ Больше о роли и отклик


#вакансия #Senior_PostgreSQL_Engineer #Database_Reliability_Engineer #Data_Engineer
Компания: Chrona (в рамках партнерского сотрудничества)
Формат работы: Гибрид (Минск)(рассматриваем кандидатов готоых к переезду в РБ)
ЗП: $5 000 – 8000 gross


Мы создаем передовые технологии для автоматизации глобального рынка рекрутмента (AdTech). Наша платформа — это высоконагруженная экосистема, через которую проходят сотни миллионов долларов рекламных бюджетов. Сердце нашего продукта — 5–6 кластеров PostgreSQL объемом десятки терабайт (самая большая база — до 30 ТБ) в облаке AWS.
Ищем Senior PostgreSQL DBA / DRE, который хочет выйти за рамки традиционного администрирования баз данных и расти в направлении Data Engineering.


🧩 Твоя зона ответственности
Эксплуатация и тюнинг СУБД: Полный контроль над состоянием, профилированием и оптимизацией PostgreSQL под конфигурацию серверов в AWS;
Отказоустойчивость и HA/DR: Настройка и сопровождение репликации, Patroni, PgBouncer, бэкапирования и катастрофоустойчивости;
Проактивный мониторинг: Поиск медленных запросов (pg_stat_statements, анализ планов выполнение), оптимизация индексов и проактивная помощь разработчикам;
Развитие в Data Engineering: Участие в построении ETL-пайплайнов и работа со смежным стеком данных по мере погружения в проект (до 60% задач в перспективе);
Автоматизация: Написание скриптов для сбора метрик, диагностики и обслуживающих процессов (Python/Bash).


❇️ Что важно для нас
Опыт от 5 лет в роли экспертного PostgreSQL DBA в высоконагруженных продакшн-средах;
Понимание PostgreSQL «под капотом»: процессы, память, WAL, блокировки, тонкая настройка autovacuum под High-Load;
Практический опыт работы с отказоустойчивыми связками (Patroni, PgBouncer, потоковая репликация);
Опыт работы с PostgreSQL в облачной инфраструктуре (AWS EC2 / RDS);
Желание развиваться в области Data Engineering (ETL, пайплайн-инструменты);
Английский язык от B2 / Upper-Intermediate для устного общения.


✅ Будет плюсом
Опыт работы с инструментами Data Engineering (Airflow, Python-пайплайны);
Навыки программирования на C;
Опыт проведения миграций и мажорных апгрейдов больших баз данных.
✳️ Что мы предлагаем

Достойный оклад ($6000–9000);
Уникальную возможность освоить Data Engineering на реальных больших данных с поддержкой сильного ментора;
Стабильный и технически зрелый проект без «пожаров» и хаоса;
Гибкий график работы и высокую степень инженерной автономии.
Контакты: @yul_shuk


#vacancy #job #вакансия #удаленка #remote #ML #senior #fulltime #BigData #AIEngineer #LLM

Вакансия: ML Engineer
Компания: НИУ ВШЭ
Проект: iFORA
Опыт работы: от 3 лет
Город: Москва, РФ
Формат работы: гибрид или полная удаленка
Занятость: full time
Зп: от 300 000 рублей net, далее обсуждаемо

🔥 iFORA - интеллектуальная система анализа больших данных (собственная разработка ИСИЭЗ НИУ ВШЭ). Система позволяет анализировать более 850 млн документов из уникальной коллекции (научные статьи, патенты, медиа) для поддержки принятия стратегических решений.

Мы приглашаем в нашу команду опытного ML инженера для работы над проектом по созданию системы анализа данных.

📌Наш стек:
• Python, Linux
• PyTorch, Transformers
• LangChain / LangGraph
• vLLM, sglang, Triton Inference Server
• MLFlow
• S3-совместимые хранилища
• Docker, Jupyter, VSCode

📌Задачи:
▪️разработка multi-agent систем (MAS) для Deep Research задач
▪️создание LLM-агентов с использованием tool calling, planning и reasoning
▪️проектирование и развитие RAG-архитектуры включая поверх коллекции из 850+ млн документов
▪️разработка и поддержка knowledge graph для аналитических и исследовательских сценариев
▪️оптимизация LLM inference (latency, throughput, batching, KV cache)
▪️подготовка и оптимизация моделей для production
▪️разработка воспроизводимых ML pipelines и инфраструктуры экспериментов
▪️внедрение и эксплуатация AI / ML сервисов в production

📌Мы ожидаем от Вас:
▪️ 3+ лет опыта реализации проектов в Machine Learning / AI
▪️знание паттерной архитектуры и системного дизайна
▪️уверенное владение Python
▪️опыт разработки систем на базе LLM
▪️опыт построения RAG систем или AI-агентов
▪️опыт вывода ML/AI сервисов в production
▪️понимание архитектуры ML pipelines и инженерного подхода

📌Что мы предлагаем Вам:
▪️участие в развитии одной из крупнейших аналитических платформ научных данных
▪️работа с современными LLM и AI-архитектурами
▪️сильная исследовательская и инженерная команда
▪️гибкий график (начало рабочего дня с 8:00 до 11:00)
▪️гибридный формат работы (возможна удалёнка)
▪️обучение и курсы НИУ ВШЭ, английский язык
▪️доступ к библиотеке НИУ ВШЭ и образовательным ресурсам
▪️софинансирование ДМС
▪️программы лояльности фитнес-клубов и театров
▪️офис на Мясницкой (м. Лубянка / м. Тургеневская)

✅Контакт для связи: tg Осыка Яна


Репост из: Data jobs feed
MLE/AE
Привет, и более полное описание вакансии в М2
Метр квадратный (М2) - это онлайн-платформа для решения вопросов с недвижимостью. Наша компания помогает проводить сделки проще, быстрее и безопаснее.

ЧЕМ ПРЕДСТОИТ ЗАНИМАТЬСЯ:
разрабатывать и доводить до продакшена модели компьютерного зрения
решать задачи речевой аналитики: транскрибация звонков, диаризация спикеров, извлечение сущностей и интентов, оценка качества коммуникаций и построение аналитических витрин по разговорам;
строить классический ML: скоринг, ранжирование, прогноз конверсии и оттока, рекомендательные и matching-модели на табличных данных;
проводить полный цикл ML: постановка задачи, разметка и подготовка данных, обучение, валидация, A/B и offline-оценка, мониторинг качества в проде;
упаковывать модели в сервисы (API/batch), выкатывать в продакшен, обеспечивать стабильность, latency, отказоустойчивость и версионирование;
настраивать пайплайны обучения и инференса, feature store / датасеты, трекинг экспериментов и CI/CD для ML;
работать с продуктом и бизнесом: формализовать метрики успеха, декомпозировать гипотезы, объяснять решения моделей и влияние на KPI.

ЧЕГО МЫ ЖДЕМ:
уверенный Python и опыт промышленной разработки, а не только ноутбуков;
практический опыт Computer Vision (классификация, детекция, сегментация) и работы с современными CV-архитектурами;
опыт речевой аналитики / speech-to-text: ASR, диаризация, NLP поверх транскриптов;
сильный классический ML: feature engineering, градиентный бустинг, валидация, работа с дисбалансом и утечками;
опыт вывода ML в прод: сервисы инференса, batch/online, мониторинг дрифта, ретрайн, откат моделей;
понимание MLOps: Docker, оркестрация пайплайнов, трекинг экспериментов, версионирование данных и моделей;
умение читать SQL и работать с витринами/хранилищами; плюсом — опыт GPU-инференса и оптимизации (ONNX, Triton, квантизация).

Наш стек:
Python,Java,Trino,DBT,Iceberg,Airflow,llama.cpp,LLM, Whisper,FastAPI,MLFlow,S3 + то что принесешь ты
Для контакта просьба писать @vika_nkl


#вакансия #mlops #dataengineering #healthtech #fulltime #москва

Вакансия: Data / ML Platform Engineer (Middle+ / Senior)
Компания: AstraTech
Формат: гибридный / удаленный по РФ
Локация: Москва
Занятость: full-time
Вилка: 280 000 - 400 000 ₽ гросс

HealthTech стартап создает продукт поддержки врачебных решений, который делает процессы в здравоохранении эффективнее и помогает врачам принимать более точные решения 🕊

Сейчас команда строит Data Platform и ML / LLM Platform. Это единый путь данных: от загрузки из разных источников до измеренного результата модели. Команда ищет инженера, который возьмет на себя подготовку данных и инструменты для ML-команды и сможет сам проводить эксперименты с моделями.

Вам предстоит:
— Разрабатывать Python / SQL-пайплайны загрузки и обработки данных из файлов, API и информационных систем.
— Проектировать таблицы хранилища: сущности, связи, правила преобразования.
— Встраивать псевдоанонимизацию и проверки качества в потоки данных.
— Готовить признаки и версионируемые train/validation/test-выборки.
— Обеспечивать прослеживаемость и воспроизводимость ML / LLM-экспериментов.
— Вместе с ML-командой развивать оценку моделей, подготовку данных для RAG и дообучения.

Ожидаем от вас:
— Уверенные Python и SQL, поддерживаемый код за пределами ноутбуков.
— Практический опыт ETL / ELT: оркестрация, инкрементальная обработка, повторные запуски.
— Опыт с S3, Parquet, pandas / Polars / PyArrow.
— Понимание жизненного цикла ML: выборки, baseline, метрики, проверка утечек.
— Опыт с MLflow, ClearML или аналогами; Linux, Git, Docker, CI/CD.
— Умение работать с чувствительными данными.

Будет плюсом:
— Опыт с медицинскими данными, МИС и клиническими справочниками.
— Практический NLP / LLM: извлечение данных из текста, embeddings, RAG.
— PyTorch / Hugging Face, дообучение и inference на GPU.
— Опыт превращения исследовательского прототипа в регулярный пайплайн.

Почему интересно:
— Проект, который действительно приносит пользу людям.
— Возможность строить платформу с нуля и влиять на архитектуру.
— Работа на стыке Data Engineering, MLOps и LLM с современным стеком.

Направляйте ваши отклики с резюме - @Inga_IT 📩


#вакансия
Команда Excdev в поиске Тимлида ML

Общие требования
•Опыт: от 5+ лет в AI/ML, из них не менее 3 лет — в роли тимлида;
•Уровень: senior/lead ML engineer + опыт управленца (Tech Lead / AI Team Lead);
•Способность вести проекты от идеи до внедрения, включая исследование, архитектуру, разработку, деплой и мониторинг.
•Управление распределённой командой:

Глубокие технические компетенции
1. Распознавание финансовых документов (Document AI)
2. Vision-Language Models (VLM)
3. Разработка чат-ботов и интеллектуальных агентов
4. OSINT и глобальный поиск
5. Работа с веб-сайтами через Computer User Agent
6. Разработка локальных переводчиков

Условия:
Локация сотрудника не в РФ
Удаленный формат работы из любой точки мира
График с 10.00 до 19.00 по мск
Выплаты два раза в месяц

Контакт для связи
@VLT_recruiter


Привет!

Dodo Brands ищет дата-инженера в Drinkit

Наш стек:
- Databricks: PySpark, Spark SQL, Structured Streaming, Delta Lake
- Unity Catalog
- Python 3.12+
- Azure: Event Hubs, ADLS Gen2, Data Explorer
- IaC и шаблонизация: Terraform, Jinja2
- CI/CD: Git, Databricks Asset Bundles

Мы ожидаем:
- 4+ лет коммерческого опыта в роли Data Engineer / ETL-разработчик.
- Сильный SQL
- Уверенный Python для обработки данных и простых сервисов
- Опыт с Spark или аналогом.
- Базовый опыт с Kafka
- Проактивность: сам видишь проблемы и возможности в данных/пайплайнах и предлагаешь, что улучшить.
- Хочешь решать конкретные задачи, а не просто переливать данные.
- Умеешь говорить с аналитиками, иногда с менеджерами, не боишься вопросов, готов брать на себя ответственность

Мы предлагаем:
- Трудоустройство по ТК РФ;
- Удаленную работу из любой точки мира или в офисах в Москве или Санкт-Петербурге;
- Культуру свободы и ответственности. Мы ценим тех, кто готов принимать решения и брать за них ответственность;
- Оплачиваемое обучение. Курсы, конференции, профильная литература и софинансирование английского в Skyeng;
- Заботу о сотрудниках. ДМС с первого дня, включая стоматологию, и поддержка ментального здоровья через Alter.

Ссылка для отклика


доброго времени суток! Если можно опубликуйте вакансию

Role: Marketing Analyst
Company: Scentbird
Location: Remote

About Scentbird:
Scentbird is a digital subscription service and fragrance marketplace inspiring people to discover and explore scents beyond the ordinary.

What you’ll do:
- Analyze performance marketing across marketing channels
- Own CAC, LTV, ROI analysis and help optimize marketing efficiency
- Build and maintain attribution models and support incrementality testing
- Design and analyze A/B tests across creatives, landing pages, and funnels
- Evaluate performance of email, SMS, push notifications, and other CRM channels.

Requirements:
- 3+ years of experience in marketing / product / data analytics
- Strong SQL / Python and experience working with large datasets
- Experience with digital analytics tools (GA4, Mixpanel, Amplitude, Looker)
- Solid understanding of performance marketing metrics (CAC, LTV, ROAS, Attribution)
- Hands-on experience with A/B testing and experiment design
- Experience working with event tracking and GTM
- Knowledge of incrementality testing, MMM, or causal inference
- Experience analyzing CRM or lifecycle marketing campaigns
- Upper-intermediate English or higher

We offer:
• Competitive compensation + bonus
• Fully remote work
• Paid time off
• Fast-growing, product-driven company with strong analytics culture

Contact:
👉 DM: @svmakarovv


🔥 Успей присоединиться к онлайн хакатону от МТС с призовым фондом 700 000 ₽

На MTC Engineer Hack ты разработаешь техническое решение для телеком-сетей и проверишь его на реальном кейсе при поддержке экспертов МТС.

На MTC Engineer Hack тебя ждет:
— задачи, близкие к реальной работе инженеров;
— шанс попасть в команду МТС;
— очный финал в Москве за счет организаторов;
— мерч для финалистов.


➡️ Если ты инженер в области DevOps, радиоинженерии или сетевых технологий — подавай заявку до 26 сентября и попробуй свои силы на практике: https://u.to/Bay0Ig


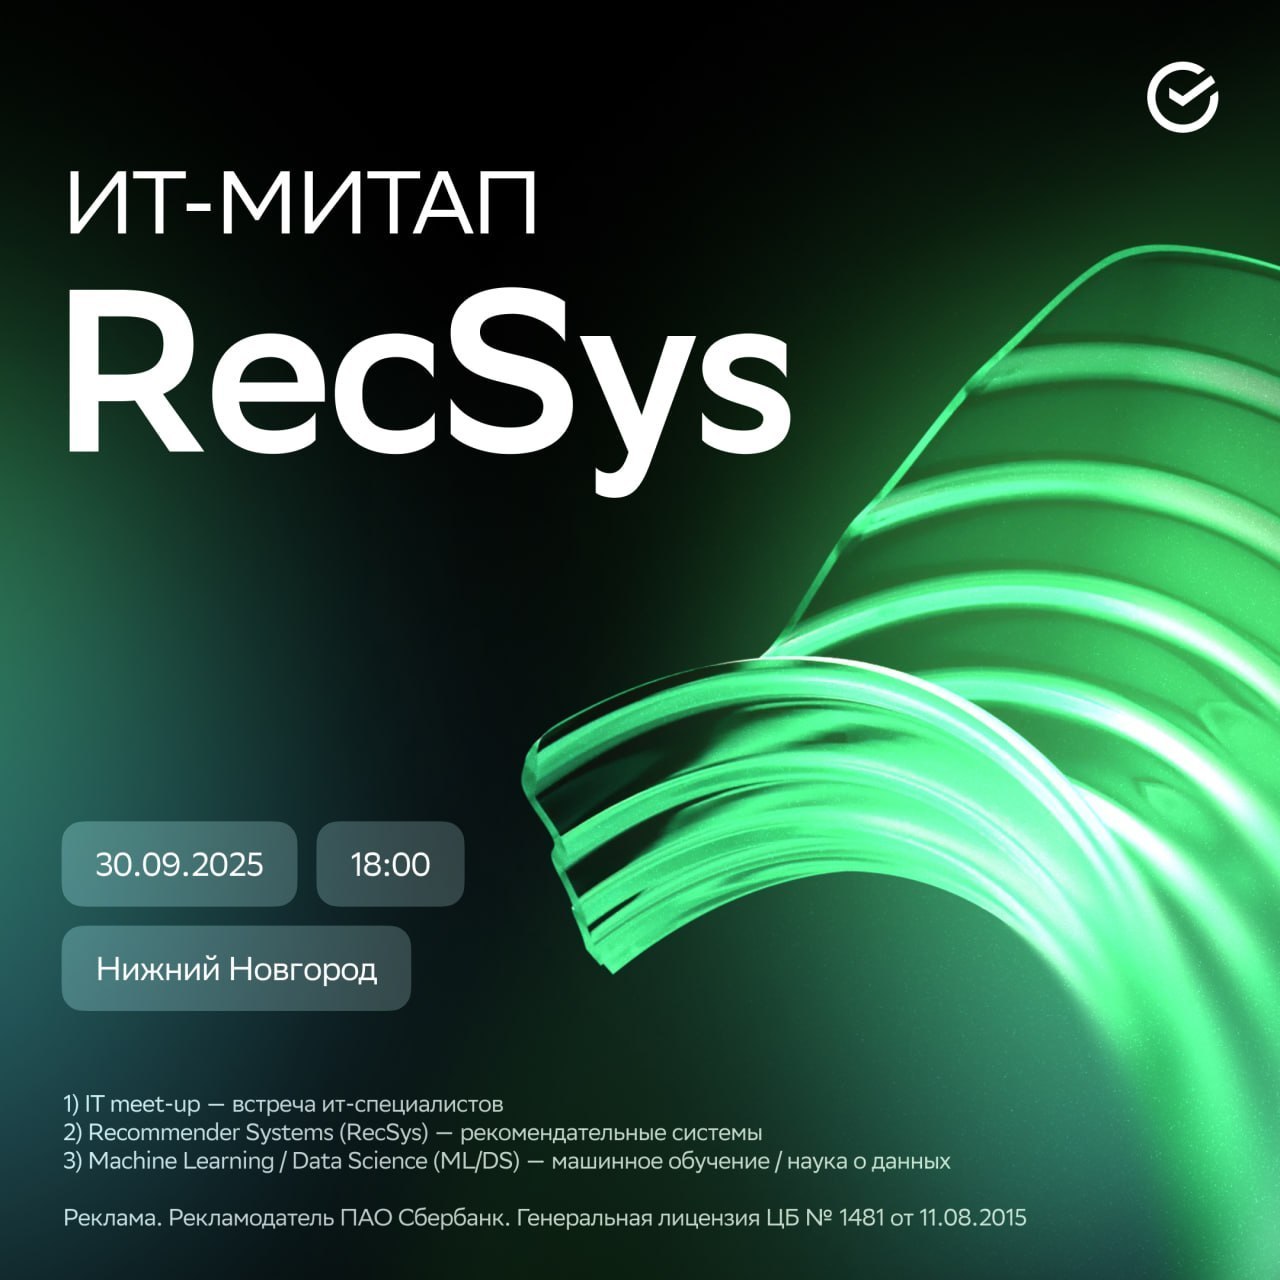
Как сегодня строят рекомендательные системы — и что будет с ними завтра?

30 сентября собираем RecSys-сообщество — разработчиков, ML/DS-специалистов и всех, кто делает персонализацию и рекомендации в реальных продуктах.

В программе — доклады от экспертов Сбера. Поговорим о свежих подходах и нестандартных решениях на реальных кейсах.

А после докладов переключаемся на неформальный режим: знакомимся, спорим про RecSys, обсуждаем идеи, находим единомышленников и просто хорошо проводим вечер среди своих.

📍г. Нижний Новгород, пространство «Гараж»

Количество мест ограничено — успей забрать своё по ссылке!


⚡️ Вышел отчет «Отечественные решения Data Lakehouse-круг Громова 2026»

Российский рынок Data Lakehouse перешёл от пилотных проектов к промышленным внедрениям. При этом рынок разделился на два архитектурных подхода, а информационная безопасность стала одним из главных критериев выбора платформы.

В исследование вошли 10 отечественных решений: MWS Data Lakehouse, Платформа Selena, Digital Q.DataFactory, CedrusData Platform, Data Ocean Nova, Tengri Data Platform, Arenadata Hyperwave, VK Data Platform, YTsaurus и Yandex Data Platform.

➡️ Отчёт даст ориентиры:
– чем отличаются интегрированные платформы от унифицированных систем,
– когда важнее гибкость и технологическая свобода, а когда – простота внедрения и сопровождения,
– какие компоненты и архитектурные подходы используют российские Data Lakehouse,
– на что обратить внимание при выборе платформы для корпоративного хранилища данных.

➡️ Особое внимание уделено:
– драйверам перехода на Data Lakehouse – почему технология становится востребованной и какие задачи заказчиков стимулируют её внедрение,
– информационной безопасности – RBAC, сквозному управлению доступом, аудиту и Data Lineage,
– S3-хранилищу, которое фактически становится фундаментом производительности Lakehouse,
– AI/ML и AI-агентам: полноценные агентные возможности на российском рынке пока остаются скорее исключением, чем стандартом.


📌 Исследование основано на сравнении технологических стеков, экспертной оценке решений и анализе практических сценариев их применения. Полный отчёт доступен на сайте центра «Круги Громова» – скачать бесплатно!

Получите актуальную картину российского рынка Data Lakehouse на 2026 год.

#КругиГромова #DataLakehouse #DLH #DWH #исследование_КругиГромова


Гайз, знаю что все ждали этого — новый сезон опроса State Of Data
оч прошу потратить 10 минут времени всем и каждому + разослать по чатикам с коллегами

в этом году, ожидаемо, появились вопросы про всякие llm и прочих агентов )

https://forms.gle/Fp6HrZxBw7Y5VbFw7

давайте посмотрим насколько помирает хадуп (особенно по сравнению с позапрошым годом)
насколько выстреливает старрокс (или наоборот стагнирует)
и прочие интересные инсайты вытащим

там в форме есть ссылки на .parquet с исходниками опросов '24 и '25
по текущему опросу исходник выложу в ту же гуглопапку ~ в середине октября


senior ds, 350-550 gross, большой зеленый финтех, Москва офис/гибрид
Senior Data Scientist / MLE

Дивизион "Моделирование и исследование данных" отвечает за компетенцию Data Science в Блоке Сеть Продаж.
Мы разрабатываем и внедряем end-to-end решения на основе AI в бизнес-процессы Сети Продаж Банка.
Ищем человека, вместе с которым мы будем строить топовые AI решения, на основе архитектуры Claw-like & Ouroboros, которые будут в действительности приводить к Disrupt в реальных процессах.

Задачи:

• разрабатывать с нуля AI-агентов и микросервисы для AI-продуктов
• исследовать и внедрять новейшие технологические решения в ИИ - Claw-like & Ouroboros
• разрабатывать и дообучать модели машинного обучения (Classic ML, Deep Learning)
• разрабатывать алгоритмы взаимодействия ML-моделей и сервисных модулей
• принимать участие в разработке архитектуры и дизайна агентов и AI-сервисов
• проектировать и разрабатывать backend-части AI-сервиса
• принимать участие в оптимизации скорости работы AI-агентов и ML-моделей.

Мы ожидаем:

• законченное высшее образование
• компетенции: Python, Classic ML, Deep Learning, LLM/Agents, MLOps
• понимание принципов разработки, внедрения и сопровождения AI-решений
• уметь писать хороший и понятный production-ready код на Python, хорошее знание алгоритмов, структур данных
• опыт работы с реляционными и нереляционными базами данных
• навыки работы с генеративными AI-моделями, опыт создания AI-агентов и использование их в работе будет преимуществом
• опыт использования GigaChat, Kandinsky и аналогов в продуктах
• инструментальное владение Ai для анализа, генерации и автоматизации
• опыт построения отказоустойчивых высоконагруженных распределенных ML систем.


Мы готовы предлагать:

• график 5/2, офис на м. Кутузовская;
• режим работы на выбор - офис или гибрид
• достойный уровень вознаграждения (оклад + годовая премия)
• возможность стать частью команды, реализующей программы цифровой трансформации банка - на основе передового опыта и инновационных идей
• широкие возможности для профессионального развития: корпоративный университет и множество онлайн-программ обучения. Корпоративное обучение за счет компании
• бесплатная подписка СберПрайм+, многочисленные скидки и бонусы от партнеров: СберМаркет, МегаМаркет, Самокат, Еаптека и др.

Резюме можно направить @TNemkovskaya


Вакансия Product Manager
Название компании: MyFinishLine — международная платформа виртуальных квестов для активных людей. Пользователь двигается в реальной жизни (ходит, бегает, ездит на велосипеде) и открывает главы приключенческой истории, проходя маршруты по всему миру
https://myfinishline.app/
Формат работы: удалённо, полная занятость
Контакты: @DN_MFLi

Чем предстоит заниматься
Формировать и развивать продуктовую стратегию и roadmap приложения
Самостоятельно собирать рабочие прототипы (вайб-кодинг) и тестировать гипотезы 
Проводить исследования пользователей (ретеншн, вовлечённость, причины оттока), формулировать гипотезы и проверять их через A/B-тесты
Развивать ключевые механики геймификации: сюжетные квесты, систему медалей, интеграцию со Strava и другими фитнес-сервисами
Анализировать продуктовые метрики и на их основе принимать решение 

Наш идеальный кандидат
Продакт с опытом в геймифицированных продуктах или играх, который понимает, как устроена мотивация пользователя, как выглядит хороший онбординг и пейволл. Важно, чтобы понимал не только продуктовую составляющую, но и сам мог сделать решение руками: например, сделать в Figma концепт и собрать рабочий прототип через вайбкодинг и AI-инструменты. 
▪️Критично важен опыт в игровых/около игровых приложениях/платформах, или fitness/спорт/lifestyle-приложениях или play-to-earn продуктах
▪️Опыт работы продакт-менеджером или продакт-дизайнером от 2 лет 
▪️Есть измеримые кейс роста revenue или LTV
▪️Опыт работы с AI и вайбкодингом, нам нужен человек, который умеет выстраивать инфраструктуру 
▪️Уверенное владение Figma: попросим ваше портфолио с дизайнами лендингов 
▪️Опыт работы с аналитикой: умеете сами прочитать CJM и понять, какая метрика и почему проседает
▪️Понимание принципов геймификации и удержания пользователей

Сильным плюсом будет
▪️Сильный визуальный вкус, особенно в дизайне лендингов 
▪️Базовое понимание HTML/CSS/JS достаточное, чтобы поправить то, что сгенерировал AI 
▪️Опыт работы с БД 
▪️Английский язык на уровне, достаточном для чтения документации и написания текстов для лендингов и интерфейса

Как откликнуться
В сообщении @DN_MFLi пришлите пожалуйста, кейс в формате: ниша / что сделали / какой результат, а также примеры вашего дизайна в Figma, и как именно вы используете AI


Добрый день!

А можно у вас разместить вакансию:

Вакансия: ML Researcher / ML Engineer — медицина
Компания: Сибинтек
Локация: Москва, Россия
Занятость: full-time
Формат работы: офис / гибрид / удалённо (РФ)

Наша команда занимается проектами в области здравоохранения, создавая прорывные диагностические и прогностические решения. Наша цель — работа над нейродегенеративным направлением: в тесной связке с врачами мы находим потенциальные возможности и воплощаем их в реальные продуктовые решения.

Чем предстоит заниматься?

-Анализ и выбор SOTA-решений: постоянный мониторинг передовых подходов под конкретные задачи, а также умение переводить статьи в код без готовых репозиториев;
-разработка и улучшение моделей детекции, сегментации и трекинга: обучение и адаптация моделей для обработки диагностических снимков, видеоаналитики и данных анамнеза;
-мультимодальная обработка данных: разработка пайплайнов для обработки медицинских данных, полученных из разных источников;
внедрение и масштабирование: оптимизация моделей, анализ ошибок, работа с большими объёмами данных и инфраструктурой обучения.

Что мы ценим и ищем?

-Обучаете нейросетевые модели и применяете разные подходы. Понимаете, как именно модели устроены изнутри;
работаете с PyTorch;
-ориентируетесь в мире прикладного DL: знаете теорию компьютерного зрения и умеете добиваться практических результатов;
-понимаете особенности realtime-ограничений;
читаете статьи с ML-конференций и следите за развитием области.

Будет плюсом, если вы:

-Работали с медицинским доменом;
-имели дело с большими фундаментальными моделями и понимаете, как они устроены;
-имеете публикации на ведущих ML-конференциях;
-имеете профильную учёную степень (физико-математическое направление).

Что вас ждет?

-ДМС со стоматологией;
-28 календарных дней отпуска;
-годовая премия по результатам работы;
-конкурентная заработная плата (по результатам собеседования);
-корпоративное обучение и возможности для профессионального развития;
-доступ к серверам с профессиональными GPU для обучения, тестирования и экспериментов с моделями;
-отсутствие ограничений по использованию современных AI-инструментов.

Резюме направлять: @AlexandraGhu

Показано 20 последних публикаций.