


🧪 How-to: применить bootstrapping для оценки статистик
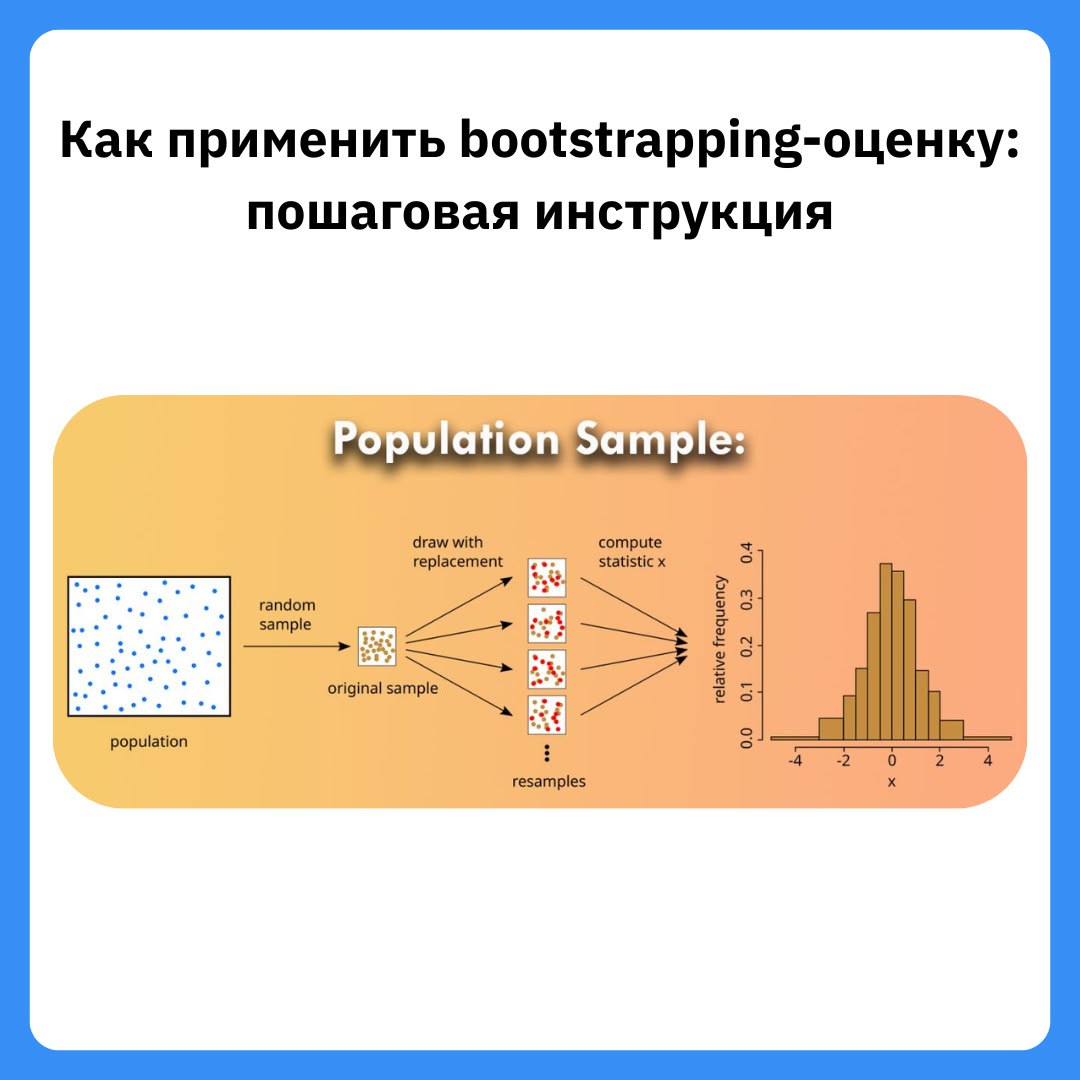
Когда данных немного или нет уверенности в распределении, bootstrapping приходит на помощь. Это техника, позволяющая оценить доверительные интервалы и стабильность метрик без строгих статистических предположений.
🚩 Что делать
Мы будем многократно пересэмплировать нашу выборку с возвращением и оценивать интересующую статистику (среднее, медиану, разницу, корреляцию и т.д.).
🚩 Шаги:
1️⃣ Импорт библиотек:
import numpy as np
from sklearn.utils import resample
2️⃣ Готовим данные:
data = np.array([12, 15, 14, 10, 8, 11, 13]) # пример
3️⃣ Запускаем бутстрэп:
boot_means = []
for _ in range(1000): # количество повторений
sample = resample(data, replace=True)
boot_means.append(np.mean(sample))
4️⃣ Оцениваем результат:
conf_int = np.percentile(boot_means, [2.5, 97.5])
print(f"95% доверительный интервал для среднего: {conf_int}")
🚩 На что обратить внимание:
📍 Используйте не менее 1000 итераций для устойчивых результатов.
📍 При маленьких выборках возможны смещения и высокая дисперсия.
📍 Если данные сильно несбалансированы — будьте осторожны с интерпретацией.
🚩 Основные преимущества:
✔️ Гибкость — можно применять к любым статистикам, особенно если неизвестно теоретическое распределение.
✔️ Без предположений — не требует априорных знаний о распределении в популяции.
✔️ Надёжность — работает даже при небольшом объёме выборки.
Библиотека дата-сайентиста #буст