DataTalks


Channel's geo and language: Russia, Russian
Category: Technologies


Образовательный проект DataTalks. Рассказываем про управление данными на конференциях, митапах и марафонах.
#datatalks #безграниц #безрекламы #безводы
Контакты:
dataoffice@rt.ru
datatalks.rt.ru
rutube.ru/channel/25367326/

Related channels  |  Similar channels

Channel's geo and language
Russia, Russian
Statistics
Posts filter


Программа первого дня — раскрываем карты
Одной интригой меньше. На сайте выложили программу первого дня Data & AI Talks 7.0 — теперь можно посмотреть, кто выйдет на сцену 15 октября и о чем будет говорить. А что будет 16 октября пока еще интрига.

Спойлер: будет мощно.

⚡️ Мы позвали CDO и экспертов из Сбера, Московской биржи, X5, Дом.РФ, Газпром-Медиа, Rutube, Premier и других компаний, которые расскажут, как у них устроена работа с данными и что происходит, когда в дата-офис приходит ИИ со своими запросами.

🔹 Секцию по искусственному интеллекту делаем вместе с Альянсом в сфере ИИ — там будет:
— открытое заседание отраслевого ИКТ-клуба
— разговор про деньги: как считать финансовые эффекты от внедрения ИИ
— наука и кадры — откуда брать людей и что с этим делать

📁 ДЗО Ростелекома - БФТ, Беркут, Солар, ТДата, Турбо Облако - поделятся своим опытом трансформации компаний и изменениями у заказчиков.

Первый день — это стратегия и дискуссии в офлайне (Москва, метро Автозаводская), с онлайн-трансляцией на Wink.

📎 Программа и регистрация на сайте


Скоро мы начнем выкатывать анонсы докладов Data & AI Talks 7.0. А пока — видео с прошлогодней конференции и ответы постоянных участников на вопрос «что для вас DataTalks».

⚡️ Новость для дочитавших: в сетке еще есть свободные слоты.

Конференции семь лет, и мы проводили не смотря на ковид, импортозамещение и всё остальное. Счетчик показывает 7.0, нам самим не верится.

Если давно собирались выступить у нас и ждали знака — это он. Есть два трека: Данные и ИИ.

✏️ Заявку можно оставить — на сайте.

Приходите рассказать, что у вас работает. И что не работает — это обычно даже интереснее.


Forward from: TData
⚡️Приглашаем на бизнес-завтрак T1 и TData

26 июня на встрече расскажем, как эффективно применять передовые отечественные технологии и методики управления данными для достижения стратегических целей.
Своим опытом поделятся представители АО «Объединённая двигателестроительная корпорация» и ЕВРАЗ.
Для всех участников подготовлено уникальное предложение пилотного проекта с использованием данных технологий, что позволит оценить целесообразность внедрения.

*Количество мест ограничено. Необходима предварительная регистрация.

Зарегистрироваться


📝 На Хабре вышла интересная аналитика по информационной безопасности. Согласно исследованию, количество и мощность DDoS-атак растут, ставя под угрозу доступность публичных и корпоративных сервисов.

⚡️ Мы поговорили о том, что такое DDoS-атака, что означают цифры из аналитического отчета для отрасли в целом, и для Ростелекома в частности, и о том, какие угрозы информационной безопасности стоят перед Централизованным хранилищем данных (ЦХД) Ростелекома со Станиславом Поповым.

DDoS-атака – эффективный, простой и дешевый способ провести атаку. Стоимость атаки начинается от 10 долларов на небольшую организацию и пользуется большим спросом. С учетом того, что ботнет сети растут, а большая часть устройств в них – это IoT-устройства с низкой защитой, цифры будут только расти – в начале года самая большая атака - 6 Тбит/с, в конце 2025 года достигала 29 Тбит/с.

Это говорит о том, повышается эффективность защиты от DDoS-атак. Именно это заставляет атакующих наращивать мощности атак. Кроме этого появляются эффективные способы защиты от одних атак (например, UDP Flood) и вектор смещается на более сложные и соответственно дорогие атаки (TCP SYN Flood и TCP PSH/ACK Flood). Это постоянная эволюция щита и меча.

Я бы обратил внимание, что цифры звучат внушительно –количество атак 140 628 и длительность 22 743 часов в 2025 году, но средняя продолжительность – 9,8минут. Средняя продолжительность в 2024 году – 7,3 минуты. Средняя продолжительность атаки выросла на 2,5 минуты. Атаки носят разведывательный характер – проверяют есть ли защита от DDoS-атак и длятся атаки меньше минуты.

Много это или мало?

Например, у одного из крупнейших маркетплейсов – средняя выручка в 2025 году составила практически 6 миллионов в минуту (выручка wildberries в 2025 году 3,1 триллиона рублей). Если маркетплейс будет недоступен из-за DDoS-атаки в течении 10 минут, покупатели пойдут заказывать товары к конкурентам – убытки составят около 60 миллионов рублей. Конечно это примерные цифры. Естественно, что маркетплейс будет вкладывать большие средства в обеспечение доступности своих сервисов.


➡️ И мы переходим к оценке критичности DDoS-атаки для команды Центра управления данными Ростелекома.
Централизованное хранилище данных (ЦХД) Ростелекома – это внутренний сервис и напрямую не связан с интернетом. Опосредованно, DDoS -атаки могут повлиять на работу VPN-шлюза для пользователей, получение данных для наполнения ЦХД из внешних источников, получения обновлений. С учетом непродолжительности атак – это не очень критично.

Но DDoS-атаки могут быть не только внешними, но и внутренними. Если пользователи или другие системы нагружают ЦХД неправильно настроенными запросами или большим количеством запросов, это влияет на работоспособность ЦХД. Для балансировки нагрузки на БД у нас используются Keepalived, Pgbouncer, Haproxy, которые контролируют нагрузку на сервисы с помощью мониторинга и распределяют нагрузку.

Но и этого может быть недостаточно. Для контроля работы со SPILL-файлами команда ЦХД разработала систему контроля – Демократизатор. Подробнее о ней читайте в статье.

Есть и другие критичные вектора атак для ЦХД – атака на цепочку поставок и выгрузка данных недобросовестным пользователем. Атака на цепочку поставок – это атака через подрядчика. Зачем атаковать напрямую, преодолевать выстроенную систему защиты, если можно взломать подрядчика, у которого намного меньше ресурсов для создания полноценной системы защиты? Этот тип атак актуален и для Ростелекома, и для ЦХД.

Второй тип – это даже не атака. Пользователь может выгрузить себе на компьютер данные и потом вынести эти данные. Если большой объем данных можно заметить с помощью того же Демократизатора, то выгрузка небольших объемов в течении некоторого времени останется незаметной.

Эти угрозы можно нейтрализовать с помощью дополнительных средств, таких как PAM или IDM, но кроме того, что эти системы дорогие, их необходимо эксплуатировать и реагировать на их оповещения.


Forward from: TData
⚡️️️️ Новый релиз RT.ClusterManager 2.9.0

Новая версия — это не просто технический апдейт, а шаг к более зрелому и автоматизированному управлению распределёнными СУБД и аналитическими системами.

Что изменилось:
🟣при создании кластера теперь можно сразу выбрать контур: PROD, UAT, DR, DEV или TEST — меньше рисков, чётче разделение сред;
🟣появился встроенный планировщик событий для автоматизации регулярных операций;
🟣добавлен конструктор YARN Scheduler для пользователей RT.DataLake (Hadoop) — полный контроль над распределением ресурсов;
🟣полностью переработан интерфейс;
🟣обновлены Java (до 23) и Spring Boot (до 3.4), устранены уязвимости;
🟣усилены механизмы стабильности и защиты от ошибок.

Отдельное внимание уделено соответствию требованиям импортозамещения: платформа продолжает поддерживать российские ОС, включая Astra Linux, RedOS и ALT Linux.

Ссылка на релиз

tdata.tech / RUTUBE


Возможно вы не знали, но у Ростелекома есть ДЗО TData. И ребята делают очень крутые продукты управления данными (знаем, потому что сами пользуемся этими продуктами).

Сегодня мы расскажем вам про один из продуктов - RT.ClusterManager

📌 Что такое RT.ClusterManager ?
RT.ClusterManager –централизованная платформа оркестрации, через единый интерфейс обеспечивающая развертывание, конфигурирование, мониторинг и обновление кластеров.

Кластера для хранения и обработки данных представляют из себя сложные системы. Для управления кластерами требуются большие технические навыки. Но даже с техническими навыками ручное управление создает риски. Со временем кластеров становится больше, среды разделяются, операционная нагрузка растёт и ручное управление становится невозможным.

RT.ClusterManager берёт это под контроль👌

Платформа позволяет:
🟣автоматизировать регулярные операции по управлению кластером и снижать влияние человеческого фактора,
🟣управлять несколькими кластерами из одного интерфейса,
🟣контролировать состояние и нагрузку.

При этом сохраняется соответствие требованиям информационной безопасности и импортозамещения.

Проще говоря, это инструмент для DBA и DevOps-команд, который делает инфраструктуру управляемой, а процессы — воспроизводимыми.

➡️ Результат — меньше операционных рисков, больше предсказуемости и устойчивости в работе с данными.

Кстати, уже вышла версия RT.ClusterManager 2.9.0, скоро расскажем что в ней есть


6. Количество проектов по внедрению генеративного ИИ увеличится
Да, хайп еще не остыл, многие компании из числа не самых пионеров еще не распробовали ИИ в бизнес процессах, им это еще предстоит.

Причем я уверен, что не все сценарии эффективного применения еще открыты, и нас ждет еще некоторое количество интересных открытий и способов применения этих технологий в бизнесе.
В Ростелекоме, кроме Нейрошлюза, существует и собственная платформа ИИ, на которой можно размещать и пробовать различные гипотезы.


7. Большинство организаций будет вести системную работу по управлению данными
Не ожидал наткнуться именно такой заголовок в 2026 году. В то время, в котором казалось бы необходимость в управлении данными уже всем очевидна и доказана, но да, с одной стороны ИИ подталкивает всех начать управлять данными там, где этого еще не сделали, и с другой стороны тренд цифровизации мог до кого-то еще не докатиться.

Я лично давно уверен, что системная работа с данными это основа развития ИТ и бизнес процессов в целом, а путь дата-центричности позволит развиваться компаниям гораздо быстрее конкурентов.

Прямо сейчас мы разрабатываем и презентуем обновленную стратегию по управлению данными в компании и даже группе компаний, которая как раз призвана и зафиксировать все успехи и удачные идеи предыдущей стратегии, и внести важные обновления в процессы и подходы, которые в том числе будут стимулировать развитие ИИ решений на базе данных компании.


8. Заказчики будут чаще отдавать предпочтение мультиоблачной модели
Мультиклауд, на мой взгляд, весьма сложен. А на российском рынке не выстроена еще системам из игроков, на которых можно складывать решения и гибко использовать одного или другого.

Плюс поддержу мнение, что это серьезная инженерная задача для команд инфраструктуры: сделать такую конфигурацию прозрачной для работы приложений и для разработчиков.

Тем более, что с растущей активности киберугроз многие будут стремиться уйти в более контролируемый онпремис, чем развивать сложную конфигурацию с несколькими облаками.


9. Российские компании расширят применение локальных дата-центров
Как я уже говорил в предыдущем пункте – реалии в ИБ толкают компании в собственные ЦОД. Но не только это.
ИИ тенденции требуют создания новых ЦОДов, с другими характеристиками по питанию и охлаждению и в принципе по организации пространства и распределению мощностей.

Но строить такие ЦОДы могут далеко не все. Это очень сложная, дорогая, энергоемкая задача. Поэтому локальность будет у немногих, кто сможет – у очень крупных игроков, к которым, к счастью, группа РТК тоже относится.


10. Острая нехватка российских электронных комплектующих сохранится
Мы давно не слышали о новых успехах микроэлектроники. Производство чипов очень сложная, многослойная задача, и мало кто в мире вообще смог решить задачу локализации всех слоев. Отсюда и у нас сохранится общая зависимость от мировых тенденций, например, как текущий кризис нехватки оперативной памяти.

Однако мы видим уже немало российских игроков - производителей железа, которые стабильно наращивают уровень локализации в своих продуктах.

Будем ждать новых прорывов!


➡️ Тренды 1–5 в первой части

———
#аналитика #экспертное_мнение


CNews опубликовал ТОП-10 ИТ-трендов в России на 2026 г., и мы обсудили их с Борисом Емельяновым – техническим директором Центра управления данными Ростелекома, и.о. Директора по управлению данными.


1. Цены на российское ПО вырастут
С одной стороны – да. Факторы роста объективны: инфляция, подкрепленная налоговыми изменениями.

Однако, нужно учитывать и другие факторы. Например, то, что косты российских вендоров – это в основном ФОТ. А ситуация на рынке труда для ИТ специалистов сейчас объективно сложная.

К тому же в компаниях заказчиках может снижаться активность инвестпрограмм, а значит за клиента вендорам еще придется побороться. В такой ситуации, возможно, удобней будет где-то снизить маржу, а не потерять клиента.

В таком случае рост цен на ПО может быть и не таким крупным, как прогнозируют.


2. Темпы импортозамещения ИТ сохранятся на текущем уровне
Тоже верю в этот тезис.

Некоторые компании, например, как Ростелеком, уже прошли самые сложные этапы и заместили многие ключевые компоненты своих информационных систем, что должно, замедлять общий темп.
Замещение ключевых инструментов в аналитической платформе мы завершили еще несколько лет назад, и продолжаем использовать наш пакет инструментов: RT.Warehouse, RT.Datalake, RT.Widestore, RT.Data Governance, RT.Data Vision и другие.

Однако, знаю не мало и таких компаний, которые долго занимали выжидательную позицию, и их ИС на иностранных решениях уже подходят к концу своего жизненного цикла, морально устаревают и требуют обновления. Вот за счет таких игроков темп вполне вероятно будет сохраняться.


3. Спрос на начинающих программистов существенно сократится
Вот тут интересно.

Действительно LLM и нейросети ведут нас к тому, что в простой работе джуна заменит Copilot, но откуда тогда будут браться новые миддл и синьор программисты?

Очевидно, что спрос на кадры не исчезнет, но возможно преобразятся требования и ожидания к начинающим специалистам, да и к работе с LLM в целом. Вот этот навык точно всем желающим остаться в отрасли нужно в себе тренировать.

У нас в Ростелекоме всем внутренним сотрудникам доступен замечательный инструмент – Нейрошлюз: дверь в мир LLM и агентских цепочек. А также активно проводится обучение по использованию ИИ и нейросетей в рабочих процессах.


4. Количество кибератак и масштабных публичных инцидентов будет расти
Тревожный, но важный тренд.

Сложно не согласиться с аргументами и еще сложней аргументировать важность затрат на ИБ в эпоху фокуса на эффективности.
Но если представить себе возможные потери от остановки бизнес процессов или утечки пользовательских данных – все встает на места.

В этом месте хочется отдельно напомнить всем коллегам, и нашим инженерам, что ИБ – это не прихоть отдельных архитекторов, а базовая необходимость во всех ИТ системах. Это же важно доносить и до заказчиков, которым иногда скорость может быть важнее внимания к рискам.


5. Бюджеты компаний на ИБ-аутсорсинг возрастут
Здесь мы отлично видим, как щит не успевает за мечом. Волна популярности нейросетей и публичных сервисов накрыла компании так быстро, что многие просто не успевают адаптироваться. Конечно важно давать пользователям возможности: защищенные внутренние ресурсы для общения с LLM и использования в своих проектах с минимальными рисками. Иначе данные компании через обычных пользователей будут утекать во внешние сервисы.

Отдельный пласт возможных проблем – это те риски, которые несет компания, встраивая в рабочие процессы модели (так называемое агентское использование).

Многие просто не предусматривают возможных вариантов поведения такого агента, а OWASP недавно выпустил отдельный отчет о том, какие основные угрозы скрываются в таком сценарии. Аудит и защита бизнеса от потенциальных проблем ИБ в этой области действительно открывает новый рынок для ИБ профессионалов.

К счастью, в Ростелекоме есть Блок информационной безопасности и РТК.ИБ,, которые помогут нам защититься от этих проблем.


➡️ Продолжение в части 2

———
#аналитика #экспертное_мнение


Вам надоели новости про ИИ? Честно, нам тоже.

Казалось бы, уже всё: новые версии моделей, генеративные котики, дипломы на ChatGPT, компании, внедрившие ИИ-агента в процесс № 234. ИИ-новости, написанные с помощью ИИ.

✨ Но мы нашли три статьи, которые вернут вам веру в ИИ. Потому что это технология, которая реально спасает людей в тех задачах, где человек уже не справляется.

➡️ Читайте: раз, два, три.

———
#Подборка_статей #Искусственный_интеллект


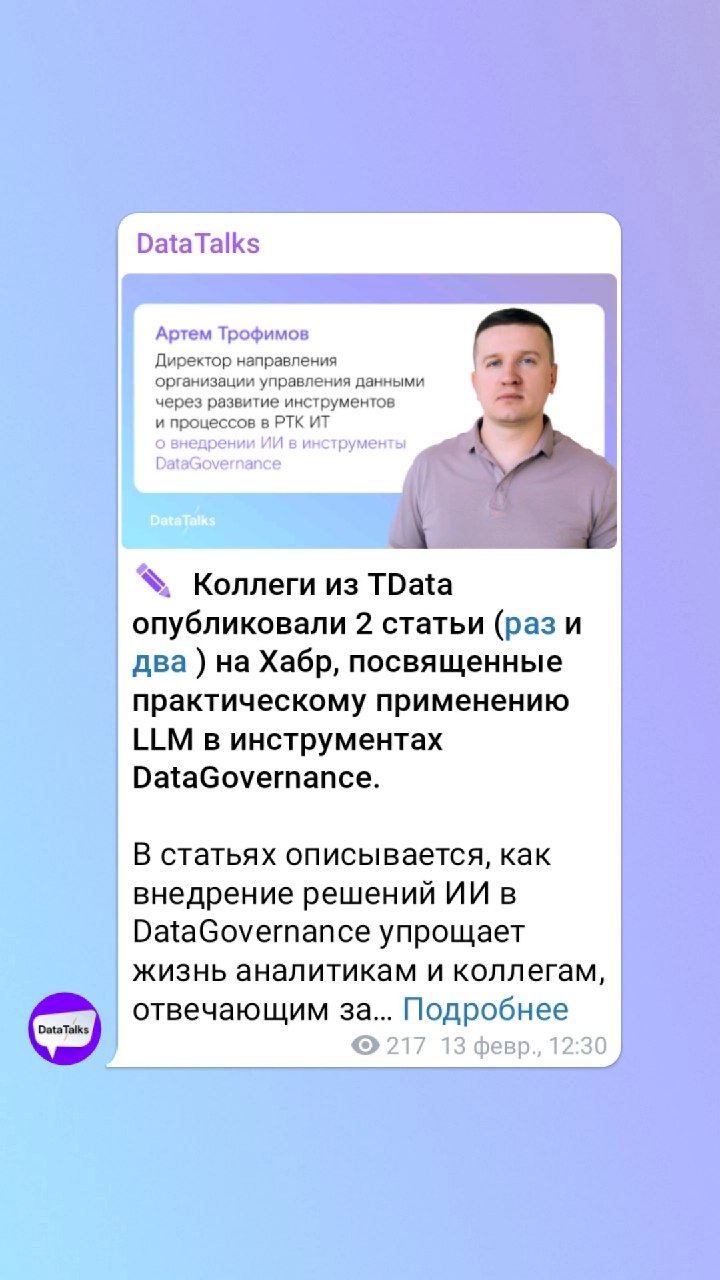
✏️ Коллеги из TData опубликовали 2 статьи (раз и два ) на Хабр, посвященные практическому применению LLM в инструментах DataGovernance.

В статьях описывается, как внедрение решений ИИ в DataGovernance упрощает жизнь аналитикам и коллегам, отвечающим за безопасность данных.

📞 Мы поговорили про эффекты внедрения обновленного инструмента RT.DataGovernance с Артемом Трофимовым - Директором направления организации управления данными через развитие инструментов и процессов в РТК ИТ.
Реализованы две важные функции ИИ, которые мы можем наблюдать в инсталляции RT.DataGovernance Ростелекома уже сейчас:
1. разметка персональных данных (ПДн)
2. описание объектов БД.
Решение этих задач вручную, без инструментов ИИ, никогда бы не было сделано, потому что заняло бы в разы больше времени.
Разметка ПДн в 20 раз увеличила скорость классификации данных по сравнению с ручной разметкой (при выполнении ручной проверки ресурсам в 3 ШЕ по фиксированному количеству объектов).
Описание объектов БД повысила доступность и понятность данных. Это позволяет аналитикам тратить на 15-30% меньше времени на задачи изучения данных (особенно когда речь идет о "сырых" данных систем-источников).
Спойлер!

Скоро будет внедрено и описание атрибутов, что сильно поможет в анализе тех таблиц, где сейчас нет никакого описания.


Все описанные функции доступны для любого подключенного ХД в датакаталоге DG. Поэтому будут полезны не только существующим пользователям DG, но и новым участникам.

➡️ Хотите узнать про DataGovernance в Ростелекоме больше – пишите свои вопросы в комментариях.
Ну и ставьте лайки, подписывайтесь на канал:)


➡️ Статья про подготовку данных для дэшбордов.

➡️ Статья о том, как делать дэшборды, понятные всем сотрудникам компании, независимо от их уровня погружения в продукт.

➡️ Статья о важности критического мышления при анализе графиков

➡️ И самая лучшая (на наш взгляд) книга про визуализацию данных

———
#Полезная_подборка #Аналитика_данных #Визуализация_данных


💬 Хабр и сайт «Грамота.ру» подвели итоги голосования за фразу или слово 2025 года. В категории «Информационные технологии» победил «вайбкодинг». На втором месте «ИИ‑агент», на третьем — Max.

При выборе "слова года" используются следующие критерии: новизна, актуальность, частота употребления, освоение в языке. Подробнее о том, как проходит исследование и какие слова победили в отраслях психологии, экономки и финансов читайте здесь.

📞 А какое слово года у вас? Делитесь в комментариях!


🟣Термодинамический способ ИИ-генерации — разработан прототип чипа для машинного обучения, который сможет потреблять в 10млн раз меньше электроэнергии

🟣Gemini 3 научили анализировать изображения как человек — приближать и отдалять изображение чтобы рассмотреть детали

🟣Adobe обновила Photoshop — улучшения в Generative Fill и новая бета-функция для работы с текстом

🟣Статья про аугментацию данных — как "испортить" картинки (повороты, шум, вырезание фрагментов, искажения), чтобы нейросеть обучалась лучше.

———
#Подборка_статей #Генерация_изображений


🟣 Ландшафт киберугроз 2025 года — масштабная аналитика от Positive Technologies. Спойлеры → рост атак на 6%, основные жертвы — госсектор (15%) и промышленность (15%), популярные методы — вредоносное ПО (71%) и социальная инженерия (51%). В России за 8 месяцев утекло 13 млрд строк персональных данных

🟣 Как сайты вычисляют мошенников — детальный технический разбор антифрод-систем

🟣 Киберпреступные форумы — интересная статья о том, как устроена информационная безопасность на "темной стороне" интернета

———
#Подборка_статей #Информационная_безопасность


🟣 Статья Авито про автоматическую проверку качества дэшбордов

🟣 Островок рассказал про интеграцию DataHub с нейросетями. Спойлер ➡️ Теперь искать владельцев таблиц и анализировать связи можно через простой диалог с ботом.

🟣 Статья о том, как и почему Лемана про переходила с проприетарного каталога данных на Open Source и что из этого получилось. Спойлер ➡️ Пошли ва-банк, выбрав вариант с собственной разработкой

———
#Подборка_статей #Data_Governance

20 last posts shown.