CV Time


Channel's geo and language: Russia, Russian
Category: Technologies


Канал о компьютерном зрении от ml-специалистов Яндекса: разбор актуальных статей, горячие обсуждения и личный опыт из первых рук. Присоединяйтесь!
Вопросы и предложения > @yandex_ml_brand

Related channels

Channel's geo and language
Russia, Russian
Statistics
Posts filter


Четыре способа испортить предсказание диффузионной модели

Сегодня делимся обзором четырёх работ, в которых генерацию улучшают, отталкиваясь от специально испорченного предсказания. Посмотрим на разные методы такой «порчи» и полученные результаты.

Guiding a Diffusion Model with a Bad Version of Itself

Для начала вспомним CFG (Classifier-free guidance). При обучении модели в части случаев (скажем, 10%) подаётся пустой кондишн. При сэмплировании получают conditional- и unconditional-предсказания и экстраполируют от второго в сторону первого.

CFG улучшает качество и соответствие условию, но при этом снижает разнообразие генераций. Авторы предлагают метод Autoguidance — вместо unconditional-предсказания берут предсказание ухудшенной версии той же conditional-модели, например, недообученной или уменьшенной.
И тут надо понять, как именно должна быть ухудшена вторая модель. В аблейшнах авторы сравнивают разные варианты.

• Если обе ветки ухудшены одним способом, но с разной силой, экстраполяция может компенсировать ухудшение (например, для моделей с постфактум добавленным дропаутом разной силы FID удалось снизить с 5 до 2,55 — практически до уровня исходной модели с FID 2,56).

• Если же характер ошибок различается — например, одна ветка испорчена дропаутом, а другая шумом — guidance не помогает, лучший FID получается при scale = 1, то есть без экстраполяции.

Основная идея Autoguidance в том, что плохая модель должна делать ошибки того же характера, что и хорошая, только сильнее.

Self-Rectifying Diffusion Sampling with Perturbed-Attention Guidance

Авторы заходят с чуть другой стороны и предлагают метод PAG (Perturbed-Attention Guidance). В одном или нескольких аттеншн-блоках строят ухудшенное предсказание, заменяя attention map на единичную матрицу. Получается, что каждый токен смотрит только на себя — и пространственное взаимодействие между токенами в этом блоке пропадает. При генерации отталкиваются от этого ухудшенного предсказания.

В эксперименте на Stable Diffusion 1.5 PAG дал более низкий FID, чем CFG. При этом методы можно сочетать, и вместе они показывают ещё более высокое качество.

Stochastic Self-Guidance for Training-Free Enhancement of Diffusion Models

Здесь плохое предсказание получают за счёт того, что на каждом шаге диффузии случайно выбирают 10% трансформер-блоков и пропускают их. При попытке реализовать этот метод мы столкнулись с тем при дропе трансформер-блоков на изображениях действительно появлялось больше деталей. Но одновременно картинки становились заметно более тусклыми, хотя авторы такого эффекта не упоминают. Код они пообещали выложить, но пока его нет. Хотелось бы посмотреть на реализацию авторов.

Guiding a Diffusion Model by Swapping Its Tokens

Получают плохое предсказание с помощью перестановки самых непохожих токенов в отдельных блоках модели. Авторы предлагают два варианта: перемешивать сами токены или их каналы. Первый не дал заметного прироста, а с увеличением скейла качество генераций ухудшалось. Перемешивание каналов оказалось ещё нестабильнее, и даже при небольшом скейле изображения разваливались.

Во всех этих методах критичным оказывается выбор способа построения ухудшенного предсказания. Само по себе более сильное искажение не делает guidance эффективнее: если оно слишком сильно меняет структуру предсказания или вносит ошибки не в тех местах, где ошибается основная модель, качество генерации быстро падает.

Разбор подготовил ❣ Лавр Плисковский
CV Time


Foveated Diffusion: Efficient Spatially Adaptive Image and Video Generation

Разбираем статью, в которой попробовали использовать идею, отчасти навеянную анатомией человеческого глаза.

Наш глаз в отличие от камеры не воспринимает всю картинку в одинаково высоком разрешении. На сетчатке есть небольшой участок — фовеа, где клетки расположены с очень большой плотностью. Именно этой частью глаза мы различаем мелкие детали, а по краям информация гораздо менее подробная. В голове всё это собирается в полноценное изображение.

Плюс такого устройства в том, что мы можем обращать внимание на супермелкие детали и при этом иметь широкий угол обзора. То есть одновременно обрабатывать сигнал в высоком и низком разрешении и не тратить ресурсы на обработку всего мира в супервысоком разрешении.

В технике эта идея уже применяется в foveated-рендеринге. Например, в VR область, куда смотрит пользователь, рисуют в более высоком разрешении, а остальную — в более низком.

Авторы переносят эту идею на генерацию. Они позиционируют свою работу как способ дешёвого ускорения генеративной модели (для картинок в 1,5–2 раза, для видео — в 3,5, потому что пространственно-временное внимание дороже) без особых потерь качества.

Метод рассчитан на сценарии, где известно, куда смотрит пользователь: айтрекинг в VR, стриминговая генерация, симуляторы. Маска приходит извне, а не выводится из картинки.

При генерации, кроме промта, есть condition — foveation mask, который говорит, где нужно нарисовать в высоком разрешении. Модель генерирует сигнал в двух разрешениях: кусочек в high res и остальную часть в low res.

Получается полноценный латент, который переорганизуется на грид. High-res-кусочек декодируется отдельно, а вся остальная картинка собирается на грид более низкого разрешения и тоже декодируется. После этого две компоненты просто складываются с весами маски и получается комбинированное изображение. Декодер берут готовый, он ничего не знает об этих манипуляциях, поэтому на границе могут появляться артефакты. Авторы выносят цветовые артефакты на границе в ограничения и предлагают переделать VAE под декодирование смешанного разрешения.

Нетривиальный кусочек работы посвящён кодированию позиций токенов с учётом информации, что где-то у нас высокое разрешение, а где-то низкое. Мы привыкли, что сигнал — это равномерная решётка, но позиционные эмбеддинги позволяют ставить внутрь позиции не только равномерных, но и нужных нам узлов. В high-res-части позиции кодируются как обычно, а в low-res-кусочках делаются пропуски. В итоге информация о том, как конкретный токен соотносится с картинкой, сводится к позиционному кодированию.

Просто запустить предобученную модель на такой неоднородной сетке не выходит, так как масштабы и структура в двух зонах расходятся, объекты дублируются. Поэтому авторы дообучают модель через LoRA на мишени, консистентной по построению: картинку и её уменьшенную копию кодируют VAE независимо, а потом сливают токены по маске, так обе части заведомо описывают один и тот же контент.

Большую часть экспериментов делают со случайными масками: так модель учится работать с произвольной маской при генерации (замеры производят на фиксированной центральной). Но если для обучения брать маски из модели, которая оценивает, куда посмотрит человек, выходит неожиданный эффект: модель начинает сама размещать значимые объекты внутри фовеа. Фактически бесплатный грубый контроль композиции, в том числе многообъектный, если маска состоит из нескольких несвязных кусков.

В результатах авторы показывают, что просадки по качеству особо нет, а выигрыш по скорости есть. Дальше уже интересно, можно ли сделать так, чтобы модель сама без подсказок по мере генерации понимала, где ей нужно больше токенов, а где меньше. На первых шагах диффузии мы ничего не знаем о картинке, но потом постепенно появляется какая-то грубая компоновка: становится понятно, что здесь будет трава, здесь небо, здесь какой-то объект. По нему уже видно, где нужны детали, а где можно сэкономить.

Разбор подготовил ❣ Кирилл Струминский
CV Time


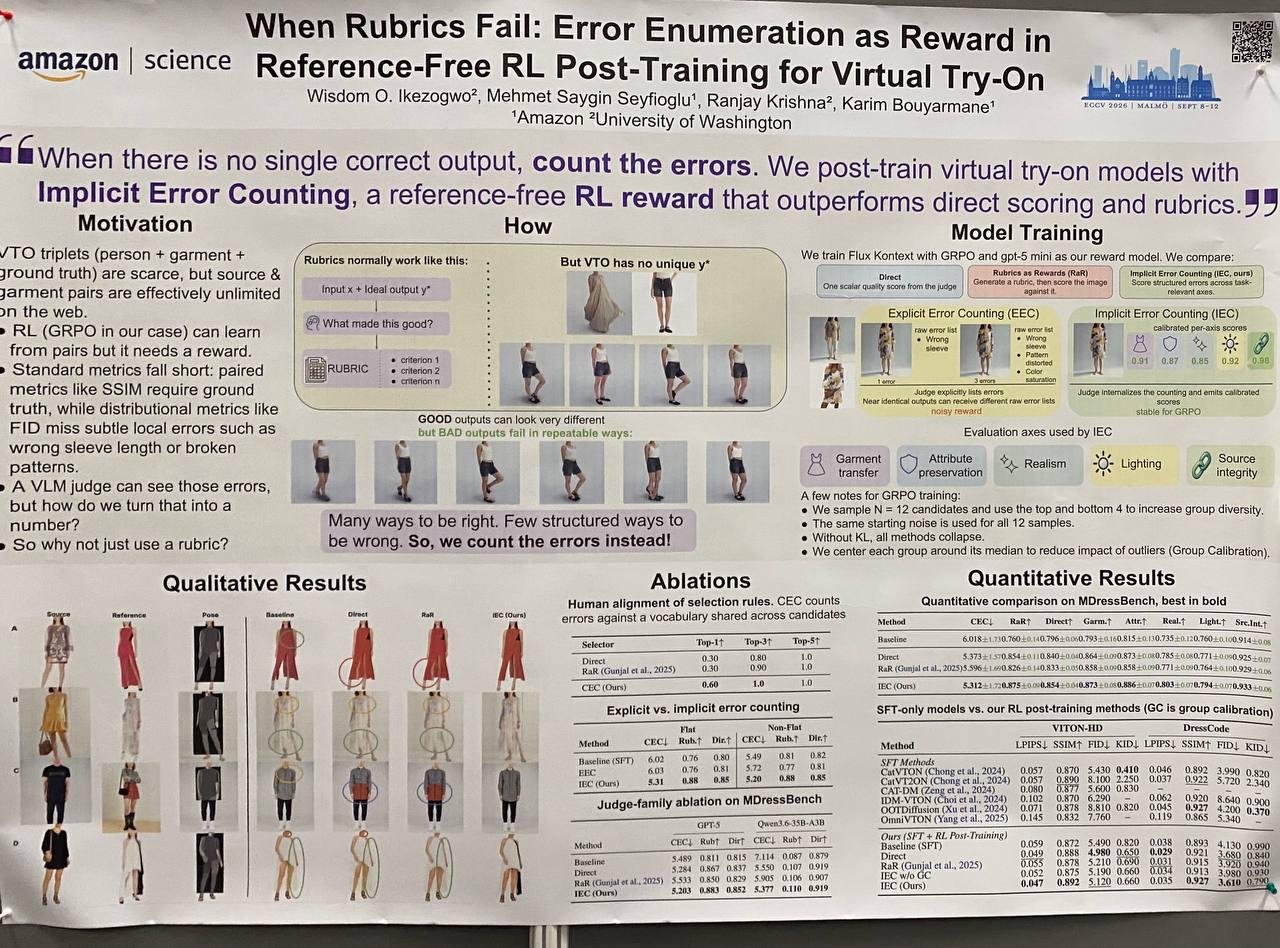
When Rubrics Fail: Error Enumeration as Reward in Reference-Free RL Post-Training for Virtual Try-On

Разбираем статью, в которой исследователи из Amazon, University of Washington и Allen Institute for AI предложили ещё один способ строить награду для задач без единственного правильного ответа.

Обычно рубричная награда работает так: для конкретного запроса генерируется набор критериев хорошего результата, каждому назначается вес, а итоговая оценка зависит от выполненных пунктов. Такой подход позволяет адаптировать оценивание под задачу и обычно информативнее единого скора качества.

Проблема возникает в открытых генеративных задачах. Хороших ответов может быть много, и в них не обязательно присутствуют одинаковые признаки. Поэтому критерии, построенные по одному эталону, могут штрафовать другие корректные варианты.

Авторы предлагают перевернуть оценивание: описывать не идеальный ответ, а универсальный для задачи набор критических ошибок. В качестве примера такой задачи авторы берут виртуальную примерку одежды, где типичные ошибки — это неправильный перенос одежды, искажение цвета и текстуры, артефакты, некорректное освещение или изменение исходного человека.

Модель-судья проверяет результат по каждой категории и возвращает оценки от 0 до 1: чем больше и серьёзнее ошибки, тем ниже оценка. Метод называется Implicit Error Counting. Полный список дефектов не используется напрямую, поскольку его явная генерация оказалась слишком нестабильной.

Итоговая награда считается как среднее оценок по категориям, затем калибруется относительно других генераций для того же входа и используется для обучения с GRPO. (Понятно, что с тем, как именно агрегировать скоры в единый сигнал, можно экспериментировать).

На MDressBench метод превзошёл прямую и рубричную оценку по всем восьми метрикам. На VITON-HD и DressCode он оказался не хуже или даже лучше шести базовых методов по 6 из 8 метрик. Предложенная авторами метрика также совпадала с человеческим выбором в 60% случаев против 30% у прямого и рубричного оценивания.

Основная идея: если множество хороших ответов описать трудно, но множество типичных ошибок ограничено, награду можно строить через отсутствие этих ошибок.

#YaECCV2026

Разбор подготовила ❣ Ангелина Гнедина

CV Time


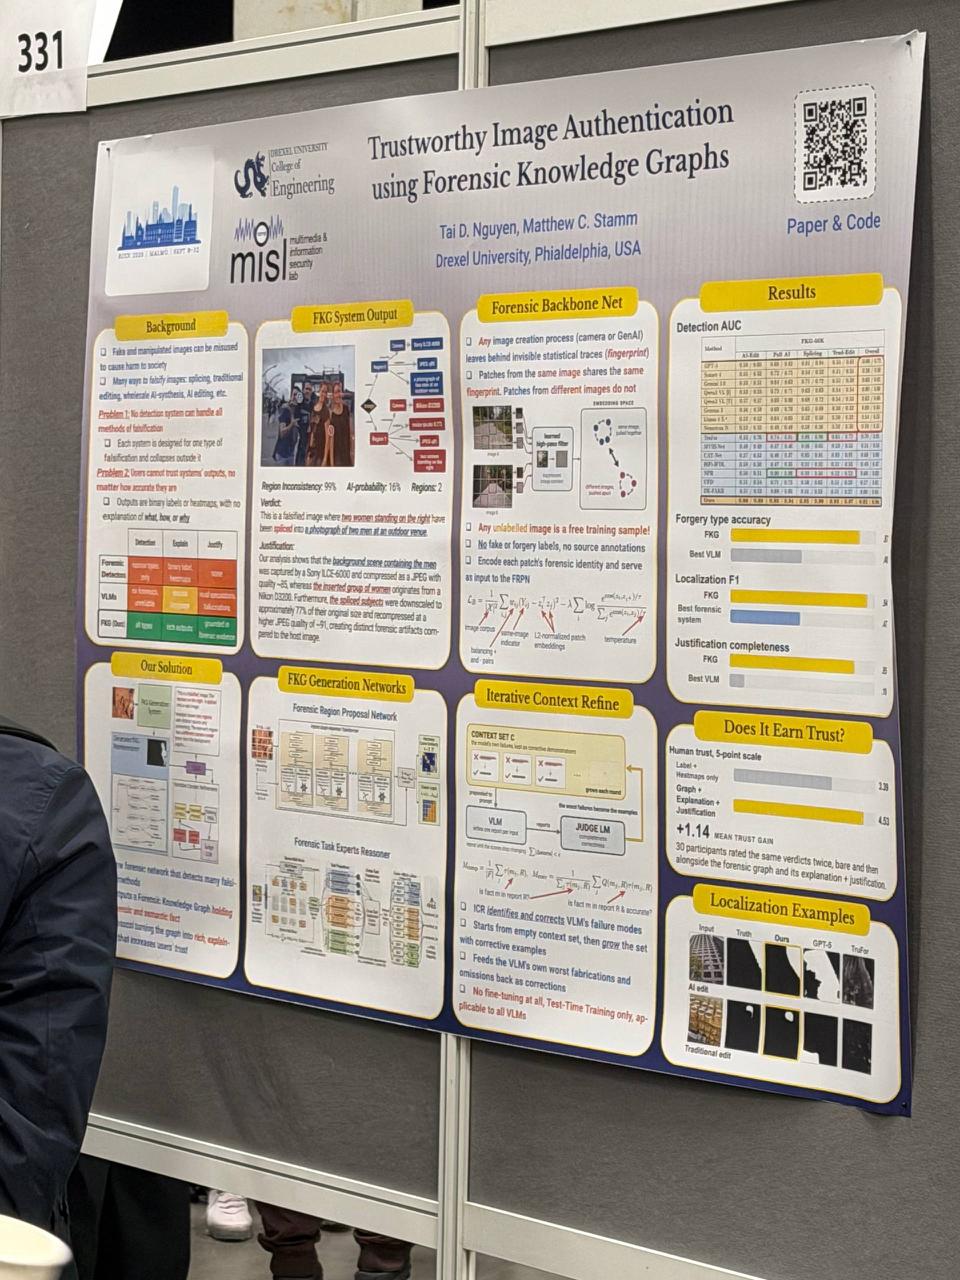
Trustworthy Image Authentication using Forensic Knowledge Graphs

На ECCV 2026 прослеживались два основных направления по детекции AIGI (AI-generated images):

• обобщающие подходы, которые пытаются строить решения независимо от конкретных генераторов, чтобы не переучиваться под новые;
• объясняемые подходы на базе VLM, где модель отвечает, почему изображение поддельное.

Разбираемая статья интересна тем, что фокусируется сразу на обоих эти обоих направлениях.

Авторы обучают self-supervised-эмбеддер на неразмеченных фотографиях. Получают fingerprint изображения, который отражает не семантику или содержание, а низкоуровневые особенности, связанные с тем, как изображение было сформировано. Для этого эмбеддинги патчей одной фотографии сближают, а разных фотографий — отдаляют.

Дальше картинка режется на патчи, для каждого считается такой отпечаток, и патчи с похожими отпечатками склеиваются в области.

Потом эмбеддинги патчей области усредняются, и отдельные модели-эксперты (MLP) предсказывают источник (камера или генератор), постобработку и сжатие (JPEG-параметры), а трансформер-ризонер сверху увязывает эти предсказания между собой.

Всё собирается в граф: изображение → области → источник, постобработка, сжатие.

В самом конце подключается VLM, которая переводит граф в текстовое описание с проверкой, что каждое утверждение опирается на факты из графа.

Такой подход позволяет единой системой находить и обосновывать разные манипуляции: сплайсинг (вставка одного изображения в другое), классическую локальную обработку (блюр), локальное AI-редактирование и полностью сгенерированные изображения. Например, разные источники у областей выдают сплайсинг, смесь камерных и синтетических отпечатков — AI-редактирование, а отсутствие камерных отпечатков вовсе — полную генерацию.

#YaECCV2026

Разбор подготовил ❣ Евгений Кузнецов

CV Time


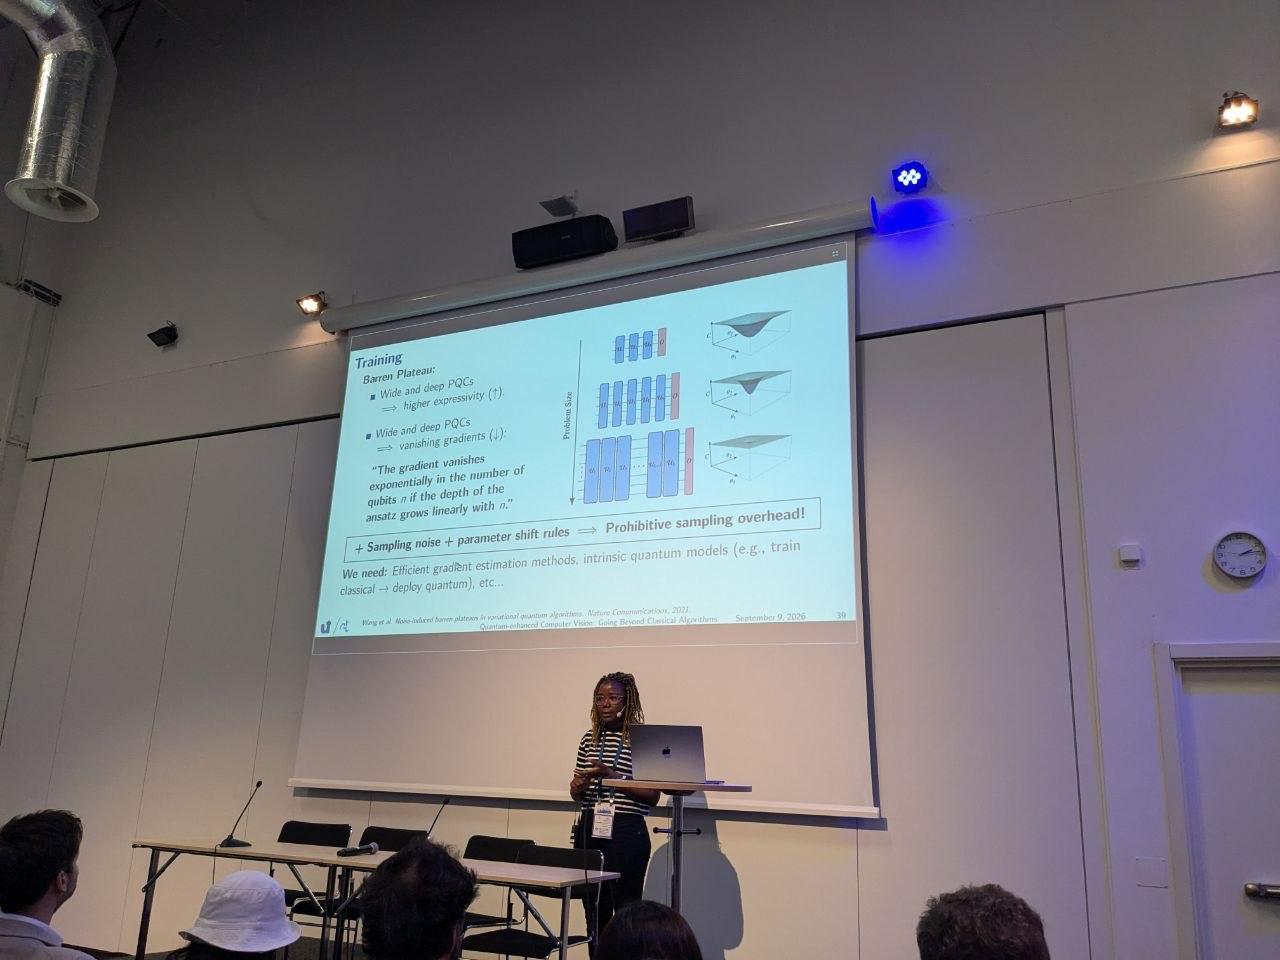
Мы всё ещё на ECCV: репортаж с воркшопа о квантовых вычислениях в компьютерном зрении

Наш коллега Александр Шишеня посетил воркшоп 3rd Workshop on Quantum Computer Vision and Machine Learning (QCVML) и рассказал, что там было интересного.

Начали с хорошего введения в квантовые вычисления от исследователя в Университете Зигена Natacha Kuete Meli. Впоследствии удалось пообщаться с ней лично, и она подтвердила описанные здесь выводы.

Вкратце идея в том, чтобы создать квантовую систему, состояние которой — решение целевой задачи. Сама система описывается уравнением Шредингера, соответственно и круг решаемых задач ограничен теми, которые вписываются в эту модель.

А вписывается в неё, например, дискретная (бинарная) квадратичная оптимизация или задача о назначениях — о ней в основном и рассказывали.

Всё это относится к адиабатическим квантовым вычислениям. В качестве ячеек памяти у нас кубиты (например, спин иона). Они вообще находятся в суперпозиции состояний, но при замере схлопываются в 0 или 1 — отсюда и бинарная оптимизация. К компьютерному зрению такой подход напрямую отношения не имеет.

Но есть ещё gate quantum computing. Здесь состояние кубита описывается амплитудами вероятности, что потенциально позволяет кодировать гораздо больше информации и решать в том числе задачи компьютерного зрения. Правда, чтобы получить информацию о состоянии, квантовую схему приходится запускать и измерять много раз: чем больше, тем точнее оценка. Пока практического применения в CV у этого подхода нет, но Natacha уверена, что в будущем квантовые вычисления найдут там своё место.

Затем выступали ребята из eleQtron — они выпускают квантовый компьютер на


Больше CV на ECCV!

Наши инженеры поделились ещё двумя интересными работами на тему компьютерного зрения. В первой стремятся сделать рассуждения мультимодальных моделей надёжнее, во второй — работают над улучшением распознавания незнакомых данных.

SophiaVL-R1: Reinforcing MLLMs Reasoning with Thinking Reward

Статья была представлена на ICLR 2026. При обучении reasoning-моделей награда обычно зависит только от финального ответа. Но верный ответ ещё не гарантирует правильное рассуждение, ведь модель может прийти к нему случайно, через логические ошибки или противоречивую цепочку. Outcome reward этого не замечает.

Авторы добавляют Thinking Reward Model, которая оценивает рассуждение целиком: его логичность, корректность, согласованность и отсутствие лишних повторений.

Итоговая награда в Trust-GRPO:

Reward = Outcome reward + Trust × Base weight × Time decay × Thinking reward

Где:

• Outcome reward — правильность финального ответа;
• Thinking reward — качество рассуждения;
• Base weight — заданный вес thinking reward;
• Trust — динамическая оценка доверия к Thinking Reward Model.

Для каждого вопроса генерируют группу ответов и сравнивают средний thinking reward правильных и неправильных решений.

Если правильные решения оценены выше, Trust = 1. Если judge в среднем ставит неправильным решениям более высокие оценки, Trust экспоненциально уменьшается пропорционально разнице между этими средними. Так ненадёжный сигнал слабее влияет на обучение.

Time decay постепенно снижает вес thinking reward. Сначала он помогает модели сформировать хорошие стратегии рассуждения, а позднее обучение сильнее опирается на более надёжный и формально проверяемый outcome reward.

Balanced Hyperbolic Embeddings Are Natural Out-of-Distribution Detectors

Авторы этой статьи ставят задачу определить, какие изображения — Out-of-Distribution (OOD).

Проблема следующая. Если классификатору показать «белку», которой в обучении не было, он может уверенно предсказать «кошку», потому что не понимает, что такое «объект OOD».

В работе предлагают устроить пространство признаков так, чтобы сама геометрия помогала модели понять, насколько объект ей знаком. Для этого используют гиперболическое пространство признаков.

Конкретнее: возьмем WordNet или VerbNet, который построит иерархию классов из обучающего датасета (граф). Шаг 1: берём полученный граф и учим эмбеддинги каждого класса в гиперболическом пространство так, чтобы расстояния в нём соответствовали расстояниям в графе.
Шаг 2: берём датасет картинок и сближаем в гиперболическом пространстве эмбеддинги картинки и соответствующего класса.

В результате эмбмеддинги OOD-картинок оказываются ближе к «центру» гиперболического пространства (к корневому классу, а-ля world), а эмбеддинги обычных картинок — ближе к краям, то есть к эмбеддингам соответствующих классов.

#YaECCV2026

Интересное увидели ❣ Ангелина Гнедина и Полина Комиссарова

CV Time


Интересные доклады с ECCV 2026

С 8 сентября в шведском Мальмё проходит ECCV — Европейская конференция по компьютерному зрению. Ведущий разработчик подгруппы Agentic Vision и VLM Reasoning в Яндексе Александр Шишеня рассказал о нескольких докладах, которые удалось посетить. Слово Александру.

Enterprise Agents: Capable or Compromised?

Вначале спикер прорекламировал BrowserGym, среду для web-агентов, а также WebArena-Pro — усложнённую версию WebArena с более трудными и multi-app-задачами.

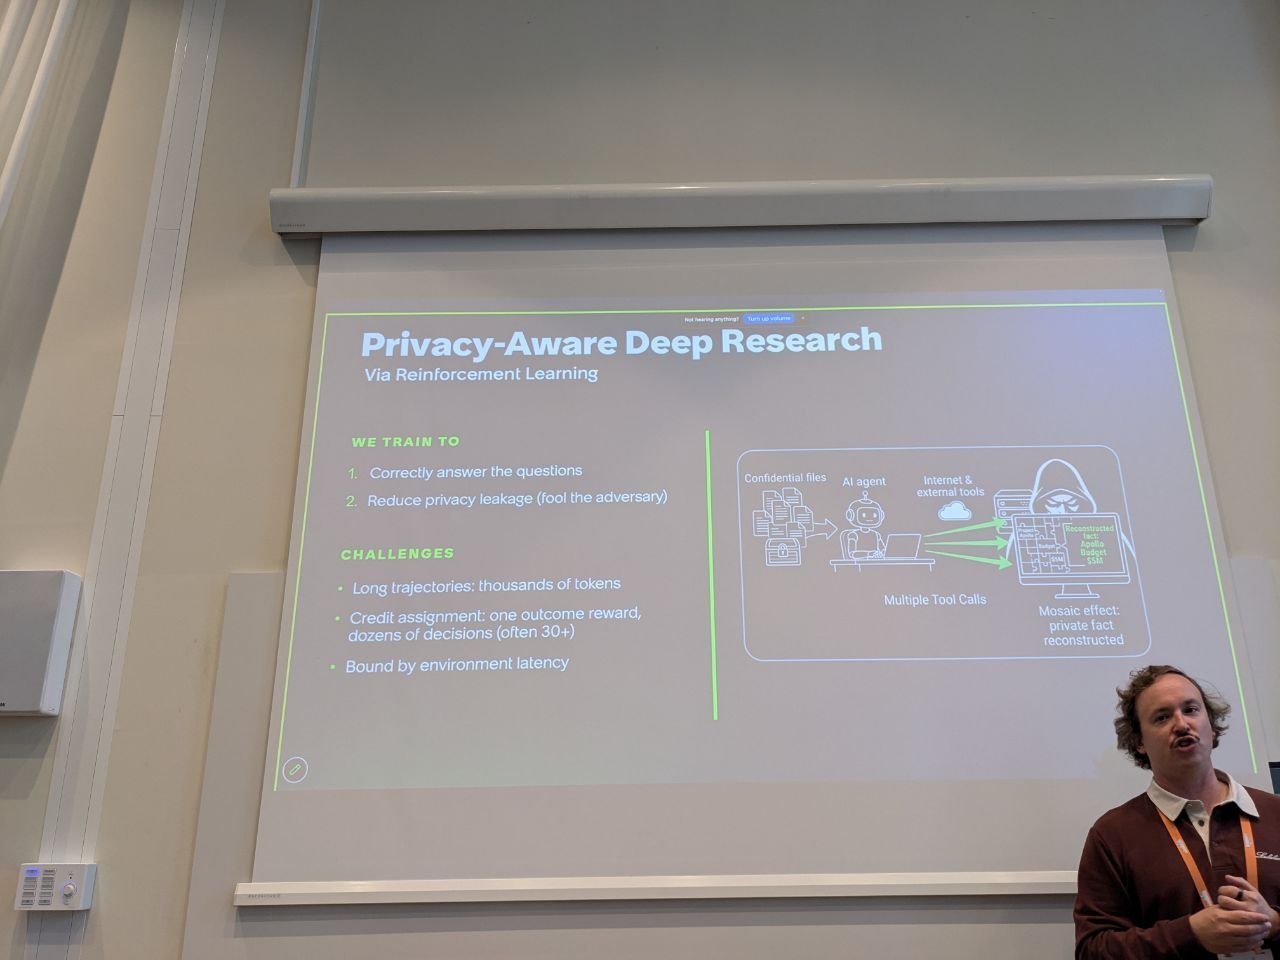
Сам доклад состоял из двух частей. Первая озаглавлена Privacy-Aware Deep Research. Если агент работает с чувствительными данными, часто по всей совокупности тул-коллов можно восстановить приватную информацию, даже если в каждом отдельном тул-колле информация была обфусцирована. Авторы предлагают стратегию борьбы с этим поведением, добавляя на стадии RLVR специальный реворд. Подход действительно работает, утечки во многом устраняются, а качество на целевых задачах растёт. При этом бэйзлайновый подход — добавление промпта — тоже решает задачу приватности, но роняет качество.

Вторая часть — Malice in Agentland. В обучающие данные можно подложить небольшое количество вредоносных данных. Благодаря этому обученная модель будет способна на вредоносное поведение, которое вызывается специальной заранее определённой комбинацией токенов. Например, модель может начать слать на заранее заданный сервер файлы с локального компьютера. Авторы показали, что достаточно всего 1% таких данных в обучающем датасете, чтобы вредоносное поведение триггерилось с вероятностью 99%.

Утверждается, что такие вредоносные семплы достаточно трудно задетектить в датасете, к тому же обучение на таком наборе поднимает целевое качество. По тому же принципу может быть заражена среда, где собираются данные.
При этом в маленькие модели сложнее заложить такое вредоносное поведение.

Learning When to Search, What to Search and What to Trust: Reinforcement Learning for Multimodal Reasoning Agents

Ключевые идеи такие. Модель сама по себе не имеет представления, что она знает хорошо, а что не знает. Чтобы выяснить, на каких семплах вызывать тулы, а на каких не обязательно — нужно прогонать модель с тул-коллами и без. Если на семпле просадка качества при вызове без тул-колла — required_tool=True и затем штрафуем, если на RLVR модель вызывает тул на таких семплах. Далее давайте генерировать сразу несколько различных тул-коллов, которые стремятся решить одну задачу, чтобы генерировать несколько кандидатов. Потом ответы этих тул-коллов фильтруем отдельной моделью на полезность и таким образом пруним траектории. Также предлагают модификацию GRPO — Dr. GRPO (done right).

Manipulation in GUI Agents

В этой работе делают VLA для computer_use. При этом движение мышки генерируют как криволинейную траекторию с помощью flow matching отдельной лёгкой головой по эмбеддингам из VLA. В перерыве удалось пообщаться с автором, поспорили, вместе подумали над идеями.


#YaECCV2026

CV Time


Representation Alignment for Just Image Transformers is not Easier than You Think

REPA хорошо зарекомендовала себя для латентных диффузионных моделей. Берутся промежуточные фичи генеративной модели и обучаются быть похожими на фичи предобученного энкодера вроде DINO. Кажется логичным просто перенести тот же подход на pixel-space-модели. Но с JiT это привычного буста не даёт, а при долгом обучении может сделать даже хуже.

Авторы статьи PixelREPA, которую мы разбираем сегодня, связывают проблему с несовпадением пространств представлений.

DINO становится bottleneck`ом, его фичи сжимают информацию об изображении и отбрасывают часть мелких и высокочастотных деталей. В латентном пространстве тоже уже произошло информационное сжатие, поэтому алайнмент между DINO и латентными диффузионными моделями имеет смысл. А JiT работает напрямую с пикселями и может сохранять гораздо более детальную информацию.

Когда высокоразмерные фичи JiT напрямую выравнивают с более компактными DINO-фичами, происходит representation collapse, то есть разные с точки зрения JiT изображения становятся неразличимыми после алайнмента. Особенно хорошо это видно на парах изображений, которые DINO считает очень похожими. Там REPA сильнее всего ухудшает результат. И чем размерность pixel space выше, тем заметнее проблема.

Как чинят?

Авторы предложили не матчить JiT и DINO напрямую, а сначала научиться выжимать из «богатых» JiT-фичей более компактное представление.

Для этого:

🔴заменяют простой MLP-проектор на два JiT-блока с аттеншном;

🔴маскируют часть токенов перед алайнментом, заставляя проектор выделять основную информацию из неполного представления.

Именно маскирование оказывается важной частью фикса. JiT с обычной REPA работает хуже исходной модели. Если заменить простой проектор между фичами JiT и DINO на более мощный, результат станет получше, но он всё ещё не будет дотягивать до исходного JiT. И только когда к новому проектору добавляют маскирование части токенов, удаётся превзойти базовую модель.

Интереснее всего в работе не конкретный рецепт, а вывод: эффективность representation alignment`а зависит от пространства, в котором живёт генеративная модель.

Отсюда возникает гипотеза о том, что, возможно, обычную REPA в pixel space стоит не только модифицировать, но и просто вовремя выключать. В начале она помогает сформировать семантику, а позже начинает мешать модели учить более fine-grained-признаки. И это подтверждается нашими внутренними экспериментами.

Разбор подготовил ❣ Никита Стародубцев
CV Time


PixelDiT: Pixel Diffusion Transformers for Image Generation

Сегодня разбираем статью, в которой предложили ещё один способ заставить диффузионный трансформер работать напрямую с пикселями. Самое интересное в работе — описанная авторами архитектура.

Главное нововведение подхода в том, что модель обрабатывает изображение на двух уровнях: отдельно семантику, отдельно пиксельные детали.

Сначала картинку бьют на крупные патчи 16х16 и прогоняют через обычные DiT-блоки. На выходе получаются семантические токены, которые компактно передают глобальное содержание картинки.

После этого модель снова берёт исходное изображение, но уже с размером патча 1х1. Каждый пиксель становится отдельным токеном с эмбеддингом маленькой размерности. Семантические токены из первой части используют для обусловливания pixel-блоков через pixel-wise AdaLN. То есть первая часть модели отвечает за семантику изображения, а вторая восстанавливает его буквально по отдельным пикселям.

Но селф-аттеншн по всем пикселям стоил бы безумно дорого. Поэтому перед аттеншном PixelDiT временно группирует соседние пиксельные токены: длина последовательности уменьшается, размерность представления растет, аттеншн считается уже в сжатом пространстве, а затем токены разворачиваются обратно. Авторы делают акцент на том, что это именно оптимизация вычислений, при этом fine-grained-информация продолжает идти через pixel-level-представление. Без такого сжатия модель просто упирается в OOM.

В методе JiT для перевода эмбеддингов обратно в изображение используется один линейный слой. Если выход высокоразмерный (пересказываем шум или velocity), то такое работать не будет. Именно поэтому в JiT модель предсказывает чистое изображение (чистый патч) — чистое изображение лежит в низкоразмерном пространстве. В это же время PixelDiT каждый пиксель обрабатывает отдельно, поэтому модель предсказывает высокоразмерную velocity.

И ещё прикольно выглядит использование AdaLN. Здесь conditioning — не один глобально спуленный вектор. Семантические представления используют, чтобы отдельно обогащать информацией pixel-level-представления. По аблейшену, pixel-wise AdaLN делает хороший вклад в результат.

Разбор подготовил ❣ Илья Дробышевский
CV Time


Sparse Forcing: Native Trainable Sparse Attention for Real-time Autoregressive Diffusion Video Generation 

Сегодня разбираем работу, в которой предложили sparse attention для авторегрессионной генерации видео.

В целом идея sparse attention в видео не новая. В предыдущих работах, таких как  Sparse VideoGen и Sparse VideoGen2, разреженный паттерн задавали заранее или подбирали динамически, но в основном уже на инференсе. Из-за этого возникал мисматч — обучалась модель с обычным аттеншном, а при генерации получала другую схему доступа к контексту.

В Sparse Forcing предлагается end-to-end-подход, в котором sparse attention становится частью обучения. Кроме того, генерация видео происходит именно авторегрессионно, а не bidirectional, как было в прошлых статьях.

Подход опирается на наблюдение о том, что аттеншн в видео обычно собирается в блоки, и модель смотрит не на всю историю равномерно, а на несколько участков прошлого контекста и окно вокруг текущей позиции.

Тензор видеолатентов разбивают на небольшие пространственно-временные блоки. Дальше для каждого query-блока динамически выбирают фиксированное число блоков, на которые ему полезнее всего смотреть.

Память при этом делится на две части:

🔴persistent memory хранит не всю историю, а ограниченный набор блоков (sink-блоки + динамически отобранное подмножество, Top-C), доступна всем query и аттендится каждым из них. Именно за счёт того, что история не хранится целиком, достигается снижение пикового KV-кэша;

🔴local memory работает как sliding window и может отличаться для разных query.

Чтобы не считать полный аттеншн только ради выбора нужных блоков, каждый блок сначала сжимают в один вектор простым усреднением его токенов. По этим представлениям считают грубый attention score. Его используют двумя способами:

1) внутри локального окна для каждого query-блока выбирают top-k релевантных блоков и точный аттеншн считают только по ним;

2) агрегированный score по истории решает, какие блоки удержать в persistent memory (Top-C) при вытеснении из локального окна. При этом сами persistent-блоки не фильтруются через top-k — их плотно аттендят все query.

То есть сначала делают дешёвый поблочный скоринг, а потом считают точный аттеншн по выбранному подмножеству. Сам sparse-паттерн меняется динамически и отдельно для каждого query, но число выбранных блоков остаётся фиксированным. Похоже sparse attention устроен в DeepSeek, где тоже есть отдельный скоринг на более компактных представлениях, который определяет, к каким блокам обращаться.

Для такого подхода нужны специальные кернелы. Авторы заявляют ускорение относительно FlashAttention-2 и показывают, что оно зависит от размера локального окна и отношения выбранных блоков к общему контексту, доли persistent-памяти (N_P/N_L) и длины блока. Динамический отбор блоков должен быть особенно полезен для длинной авторегрессионной генерации, где история и KV-кэш постоянно растут.

Но здесь возникает главный вопрос к работе. Кернелы не опубликованы, кода на момент написания поста тоже нет. В экспериментах sparse attention сравнивают в основном с FlashAttention-2, хотя всё запускали на H100 и могли бы проверить FlashAttention-3. Поэтому оценить реальный спидап сложно.

С видеомоделями ситуация похожая. Авторы сравниваются с CausVid, Self Forcing, SkyReels-V2 и MAGI-1 и говорят о сниженной  задержке и меньшем количестве артефактов. Но самых близких sparse-бейзлайнов в сравнении нет — от них авторы открещиваются говоря, что паттерн одновременно обучаемый, динамический и авторегрессионный.

В итоге модель сама учится работать с ограниченным набором блоков, поэтому качество должно проседать меньше. Динамический выбор контекста тоже кажется полезнее фиксированной маски.

Но насколько большой практический выигрыш даёт именно этот метод, по приведённым экспериментам понять трудно — из-за слабых бейзлайнов и отсутствия кода.

Разбор подготовил ❣ Федор Великонивцев
CV Time


DiffusionNFT: Online Diffusion Reinforcement with Forward Process [2/2]

Завершаем разбор статьи об RL для диффузионок от NVIDIA. В первой части рассказали, что предложили авторы. Переходим к самому интересному — результатам.

Что крутого в решении:

🔴Независимость от солвера — тренировка полностью отделена от семплирования: можно использовать любой black-box-солвер, не нужно хранить траектории.
🔴Неявное «впекание» CFG — направление ∆ (по сути CFG-подобный гайденс) встраивается прямо в модель через репараметризацию, без отдельной гайденс-модели и guided-семплирования.
🔴Likelihood-free — метод не использует приближение правдоподобия (в отличие от DPO-style-методов с ELBO и неравенством Йенсена, или дискретизации обратного процесса), а значит не вносит систематическое смещение в оценку.

Если упростить до алгоритма обучения:

1) Семплируем роллауты без CFG — прогоняем текущую v_old по промптам, группами (group rollouts, как в GRPO).

2) Для каждого члена группы считаем reward и нормализуем его внутри группы — получаем аналог advantage.

3) Из набранных групп формируется пул данных, по которому оптимизируется введённый выше objective мини-батчами — обновляется только v_θ.

4) После прохода по всему набору групп делается EMA-like апдейт v_old ← v_θ .

Отдельно замечу: в самой статье об этом ни слова, но в опубликованном коде NFT дополнительно используется KL-регуляризация к исходной модели — то есть на практике это не просто голый flow matching objective на implicit positive/negative policy, а ещё с якорем на исходные веса.


На SD3.5-Medium предложенный метод сходится заметно быстрее, чем Flow-GRPO — в head-to-head-сравнениях авторы заявляют до 25× по эффективности. Например, на GenEval DiffusionNFT доходит с 0,24 до 0,98 всего за 1 тысячу шагов, тогда как Flow-GRPO выходит лишь на 0,95 за 5k+ шагов и дополнительно требует CFG на инференсе. При этом сама тренировка у DiffusionNFT полностью CFG-free, а значит легче: не нужно гонять условную и безусловную ветку, не нужно хранить полные траектории семплирования.

Подводя итог, метод действительно впечатляет. Относительно Flow-GRPO он буквально не имеет недостатков, при этом помимо RL мы попутно получаем и «впекание» гайденса, а значит, на последующей стадии общей дистилляции на одну головную боль становится меньше.

Кажется, что в будущем такой подход к RL диффузионных моделей может стать новой общепринятой практикой. Уже сейчас ссылки на DiffusionNFT можно найти в MeanFlow NFT от Tencent, где NFT успешно распространяют на MeanFlow-формулировку, а также в Mage-Flow — новой диффузионной генеративке Microsoft, где метод применили на стадии пост-трейнинга вместо GRPO.

Разбор подготовил ❣ Валерий Старцев
CV Time


DiffusionNFT: Online Diffusion Reinforcement with Forward Process [1/2]

Сегодня разберём свежую статью из мира RL для диффузионок — Diffusion NFT от NVIDIA, представленную на ICLR 2026.

В сообществе доминируют два подхода к RL-дообучению диффузионных моделей: офлайн-обучение на предпочтениях (DPO-style) и онлайн-GRPO — де-факто стандарт в text-to-image-моделях продакшен-уровня.

У обоих есть проблемы. У DPO — неустойчивый objective, офлайновость и необходимость собирать большие датасеты с человеческой разметкой. У GRPO — неудобность: нужно хранить траектории всех генераций в группе и жёстко привязываться к определённому виду семплера.

Авторы из NVIDIA предложили метод, который решает проблемы GRPO, при этом сходится быстрее и позволяет «вшить» CFG прямо в результирующую модель.

Идея — делать RL не на обратном процессе (как в GRPO), а на прямом. Так родился DiffusionNFT (Diffusion Negative-aware FineTuning). Вместо policy gradient метод напрямую оптимизирует форвард-процесс через flow matching objective. Смысл в том, чтобы задать контрастное «направление улучшения» между двумя неявными политиками, обученными на позитивных и негативных семплах (по реворду), и двигаться в сторону позитивной политики, не трогая сам процесс семплирования.

Плюсы такой формулировки:
🔴работает с любыми солверами, а не только с SDE первого порядка;
🔴не нужно хранить целые траектории семплирования — только чистые картинки;
🔴минимальные изменения в существующем коде обучения.

Технически это устроено так: есть претрейн policy π_old и датасет промптов. На каждой итерации семплим K картинок по промпту и оцениваем каждую скалярным reward r ∈ [0,1] — это «вероятность оптимальности» картинки. Каждая картинка с вероятностью r попадает в «позитивный» датасет D+, иначе — в «негативный» D−. При бесконечном числе семплов D+ соответствует implicit policy π+ (условная на успех), D− — implicit policy π− (условная на неуспех). Авторы показывают, что всегда верно π+ ≻ π_old ≻ π−.

Наивный вариант — Rejection FineTuning (RFT): тренировать модель только на D+. Работает, но не использует негативные данные, и чистое обучение на позитивах приводит к коллапсу.
Ключевая идея — ввести «направление улучшения» ∆ между π_old и целевой policy, по аналогии с гайденсом (как в CFG):

v* = v_old + (1/β)·∆
где, β — сила гайденса.

Теорема авторов показывает, что ∆ можно эквивалентно выразить через любую пару {v_old, v+, v−}:

∆ = (1−α)·(v_old − v−) = α·(v+ − v_old)

где α ∈ [0,1] — скаляр, зависящий от реворд-статистики. То есть направление к «хорошей» политике можно получить и через контраст с «плохой» политикой — они пропорциональны друг другу.

Главный трюк. Вместо обучения двух отдельных моделей v+_θ и v−_θ, авторы параметризуют их через одну и ту же сеть vθ:

v+_θ = (1−β)·v_old + β·vθ — implicit positive policy
v−_θ = (1+β)·v_old − β·vθ — implicit negative policy

И обучают на единый лосс:

L(θ) = E[ r·‖v+_θ(x_t,c,t) − v‖² + (1−r)·‖v−_θ(x_t,c,t) − v‖² ]

На позитивных семплах (вес r) модель обучается через ветку implicit positive policy; на негативных (вес 1−r) — через implicit negative policy, но обе ветки завязаны на одну и ту же сеть vθ. При достаточном количестве данных и капасити оптимум этого лосса даёт нужное направление улучшения:

vθ* = v_old + (2/β)·∆

По сути это обычный supervised диффузионный лосс с двумя ветками для позитивных и негативных примеров — но при этом даёт полноценный RL-эффект.

Во второй части разберём, почему это круто и какие результаты получились.

Разбор подготовил ❣ Валерий Старцев
CV Time


Курс по Visual GenAI от Yandex Research и ШАД

Авторы CV Time не только пишут обзоры статей о компьютерном зрении, но и создают обучающие курсы.

Сегодня делимся курсом ШАДа «Генеративные модели в компьютерном зрении», который ведёт Дмитрий Баранчук, руководитель группы GenAI в Yandex Research, вместе с праймовой командой исследователей в этой области.

Будет полезно тем, у кого есть базовые знания по генеративкам и желание разобраться глубже:

• в теории диффузионных моделей, эффективных методах их обучения и семплирования;
• в новых гибридных моделях на основе диффузии для генерации изображений, видео и 3D.

У курса есть открытый GitHub-репозиторий, где можно найти слайды, записи лекций и семинаров, а также домашние задания.

CV Time


Qwen-Image-Agent: Bridging the Context Gap in Real-World Image Generation

Сегодня разбираем статью о Qwen-Image-Agent — не столько техническую, сколько идеологическую. Авторы предлагают добавить перед генеративной моделью агентский пайплайн, который собирает недостающий контекст.

Главной проблемой называют Context Gap — разрыв между тем, что пользователь написал, и тем, что модели нужно для качественной генерации. Дело в том, что промпт юзера может быть неполным: не хватает деталей, референсов или контекста предыдущего диалога. Кроме того, он обычно не попадает в распределение, на котором училась модель.

Например, пользователь просит нарисовать скорборд финала NBA 2026 с логотипами команд и итоговым счётом. Но генеративная модель может не знать, кто играл, какой был счёт и как выглядят логотипы. Если отправить запрос напрямую, она, скорее всего, что-нибудь нагаллюцинирует.

Qwen-Image-Agent сначала определяет, какой информации не хватает, и формулирует вопросы. Затем они направляются в нужный механизм:

🔴Reasoning — логика, здравый смысл и визуальный ризонинг;
🔴Search — веб-поиск и поиск изображений;
🔴Memory — история диалога и прошлые генерации;
🔴Feedback — проверка результата через VLM-as-a-Judge.

Когда нужная информация собрана, система переписывает промпт через обычную репромптиловку, но с контекстом из внешних источников.

Дальше генерируется изображение, а VLM-as-a-Judge проверяет его по чек-листу. Если всё выполнено, картинка возвращается пользователю. Если нет, система смотрит оставшийся Context Gap, уточняет промпт и запускает новую итерацию.

В пайплайне задействованы две модели. Мультимодальная — отвечает за планирование, ризонинг, поиск и оценку результата, а генеративная — за синтез изображения.

Дополнительного обучения нет, вся система работает zero-shot на системных промптах. Именно в системном промпте задаются правила, когда использовать Reasoning, а когда Search.

Есть момент, что граница между Reasoning и Search довольно размыта. Общие и стабильные знания можно брать из весов модели, а точные, визуальные или динамические данные лучше искать. (Например, модель может примерно знать логотип команды, но для точного воспроизведения надёжнее найти референс.)

Отдельный уровень планирования нужен для multi-image- и multi-turn-генерации. Например, при создании презентации несколько слайдов должны сохранять единый стиль. В одном из примеров система сначала генерирует титульный слайд, а затем использует его как стилевой референс для остальных. При этом из памяти извлекается только релевантный контекст, иначе он быстро раздуется.

Важная часть статьи — Image Agent Bench, бенчмарк для end-to-end-оценки агентских систем генерации. Проверяет четыре способности: Planning, Reasoning, Search и Memory. Для каждого кейса есть свой чек-лист, всего в них около 1800 пунктов.

Для оценки используют Pass Rate, Checklist Accuracy и интегральный Image Agent Score. Срезы взвешиваются как 0,3 / 0,3 / 0,3 / 0,1 — памяти дают меньший вес, потому что она используется только в multi-turn-задачах.

В работе привели абляцию, по которой агентский пайплайн получает около 45 баллов против 17 у базовой Qwen-Image без агента. Замена как генеративной, так и ризонящей модели на более слабую результат снизила, но агентские версии всё равно остаются лучше прямой генерации.

Отключение Feedback Loop приводит к самому маленькому падению качества. Фидбек при этом очень дорогой, так как нужен дополнительный вызов VLM-джаджа, а при ошибке требуется повторная генерация. Возможно, планирование, поиск и ризонинг уже закрывают большую часть Context Gap, поэтому дополнительный выигрыш от фидбека невелик.

Можно сделать вывод, что авторы не предлагают принципиально новых компонентов, но зато удобно собирают поиск, ризонинг, память, репромптинг и оценку в единый фреймворк. Качество растёт, но вместе с ним растут вычисления, контекст и сложность пайплайна.

Разбор подготовил ❣ Василий Прядченко
CV Time

14 last posts shown.