


When Rubrics Fail: Error Enumeration as Reward in Reference-Free RL Post-Training for Virtual Try-On
Разбираем статью, в которой исследователи из Amazon, University of Washington и Allen Institute for AI предложили ещё один способ строить награду для задач без единственного правильного ответа.
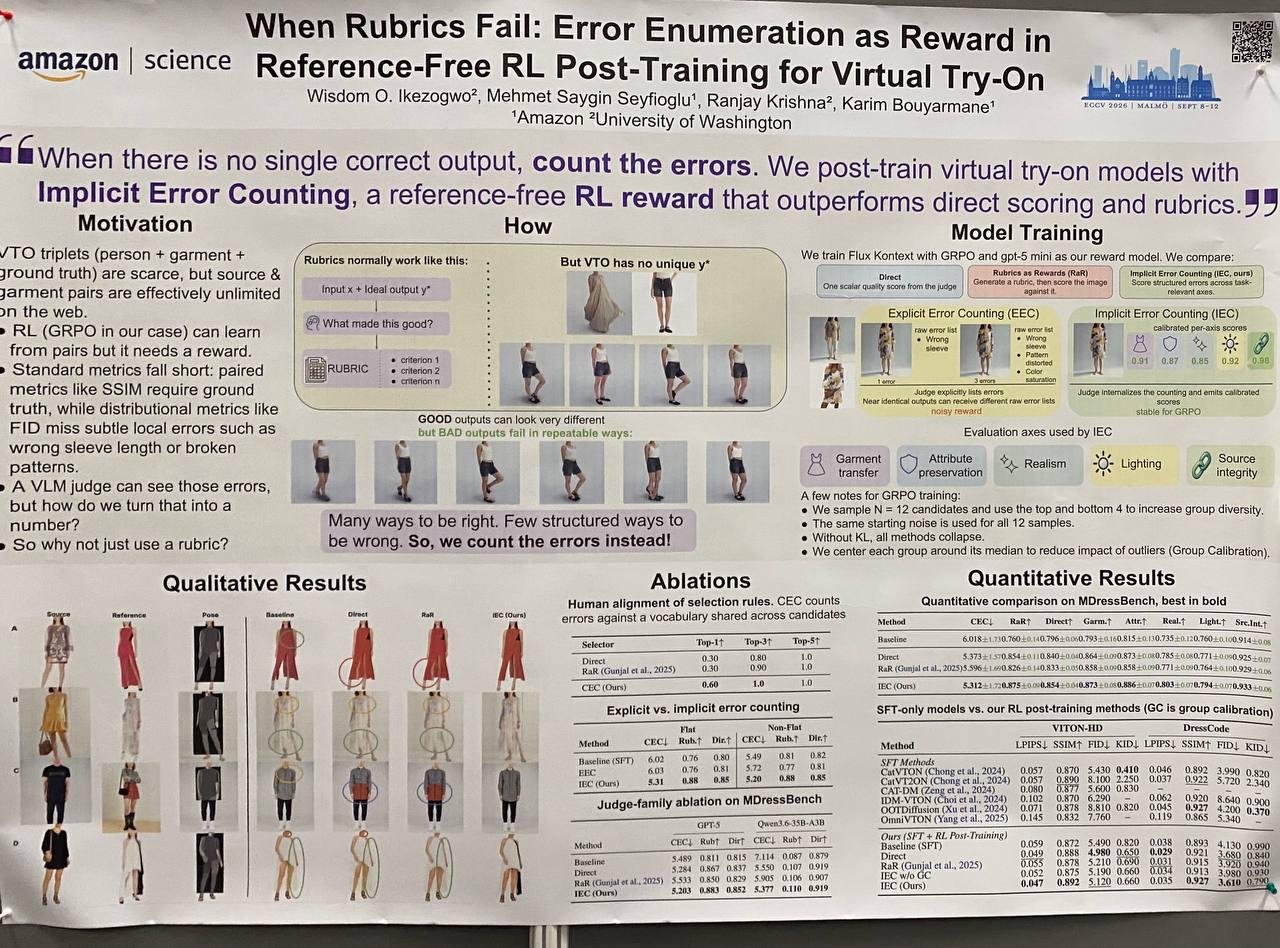
Обычно рубричная награда работает так: для конкретного запроса генерируется набор критериев хорошего результата, каждому назначается вес, а итоговая оценка зависит от выполненных пунктов. Такой подход позволяет адаптировать оценивание под задачу и обычно информативнее единого скора качества.
Проблема возникает в открытых генеративных задачах. Хороших ответов может быть много, и в них не обязательно присутствуют одинаковые признаки. Поэтому критерии, построенные по одному эталону, могут штрафовать другие корректные варианты.
Авторы предлагают перевернуть оценивание: описывать не идеальный ответ, а универсальный для задачи набор критических ошибок. В качестве примера такой задачи авторы берут виртуальную примерку одежды, где типичные ошибки — это неправильный перенос одежды, искажение цвета и текстуры, артефакты, некорректное освещение или изменение исходного человека.
Модель-судья проверяет результат по каждой категории и возвращает оценки от 0 до 1: чем больше и серьёзнее ошибки, тем ниже оценка. Метод называется Implicit Error Counting. Полный список дефектов не используется напрямую, поскольку его явная генерация оказалась слишком нестабильной.
Итоговая награда считается как среднее оценок по категориям, затем калибруется относительно других генераций для того же входа и используется для обучения с GRPO. (Понятно, что с тем, как именно агрегировать скоры в единый сигнал, можно экспериментировать).
На MDressBench метод превзошёл прямую и рубричную оценку по всем восьми метрикам. На VITON-HD и DressCode он оказался не хуже или даже лучше шести базовых методов по 6 из 8 метрик. Предложенная авторами метрика также совпадала с человеческим выбором в 60% случаев против 30% у прямого и рубричного оценивания.
Основная идея: если множество хороших ответов описать трудно, но множество типичных ошибок ограничено, награду можно строить через отсутствие этих ошибок.
#YaECCV2026
Разбор подготовила ❣ Ангелина Гнедина
CV Time