


Яндекс рассказал, как пробует пересобрать один из самых массовых видов ИИ
Подсказка: это не чат-бот.
У чат-ботов сотни миллионов пользователей, но их открывают, когда что-то нужно. А есть ИИ, с которым мы сталкиваемся каждый день и работу которого давно уже не замечаем, – это рекомендательные системы. Они решают, какой ролик всплывет в ленте следующим, какой трек заиграет в вашей колонке через минуту, какой товар магазин покажет вам первым.
Это очень сложные системы, от совершенства которых, не побоюсь этого слова, зависит качество нашей с вами жизни. Наверное, каждый сталкивался с ситуацией: лента продолжает советовать чайники через месяц после того, как вы чайник купили.
Сейчас большинство крупных рекомендательных систем устроено как конвейер, который инженеры годами собирали из десятков отдельных алгоритмов и подгоняли друг к другу вручную. Именно его Яндекс и попробовал разобрать.
Обычный конвейер чем-то похож на отбор на большой музыкальный конкурс. Сначала десятки отборщиков, отдельных алгоритмов, быстро прослушивают каталог из миллионов треков и приносят кандидатов, каждый со своим вкусом. Потом предварительное жюри, модель попроще, отсеивает лишнее. И только финалистов слушает главное жюри, которое и решает, что заиграет следующим.
Внимательно оценить каждый из миллионов треков для каждого слушателя за доли секунды не может ни одна модель, поэтому воронка и появилась. Платить за нее приходится двумя болезнями. Этапы учатся по отдельности и друг о друге не знают: отборщик может найти отличный трек, а предварительное жюри его срежет или отправит в конец списка. А еще жюри плохо читает сырую историю слушателя, и инженеры придумывают для него сотни подсказок-признаков вроде “сколько раз за неделю человек пропустил этот жанр”.
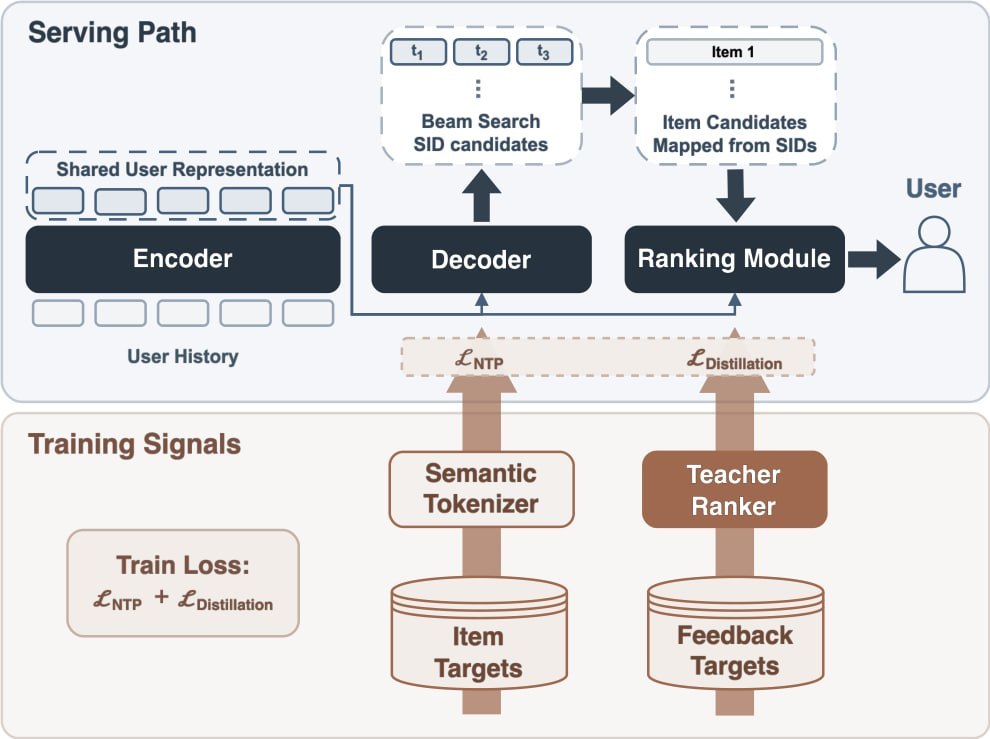
Яндекс решил вылечить обе болезни разом и заменить весь конвейер одной моделью. Ее назвали Sona и на неделю поставили вместо привычной системы у 15% слушателей в музыкальных рекомендациях. Слушать музыку стали на 6,3% больше.
Перебирать миллионы треков Sona и не пытается. Каждому треку заранее присваивают короткий адрес из нескольких частей, примерно как библиотечный шифр: зал, стеллаж, полка. Его строят по первым 90 секундам записи, описанию трека и тому, как его слушают люди, поэтому у похожих композиций начало адреса совпадает. Sona по истории слушателя “дописывает” такой адрес по частям, как языковая модель дописывает фразу, и с каждой частью круг подходящих треков сужается.
На одной полке может оказаться несколько треков, и порядок между ними выбирает второй модуль внутри той же модели. Оба модуля опираются на одно и то же прочтение истории слушателя и учатся вместе, поэтому находка одного не теряется у другого. Подсказки-признаки Sona не нужны: она читает сами прослушивания, пропуски и лайки. И постоянно доучивается: от лайка до версии модели, которая его учла, обычно проходит около 45 минут.
Тех самых лайков в эксперименте стало на 11,4% больше, а активных слушателей – на 4,5%. Прирост аудитории в 2,4 раза больше того, что в свое время дала Argus, прошлая сильная модель Яндекса. Оговорка важная: неделя и один сценарий, и сам Яндекс еще проверит, продержится ли эффект месяцами.
Над той же задачей бьются крупнейшие площадки мира. Китайская Kuaishou тоже собирает рекомендации генеративной моделью, но оставляет рядом отдельного оценщика, а ByteDance сводит этапы в одну модель и держится за признаки. Яндекс занимается рекомендациями больше десяти лет и в 2025 году открыл для исследователей Yambda, набор данных почти на 5 млрд взаимодействий. Теперь компания заявляет, что первой публично описала решение, которое заменяет весь конвейер, обходится без ручных признаков и проверено на живых слушателях.
Дальше подход, скорее всего, проверят в других музыкальных сценариях и в Яндекс Рекламе. Если он приживется, вы этого, возможно, даже не заметите – просто чаще будете ставить лайки.
👉 Подробности на Хабре