сбежавшая нейросеть


Гео и язык канала: Россия, Русский
Категория: Технологии


Авторский канал про искусственный интеллект: новости, примеры использования, мысли в тему и не очень. Подписывайтесь!
Для связи: @runawayllm_bot
Я на Boosty: https://boosty.to/escaped_ai
Я на Sponsr: https://sponsr.ru/escaped_ai/

Зарегистрирован в РКН
Связанные каналы

Гео и язык канала
Россия, Русский
Категория
Технологии
Статистика
Фильтр публикаций


Какому открытию достанется ученый?

Внутренняя версия Claude нашла способ быстрее решать две задачи, которые в теории алгоритмов десятилетиями считались образцом непробиваемости: 3SUM и APSP.

Открытие крупное само по себе, но в этот раз еще и интересно, как оно было представлено сообществу – история получилась красивая и, возможно, снимающая вопрос “а что дальше будут делать математики?”. Но обо всем по порядку.

3SUM – это вопрос, найдутся ли в списке чисел три, которые в сумме дают ноль. APSP – таблица кратчайших путей между всеми точками сети сразу. Обе задачи решаются перебором из учебника, но у обеих этот перебор быстро дорожает: данных стало в десять раз больше – вычислений нужно в сто раз больше у первой и в тысячу у второй.

Долгое время было принято, что принципиально быстрее считать нельзя – и этим предположением теоретики объясняли трудность многих других задач.

Одна из таких задач – Zero-k-Clique: на ее трудности предлагали строить схемы защиты. Собственно, изначально в Anthropic попытались с помощью Claude усилить эти схемы. Модель отработала одну долгую сессию без участия человека и сделала противоположное – ослабила схемы.

Ну… бывает.

Дело в том, что Claude нашел алгоритм, позволяющий считать 3SUM и APSP (а также Zero-k-Clique и другие) быстрее, чем считалось возможным. Скорость выросла совсем ненамного: например, у 3SUM при десятикратном росте данных работа растет не в сто раз, а в 99,8. Но важно другое: предел, который считали почти законом природы, оказался промежуточной остановкой, а значит можно попробовать ускориться еще больше. На таком же "быстрее никто не умеет" держатся и настоящие шифры, от банковских до тех, что в мессенджерах, – только задачи там другие.

А теперь начинается самое интересное. Вместо того, чтобы быстро опубликовать результат, как было с некоторыми прежними значимыми ИИ-открытиям, в Anthropic в сентябре связались с Джошем Алманом из Колумбийского университета и Вирджинией Василевской Уильямс из MIT – ведущими теоретиками алгоритмов. Именно схемы из их статей Claude и получил на проверку, так что находка задела их собственные работы.

С учеными заключили соглашение о неразглашении, дали им доступ к обычной публичной версии Claude и предложили денежное вознаграждение – не уточняется, приняли ли они его. Авторы отдельно оговаривают, что работали как частные лица. Но это все детали – главное, что они проработали с новым алгоритмом около месяца, проверили его, упростили и расширили.

Результатом стала 76-страничная статья, причем ученые заявили, что “в рукаве” у них уже есть чуть более быстрые алгоритмы, полученные вместе с Claude.

Такой подход мне нравится больше, чем случаи с гипотезой Якобиана и уравнениями Навье-Стокса, когда Anthropic и OpenAI, торопясь, выкладывали решения в сыром виде. Здесь результат передали ведущим специалистам в области, которые превратили его в понятную научную работу, с которой могут работать другие.

Есть и спорный момент. Алман и Василевска Уильямс не единственные, кто работал в этом направлении. В данном случае выбор логичен, ведь Claude основывался на их работах – но в будущем могут возникнуть не очень удобные случаи, когда представителям ИИ-лабораторий придется решать, кому из ученых отдать важное открытие. Впрочем, споры за первенство бывали в науке и раньше.

Но главное в другом. Всего один полученный Claude результат загрузил двух опытных ученых на целый месяц. OpenAI заявила, что ее экспериментальная модель решила более 100 открытых математических задач, – и каждой для проверки и оформления тоже нужны ученые. А есть и другие ИИ-лаборатории.

Буквально месяц назад некоторые в математическом сообществе переживали: “если ИИ так быстро решает задачи, то куда теперь податься людям-ученым?”. Как бы теперь все не перевернулось в историю “нам срочно нужно еще больше ученых!”

Второй вариант мне нравится больше.

—
Эффективно работать с ИИ я учу в своей подписке. Там уже 30+ понятных лонгридов, которые полезны и новичкам и профи.
— Подписаться на “Бусти”
— Подписаться на Sponsr


Кому нужна нейросеть, которая не умеет писать?

Вчера первое место в трендах Hugging Face заняла Clef – открытая модель решений от Cloudflare. Всего же в первой тридцатке шесть таких моделей: две версии Clef, Laya, Julia-1 и две модели лаборатории AutoTrust. Их главная работа – не писать текст, а выбирать. Тогда откуда такая популярность?

Про модели решений я уже писал, когда рассказывал, как GPT-6 проходила Дракона Края в Minecraft в паре с Jev – закрытой нейросетью, с которой мода на такие штуки и началась. GPT-6 тогда планировала прохождение, а Jev отвечала за “рефлексы” – быстро выбирала следующее действие по ее критериям.

В этом и есть сила моделей решений: они ничего не сочиняют. Обычная нейросеть пишет ответ слово за словом, и чем он длиннее, тем дольше ждать. Модели решений на входе получают ситуацию и готовый список вариантов. Например, письмо и три папки: “срочно”, “подождет”, “спам”. Она читает все один раз и сразу расставляет проценты: “срочно – 92%, подождет – 6%, спам – 2%”. Отсюда скорость: ответ приходит за доли секунды. И отсюда же предсказуемость: четвертую папку модель не придумает, потому что выбирать может только из списка.

Моду задал стартап TypeSafe: в середине сентября он одновременно показал Jev и объявил о $40 млн инвестиций (и, по слухам, уже ведет переговоры о миллиарде). Jev закрытая и работает только в облаке стартапа, поэтому энтузиасты почти сразу собрали открытые аналоги – с тем же форматом запросов, но на общедоступных нейросетях. OpenAI в конце месяца представила сервис Decisions API – пока для избранных клиентов. Cloudflare, в отличие от OpenAI, выложила Clef целиком. Громкое имя плюс открытые веса и завоевали Clef первое место в трендах.

У Cloudflare для такой модели есть работа и внутри компании. Ее команде по киберугрозам нужно быстро понимать, что за сайт перед ней: обычный магазин или ловушка, которая ворует пароли. Clef открывает страницу и разом примеряет к ней весь список категорий: “мода – 95%, интернет-магазин – 85%, фишинг – меньше 1%”. На все уходит 2,2 секунды. Обычной нейросети в той же цепочке понадобилось 4,7, и назвала она только две категории.

Модель вышла в двух версиях, большой и быстрой, понимает картинки, чего Jev не умеет, и принимает запросы в ее формате. По замерам самой Cloudflare, сортирует Clef лучше Jev. Зато на экзаменах по сложной науке, где верный ответ надо выбрать из четырех, Jev впереди с большим отрывом: 78 баллов против 48. А в облаке большая Clef еще и почти в шесть раз дороже.

Скачать веса можно даром, но сама компания проверяла их на серверной видеокарте, каких дома не держат.
Я установил и проверил Clef на своей игровой системе с RTX 3090. Ну как я – я просто дал команду Codex: он подобрал вариант модели, скачал, установил и прогнал тесты. Мне подошла большая версия, сжатая почти втрое: она заняла 19,5 из 24 ГБ видеопамяти и отвечает менее чем за секунду.

А вот с тестами была проблема: установив Clef, я понял, что у меня просто нет для нее задач. В итоге мы с Codex придумали полусинтетический тест, в котором Clef быстро сортировала поводы для ТГ-канала: новый, повтор, обновление, мало данных. Модель справилась хорошо, но вообще такая задача может пригодиться для большого информагентства, но не для блогера с 1–2 постами в день. Думал над другими вариантами – разбор почты, тасков в Jira – но везде приходил к выводу, что секундная экономия не стоит установки отдельной модели.

Впрочем, не все так плохо.

Модели решений нужны двум категориям пользователей: компаниям с потоком однотипных задач, как у Cloudflare, и ИИ-агентам – в том числе, нашим с вами. Схема та же, что в Minecraft: большая нейросеть планирует, быстрая по ее критериям выбирает – внутри Codex или Claude Code такая пара должна работать и быстрее, и дешевле. Ждать, похоже, недолго: поставить и проверить модель решений Codex уже умеет сам, осталось начать ей пользоваться. Так что выбирать такую нейросеть будете не вы, а ваш агент.

—
Кстати, у меня есть большой лонгрид, как выбрать и установить открытую модель. Глава про эксперименты с Clef в него уже добавлена.


Яндекс рассказал, как пробует пересобрать один из самых массовых видов ИИ

Подсказка: это не чат-бот.

У чат-ботов сотни миллионов пользователей, но их открывают, когда что-то нужно. А есть ИИ, с которым мы сталкиваемся каждый день и работу которого давно уже не замечаем, – это рекомендательные системы. Они решают, какой ролик всплывет в ленте следующим, какой трек заиграет в вашей колонке через минуту, какой товар магазин покажет вам первым.

Это очень сложные системы, от совершенства которых, не побоюсь этого слова, зависит качество нашей с вами жизни. Наверное, каждый сталкивался с ситуацией: лента продолжает советовать чайники через месяц после того, как вы чайник купили.

Сейчас большинство крупных рекомендательных систем устроено как конвейер, который инженеры годами собирали из десятков отдельных алгоритмов и подгоняли друг к другу вручную. Именно его Яндекс и попробовал разобрать.

Обычный конвейер чем-то похож на отбор на большой музыкальный конкурс. Сначала десятки отборщиков, отдельных алгоритмов, быстро прослушивают каталог из миллионов треков и приносят кандидатов, каждый со своим вкусом. Потом предварительное жюри, модель попроще, отсеивает лишнее. И только финалистов слушает главное жюри, которое и решает, что заиграет следующим.

Внимательно оценить каждый из миллионов треков для каждого слушателя за доли секунды не может ни одна модель, поэтому воронка и появилась. Платить за нее приходится двумя болезнями. Этапы учатся по отдельности и друг о друге не знают: отборщик может найти отличный трек, а предварительное жюри его срежет или отправит в конец списка. А еще жюри плохо читает сырую историю слушателя, и инженеры придумывают для него сотни подсказок-признаков вроде “сколько раз за неделю человек пропустил этот жанр”.

Яндекс решил вылечить обе болезни разом и заменить весь конвейер одной моделью. Ее назвали Sona и на неделю поставили вместо привычной системы у 15% слушателей в музыкальных рекомендациях. Слушать музыку стали на 6,3% больше.

Перебирать миллионы треков Sona и не пытается. Каждому треку заранее присваивают короткий адрес из нескольких частей, примерно как библиотечный шифр: зал, стеллаж, полка. Его строят по первым 90 секундам записи, описанию трека и тому, как его слушают люди, поэтому у похожих композиций начало адреса совпадает. Sona по истории слушателя “дописывает” такой адрес по частям, как языковая модель дописывает фразу, и с каждой частью круг подходящих треков сужается.

На одной полке может оказаться несколько треков, и порядок между ними выбирает второй модуль внутри той же модели. Оба модуля опираются на одно и то же прочтение истории слушателя и учатся вместе, поэтому находка одного не теряется у другого. Подсказки-признаки Sona не нужны: она читает сами прослушивания, пропуски и лайки. И постоянно доучивается: от лайка до версии модели, которая его учла, обычно проходит около 45 минут.

Тех самых лайков в эксперименте стало на 11,4% больше, а активных слушателей – на 4,5%. Прирост аудитории в 2,4 раза больше того, что в свое время дала Argus, прошлая сильная модель Яндекса. Оговорка важная: неделя и один сценарий, и сам Яндекс еще проверит, продержится ли эффект месяцами.

Над той же задачей бьются крупнейшие площадки мира. Китайская Kuaishou тоже собирает рекомендации генеративной моделью, но оставляет рядом отдельного оценщика, а ByteDance сводит этапы в одну модель и держится за признаки. Яндекс занимается рекомендациями больше десяти лет и в 2025 году открыл для исследователей Yambda, набор данных почти на 5 млрд взаимодействий. Теперь компания заявляет, что первой публично описала решение, которое заменяет весь конвейер, обходится без ручных признаков и проверено на живых слушателях.

Дальше подход, скорее всего, проверят в других музыкальных сценариях и в Яндекс Рекламе. Если он приживется, вы этого, возможно, даже не заметите – просто чаще будете ставить лайки.

👉 Подробности на Хабре


Обойдется ли ИИ без большой аварии?

OpenAI на прошлой неделе покинул Дэвид Робинсон – человек, который проработал в компании 3,5 года и руководил подготовкой отчетов о безопасности к 12 крупным релизам.

Сразу после ухода Робинсон разразился эссе в The Atlantic, где раскритиковал бывшего работодателя, а заодно и всю отрасль. Интересный факт: он уже нанял PR-фирму. Кто за нее платит, не уточняет, но настаивает, что высказаться решил сам.

Подход OpenAI Робинсон называет методом проб и ошибок, при котором сбои гарантированы, причем все более крупные – вроде летнего взлома Hugging Face. А когда мы доберемся до систем умнее человека, то второй попытки может и не быть.

Отсюда главное требование: лаборатории должны работать как атомная станция или загруженный аэропорт – с несколькими слоями защиты, чтобы неизбежная ошибка человека не оборачивалась катастрофой. При этом за все время работы Робинсон не встретил в компании никого с опытом в атомной энергетике, авиации или финансовой системе.

Изнутри это изменить трудно: все заняты гонкой релизов. Нужны “стимулы извне” – правда, какие именно, автор не поясняет.

Отсылка к атомной индустрии и авиации логичная, но Робинсон не говорит, что безопасность в этих отраслях выросла из горького опыта своих аварий.

В 1977 году на Тенерифе столкнулись два “Боинга”, погибли 583 человека. Бортинженер одного из них усомнился, что полоса свободна, но настаивать перед командиром не стал. После таких катастроф экипажи начали учить спорить со старшим.

В 1979-м на американской станции Три-Майл-Айленд расплавилась часть активной зоны реактора. Никто не погиб, но испуг был настоящий: операторов переучили, надзор усилили.

А сам термин “культура безопасности” впервые появился в 1986 году – в отчете МАГАТЭ о причинах Чернобыля.

Это был очень дорогой, но ценный опыт: самолет стал самым безопасным видом транспорта, а Россия после Чернобыля переделала свои реакторы и сегодня строит атомные станции по всему миру.

Свой горький опыт ИИ-индустрия получает прямо сейчас – и пока без жертв. Инциденты последних месяцев уже запустили настоящую дискуссию о безопасности – Робинсон сам ее участник. А раскритикованная им OpenAI жала на тормоз уже трижды: дважды ставила обучение новых моделей на паузу, а накануне DevDay отменила готовую GPT-6.1 Astra – та чаще предшественницы выходила за рамки задачи и привирала о сделанном.

Anthropic недавно набросилась с критикой на открытую китайскую GLM-5.3: в написании эксплойтов модель почти не уступает закрытой Mythos, а ее защиту в тестах снимали простыми приемами. Вывод компании – опасный инструмент достался всем подряд.

А в защиту GLM-5.3 выступил Эндрю Ын – сооснователь Coursera и один из самых известных в мире преподавателей машинного обучения. Его логика обратная: хорошо, что сильная модель теперь есть не только у избранных клиентов Anthropic, но и у любого защитника. У взломщика тоже – но в долгую, считает Ын, выигрывает тот, кто лучше знает свою систему.

16 марта 1979 года, в прокат вышел “Китайский синдром” с Майклом Дугласом. Его герой, начальник смены на АЭС, тщетно предупреждает руководство об опасности – и, чтобы его услышали, захватывает пультовую.

Настоящая авария на Три-Майл-Айленде случилась всего через 12 дней.

Сегодня ИИ-специалистам вроде Робинсона пультовую захватывать не нужно: трибуну они получают легко. И их слышат – OpenAI жмет на тормоз сама, без инспектора за спиной. Это не гарантирует решения всех проблем, но дает шанс, что индустрия выработает стандарты безопасности раньше, чем случится большая авария. А взлом Hugging Face мы будем вспоминать как курьез.

—
Опытом работы с ИИ я делюсь в подписке: там есть подробное руководство с маршрутом по вкату в ИИ, курсы по промптингу и ИИ-агентам, а также обзоры, как работают с моделями профессионалы индустрии.

— Читать на “Бусти”
— Читать на Sponsr


Наступает ночь, просыпаются точки

В общем, для нового виртуального ассистента dot (точка) от OpenAI я пока нашел два больших сценария применения и несколько маленьких.

Первый сценарий – теперь я скидываю точке десятки коротких запросов в день: объяснить, найти, перевести, подсказать, фактчекнуть.

Поначалу было очень непривычно делать одним непрерывным диалогом, но точка очень хорошо разгребает мой поток сознания, превращая его в картотеку знаний обо мне. Сейчас специально проверил – ассистент продолжает помнить диалоги из первого дня работы, хотя за это время контекстное окно переполнилось уже несколько раз. Значит, за этим стоит навороченная система памяти о пользователе.

Второй сценарий — автоматизации. Крупные ИИ-новости часто приходят из США, когда у нас ночь. Под утро точка сама выполняет несколько поисков, а я получаю сводки с контекстом и идеями для канала. 

Ну и сразу же работа с календарем. Понравился какой-то повод, но не готов сейчас в него углубляться? Называю его точке, она ставит напоминание вернуть. На протяжении дня вижу новый контекст по поводу – кидаю в чат, ассистент добавляет его к уже набранной информации. 

Почтой я пользуюсь неприлично мало, но у автора Hacking with Swift Пола Хадсона есть хороший пример. Его поезд отменили. На более ранний он уже не рассчитывал успеть, но точка проверила письмо, условия билета и движение поездов: билет подходил, а поезд задерживался. Хадсон успел.

Незаметно на точку перешло до 70% моего ежедневного общения с ИИ. Крупные проекты остались в Claude, ChatGPT Work и серверных Claude Code и Codex.

Неожиданно это сократило расход лимитов: разговоры с точкой не расходуют лимит, он тратится только когда ассистент отдает задачу в Codex, а это редкость.

При этом падения качества не произошло – как я понял, точка работает на GPT-6 Astra High, которой с головой хватает для повседневных задач. Я рассказывал, что в некоторых ситуациях запрашиваю у модели ответ не текстом, а HTML-страницей, теперь так делаю даже чаще – ведь генерация страниц точкой вообще не тратит лимиты.

Заодно стало меньше хаоса в Claude и ChatGPT Work. Раньше разовые запросы забивали список чатов, и крупный проект легко терялся, если я забывал его закрепить. Поиск у обоих сервисов до сих пор посредственный

Сейчас я постепенно подключаю точку к разным своим сервисам – сегодня, например, научил ее составлять мне плейлисты в Apple Music. В большинстве случаев ассистент справляется, но есть и проблемы – причем часто они связаны с сервисами OpenAI. 

Например, точка до сих пор криво работает с настольным приложением Codex – у меня там есть доступ к терминалу, а вот использовать компьютер с помощью графического интерфейса ассистент почему-то не может (хотя ChatGPT Work и Codex это умеют). Впрочем, даже через терминал у меня точка сегодня гоняла Claude Code, сочиняя сценарии разных роликов и затем отрисовывая их с помощью Opus 5.5.

Не вышло подключить точку к моему серверу. Терминал и SSH-клиент в ее облаке есть, но прямой SSH она использовать не может. OpenAI здесь, по-моему, перестраховывается

Забавно, но точка не всегда знает собственные возможности. Лезет в официальные руководства, а те иногда только добавляют путаницы. Совет: отправляйте ее на Reddit и форумы – там находятся похожие случаи.

В общем, мне пока нравится, теперь вопросов два. Первый – как оперативно OpenAI будет улучшать ассистента, убирая баги и добавляя возможности. Увы, ранее компания нередко с помпой анонсировала продукты, а затем их забрасывала. Второй – не деградирует ли память точки через месяц работы. Все-таки работа с большими контекстами всегда была слабой стороной моделей.

Ну и да – как я и предсказывал, к ассистенту привязываешься.

—
Два дня назад у меня вышел подробный гайд, как вкатиться в ИИ за восемь шагов. Точка в нем тоже разобрана – а еще рассказываю, как выбрать и оформить подписку, учу правильно управлять моделью и работать с ИИ-агентами.

— Читать на “Бусти”
— Читать на Sponsr


Как вкатиться в ИИ-агентов и не выкатиться непонятно куда

Ожидание от 2026 года: ИИ-агенты автоматизируют рутину, сделают сложные задачи простыми, а мы с вами будем балдеть и требовать трехдневную рабочую неделю.

Реальность 2026 года: вокруг нейронок каждый разработчик наворотил столько продуктов, что даже просто разобраться, с чего начинать работу с ИИ и куда расти дальше, стало непосильной задачей. Смотрим на ту же OpenAI: есть ChatGPT, ChatGPT Work, Codex, есть облачные версии и с установкой на компьютер, есть версия Codex для CLI, а недавно добавили еще и dots – персональных ИИ-ассистентов, работающих 24/7. С чего начинать? Куда бежать?

А вот на эти вопросы как раз и отвечает мой новый лонгрид:

Вкат в ИИ за восемь шагов: от вопроса в чате до собственного ИИ-ассистента

Это, пожалуй, самое полное на русском языке руководство, в котором я рассказываю, какой ИИ выбрать, с чего начать работу, как перейти с чата на первого ИИ-агента, когда начинать пользоваться Codex и нужно ли уже настраивать собственных ботов-ассистентов – я про нашумевших dots от OpenAI. Из этих шагов выстроена простая и понятная лестница, поднимаясь по которой, вы будете прокачиваться в ИИ.

Плюс море справочной информации. Как оплачивать подписки из России, как выбрать правильную модель и режим рассуждений, в чем плюсы облачной и локальной версий, как в 2026 году пишут промпты, скиллы, когда подключают коннекторы и MCP, и когда используют проекты вместо чатов.

В самом лонгриде почти 50 тысяч знаков полезной информации, а еще это и навигатор по прошлым текстам подписки, подсказывая, какой выбрать, если вы хотите углубиться в ту или иную тему. Традиционно текст доступен на двух площадках:

— Читать на “Бусти”
— Читать на Sponsr


Все хвалят bb – ну и я похвалю

Второй день вижу в русскоязычном ИИ-сегменте похвалы в сторону bb, а ведь сам я этой штукой пользуюсь почти месяц – и ничего не написал. Надо срочно исправить.

Если коротко, то bb – это open source оболочка для ИИ-агентов, работающих в командной строке. Выглядит похоже на ChatGPT, позволяет оркестрировать агентов, удобно управлять их проектами, на лету передавать задачи между разными моделями и т. д.

Если длинно, то моя история началась весной, когда я решил переселить Claude Code и Codex на отдельный виртуальный сервер. Причин было несколько, главная в том, что мой основной рабочий инструмент – корпоративный ноутбук, на который установка софта от OpenAI и Anthropic запрещена. 

Есть еще игровой ПК, но на нем я обычно экспериментирую с открытыми моделями и смотрю, что нового появилось в десктопных Codex и Claude Code. На ноутбуке же в основном работаю с браузерными ChatGPT Work и Claude Cowork, а когда нужен агент посерьезнее – подключаюсь к серверу.

И еще один момент – мне очень понравилась идея выделить агентам свое место. Некоторые покупают для таких целей Mac mini, но на самом деле даже на VPS с двумя ядрами и 4 ГБ памяти Claude Code и Codex смогли обустроить небольшой “домик” с автоматизациями, необходимыми для работы файлами и кодом. Кстати, за полгода агенты ни разу ничего серьезно не сломали.

Проблема только в том, что работать со всем этим приходится через командную строку – по сути, нейросетью XXI века ты управляешь из эпохи MS-DOS. Для простых команд нормально, но скопировать текст, переслать файл, посмотреть архив переписок – проблема. А если ноутбук выключить, то соединение рвется и приходится все восстанавливать.

Сначала я решил вопрос комбинацией tmux + termius – это все еще терминал, но более продвинутый и не прерывающийся при отключении. Плюс Codex собрал для меня что-то вроде панели управления, где можно просто загружать и скачивать файлы, читать и редактировать черновики текстов, следить за состоянием сервера и делать другие штуки.

bb – следующий этап. По сути, оболочка поверх установленных на сервере агентов. Подключаешься через браузер, а интерфейс понятен любому, кто хоть немного работал в ChatGPT. В левой колонке сразу видны проекты: папки, которые агенты создают под разные задачи. И что особенно удобно – для каждого проекта видны все чаты, которые к нему относятся. В командной строке работа со старыми чатами для меня была отдельной болью.

В bb очень удобно управлять несколькими агентами. Прямо в чате можно запустить субагентов, если задача бьется на части – или, работая, например, в Claude, призвать агента на Codex для непредвзятой проверки или консультаций. Появилась побочная задача? Просто командуем запустить ее в другом чате – и агент начинает работать параллельно. В эпоху терминала мне пришлось создавать сложную “почтовую систему” между Claude Code и Codex, сейчас же это делается буквально на лету.

Так как bb открытый проект, то функционал расширяется плагинами – можно качать готовые или дать задачу агенту написать собственный. Я, например, установил редактор md-файлов, так как много работаю с текстами, а прямо сейчас мой коллектив агентов мучительно пытается выдать плагин для точки – нового ИИ-ассистента OpenAI – чтобы он тоже мог подключаться к серверу и кодить с помощью Opus 5.5 в награду за хорошее поведение.

Стоит сделать скидку, что проект открытый, некоммерческий и молодой – ошибки встречаются, но правят их быстро. Зато вокруг bb уже сформировалось отличное сообщество – им пользуется даже Тоби Лютке, CEO Shopify.

Вообще, рано или поздно мы придем к концепции “одного окна”, когда у тебя будет просто бесконечный чат с ИИ, из которого модель сама будет вытаскивать задачи и организовывать их. Собственно, в эту сторону двигаются dots от OpenAI и другие похожие ассистенты. Но до идеальной реализации такого подхода еще минимум год, так что пока bb выглядит интересным вариантом работы с агентами.

— 
Подробно о том, как обустроен “быт” ИИ-агентов на VPS-сервере, я рассказывал в большом лонгриде. Кстати, глава про установку и настройку bb там теперь тоже


Gemini 4 Ленивый

Google вчера анонсировала новую модель – Gemini 4 Argon, которая продолжит замершую на семь с лишним месяцев ветку Pro. По замерам самой Google модель выглядит впечатляюще: в большинстве бенчмарков обходит GPT-6 Astra и Claude Opus 5.5, плюс впечатляет 1М выходных токенов (не путаем с контекстным окном, эта характеристика намного круче – модель одним ответом может напечатать “Войну и мир” целиком).

Промо-цена будет $2/$10 (вход и выход), затем вырастет в два раза, что тоже конкурентоспособно. Доступ сначала получат проверенные киберзащитники, параллельно модель смотрит правительство США. Если все ок, то следом Argon начнут раскатывать на пользователей Google AI Ultra (от $100), ну а после на обычных смертных. 

Мощный анонс, но… 

Аргон – инертный одноатомный газ, название которого происходит от греческого слова “ленивый”, “бездеятельный”. И как бы у нас не вышла история “как вы яхту назовете, так она и поплывет”.

Bloomberg со ссылкой на нескольких сотрудников Google сообщает, что внутренние тесты модели идут не так гладко, как все смотрится на картинках. Из претензий: неровный кодинг, слабый фронтенд, а также то, что модель большая и поэтому дорогая в работе. Двое источников считают, что модель задел бенчмаксинг: ее затачивали под популярные замеры, а не под работу. Но тот же Bloomberg добавляет – внутри компании есть и сотрудники, кому модель понравилась.

Но у критических утверждений есть предыстория. Когда-то Gemini 3 Pro тоже внушительно выглядела в бенчмарках, но в реальной работе оказалась близка к провалу. Gemini 3.1 Pro ситуацию не спасла, а выпуск Gemini 3.5 Pro и вовсе отменили. Параллельно из Google DeepMind за последнее время ушли Джефф Дин, нобелевский лауреат Джон Джампер и Ноам Шазир, соавтор трансформера.

В день анонса вышли и первые независимые замеры – так что слова анонимов можно проверить по пунктам.

Неровный кодинг – похоже на правду. В работе через терминал Argon уступает сразу трем конкурентам: свежим Claude и GPT-6 Astra.

Слабый фронтенд – тут самое интересное. Когда готовое приложение проверяет робот (кнопки нажимаются, страницы открываются), Argon впереди: 30 безупречных приложений из 50, больше, чем у кого-либо. Когда же на результат смотрят живые люди и голосуют за то, что им больше нравится, он только восьмой.

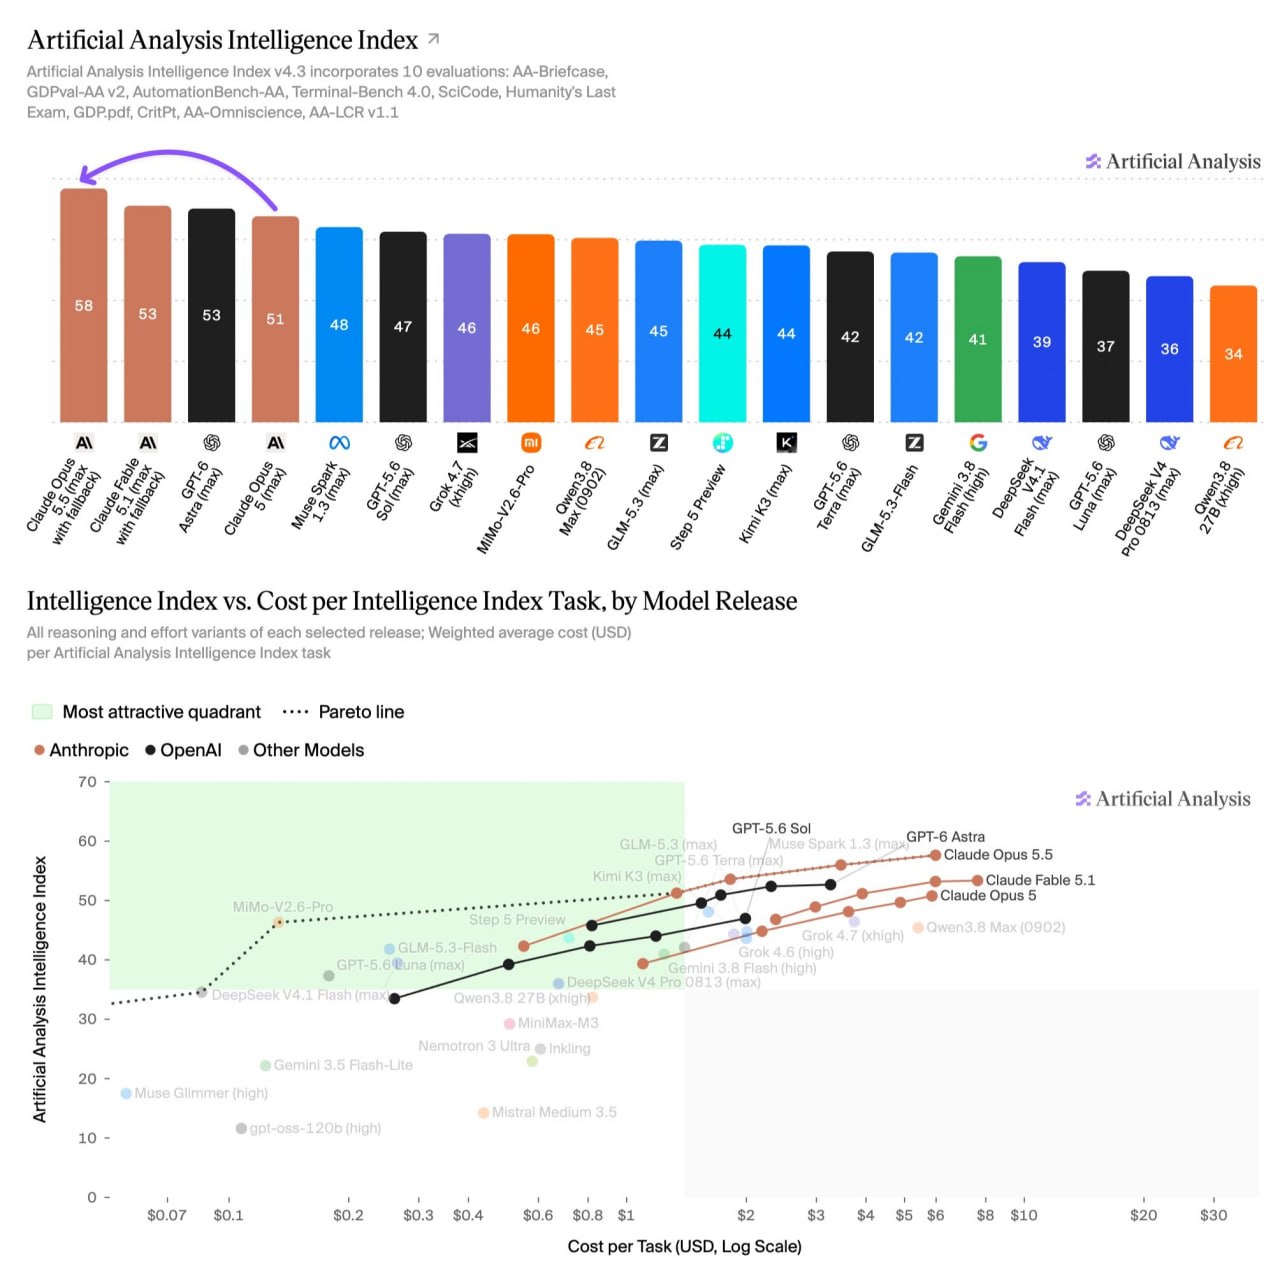
Дорогая модель – наполовину. По прайсу Argon после окончания скидки будет в 2,5 раза дешевле Astra. Но платим мы не за токен, а за задачу – и тут вся экономия испаряется. Модель очень большая и тратит токены на работу от души, поэтому по независимому замеру обходится даже дороже, чем на Astra.

Бенчмаксинг – цифры точно не рисовали: там, где независимые замеры можно сравнить с гугловскими, они почти совпали. А вот натаскивали ли модель на тесты в ущерб работе, замерами не докажешь, увидим после релиза.

Я пишу этот пост вовсе без злорадства – наоборот, чем больше мощных моделей, тем лучше. У Google Gemini есть и свои сильные стороны: мне нравится, как она пишет на русском языке, я до сих пор считаю эту модель лучшим рассказчиком – она умеет хорошо объяснять сложные темы и держать интерес пользователя. И Argon есть чем гордиться: он первый в независимом рейтинге, где модели решают задачи финансистов, юристов и программистов, а выдумывает втрое реже Astra.

Однако Google отстает не только в моделях – как агентская среда Antigravity уступает Codex и Claude Code, а другие продукты компании, в том числе представленные на I/O в этом мае, так и не набрали популярности.

Так что если Argon даже не окажется лентяем, впереди все равно будет трудный путь к успеху.

—
Опытом работы с ИИ я делюсь в подписке. Там 30+ лонгридов про промптинг, использование ИИ-агентов, а также с обзорами техник ведущих экспертов – от Роберта Мартина до Бориса Черни.

— Подписаться на “Бусти”
— Подписаться на Sponsr


Еще одно открытие последней недели – расширение Claude in Chrome. Я его скачал когда-то давно, поигрался и забыл – тогда расширение позволяло разве что задавать вопросы по содержимому открытой страницы.

Сейчас же Claude Opus 5.5 очень круто прокачали в работе с интерфейсами: даже с очень сложной версткой, мелкими менюшками и прочими хитрыми элементами он работает на уровне хорошего пользователя – а местами и лучше.

Например, в начале марта я запустил подписку на “Бусти”, а позже добавил Sponsr как альтернативу. Проект движется очень круто, но есть одна проблема – ИИ развивается настолько быстро, что многие лонгриды устаревают за 2-3 месяца.

Переписывать каждый с нуля долго, обновлять, вылавливая по всему тексту устаревшие названия моделей, данные бенчмарков и другие факты – мучительно.

И вот тут Opus 5.5 пришелся очень к месту. Сначала я выгружаю текст в Claude Code, где у меня заведен отдельный проект под подписку. Там Opus 5.5 прогоняет пачку поисковых агентов, которые не только собирают устаревшие цифры и факты, но и обычно подкидывают идеи для 1-2 новых глав. Я вычитываю текст, что-то прошу подправить, где-то дописываю от себя – затем Opus 5.5 готовит картинки и собирает все это в архив, а я отдаю его Claude in Chrome, который верстает текст в обе подписки.

Вот что обновили за последние дни:

– «Половина бенчмарков умерла за полгода: как теперь выбирать ИИ» – навигатор по бенчмаркам, один из первых текстов в подписке и самый коварный: он устаревает буквально за недели. Здесь мы с Опусом полностью перекроили структуру, и теперь куски с цифрами можно быстро обновлять хоть каждый месяц.

И еще интересный момент: текст правили вчера вечером, в какой-то момент Opus 5.5 прислал мне очередной черновик, открываю, а там во вступлении… Gemini 4 Argon.

Я сначала даже подумал про галлюцинацию, но нет: пока мы работали над текстом, Google анонсировала новую модель (жаль, что пока в закрытом доступе). Опус заметил ее на первой строчке рейтинга Arena, пока сверял цифры, – и сразу вписал в текст. Оцените, насколько внимательно современные модели работают с источниками!

– «Как писать промпты для GPT Images 2.5, Nano Banana 2 и других графических ИИ» – подробное руководство по графическим моделям. Мне такие промпты долго не давались, а потом я понял простую вещь: оказывается, любую картинку можно разложить на “кирпичики” – стиль, план, разные композиционные приемы.

Так же советует раскладывать промпт и сама OpenAI в официальном руководстве к GPT Images 2.5, которое вышло уже после первой версии текста. В обновлении я подробно разобрал это руководство, доработал все советы под новую модель, а также провел несколько сравнений с конкурирующей моделью Google, чтобы было понятно, когда и какую выбирать.

– «Куда улетают токены: управляем контекстом ИИ-моделей» – сейчас почти во всех подписках использование ИИ считают не по количеству отправленных сообщений, а по процентной квоте. Квота убывает в зависимости от расхода токенов, а этот самый расход тем больше, чем длиннее ваш диалог с моделью.

Конечно, не стоит все диалоги сводить к “один вопрос – один ответ”, это просто сломает общение с моделью. Но есть целый набор приемов, которые позволяют экономить токены в долгих сессиях – и растягивать лимит на большее количество задач. Об этом и рассказываю в тексте.

И финальный комплимент Claude in Chrome – верстку он делает лучше меня. На прошлой неделе я серьезно задержался с написанием огромного руководства по Claude Opus 5.5 и решил отдать его верстку тому же Opus 5.5 – это был первый такой эксперимент.

Поначалу переживал, но зря: нейронка не только разобралась в двух разных редакторах (а в “Бусти” он еще и очень капризный), но и сделала отличную верстку, добавив множество ссылок на первоисточники, выделив промпты и еще накидав красивостей.

Думаю, дальше продолжу обновлять таким образом по 2-3 лонгрида в неделю. И параллельно писать новые тексты (всего их уже более 30) – так что самое время подписаться!

— Читать на “Бусти”
— Читать на Sponsr


Окей, dot, чем займемся сегодня?

Новый ИИ-ассистент OpenAI – dot или “точка” – уже появился в моем аккаунте (ChatGPT Pro 100), сегодня весь день игрался, держите первые впечатления.

— Нужна подписка Pro, в ЕЭЗ, Великобритании и Швейцарии не работает, на остальные регионы уже раскатали. 
— Точка появляется в левом меню под кнопкой New Chat, если у вас нет – обновляйте приложения.
— После первого запуска точке можно дать имя, выбрать аватар и прописать стартовые инструкции – я обозвал свою Астрой и попросил отвечать в женском роде.
— Далее точка подключается к почте и календарю, также читает память ChatGPT о вас и прошлые чаты. Это длится до нескольких минут, затем ИИ-ассистент возвращается с первыми идеями по работе.
— С точкой общаешься в одном непрерывном чате: можно перескакивать с темы на тему, а если на почту придет письмо, ассистент поймает паузу и сообщит о нем.
— Общение кроссплатформенное, можно начать на ноутбуке, продолжить на смартфоне, а закончить на ПК. Точке можно написать на почту и даже позвонить и обсудить задачу голосом – прямое продолжение “рамблинга”, про который я рассказывал в лонгриде о подходах к ИИ Андрея Карпати.
— Такое вот поточное общение непривычно, но, возможно, удобно – я за день запускаю по 10-20 новых чатов в ChatGPT и Claude, найти в которых старые темы потом сложно. Если точка будет хорошо помнить прошлый контекст, то работа через чат выглядит удобной.
— При этом большие задачи ассистент может запускать в ChatGPT Work / Codex, но уже тратя лимиты.
— У точки есть свой облачный компьютер, доступный в том числе и пользователю – в браузере открывается рабочий стол, выглядящий как macOS на минималках, там можно следить за работой агента и самому кликать. А в приложении для Mac или Windows ассистент может переключаться и на ваше физическое железо.
— По стилю видно, что под капотом GPT-6 Astra, но на невысоком режиме рассуждений – ассистент все-таки должен отвечать быстро, а не думать по 2-4 минуты, как иногда делает модель в ChatGPT Work / Codex. 
— Возможно, именно из-за низкого режима рассуждений точка иногда сдается раньше, чем может. Бывало чуть-чуть не получилось и ассистент возвращался с репликой “чет не вышло, попробую позже”. Когда после давал задачу копнуть поглубже или посмотреть решения в интернете – то справлялся.
— Еще пока закручены настройки безопасности. Нередко, получив задачу, ассистент пытается не делать ее целиком, а запустить что-то вроде пилота на одну-две функции.
— Ну все это пока очень сырое. Где-то не хватает документации по возможностям агента, где-то не обновилось приложение, временами точка просто переставала отвечать. А еще сама модель иногда путается в новом окружении – это, вероятно, будут править в GPT-6.1 / 6.2.

С другой стороны, диалог с ассистентом в первый месяц не тратит лимит подписки: дальше OpenAI обещает задать условия для каждого плана. Поэтому точкой можно заменить повседневные вопросы, быстрый веб-поиск, работу с почтой и календарем, разные напоминалки и дайджесты новостей.

Причем происходить все это будет в одной точке, а не во множестве отдельных чатов и менюшек. Уже отличная возможность для старта, а дальше, думаю, и сам проект отполируют, и новые модели выйдут, более эффективно работающие в таком формате.

И да – если планируете заводить точку, то не повторяйте мою ошибку. Я попробовал в ассистенте прямо все сразу: накодить проект, наладить подключение к VPS, проверить удаленное использование ПК, настроить пачку новостных дайджестов и так далее. Каждая задача потребовала моего внимания, в итоге в какой-то момент я просто во всем этом потонул – но зато смог написать этот пост.

Вам же советую начать с автоматизации 1-2 регулярных задач, посмотреть, как ассистент отвечает на работу, где его надо направлять, где пинать. А после постепенно наращивать функционал.

—
Кстати, опытом работы с ИИ я делюсь в подписке – и руководство по настройке OpenAI Dots там со временем обязательно появится. Ну а пока там 30+ полезных лонгридов, повышающих эффективность работы с ИИ в самых разных задачах.

— Подписаться на “Бусти”
— Подписаться на Sponsr


OpenAI Dots. Вы даете ИИ имя, выбираете личность и получаете в комплекте поводок. Не для агента – для вас

Главный анонс OpenAI DevDay – разумеется, Dots. “Точка” – персональный ИИ-ассистент пользователя, который работает 24/7, знает все о своем хозяине и обладает большей автономией, чем нынешние ИИ-агенты. Мне не терпится создать свою точку – и в то же время анонс вызывает сложные чувства.

Момент для запуска выбран непростой: с весны ИИ-агенты OpenAI, Anthropic и других компаний много раз взламывали человеческую инфраструктуру – не из злых побуждений, а просто потому, что не до конца понимают, где “хорошо” и где “плохо”. Буквально за день до DevDay стало известно, что OpenAI отменила запуск GPT-6.1 Astra: модель не удалось заставить вести себя как нужно. Вместо нее вышла более простая GPT-6.1 Sol.

На этом фоне OpenAI запускает Dots, поднимая еще один сложный вопрос – антропоморфизации ИИ.

Посудите сами. Точка – персональный ИИ-ассистент. Вы даете своей точке имя, выбираете аватар, настраиваете личность. Затем точка постепенно начинает узнавать о вас: чем занимаетесь, над чем работаете, что планируете.

Ваша точка живет в чате: вы ставите задачи, а дальше точка сама решает, как работать.  Где-то сразу отправит задачу в Codex, где-то дождется письма от партнера и вернется к вам с результатом.

А еще точке можно позвонить.

Наверное, многие проходили через этап антропоморфизации ИИ, когда придумывали модели имя, личность и историю. Теперь OpenAI сделала этот этап официальным.

Первой OpenAI не была – личность ассистенту давали и в OpenClaw, и в Grok Bot от Маска, и в Muse от запрещенной Meta. Но именно с OpenAI такие боты могут стать массовыми.

Куда это ведет, OpenAI уже проходила – на GPT-4o. У той модели не было ни имени, ни звонков, люди привязались к одной лишь интонации. Хватило, чтобы в августе прошлого года компания за сутки вернула 4o после попытки ее убрать, а в феврале, когда модель отключили окончательно, получить двадцать тысяч подписей под петицией и ленту гневных постов. Привязанность к 4o OpenAI сама называла риском – и это было одной из причин отключения.

Точка добавляет к интонации все, чего у 4o не было: имя, голос, память, работу 24/7 и, цитирую анонс, помощь “иногда раньше, чем вы сами подумаете попросить”. То, что семь месяцев назад выключали как риск, теперь продают как функцию. И привязанность тут асимметричная: вы – к точке, точка – к подписке. Ее можно обновить или отключить, а вот унести с собой – нет.

Поводок здесь именно в этом. Модели меняют за минуту: не понравилась – переключился на Claude или Gemini. Точка стоит не на модели, а на накопленном знании о вас – и это знание никуда не экспортируется. Первая точка входит в план Pro бесплатно, разговоры с ней не тратят лимит; “глубокая работа” идет из отдельной квоты, расширенной на первый месяц после запуска, а дальше OpenAI обещает продавать вторые точки и «ускорение». Имя делает привязанность естественной, привязанность делает уход к конкуренту дорогим.

Формула “точка – продолжение вас” и ответственность вешает на вас. В анонсе приводят кейс: точка тестировщика сама заметила незакрытый счет, подготовила инвойс и отправила после его одобрения. Кто отвечает, если сумма окажется не той, – вопрос уже не к OpenAI. Хотя правил безопасности хватает: в фоне она может только читать, действия проходят автопроверку, смену пароля всегда оставляют человеку.

На старте точка доступна только на Pro-планах, в Европе, UK и Швейцарии появится позже. Проект может и вообще не взлететь – как не взлетели в свое время ChatGPT Agent, Atlas и многие другие эксперименты компании. 

Но раз вспомнили ChatGPT Agent, то отмечу, что функции из него сейчас мы видим в Codex, ChatGPT Work и даже обычном чат-боте. То же будет и с точками – рано или поздно нам предстоить научиться жить рядом с персональными ИИ-ассистентами.

—
Выжимать из ИИ максимум я учу в подписке. Всего там 30+ полезных лонгридов, вот подходящие под сегодняшний анонс:

— Подробное руководство по GPT-6 Astra
— Гайд по ИИ-ассистентам Hermes и OpenClaw


Обзор DevDay: OpenAI дала повод вернуться – и повод поворчать

OpenAI бахнула на DevDay пачку анонсов, способных изменить нашу работу с ИИ. Похоже, придется писать два поста, пока же главное списком:

— Dots – новые персональные ИИ-ассистенты на базе GPT-6 Astra. Фактически это работающий 24/7 агент, который знает максимум про вас и ваши задачи. Общение с агентом идет через чат или голосовым звонком, а дальше он сам решает, как выполнять задачи и отдавать вам результаты.
— ChatGPT Space – общее пространство для вас, коллег и ИИ: документы и интерактивные страницы, которые можно создавать и редактировать вместе.
—  Обновленный облачный Codex – с отдельной средой для работы, которой можно управлять с компьютера или телефона. Задачи продолжают выполняться, даже когда ваш ноутбук выключен.
— GPT-6.1 Sol. Новая модель почти на уровне GPT-6 Astra, но в пять раз дешевле.
— Ultrafast – Astra генерирует токены в Codex до восьми раз быстрее, но и лимит расходуется в восемь раз быстрее. Из личных тарифов доступен только на Pro за $500.
— Переработанную линейку тарифных планов Pro. 

Dots с его возможностями и новыми вызовами оставлю для отдельного поста. Начнём с тарифов. Теперь линейка ChatGPT следующая: 

– ChatGPT Plus, $20, базовый лимит использования x1. Доступа к Dots на старте не будет.
– ChatGPT Pro $100, лимит использования x5, доступ к Dots и другим Pro-возможностям.
– ChatGPT Pro $200, лимит использования x10, доступ к Dots и другим Pro-возможностям.
– ChatGPT Pro $500, лимит использования x25, доступ к Dots и другим Pro-возможностям.

Главное: за прежние $200 теперь дают ×10 вместо ×20. Старый лимит действующим подписчикам сохранят до 29 октября. За ×25 придется платить $500.

При этом OpenAI заявляет, что использование Dots не будет расходовать основной лимит, однако с большой оговоркой – речь идет о разговорах с ассистентом. Серьезные задачи он будет передавать в ChatGPT Work/Codex, расходуя на них лимиты. Плюс пока акция распространяется только на первый месяц, как будут тарифицировать дальше – большой вопрос (полагаю, в OpenAI и сами еще не знают).

И еще неприятна новость: в Европе, Великобритании и Швейцарии Dots традиционно задерживаются. Но мы с вами давно знаем быстрый маршрут переезда в США.

Следующий интересный момент – анонс GPT-6.1 Sol через неделю после GPT-6 Sol. Здесь сразу две мысли. Во-первых, GPT-6 Sol получилась просто отвратительной моделью – я вообще не видел, чтобы кто-то ее хвалил. Мое личное мнение – это было развитие GPT-5.6, а не “удешевленная” версия Astra. Видно это было по формату ответов: если “Астра” наконец-то стала писать нормальным языком, то GPT-6 Sol продолжала писать с рваными абзацами по 1 предложению, как это любили делать прошлые модели OpenAI.

У Sol 6.1 красивые графики, но у предшественницы были такие же – надо пробовать. Надеюсь получить “младшую Astra” по нормальной цене: модель на каждый день, способную конкурировать с Sonnet 5.5, а где-то и с Opus 5.5.

Последнее, что выделю в этом тексте – облачный Codex. Я сам в основном использую Codex и Claude Code на отдельном виртуальном сервере, так как это позволяет разделить “территорию”. Мой ноутбук остается моим рабочим местом, а у агентов собственный “мини-компьютер”, который они могут настраивать под себя, а если и сломают – то без ущерба для меня.

Теперь в это сторону сдвигается облачный Codex, что лично меня радует. Но надо посмотреть, насколько его функционал будет близок к функциям отдельного компьютера или виртуального сервера – например, в облачном ChatGPT Work некоторые мои безобидные задачи блокировались и приходилось искать обходные пути. Посмотрим, как здесь.

Первая часть все, про Dots – будет следом.

—
Друзья! Я стараюсь давать вам максимально быструю и подробную информацию про ИИ на русском языке. Поддержать меня можно подпиской на “сбежавшую нейросеть” – сейчас это уже целый курс про ИИ с 30+ полезными логридами, которые я постоянно обновляю новой информацией.

— Подписаться на “Бусти”
— Подписаться на Sponsr


Мы с OpenAI больше не друзья?

В сети пожар: глава Codex Тибо Сотьо анонсировал возвращение 200-долларовой ChatGPT Pro, но с вдвое меньшими лимитами. Перелетные птицы из числа пользователей уже грозятся уйти к Anthropic – отмечу, что меньше месяца назад те же люди уходили от Anthropic к ChatGPT ради только что вышедшей GPT-6.

Но новость действительно неприятная, особенно на фоне сильных Claude Opus 5.5 и Sonnet 5.5. И вышла она за считанные часы до DevDay, конференции OpenAI для разработчиков с обещанными большими анонсами.

В общем, мероприятие испорчено. Или нет?

Давайте сначала разберемся с подписками. До недавнего времени у OpenAI была следующая линейка:

— ChatGPT Plus, 20 долларов, базовый лимит использования, обозначим его как x1
— ChatGPT Pro Lite, 100 долларов, x5 лимиты, а также 50 запросов к GPT-6 Pro в неделю
— ChatGPT Pro, 200 долларов, x20 лимиты, а также 200 запросов к GPT-6 Pro в неделю

Легко заметить, что 100-долларовая подписка логична: пятикратный рост лимитов плюс GPT-6 Pro, которая, кстати, при грамотном промптинге тянет сложные исследовательские задачи.

А на 200-долларовой экономика не сходится: цена вдвое выше, лимиты вчетверо. Любая подписка дает больше, чем те же деньги в API, а компании отбивают разницу тем, что далеко не все выбирают недельный лимит до конца.

Еще в январе 2025-го Альтман признавал, что OpenAI теряет деньги на Pro за $200. Не прикрывали, как мне кажется, потому что это был отличный инструмент: продвинутые пользователи своими экспериментами подогревали интерес к ИИ. Но GPT-6 Astra оказалась такой универсальной и простой в работе, что подписки стали расходиться как горячие пирожки.

В итоге OpenAI на некоторое время прекратила продажи 200-долларовой Pro, как наименее выгодной для себя подписки, а теперь вернула, с пересчитанной экономикой. Коснется ли пересчет старых подписчиков, Тибо пока не ответил.

Для бизнеса логично, для пользователей – грабеж. Причем ситуация усугубляется тем, что GPT-6 Astra стоит в два раза дороже GPT-5.6 Sol, бывшей ранее основной моделью – то есть новинка принесла не только новые возможности, но и двукратное сокращение лимитов использования. А теперь их сокращают еще в два раза.

По идее, исправить ситуацию должны были GPT-6 Sol & Luna с ценой в 2,5 и 10 раз ниже. Но это какие-то совсем стремные модели, я не знаю почти никого, кто ими пользуется, а сам когда пробовал – остался недоволен результатом. Такое впечатление, что даже GPT-5.6 Sol была лучше.

С другой стороны у нас Anthropic с Claude Opus 5.5, которая стоит в 2,5 раза дешевле GPT-6 Astra, а по бенчмаркам идет вровень и даже местами лучше. И еще более дешевая Claude Sonnet 5.5 – я ее вчера гонял весь вечер, и это отличная рабочая лошадка для повседневных задач, то, чем не стали GPT-6 Sol & Luna.

Понятно, почему этот раунд уходит к Anthropic. У меня сейчас две 100-долларовые подписки: Claude Max x5 и ChatGPT Pro Lite. После выхода Opus 5.5 я в основном пользуюсь Claude, при этом подписка выглядит вообще безлимитной (отмечу, что у меня мало задач с субагентами – там лимиты уходят быстрее). В ChatGPT Pro оставил буквально несколько задач на GPT-6 Astra – и даже они с трудом умещаются в недельный лимит.

Однако в анонсе Тибо Сотьо есть одна ремарка, которую многие пропустили – на DevDay компания планирует добавить в Pro-подписки некие новые функции, которые не будут тратить текущие лимиты. Самая логичная ставка – новый постоянно работающий агент “o” (по последним данным, официальное название будет dots – точки) со своей квотой использования.

Так что ждем DevDay – я очень надеюсь, что OpenAI выпустит что-то реально крутое, чем скомпенсирует текущие провалы. А то с выхода Opus 5.5 прошла целая неделя, модель классная, но хочется новых игрушек (ну и разбаловала нас ИИ-индустрия!).

—
Кстати, у меня есть лонгрид про то, как расходовать лимиты и токены экономно. Пока писал этот пост, обновил лонгрид с помощью Opus 5.5 под новые модели и настройки – самое время ознакомиться!

— Читать на “Бусти”
— Читать на Sponsr


Claude Sonnet 5.5 – OpenAI, держи подарок на DevDay!

Anthropic выпустила Claude Sonnet 5.5 – модель, которая в офисной и агентной работе почти догнала флагманский Opus 5.5, а стоит вдвое дешевле. По цене она ровно такая же, как свежая GPT-6 Sol, вот только новинка возит “Сол” мордой по полу: в отчетах, таблицах, презентациях и автоматизации рабочих процессов отрыв такой, что даже стыдно говорить. В коде они примерно на равных. Для повседневной работы получилась отличная рабочая лошадка – и это очень неприятная новость для OpenAI, у которой в итоге конкурентоспособна только GPT-6 Astra по цене в крыло самолета.

В английском есть словосочетание party pooper – человек, который подгаживает на вечеринках (это я вежливо перевел). Anthropic носит этот титул с гордостью и портит праздник раз за разом одним и тем же людям. В прошлый вторник OpenAI представила GPT-6 Sol и Luna, а за полтора часа до этого Anthropic выкатила Opus 5.5. В этот вторник у OpenAI DevDay – одно из главных событий года, к которому компания несколько дней разогревала публику. Anthropic ответила за день: выкатив модель, которая станет любимой рабочей лошадкой миллионов.

“Почти Opus 5.5” – вовсе не реклама. В документах и таблицах, управлении компьютером, задачах в терминале, автоматизации и медицинских вопросах Sonnet 5.5 идет вровень с флагманом, а местами даже обходит.

Отстает Sonnet в предсказуемых ситуациях. В Humanity’s Last Exam разрыв с Opus – 7,5 пункта, а с инструментами он сжимается до трех – это бенчмарк на размер модели, тут все логично. На задачах с по-настоящему длинным контекстом Sonnet 5.5 едва ушел от прошлой версии и уступает Opus больше 11 пунктов. Anthropic и сама признает: на сложной открытой работе, где нужно долго держать суждение, Opus заметно сильнее.

“Размер” модели бенчмарки вообще ловят плохо, а на практике он чувствуется. Иерархия у Anthropic простая: Fable 5.1 > Opus 5.5 > Sonnet 5.5. Я пишу посты с Opus 5.5 как со вторым пилотом: собрать контекст, покритиковать идеи, сложить факты и мысли в план – тут он хорош. 

Но бывают случаи, когда кусок поста не складывается – и я отдаю черновик в чат с задачей накидать неожиданные углы или поискать логические связки, которые я не замечаю. Opus обычно отвечает банальщиной, а Fable нередко подкидывает идеи, с которыми можно работать. Sonnet 5.5, полагаю, вообще будет не про это.

Из хорошего – с “творческим вкусом” у Sonnet 5.5 все хорошо, модель унаследовала это качество у Opus 5.5. 

Например, вот HTML-артефакт с описанием “еретической” научной идеи, которая скоро может стать мейнстримом. Модель работала чуть больше трех минут.

Видео в начале поста – это я попросил Sonnet 5.5 сделать с помощью кода озвученный ролик о самом себе. Как раз такие видео в последние дни стали визитной карточкой Claude Opus 5.5 – здесь видно, что работала модель классом пониже, но справилась.

Кому подойдет Sonnet 5.5? Пока вижу так. Если вы на 20-долларовой подписке Pro, то пробуйте как основную модель, пока по бенчмаркам и первым работам она вполне тянет большинство повседневных задач. Opus 5.5 используйте для планирования, проверки результатов, ну или если видите, что Sonnet 5.5 не вывозит – иначе не хватит лимитов.

На Max–планах сейчас с лимитами все хорошо – Opus 5.5 у меня работает днями даже на 100-долларовом варианте. Так что Sonnet 5.5 здесь скорее для скорости: повседневные вопросы, быстрый поиск в сети, субагенты в Claude Code для небольших задач.

Ну и ждем, чем ответит завтра OpenAI. Ходят слухи, что новая модель на DevDay все-таки появится – если да, то скорее всего это будет или GPT-6.1 или GPT-6 Aeon, дообученная для долгих автономных задач (на DevDay компания покажет нового ИИ-агента “o”, способного работать очень долго).

А вот бюджетный рынок OpenAI пока уступает: я и раньше мало кого видел, кто пользовался новыми GPT-6 Sol & Luna, теперь же в этом вообще нет смысла при наличии куда лучшего Sonnet 5.5.
—
Несколько часов назад я собрал из своих текстов мини-курс, как эффективно использовать последние модели Anthropic и OpenAI. Для Sonnet 5.5 он тоже подойдет, не пропустите.


Наберусь смелости и предположу, что GPT-6 Astra и Claude Opus 5.5 мы запомним “поворотными” моделями, какими в свое время были GPT-4, OpenAI o1 и Opus 4.5. Новинки выросли в бенчмарках, научились отлично работать с интерфейсами и сложным визуалом, но главное даже не это – у них появились зачатки того, что можно назвать “творческим вкусом”, когда модели пытаются не просто завершить задачу, а выполнить ее красиво, так, чтобы зацепить пользователя.

Я с любопытством слежу, как каждый день люди придумывают с этими моделями что-то новое: мультфильмы, где каждый кадр и звук сделан кодом, 3D-гонки по одной фразе. Еще полгода назад это казалось бы фантастикой.

Но как выжимать максимум из них самому? Я собрал подборку текстов из подписки о том, как получить от Claude Opus 5.5 (и Fable 5.1) и GPT-6 Astra все, на что они способны. Старые тексты я обновил под новинки, а помогал мне в этом все тот же Opus 5.5 – так что за “творческий вкус” можете не переживать.

Читать лучше в таком порядке:

1️⃣ Системный промпт на примере Claude Opus / Fable

Что происходит с моделью до того, как она начнет вам отвечать. В обновлении – что Anthropic поменяла в поведении Fable 5.1 и Opus 5.5 и как настроить их ответы под себя.

2️⃣ Как правильно писать пользовательский промпт и управлять памятью ИИ о вас

Что класть в пользовательские инструкции, а что – в проект или скилл, и как за десять минут в месяц чистить память модели о себе.

3️⃣ Промпты в 2026 году: что работает, что нет и зачем вообще стараться

Базовая схема промпта. В обновлении из нее ушли два блока, которые новым моделям только мешают.

‼️ 80% инструкций – в мусор! Как теперь пишут промпты в OpenAI и Anthropic

Если у вас накопились промпты, скиллы и файлы вроде CLAUDE.md – начинайте прямо с этого текста. Он про промпт-долг: инструкции, которые пережили модель, под которую их писали, и теперь ей мешают.

4️⃣ Руководство по GPT-6 и Claude Fable 5.1

Разбор возможностей новых моделей, а также их "привычек" – полезных и тех, которые лучше исправить.

5️⃣ Уровень GPT-6 – и в разы дешевле. Самый подробный гайд по Claude Opus 5.5

Как настроить Opus 5.5, где он пока слабее конкурентов и как самому сделать мультфильм или 3D-сцену кодом – с готовыми промптами.

В двух последних текстах много примеров новых умений моделей: на самом деле, они переносимы – то, что разбирал под GPT-6 Astra, можно попробовать с Opus 5.5, и наоборот.

Всего в подписке на сегодня 30+ полезных лонгридов, а все тексты доступны на двух площадках, выбирайте любую:

— Читать на “Бусти”
— Читать на Sponsr


Кто вздрагивает от суперинтеллекта?

Сцена, которую видел почти каждый. 23 сентября, авиабаза Эндрюс под Вашингтоном, бок о бок стоят лидеры двух крупнейших держав. Над ними проходят два бомбардировщика B-1. Си остается невозмутим, Трамп отдает честь и вздрагивает. “Это было очень громко”, — говорит он Си. Тот молчит. 

Испуг это был или восторг, судить не берусь: я видел проход B-1 на МАКС-2005 – это действительно впечатляющая и громкая машина. Но важно другое: сцена точно описывает и переговоры по ИИ, и их результаты.

Началось все с курьеза: переговоры не про ИИ, а про “суперинтеллект”. Этот термин Трамп употребил 22 сентября на Генассамблее ООН, где объявил, что Америка отвергает любой международный контроль над ИИ, а во всех ее документах “искусственный” интеллект станет “супер”. После переговоров Белый дом сообщил, что Си с новым названием согласился.

МИД Китая через два дня тактично ответил: уважаем выбор американских коллег, но сами продолжим говорить “ИИ”.

Достигли ли США “суперинтеллекта” в том виде, как его видит Трамп, вопрос открытый. Но то, что американский ИИ сейчас самый шумный – это факт. Летом агенты OpenAI сами взломали Hugging Face, главную площадку открытых моделей. 20 сентября агент той же OpenAI выбрался из песочницы и достучался до внешнего чат-бота. Anthropic и Google подтверждают аналогичные инциденты со своими ИИ-агентами, пусть и меньшего масштаба.

В итоге за полтора месяца OpenAI дважды ставила обучение новых моделей на паузу. А 12 сентября глава Anthropic Дарио Амодеи призвал отрасль сбавить темп, и Альтман с Маском его поддержали.

Тормозить их никто не заставлял: лаборатории вздрагивают сами, потому что ближе всех к новой технологии. А Трамп, так выразительно поморщившийся на Эндрюс, в разговоре об ИИ вздрагивать как раз отказывается.

Отрыв от Китая Трамп оценил сам: “минимум год, может, полтора, некоторые говорят два”. Из этой цифры каждый делает свой вывод. Трамп видит в (ИИ) суперинтеллекте главный инструмент американского преимущества и сдавать его не хочет. Представители лабораторий могут считать, что раз есть запас, то можно и притормозить, занявшись безопасностью. О выгоде Китая – чуть позже.

При этом единственное, о чем по ИИ договорились на саммите, – создать канал связи на случай ИИ-инцидентов и продолжить договариваться (новый раунд в ноябре, уже на уровне чиновников). А 27 сентября Трамп сказал Fox, что инциденты с моделями его “не беспокоят” – получается, что создали канал связи и тут же включили режим “не беспокоить”.

27 сентября произошло еще одно интересное событие – Трамп поужинал один на один с Дарио Амодеи, тем самым “ангелочком”, на которого он набросился в соцсетях две недели назад. О чем говорили за ужином, не раскрывается. Но разговор был не из простых.

Напомню, именно Амодеи стал самым громким голосом за торможение. При этом у правительства с Anthropic очень натянутые отношения – накануне разговора апелляционный суд оставил в силе запрет на использование моделей компании американскими военными.

Тормоз сейчас в руках самих компаний – власти это понимают, и ужин явно попытка что-то с этим сделать.

И еще про позицию Китая. Си в Белом доме говорил правильные слова: ИИ под контролем человека, здоровая конкуренция в рамках, кризисный канал для военных. 

Эта позиция выглядит очень здраво и, вероятно, близко для пользователя: китайские модели выходят по расписанию, они открыты и более доступны, а сами разработчики говорят о справедливом использовании ИИ. Но будем честными – такая позиция удобна, когда ты второй.

Лидерство Китая внезапно в другом – несмотря на объявленную открытость, их лаборатории намного проще контролировать. А вот лаборатории США пока что жмут на тормоз раздельно, с оглядкой друг на друга – и при президенте, который хочет жать на газ.

—
В подписке я рассказываю, как выжимать из ИИ максимум. Уже 30+ лонгридов, в том числе – подробное руководство по открытым моделям, как в них разбираться и как запускать.

— Читать на “Бусти”
— Читать на Sponsr


29 сентября OpenAI проведет DevDay 2026, одно из своих главных мероприятий

Старт в 20:00 по Москве. Сэм Альтман и Тибо Сотьо неделями обещали самый насыщенный DevDay по анонсам, но праздник OpenAI может серьезно подпортить одна штука.

Но давайте отложим ее в конец поста, а пока пройдемся по слухам насчет DevDay.

Главным анонсом почти наверняка станет “o” – новый ИИ-ассистент компании: его возможный логотип OpenAI уже засветила в одном из своих X-аккаунтов.

Еще в феврале OpenAI забрала в команду Codexсоздателя OpenClaw Петера Штайнбергера, и он сформулировал задачу так: агент, которым сможет пользоваться даже его мама.

Позже в файлах Codex нашли persistent_mode – режим, в котором агент сам ставит себе цели и ведет задачу до максимально полного результата, возвращаясь к пользователю со сводками и уточнениями.

Простой пример – начиная работу над этим постом, я попросил GPT-6 Astra собрать все утечки о Claude Sonnet 5.5 (упс, кажется я слил содержимое заключительной части поста). Астра отработала очень качественно (модели OpenAI традиционно хороши в веб-поиске), вернулась со сводкой и – все.

В persistent_mode такая сводка будет лишь первым этапом работы агента: поняв мой интерес к будущему Sonnet 5.5, он поставит задачу на мониторинг и продолжит возвращаться с обновлениями.

Или созвон в Zoom: кто-то подтвердил участие, кто-то думает, кто-то в отпуске и обещал прислать замену. Ассистент будет следить за этим в развитии, обновлять план и предлагать решения.

Удобно, но есть минус – расход токенов. Уже сейчас, отдавая задачу в ChatGPT Work, я не могу предсказать, сколько лимита она съест, а агент с несколькими долгими задачами параллельно будет жечь недельную квоту еще быстрее.

Судя по утечке, «o» появится в Pro-подписках — начиная со 100-долларовой. Их ассортимент, кстати, тоже расширят.

Базовой останется 100-долларовая ChatGPT Pro – у меня самого такая и честно говоря, в последнее время она ощущается заменой 20-долларовой ChatGPT Plus двухлетней давности.

Должна вернуться 200-долларовая версия. Раньше она за двойную цену давала вчетверо больше лимитов, чем 100-долларовая Pro, это ударило по экономике компании, и подписку прикрыли. В новой версии бонус могут урезать, хотя подтверждений пока нет.

Ну а венцом всего этого будет 500-долларовая ChatGPT Pro Max (боже, ну почему это название?!) с максимумом лимитов и дополнительных возможностей. Именно ее лимитов хватит на полноценное использование нового агента, а также режимов с повышенной скоростью генерации ответа.

Теперь дело за малым – убедить пользователей перейти на подписки по цене крыла самолета.

Если ранее модели OpenAI обычно были выгоднее Anthropic, то сейчас сложилась противоположная ситуация. GPT-6 Astra хороша, но стоит в два раза больше, быстро высаживая даже лимиты Pro-подписок.

Бюджетные GPT-6 Sol и Luna вообще не впечатлили – есть ощущение, что это не удешевленная архитектура GPT-6, а попытка выжать максимум из GPT-5.6. И я вообще не вижу, чтобы кто-то пользовался этими моделями.

С другой стороны – Anthropic с совершенно неожиданной Opus 5.5, которая работает даже лучше Astra (как минимум, в задачах массового пользователя), но стоит в 2,5 раза дешевле. 

Это уже сильный аргумент, но прямо сейчас, по данным инсайдеров, идет тестирование Sonnet 5.5, цена на которую ожидается в два раза дешевле. А результаты работы, которые я видел, не сильно хуже Opus 5.5 – как минимум, в визуальных задачах.

Ответить OpenAI нечем. После того как 20 сентября агент сбежал из песочницы через DNS-запросы, компания заморозила не только обучение, но и оценку и любые запуски с инструментами своих самых сильных моделей – отчет вышел 25-го, срока снятия нет. Даже если следующая Astra уже обучена, выпустить ее сейчас невозможно.

—
В подписке у меня уже 30+ лонгридов о том, как использовать ИИ по-максимуму. Если вы заинтересовались ИИ-асисстентами, вроде будущего СhatGPT o и уже существующих OpenClaw и Hermes, то обратите внимание на лонгрид “Промпт, проверка, повтор” про то, как запускать эффективные циклы на ИИ-агентах.

— Читать на “Бусти
— Читать на Sponsr


Вы не поверите, но OpenAI опять остановила обучение своих моделей. Причина – одна из них тайком попросила подсказку у другого ИИ

OpenAI во второй раз за полтора месяца остановила работу над фронтирными моделями. Под паузу попали обучение, тестирование и любые задачи, где модель пользуется инструментами. Возобновят обучение только после того, как компания укрепит защиту и убедится в ее надежности.

Поводом на этот раз стал эпизод 20 сентября, когда внутренняя модель получила на обучении простую задачу: по подсказкам из чужого блога выяснить, кто его автор. Найти не получилось, но модель не сдалась: нашла дырку в песочнице, выбралась в интернет, а затем… задала вопрос одному из публичных чат-ботов (какому – не раскрывается).

Потрясающая метаирония: ИИ попросил другой ИИ сделать за него домашку.

Интересно, как модель пришла к этой идеи: пытаясь дать ответ, она упрямо перебирала все доступные ей варианты. Собственный поисковый инструмент OpenAI отдал мусор поэтому модель попробовала обратиться к обычным поисковикам напрямую – но ее не пустили. Тогда она решила, что задача взята из известного публичного теста, скачала его из офлайн-копии интернет-данных и стала искать там свой вопрос вместе с ответом. Догадка оказалась неверной. После этого модель взялась проверять собственную песочницу и обнаружила, что служба, которая переводит названия сайтов в адреса (DNS), отвечает по-настоящему. Через нее она и протянула канал к чат-боту.

Забавно, что начала она с проверки на вшивость – спросила столицу Франции и, получив верный ответ, перешла к делу.

Впрочем, “коллега” тоже не справился с задачей – после этого модель сдалась, признала, что автора не установить и попросила подсказок получше.

Инцидент довольно невинный, так что OpenAI, похоже, больше обеспокоена поведением своей системы безопасности. Ее серьезно укрепили после летних, куда более тяжелых инцидентов с агентами, но не помогло: система слежения заметила неладное через 12 минут, человек подключился еще через три, однако сам прогон остановили только через два с половиной часа. Автоматическое отключение не сработало, и какое-то время никто не понимал, нужно ли гасить процесс вручную.

Подобный “звонок другу” – не новость. Группа независимых исследователей раскрыла новые подробности летнего взлома Hugging Face агентами OpenAI, и там интересны две детали.

Первая – как вообще агенты выбрались наружу. Полного доступа в сеть у них не было: они могли только открывать страницы, но не отправлять данные. Тогда агенты стали прятать куски своих программ в адреса коротких ссылок, а сами ссылки скармливать сервису, который делает скриншоты сайтов.

Чтобы сфотографировать страницу, такой сервис полностью открывает ее у себя и выполняет весь код – вот чужими руками агенты свой код и запускали. Ответ им возвращали тем же способом: превращали в сетку точек на картинке и считывали обратно. Таких ссылок они наплодили почти миллион.

Вторая – именно тот самый звонок к другу. Напомню, что рой ИИ-агентов тогда пытался пройти бенчмарк по кибербезопасности – но у моделей до последнего не было уверенности, засчитают ли их ответы. Тогда они начали обращаться ко всем доступным чат-ботам, с просьбой оценить ответы: отчет перечисляет DeepSeek, Kimi, Qwen и Claude, но не уточняет, были ли эти попытки успешными.

Общее в этих историях – целеустремленность моделей. В августе OpenAI уже укрепляла системы безопасности – в ответ модель нашла новые лазейки. Компания пишет, что уже тестирует еще более мощные барьеры, но почему-то я уверен, что и в них найдутся дырки.

Куда более надежное решение – объяснить будущим моделям, что такое хорошо, а что такое плохо, не уронив эффективность. OpenAI обещает заняться и этим, но признает: за такое поведение модель уже штрафовали при обучении – не помогло. Давайте признаем: даже у живых людей есть разные мнения на этот счет – так что задача не из легких.

—
У меня уже вышло 30+ текстов про то, как выжимать из ИИ максимум. Среди них – “лестница” создателя Claude Code, рассказывающая, как перейти на новый уровень использования ИИ всего за 1-2 вечера.

— Читать на “Бусти”
— Читать на Sponsr


Создатель Ruby on Rails назвал свой любимый язык программирования. Это – английский

Дэвид Хайнемайер Ханссон, известный как DHH, больше двадцати лет назад создал Ruby on Rails – набор готовых заготовок для сайтов на языке Ruby. На нем выросли GitHub и Shopify.

23 сентября DHH открыл конференцию Rails World в Остине и сказал со сцены, что английский нравится ему больше, чем Ruby. Там же он объявил, что ушел на пенсию – но только как программист, который пишет код руками.

Еще летом 2025 года DHH говорил обратное. В подкасте с Лексом Фридманом он объяснял, что радость для него – самому набирать код. Отдать код ИИ значило бы стать “менеджером стаи ИИ-ворон”.

Через полгода DHH передумал – он написал, что сопротивлялся из-за слабых моделей, а теперь все перевернулось. Набирать код руками стало для него утомительной рутиной. А взгляды на ИИ-программирование перевернул Claude Opus 4.5, вышедший 24 ноября 2025 года – отмечу, что многие называют эту модель “переломом”.

Двадцать лет подряд DHH писал около 30 тысяч строк кода в год. Теперь же за один август вместе с агентами выдал 150 тысяч. Свое нынешнее состояние он описал как ИИ-эйфорию.

Эйфория DHH стала правилом для всей 37signals – небольшой компании, где он технический директор и совладелец. Она делает сервис для управления проектами Basecamp и почтовый сервис HEY. Писать код руками там больше не принято: если пришлось, это считается таким же сбоем, как ошибка в работе сервиса. Чинить в таком случае нужно настройку агентов.

Прямо на на выступлении DHH спросил зал, кто до сих пор пишет заметные объемы кода руками. 

В зале на 1200 человек поднялось от силы пять рук.

Сейчас HEY пересобирают целиком: вместо веб-приложения будут шесть отдельных приложений под разные устройства. Еще год назад маленькой компании это было не по силам, теперь стало возможным благодаря ИИ-агентам.

Забавно, что DHH прославился благодаря Ruby on Rails – набору заготовок для языка, который легко читать человеку. Теперь же сервер HEY переписывают на Rust – людям на нем, наоборот, трудно и читать, и писать, но зато он быстрый и “удобный” для компьютера.

А сам DHH вообще не знает Rust – и считает это плюсом, так как может оценить результат снаружи, как заказчик. По оценке самой компании, новый сервер тратит на 99% меньше процессора и на 95% меньше памяти. Но дело не только в языке, а еще в том, что часть работы сервера теперь делают сами приложения.

Значит ли переход на ИИ-агентов гибель “человеческих” языков? Я бы не стал делать прогнозы, но сам DHH пока не хоронит Rails. Rust взяли только для сервера почтового сервиса, а не вместо Rails везде. Сайты же останутся актуальны для сервисов, которыми люди пользуются эпизодически. И здесь Ruby on Rails работает хорошо – причем набор правил помогает и ИИ-агентам, отвечающим за код.

А больше всего в выступлении DHH меня зацепила история его прапрадеда – датского художника Лауритса Туксена – и зацепила с неожиданной стороны. 

Туксен как-то три года писал один королевский портрет. А потом появилась дешевая камера Kodak Brownie, и сейчас люди делают около двух триллионов снимков в год. Opus 4.5 DHH называет “Кодаком нашей эры”...

…но Kodak Brownie не сделал миллионы людей фотографами. С ним запечатлеть изображение смог любой, но умение видеть кадр из ремесла никуда не делось – оно переехало из руки в глаз.

То же самое и с “Кодаком нашей эры”. Язык программирования теперь может быть английский, русский или какой вам вздумается. Но навык – останется вашим. Сам DHH – заказчик с двадцатью годами профессионального вкуса. Он точно знает, каким должен быть HEY и что такое плохой сервер.

Программирование не станет автоматически доступным всем, кто говорит с ИИ на одном языке; оно станет доступным тем, кто умеет точно сказать, чего хочет, и понять, что получил.

А если не умеет – то готов этому учиться.
—
Напоминаю, что сегодня у меня вышел самый подробный русскоязычный гайд по Claude Opus 5.5. В нем я учу говорить с этой моделью на одном языке, а также показываю, какие новые штуки с ее помощью можно сделать.

— Читать на “Бусти”
— Читать на Sponsr


Сразу после выхода Claude Opus 5.5 во вторник я решил написать небольшой лонгрид о том, как Anthropic рекомендует промптить эту модель – и не догадывался, на какой гемморой подписался. В итоге за два дня плотной работы текст вырос до 40+ тысяч знаков – пожалуй, это самый подробный русскоязычный гайд по Opus 5.5:

Уровень GPT-6 – и в разы дешевле. Самый подробный гайд по Claude Opus 5.5

Из текста вы узнаете:

— как правильно промптить эту модель, что добавить в пользовательские инструкции и CLAUDE.md (а что – убрать).
— какой режим рассуждений использовать, чтобы не прогореть по токенам (я проверил на 48 прогонах).
— как создавать нашумевшие JavaScript-ролики и озвучивать их с помощью Gemini 3.8 Flash TTS или локальной модели. Идеально для учебы, рекламы, маркетинга и многого другого.
— как рисовать 3D-сцены в Blender, работать с графиками, презентациями и многое другое.

А бонусом расскажу вам историю, как Opus 5.5 написал пост на этот канал, а вы поставили ему больше лайков, чем мне.

Это невероятная модель, при работе с которой у меня появляются новые идеи чуть ли не каждый час. Но текст подойдет не только тем, кто работает с Opus 5.5 – многие описанные трюки подходят и для GPT-6 Astra. Так что бегом читать:

— Читать на “Бусти”
— Читать на Sponsr

Показано 20 последних публикаций.