


Большие языковые модели уже давно умеют переводить, писать тексты и выполнять множество задач, которые принято рассматривать как интеллектуальную «рутину». Но сегодня они постепенно входят в области, которые ещё недавно считались специфически человеческими: создают художественные тексты, демонстрируют способность к метаязыковым суждениям, а с появлением мультимодальных моделей получают возможность работать не только с текстом, но и с визуальной информацией.
О том, как эти изменения заставляют заново задавать вопросы о языке и культуре, — в главе Анастасии Владимировны Колмогоровой, заведующей Лабораторией языковой конвергенции НИУ ВШЭ — Санкт-Петербург, в коллективной междисциплинарной монографии «Генеративные агенты — новые участники социальных коммуникаций: как “голоса без тел” трансформируют коммуникативный порядок?», которая публикуется по итогам Всероссийского онлайн-форума «Connect Universum — 2026», организованного кафедрой социальных коммуникаций факультета психологии ТГУ.
В главе описываются результаты уникального эксперимента, направленного на сопоставление описаний произведений искусства, созданных 100 информантами, и описаний, полученных с помощью мультимодальной языковой модели. Такой материал позволяет по-новому посмотреть на то, что именно человек делает, когда «просто описывает то, что видит», и что происходит, когда эту задачу получает модель.
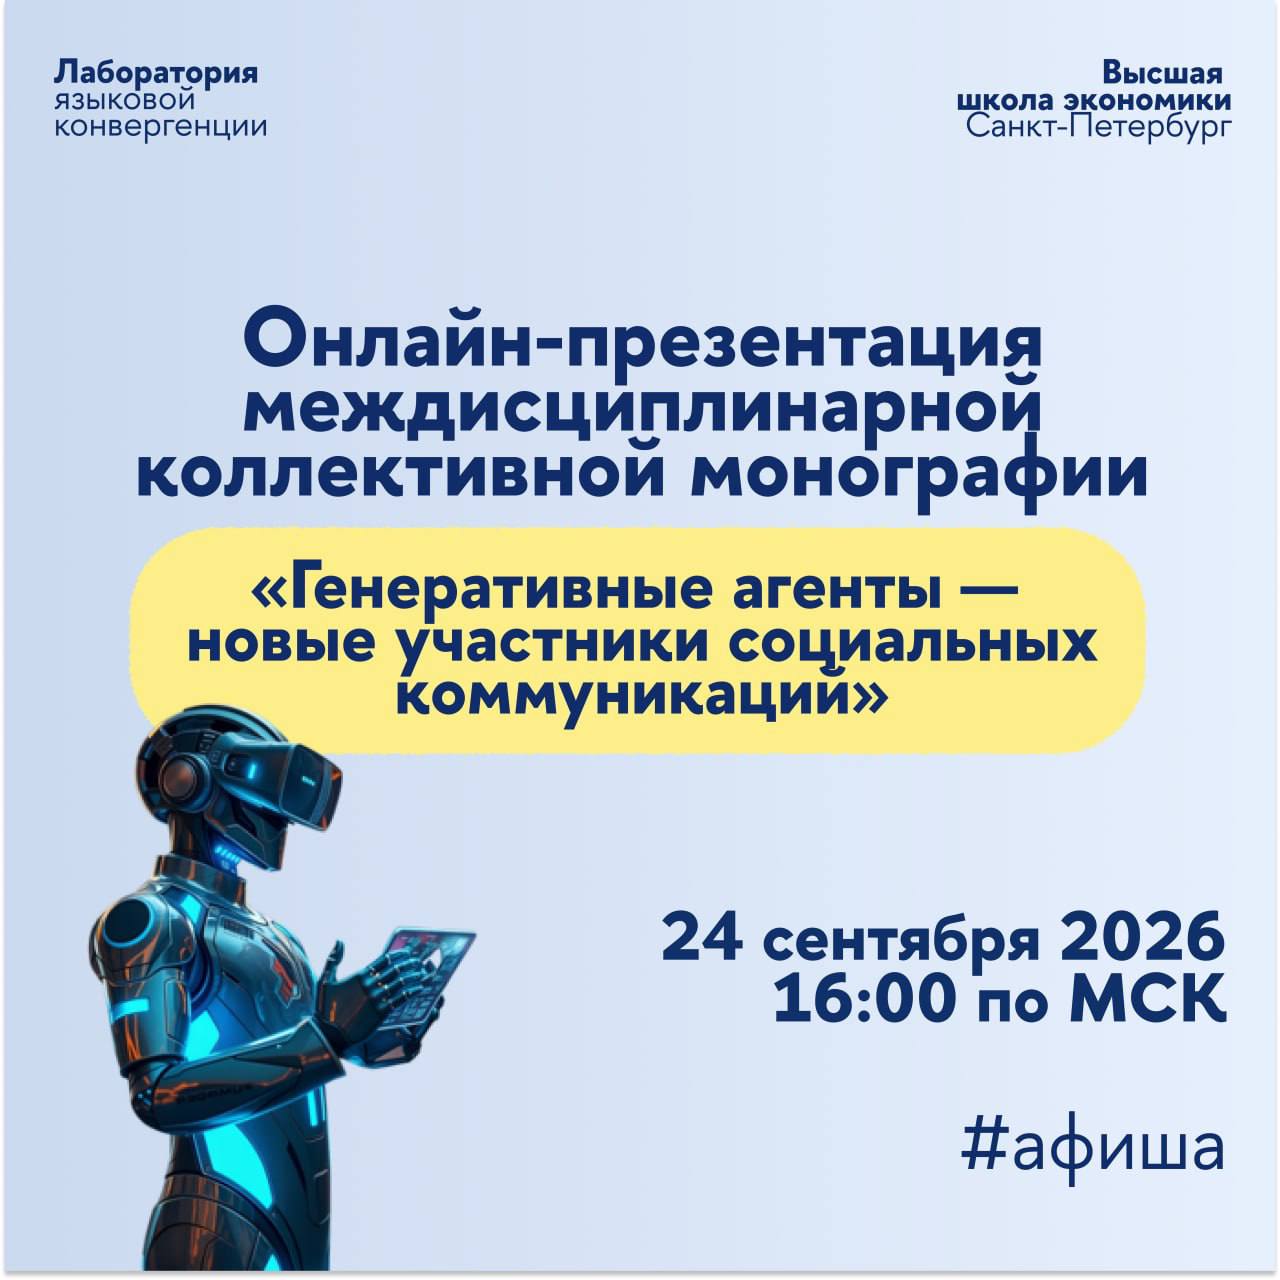
📚 24 сентября в 16:00 (МСК) состоится онлайн-презентация монографии.
📍 Подключиться можно по ссылке.
Приглашаем всех, кому интересно, как появление генеративных агентов меняет наши представления о языке, восприятии и коммуникации. Все участники презентации получат доступ к бесплатному скачиванию монографии в день мероприятия.