Мониторим ИТ


Гео и язык канала: Россия, Русский
Категория: Технологии


Канал о наблюдаемости (Observability): логи, трейсы, метрики.
Реклама: @gals_ad_bot
Вопросы: @antoniusfirst
@usr_bin_linux — Linux
@zabbix_ru — Zabbix
@elasticstack_ru — ElasticSearch/OpenSearch

Связанные каналы  |  Похожие каналы

Гео и язык канала
Россия, Русский
Категория
Технологии
Статистика
Фильтр публикаций


🤖 OPS Talk by Sber: узнай, как AI меняет сопровождение

Собираем инженеров сопровождения, SRE и DevOps, чтобы обсудить, что реально происходит с AI в эксплуатации и какие практики у нас есть уже сегодня.

Вместе со спикерами из Сбера, Т-Банка и СберТеха поговорим про:

🔘AutoHealing и автоматический откат релизов;
🔘AI-агент в observability, который вырос до 10k пользователей;
🔘DB Advisor в PV Kintsugi, или как организовать работу с моделью, чтобы её ошибка не становилась решением инженера;

А еще пообщаемся в непринужденной обстановке после деловой части.

Сбор 19 октября в 18:00 на welcome-кофе
Офис Сбера на Кутузовском 32 + онлайн

Регистрируйся, пока места ещё есть!


Как связать трейсы и логи без изменений в коде приложения

OpenTelemetry eBPF Instrumentation — OBI — научился автоматически добавлять trace_id и span_id в существующие логи контейнеров. Не нужно подключать SDK, настраивать библиотеку логирования, пересобирать или повторно развёртывать приложение.

OBI через eBPF определяет, какой запрос в данный момент обрабатывает поток, и дополняет связанные с ним записи. Это работает с JSON, NDJSON и обычным текстом: из трейса можно сразу перейти к нужным логам, а из подозрительной записи — найти соответствующий трейс.

Но есть ограничения: обогащаются только логи из stdout и stderr, необходим активный trace-контекст, CAP_SYS_ADMIN и подходящая версия ядра.

В статье в блоге OpenTelemetry показаны принцип работы, конфигурация OBI и схема внедрения.

Читать статью

📱 Telegram | 📲 MAX


🛠 OpsDeck — рабочее место DevOps-инженера в одном приложении

Если рабочий день начинается с открытия терминала, Lens, Grafana, Argo CD, GitLab, DBeaver, KeePass и Obsidian, OpsDeck говорит, дружок, а давай соберем всё это в одном окне.

Внутри — терминал с блоками команд и AI-панелью, управление Kubernetes и Helm, просмотр алертов Grafana и Alertmanager, клиенты для популярных баз данных, встроенная IDE с Git, SSH-профили, KeePass, Markdown-заметки и сетевые инструменты.

Для продовых кластеров и баз предусмотрен режим «только чтение», а локальная модель Qwen умеет предлагать команды с учётом заметок и истории пользователя.

Приложение написано на Rust и Tauri 2, работает в Linux, Windows и macOS. Проект только недавно закоммтили в репозиторий.

Идея выглядит интересно, но заменять привычные инструменты на нечто выглядит сомнительно.

Репыч на Гитхабе →

Обзор со скриншотами на Хабре →

📱 Telegram | 📲 MAX


📊 Metabase — аналитика observability-данных без барьера в виде SQL (подойдет, когда вас просят то, не знаю что)

Metabase — open source BI-платформа, которая позволяет подключить базу данных и быстро собрать интерактивные графики, отчёты и дашборды. Бизнес-пользователи могут исследовать данные через визуальный конструктор, а аналитики — писать сложные запросы во встроенном SQL-редакторе.

Платформа поддерживает фильтры, автообновление, уведомления при изменении показателей и регулярную отправку отчётов в почту, Slack или через вебхук. Готовые графики и даже целые аналитические интерфейсы можно встроить в собственное приложение.

Базы, которые поддерживаются →

Репыч на Гитхабе →

📱 Telegram | 📲 MAX


Репост из: Zabbix Recipes
🚀 Вышел Zabbix 8.0.0rc1

Первый релиз-кандидат Zabbix 8.0 показывает, каким будет следующий крупный LTS-релиз.

Главный вектор развития — переход от классического мониторинга инфраструктуры к полноценной observability-платформе.

Что нового:

🚀 Поддержка OpenTelemetry — сбор данных через Zabbix Proxy, хранение APM-данных и визуализация распределённых трассировок прямо в интерфейсе Zabbix.

🚀 ClickHouse как хранилище истории — для масштабируемой работы с большими объёмами телеметрии.

🚀 Telemetry query — новый тип элемента данных для запросов к телеметрии.

🚀 Готовые OpenTelemetry-шаблоны для Proxmox, Envoy Proxy и OpenRouter.

🚀 Новый интерфейс — тёмно-синяя тема, обновлённый дизайн и улучшенная доступность.

🚀 Экспорт и импорт дашбордов, новый Scatter plot и доработанные графики.

🚀 Усиление безопасности — API по умолчанию отключён для ролей, добавлена ролевая видимость прокси и поддержка HashiCorp Vault AppRole.

🚀 Новые шаблоны для MariaDB, Percona, GCP, Oracle Cloud и других систем.

Поскольку это RC — пока только постельный режим тестовое окружение.

Полный список изменений Zabbix 8.0.0rc1 →

@zabbix_ru


Tempo 3.1 release: new features for Kafka, TraceQL metrics updates, trace redaction, and more

В новом релизе появились защищённые подключения к Kafka, чтение данных из своей зоны доступности для снижения сетевых расходов и поддержка дополнительных алгоритмов сжатия.

Чувствительные данные теперь можно удалять сразу из нужных трейсов с помощью запроса TraceQL — перечислять каждый trace ID вручную больше не требуется. Метрики TraceQL научились учитывать сэмплирование, а ускоренный путь чтения позволяет выполнять некоторые запросы почти вдвое быстрее.

Кроме того, форматом хранения по умолчанию стал Parquet5, улучшены генератор метрик и карты сервисов, а экспериментальная функция сравнения трейсов помогает искать регрессии между запусками.

Подробнее в блоге Grafana →

📱 Telegram | 📲 MAX


ClickHouse под трейсы: почему шесть бэкендов Jaeger оказались выбором из двух

В документации Jaeger — шесть вариантов бэкенда. Но для облачного сервиса с десятками терабайт телеметрии и сотнями независимых клиентов список быстро сокращается. А решающим требованием становится изоляция данных между проектами.

Команда VK Cloud рассказывает, почему выбрала ClickHouse для Cloud Tracing: чем не подошли Cassandra и Elasticsearch, как устроила поиск трейсов и зачем понадобились собственный приёмник и авторизующий прокси. Отдельно — о компромиссах при отказе от Kafka и о том, что изменила нативная поддержка ClickHouse в Jaeger v2.

Полезный разбор для тех, кто выбирает хранилище телеметрии и хочет заранее оценить не только производительность, но и объём собственной разработки.

Читать статью на Хабре →

📱 Telegram | 📲 MAX


CheckCle

Ещё один проект в копилку мониторинга. CheckCle можно развернуть у себя и собрать в одном интерфейсе проверки доступности, метрики серверов, контроль сертификатов и публичную статус-страницу.

Что умеет:

🚀 Проверять HTTP, DNS, Ping и TCP-сервисы, отслеживать время ответа и историю доступности.

🚀 Выполнять распределённые проверки из разных регионов.

🚀 Следить за сроками действия SSL-сертификатов и доменов.

🚀 Собирать через агент загрузку CPU, потребление RAM, использование дисков и сетевую активность. Поддерживаются Linux и Windows, причём Windows пока в бете.

🚀 Учитывать окна обслуживания, вести историю инцидентов и отправлять уведомления в Telegram, почту, Slack, Discord и Matrix.

Репыч на Гитхаб

P.S. Демо у них отвалилось.

📱 Telegram | 📲 MAX


Coroot: eBPF-профилирование, логи, трейсы в приложениях в kubernetes

Coroot — open-source observability-платформа, которая из метрик, логов и трейсов делает выводы о том, что чинить. Её ключевая особенность — непрерывное профилирование без изменений кода: eBPF-профилировщик снимает CPU-профили всех процессов на ноде, а языковые профилировщики (Go, Java) добавляют память и блокировки. В результате флеймграф показывает нагрузку до точной строки кода, а предустановленные инспекции находят типовые проблемы — утечки памяти, лишние аллокации, блокировки.


Разбор Coroot в статье на Хабре

Репыч Coroot на Гитхаб

📱 Telegram | 📲 MAX


Grafana Alerting: Scale alert routing without scaling complexity using multiple notification policies

В Grafana Alerting появилась полезная штука для тех, у кого одним инстансом пользуются несколько команд.

Исторически маршрутизация уведомлений жила в одном общем дереве. Можно было выделить каждой команде свою ветку, но конфигурация всё равно оставалась общей. Хочешь поменять доставку алертов своего сервиса — правишь дерево, в котором живут и все соседи. С ростом числа команд удовольствие сомнительное.

В Grafana 13.2 в GA появились несколько независимых деревьев notification policies. Теперь можно завести отдельное дерево для команды или сервиса и явно направить в него алерты нужных правил. У каждого дерева — своё управление через UI, API или Terraform.

Самое полезное здесь — возможность раздельно менять и выкатывать настройки маршрутизации. Команда платежей правит свои маршруты, не затрагивая конфигурацию и состояние уведомлений платформенной команды.

Переносить всё разом тоже не требуется: существующие правила продолжат использовать политику по умолчанию, пока им не назначат другую.

Читать в блоге Grafana Labs

P.S. Пишите в комментах кто пользуется Grafana Alerts и какой у вас опыт использования.

📱 Telegram | 📲 MAX


Залил на Medium английский перевод своей статьи про дедупликацию сообщений на стороне лог-шипперов. Оригинал можете почитать на Хабре.

В предыдущий раз я там писал примерно шесть с половиной лет назад — про то, как я ходил на офлайн-тренинг «Слёрм DevOps». Небольшой такой перерыв. Раньше я писал на Medium только по-русски, теперь буду по-английски.

Меня крайне огорчил их редактор статей. Для просто текста с картинками норм, но для технической статьи с конфигами все катастрофически раздражает.

На Хабре прямо в редакторе есть таблицы, блоки кода с выбором языка и нумерацией строк, формулы и спойлеры, под которые можно убрать длинный конфиг. Самый кайф, что можно вставить подготовленный Markdown или вообще переключиться в Markdown-режим.

У Medium нельзя вставить md напрямую, он просто его корректно не распознает. Таблицы они предлагают вклеивать через внешний сервис. Когда хочется простого добавить строки и столбцы в статью приходится идти и ковертировать md-таблицу в картинку. Если это не фиаско, братан, то близко к этому.

Если у вас есть там аккаунт, подписывайтесь на мой и нахлопайте там хорошо в ладоши (аналог лайков).


Pandora FMS — замена ушедших PRTG, WhatsUp Gold и SolarWinds

🔥 Проверенная временем платформа мониторинга, доступная для использования в России . Более 20 лет на рынке.

📅 30 сентября в 10:00 МСК приглашаем на бесплатный вебинар по Pandora FMS, где мы проведем презентацию возможностей платформы для мониторинга IT-инфраструктуры.

Если вы используете (или использовали) PRTG, WhatsUp Gold или SolarWinds и рассматриваете альтернативные решения для мониторинга IT-инфраструктуры — приходите на вебинар.

В рамках встречи Александр Тварадзе, представитель Pandora FMS, проведёт презентацию платформы и расскажет о её возможностях.

Разберём:

🚀 мониторинг сетевой инфраструктуры и оборудования;

🚀 серверы, приложения и базы данных;

🚀 мониторинг SCADA-систем и промышленной инфраструктуры;

🚀 сбор логов и работу с событиями;

🚀 виртуализацию и облачные среды;

🚀 инвентаризацию IT-инфраструктуры и интеграцию с CMDB;

🚀 встроенный Service Desk и управление заявками;

🚀 оповещения, отчёты и панели мониторинга;

🚀 автоматизацию и интеграции через API;

🚀 распределённый мониторинг и масштабирование;

🚀 возможности Pandora FMS для комплексного мониторинга IT-инфраструктуры.

Также рассмотрим, чем Pandora FMS отличается от PRTG, WhatsUp Gold и других систем мониторинга.

Спикеры:
Александр Тварадзе
— Pandora FMS
Антон Касимов — Gals Software, региональный дистрибьютор Pandora FMS

📅 30 сентября
⏰ 10:00 МСК
📍 Онлайн

Участие бесплатное.

👉 Зарегистрируйтесь, чтобы получить напоминание и ссылку на вебинар.

Ссылка на подключение придёт в Telegram-бот за 40 минут до начала вебинара.


Помните ли вы мой пост про Машеньку, которая слегка обделалась в процессе комментирования. Она вернулась, учла все ошибки и в этот раз сняла штаны перед тем, как сделать свои грязные делишки. Пока не баню, слежу за эволюцией бота.


Klarity — GitOps-first панель для наблюдения за Kubernetes

Klarity — веб-интерфейс для просмотра состояния Kubernetes-кластеров, диагностики приложений и контроля GitOps-процессов.

Главная идея проекта: кластер нужно наблюдать через панель, а изменять — через Git, pull request и привычный CI/CD-процесс. Поэтому в Klarity нет универсального редактора ресурсов, позволяющего незаметно изменить YAML в обход GitOps.

Что умеет Klarity:

🚀 автоматически обнаруживать более 60 типов Kubernetes-ресурсов и установленные CRD;

🚀 показывать Pods, Deployments, StatefulSets, Services, Ingress, PVC, RBAC, события и другие объекты;

🚀 выводить CPU и память узлов, Pod и отдельных контейнеров через metrics-server;

🚀 ранжировать основные потребители ресурсов;

🚀 транслировать логи контейнеров через WebSocket;

🚀 открывать веб-терминал в контейнере через kubectl exec;

🚀 организовывать port forwarding прямо из браузера;

🚀 искать ресурсы сразу по нескольким категориям;

🚀 формировать HTML-отчёт о состоянии кластера.

Отдельно приятна автоматическая интеграция с Argo CD и Flux. Klarity обнаруживает их CRD и показывает состояние Applications, ApplicationSets, Kustomizations, HelmReleases и Git-репозиториев без дополнительной настройки.

Для нескольких кластеров можно загрузить набор kubeconfig-файлов и переключаться между контекстами из интерфейса.

Предусмотрено несколько вариантов аутентификации:

🚀 встроенные пользователи и роли;

🚀 Kubernetes ServiceAccount Token;

🚀 OIDC/SSO через Keycloak, GitLab, GitHub, Azure AD, Okta, Dex и другие провайдеры.

Backend написан на Go, frontend — на React и TypeScript. Интерфейс встраивается в один исполняемый файл. Развернуть приложение можно через Helm или Kustomize.

Klarity — это скорее альтернатива Headlamp, Lens или веб-вариант k9s, а не полноценная observability-платформа. Здесь нет долговременного хранения метрик, централизованного хранилища логов и трассировки. Метрики берутся из metrics-server, логи транслируются напрямую, а журнал аудита хранится в ограниченном буфере памяти.

Репыч на GitHub

Сайт и документация


📱 Telegram | 📲 MAX


Nerdlog — просмотр логов с нескольких серверов без ELK, Graylog и центрального хранилища

Интересный инструмент для тех случаев, когда нужно быстро проанализировать логи на нескольких Linux-серверах, но разворачивать полноценную систему централизованного логирования избыточно.

Nerdlog — это терминальный UI-интерфейс, который подключается к удалённым машинам по SSH, выполняет обработку логов непосредственно на них, а затем объединяет результаты в одном окне.

По умолчанию Nerdlog умеет работать с:

— /var/log/messages и /var/log/syslog;

— ротируемыми логами;

— выводом journalctl;

— произвольными текстовыми логами;

— базовым форматом логов Apache.

Можно одновременно искать события на нескольких серверах, ограничивать запрос временным диапазоном и фильтровать строки с помощью выражений в awk-формате. Результаты от разных узлов объединяются в общую таблицу.

Главная особенность интерфейса — интерактивная временная гистограмма, напоминающая Kibana или Graylog. На ней виден всплеск ошибок. Есть история запросов, постраничная загрузка, Vim-подобное управление и возможность скопировать текущий запрос в виде команды, чтобы передать его коллеге.

При этом полные файлы на рабочую машину не скачиваются. Фильтрация и построение гистограммы выполняются на удалённых узлах, а по сети передаются только найденные сообщения и агрегированные данные.

Результаты дополнительно сжимаются. Количество загружаемых строк можно ограничить — по умолчанию это до 250 сообщений с каждого потока.

Клиент работает на Linux, macOS, FreeBSD и Windows, но получать логи с Windows-хостов пока нельзя. Nerdlog написан на Go, а готовые бинарники доступны в GitHub Releases.

Репыч на GitHub

Готовые сборки

Документация и ограничения

📱 Telegram | 📲 MAX

2k 0 39 3 15

Avalonia UI и Linux Embedded: делаем Grafana-дашборд на старом Raspberry Pi и древнем 32-битном OrangePi

Старый Raspberry Pi вполне можно превратить в информационную панель с данными из Grafana. Но что делать, если установленный Chromium уже не поддерживает современный интерфейс Grafana, а ресурсов для полноценного браузера маловато?

В статье рассматривается практический кейс: авторы написали нативный дашборд на Avalonia UI, получают данные через API Grafana и выводят интерфейс напрямую через DRM/KMS — без X11, Wayland и оконного менеджера.

В статье разобраны:

— настройка Raspberry Pi OS Lite и автозапуска через systemd;

— получение данных через /api/ds/query;

— публикация self-contained .NET-приложения под ARM;

— ограничения памяти и автоматический перезапуск;

— перенос проекта на старый 32-битный Orange Pi;

— сравнение потребления памяти с Chromium: 234 против 345 МБ на Raspberry Pi.

Читать на Хабре

📱 Telegram | 📲 MAX


Quickwit — поисковый движок для логов и трейсов с хранением индексов в S3

Quickwit ориентирован на observability-данные. Можно рассматривать, когда нужно хранить и искать большие объёмы логов и трейсов, не размещая весь индекс на дорогих локальных SSD.

Главная особенность Quickwit — разделение вычислений и хранения. Индексаторы формируют независимые части индекса — splits — и сохраняют их в S3, MinIO, Google Cloud Storage или Azure Blob Storage. Search-ноды остаются stateless и загружают из объектного хранилища только необходимые части индекса. Метаданные в распределённой конфигурации обычно хранятся в PostgreSQL.

Это выглядит интересно для длительного хранения логов и нагрузок, где интенсивность поиска меняется со временем.

Что поддерживает Quickwit:

🚀 полнотекстовый поиск, фильтрацию и агрегации;

🚀 строгую схему и schemaless-индексацию;

🚀 приём логов и трейсов через OpenTelemetry;

🚀 интеграцию с Jaeger и Grafana;

🚀 совместимый REST API с Elasticsearch/OpenSearch API;

🚀 загрузку данных из Kafka, Pulsar, Kinesis, S3 и через Ingest API;

🚀 распределённое развёртывание в Kubernetes.

Основной фокус Quickwitн сделан на логах и трейсах, пока что в продукте нет полноценной поддержки метрик.

Репыч на GitHub

Архитектура Quickwit

Интеграция с Grafana

📱 Telegram | 📲 MAX


🚨 Prometheus Alertmanager или Grafana Alerting — что выбрать?

Поговаривают, что существуют окружения, в которых алерты летят одновременно из Alertmanager и Grafana. При таком раскладе правила, маршрутизация и глушилки оказываются разбросаны по двум системам, а команда не всегда понимает, какая из них главная.

По ссылке вы найдете перевод статьи, в которой подробно сравниваются оба подхода: архитектура, группировка и дедупликация алертов, правила подавления, интеграции, высокая доступность и управление через UI или конфигурацию.

Также говорят про гибридный вариант: создавать и визуализировать правила в Grafana, а сложную маршрутизацию и доставку уведомлений оставлять Alertmanager.

👉 Читать перевод статьи

👉 Расскажите в комментариях какой подход выбрали у себя в окружении.

📱 Telegram | 📲 MAX


Дедупликация строк на доставщике логов: сравниваем OpenTelemetry, Vector, vlagent, Fluent Bit Grafana Alloy и Filebeat

Дописал вторую статью из той же серии. Идеи, которые копились достаточно давно, наконец начали выходить в свет.

Вы узнаете про варианты дедупликации на уровне агентов. В одной из следующих статей поговорим о том какой бэкэнд лучше жмет, а дальше как снизить объем телеметрии.

Плюсы к статье и в карму на Хабре неистово приветствуются❤️

Читать на Хабре

📱 Telegram | 📲 MAX


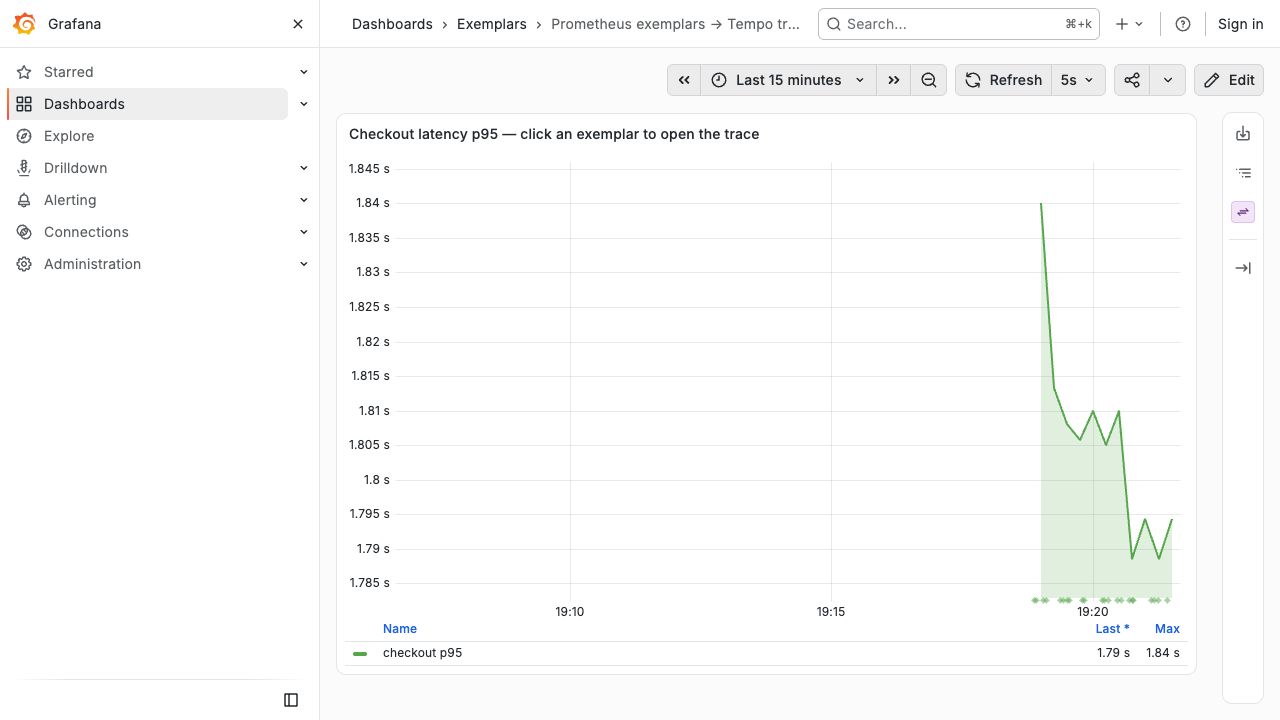
Exemplars: как перейти от всплеска на графике сразу к проблемному запросу

(удобная штука, как оказалось, но полноценно работает только в Mimir и Prometheus)

По метрикам легко определить, что вырос p95 задержки запросов, увеличилась доля ошибок или просела пропускная способность. График, к сожалению, сообщит только факт произошедшей проблемы, но не детали по ней.

Дальше идешь и ковыряешь трейсы, ищешь нужный временной интервал и нужные трейсы. Exemplars сокращают эту цепочку до одного клика.

Что это такое

Exemplar — ссылка на конкретный трейс, сохранённая рядом с метрикой. Кроме значения и времени оно обычно содержит trace_id или span_id и быть может еще какие-то дополнительные атрибуты.

Например, в гистограмме мы увидели в бакете запросы плохим статусом. Exemplar говорит: смотри, вот пример конкретного трейса, он занял 1,82 секунды, а его trace_id — 7f3a…91c2.

При этом trace_id не становится обычным лейблом метрики и не создаёт новую серию для каждого запроса.

Как внедрить

1. Настройка на уровне инструментирования приложения. Метрика и трейсы должны создаваться в одном контексте. OpenTelemetry может связать метрику с активным трейсом. В Prometheus клиенте извлекать идентификаторы трейса из контекста OpenTelemetry.

2. Настройка на уровне бэкенда. Подойдёт Tempo или Jaeger.

3. Включить exemplar storage на уровне Prometheus. В Prometheus для этого используется флаг --enable-feature=exemplar-storage. В Mimir свои настройки.

4. Связать источники данных в Grafana. В настройках Prometheus data source → Exemplars выбрать internal link на Tempo/Jaeger и указать имя метки: например, trace_id.

5. Найти наличие проблемных запросов на гистограмме (предварительно можно проверить, что exemplar появляется в Explore) и, перейти в существующий trace.

Exemplar, конечно, не способ найти все связанные трейсы. Это лишь пример, а не архив всех запросов. Если trace отброшен tail-сэмплером, ссылка окажется пустой.

По итогу exemplars сравнительно недорогой способ построить прямой путь от графика к конкретному медленному спану.

Для лучше понимания подхода, посмотрите на приложенные к посту скриншоты.

👉 расскажите в комментариях, если у вас был опыт использования exemplars.

Полезные ссылки

🚀 Документация Grafana

🚀 Настройка Prometheus data source

🚀 Exemplar storage в Prometheus

🚀 Спецификация OpenTelemetry

🚀 Пример для client_golang

📱 Telegram | 📲 MAX

Показано 20 последних публикаций.