


Как научить LLM пользоваться интернетом?
@mishaninaaaa
В 2021 году команда исследователей из OpenAI научила GPT-3 пользоваться браузером как инструментом, по сути это один из первых прототипов tool-using LLM. Про это есть статья на arxiv, а также блогпост.
Часть идей из статьи можно воспроизвести достаточно просто, если взять небольшую языковую модель и добавлять ей в контекст результат поиска промпта в интернете.
Реализация
Сделал такую реализацию на основе статьи:
• Через API(serpapi) модель отправляет запрос в Google Search Engine, результаты поиска добавляются в system prompt модели как контекст. В system prompt я также прошу модель цитировать источники
• Далее берётся instruction-tuned модель(SmolLM2-1.7B-Instruct), которая кушает user prompt и system prompt, отвечает на вопрос с указанием ссылок и списка источников
• На MacBook Pro с M5 с MPS(aka Mac CUDA) ответ модели занимает около 5 секунд
Прикрепил пример работы в комментах. Обратите внимание, что вопрос содержит свежие данные, значит модель действительно пользуется инфой из интернета
Бенчмарк
Немного про статью и подход
@mishaninaaaa
В 2021 году команда исследователей из OpenAI научила GPT-3 пользоваться браузером как инструментом, по сути это один из первых прототипов tool-using LLM. Про это есть статья на arxiv, а также блогпост.
Часть идей из статьи можно воспроизвести достаточно просто, если взять небольшую языковую модель и добавлять ей в контекст результат поиска промпта в интернете.
Реализация
Сделал такую реализацию на основе статьи:
• Через API(serpapi) модель отправляет запрос в Google Search Engine, результаты поиска добавляются в system prompt модели как контекст. В system prompt я также прошу модель цитировать источники
• Далее берётся instruction-tuned модель(SmolLM2-1.7B-Instruct), которая кушает user prompt и system prompt, отвечает на вопрос с указанием ссылок и списка источников
• На MacBook Pro с M5 с MPS(aka Mac CUDA) ответ модели занимает около 5 секунд
Прикрепил пример работы в комментах. Обратите внимание, что вопрос содержит свежие данные, значит модель действительно пользуется инфой из интернета
Бенчмарк
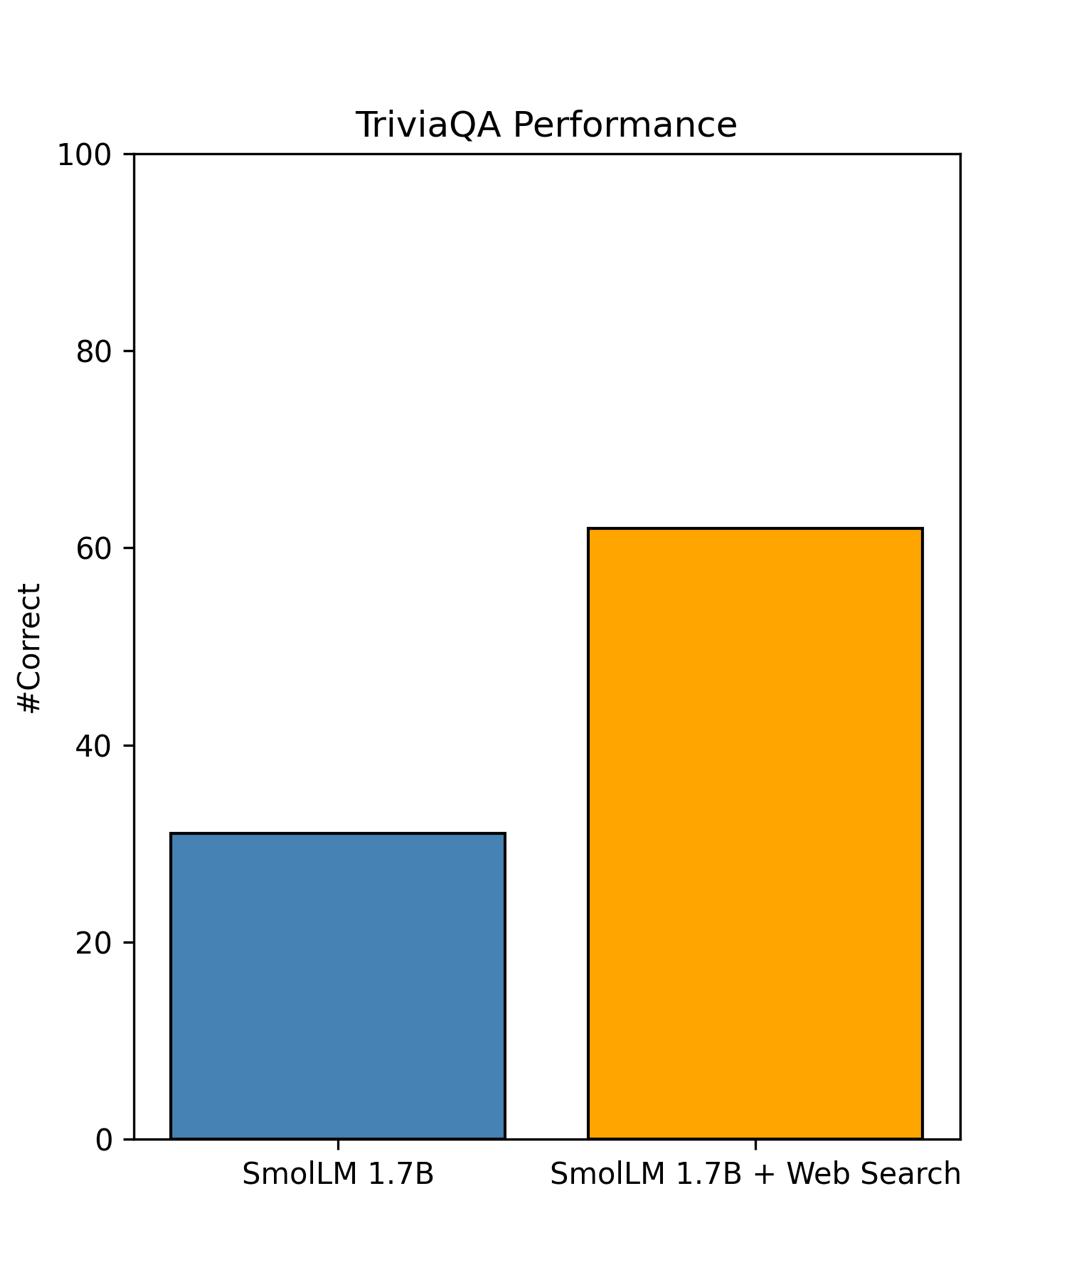
Также мне было интересно побенчмаркать модель с web-поиском на каком-нибудь датасете. Взял кусок датасета TriviaQA на 100 вопросов, который используется в статье. Вопросы короткие, имеют вид "Who was the next British Prime Minister after Arthur Balfour?".
Получилось, что модель без web-поиска ответила правильно на 31/100 вопросов, с web-поиском на 62/100 вопросов. На этом моменте я очень обрадовался)
Немного про статью и подход
Подход включал разработку web environment, в которой GPT-3 могла делать поисковые запросы, переходить по ссылкам и читать страницы.
Сначала модель обучалась имитировать то, как человек пользуется интернетом (behavior cloning), используя логи взаимодействий разметчиков с браузером. Таким образом модель училась искать информацию, подтягивать найденный текст как контекст и цитировать источники.
Чтобы мотивировать модель делать это лучше, далее обучалась reward-модель, оценивающая качество ответа. Для этого разметчикам показывали пары ответов модели и просили выбрать лучший. Reward-модель училась предсказывать человеческие предпочтения.
Для параметризации этих предпочтений использовалась модель, аналогичная Elo-рейтингу(как в шахматах): разность рейтингов позволяет оценить вероятность того, что один ответ предпочтительнее другого.
После обучения reward-модели можно использовать RL и rejection sampling, чтобы выбирать ответы с наибольшим Elo score