Графики каждый день (почти)


Гео и язык канала: Россия, Русский
Категория: Блоги


Группа, полная любопытства к миру и любви к визуализации)
контакт: @ka1242

Связанные каналы  |  Похожие каналы

Гео и язык канала
Россия, Русский
Категория
Блоги
Статистика
Фильтр публикаций


О Нобелевской премии по физике 2026
for decisive contributions to the IceCube Neutrino Observatory and the discovery of high-energy neutrinos of astrophysical origin

В этом году премию вручили Francis Halzen за вклад в открытие высокоэнергитичных нейтрино, а так же идею и реализацию IceCube.

Мне кажется это красиво, вот в 1988 году была идея (публикация), что давайте пробурим ~ 86 скважин глубиной ~ 3 км в лёд на южном полюсе и положим туда детекторы. И вот в 2005 они уже начинают собирать данные и в 2011 полноценно работать. И не знали же, а хватит ли таких масштабов для детекции, а хватило)


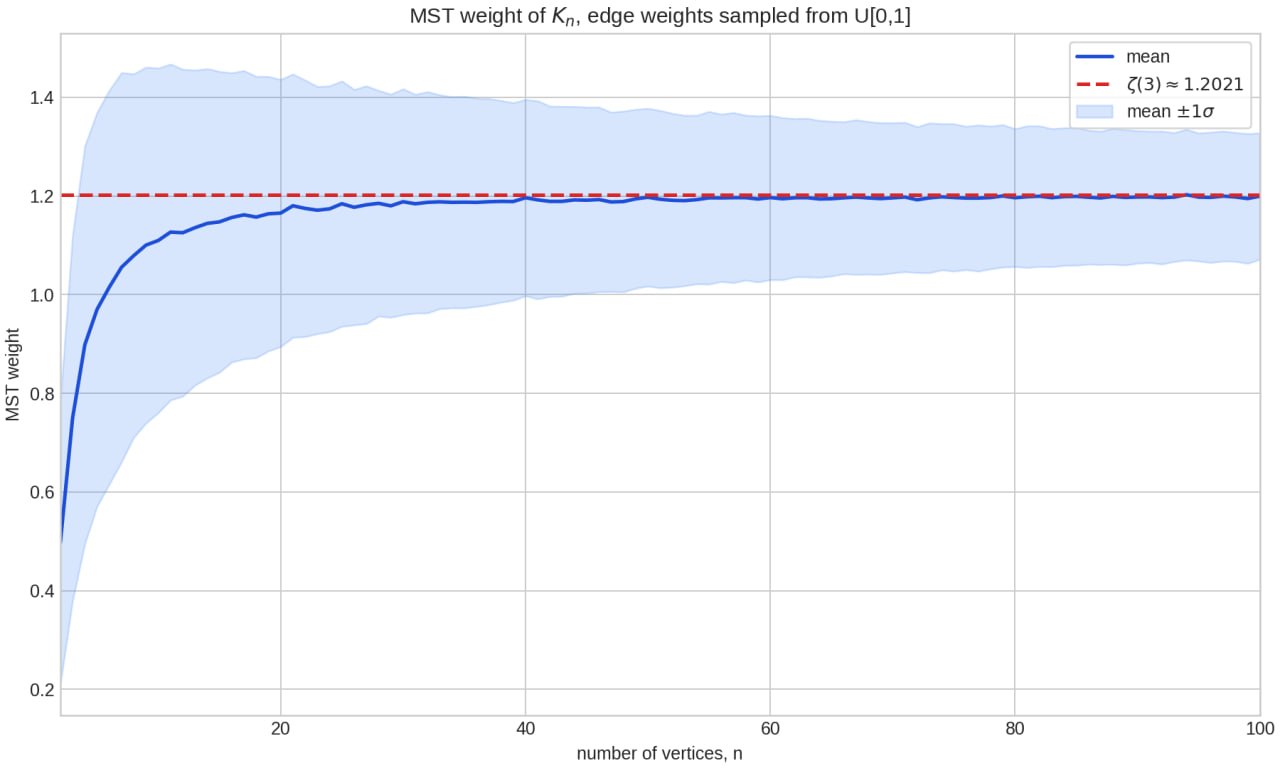
ζ(3) и минимальные остовные деревья

Три дня назад Риману исполнилось 200 лет. Думаю, многие время от времени сталкиваются со значениями его дзета-функции: ζ(2) - это известный вопрос про сумму обратных квадратов, а ζ(4) вылезает в излучении абсолютно черного тела.

А можно ли естественным образом встретить ζ(3)?
Можно! Если взять полный граф и сгенерировать случайные веса ребер из отрезка [0, 1], то вес минимального остовного дерева будет асимптотически равен ζ(3)

955 0 15 2 43

Чем дальше вы от Земли, тем слабее гравитация, и тем быстрее идёт время. Если достаточно точно измерять время, то можно отличать по высоте две точки в пространстве. Как вы думаете, какого масштаба высоты мы умеем так различать за час измерений?
Опрос
  •   миллиметр
  •   метр
  •   километр
37 голосов


О том как 2 в степень возводить
(да, 42)

Так или иначе сталкиваемся со степенями двойки. Но 2¹⁰ = 1024 ≈ 10³, и очень удобно возвращаться к 10 через
2¹⁰ᵏ ≈ 10³ᵏ
И тут есть забавная историческая путаница, что для накопителей используется 10³ᵏ байт, а, например, на Windows (и Linux при du -sh) отображается 2¹⁰ᵏ байт. То есть скорее всего в диске на 1 TB вы не увидите больше 10⁹ / 2²⁰ ~ 931 GB, хотя там есть честные 10⁹ байт. Флешка на 64 GB будет выглядеть как 60 GB.

И можно легко эти поправки доставать, а именно
2¹⁰ᵏ = 1.024ᵏ 10³ᵏ ≈ (1 + k / 42) 10³ᵏ
и для 2⁻¹⁰ᵏ ≈ (1 − k / 42) 10⁻³ᵏ. Так для 10⁹ / 2²⁰ получится (1 − 1/14) 10³ ~ 930. Теперь можно в уме прикидывать не только 2¹⁰ᵏ, но и линейную по k поправку)

890 0 10 5 21

О том зачем перед засолкой огурцы замачивать
(чтобы хрустели, или про осмотическое давление)

Читая рецепт малосольных огурцов можно встретить предложение на пару часов сначала в холодной чистой воде их замочить. Но зачем, всё равно же потом их рассолом заливать? Давайте посмотрим что будет происходить с клетками в чистой и в солёной воде.

Про клетку будем думать как про мембрану, пропускающую только воду. И будем считать, что внутри клетки есть избыточное давление ΔP и добавляя туда частицу воды увеличиваем объём на v. Если внутри N частиц воды и n частиц примеси, то добавление одной частицы воды увеличивает число возможных конфигураций примерно в 1+n/N раз. То есть будет движение воды через мембрану туда, где больше примеси.

Но против избыточного давления совершаем работу ΔP v, так что перенос частиц будет увеличивать энергию на ΔE = ΔP v. По Больцману у вероятности находиться с ΔP вес exp(−ΔE / kT) = exp(−ΔP v / kT). Получается вода будет прибывать до тех пор, пока не уравновесится избыточным давлением: (1 + n/N) exp(−ΔP v / kT) ≈ 1, или ΔP ≈ (kT/v) ln(1 + n/N). При n ≪ N упрощается до ΔP ~ n. ΔP называется осмотическим давлением.

Получается, если залить клетки чистой водой, примесей внутри них больше, чем снаружи, поэтому вода движется внутрь: клетки набухают, становятся более упругими, и огурцы — более хрустящими (это имеет смысл скорее если они уже какое-то время полежали, а не только с огорода). А когда заливаем их рассолом, то уже примесей больше снаружи. Собственно, этот эффект и подразумевается, когда говорят что соль "вытягивает" воду)

P.S. Отучился 6 лет на физике, а этот сюжет только на днях узнал


О том что куда-то двигаемся

Попробовал gpt6 — очень почувствовал разницу с gpt5. Наверное даже сильнее, чем разницу между gpt5 и gpt4. Бенчмарки бенчмарками, но несколько недель охапка задачек у меня не решалась. Не двигались и всё тут. А сейчас вот в новую версию закинул и в пределах пары часов прогресс — чудеса)

P.S. Про одну такую задачу подробнее тут написал https://lnkd.in/p/dApWKqNE


О том что такое лист A4
(√2, свет и ¹³³Cs)

Это взяли за A0 лист площадью 1 м² с отношением сторон √2 : 1 (так чтобы разрезая пополам отношение сторон сохранялось) и разрезали 4 раза.

А что такое метр?
Это сколько свет проходит за 1/299792458 секунды, точно, мы определяем расстояние через свет и время с 1983 года.

А что такое секунда?
Это мы возбуждаем переход между двумя сверхтонко расщепленными уровнями основного состояния атома ¹³³Cs и секунда это время за которое происходит 9192631770 колебаний, точно, с 1967 года.

Получается, что лист А4 это √2, свет и ¹³³Cs.

1.4k 0 12 11 66

Как научить LLM пользоваться интернетом?
@mishaninaaaa

В 2021 году команда исследователей из OpenAI научила GPT-3 пользоваться браузером как инструментом, по сути это один из первых прототипов tool-using LLM. Про это есть статья на arxiv, а также блогпост.

Часть идей из статьи можно воспроизвести достаточно просто, если взять небольшую языковую модель и добавлять ей в контекст результат поиска промпта в интернете.

Реализация
Сделал такую реализацию на основе статьи:

• Через API(serpapi) модель отправляет запрос в Google Search Engine, результаты поиска добавляются в system prompt модели как контекст. В system prompt я также прошу модель цитировать источники

• Далее берётся instruction-tuned модель(SmolLM2-1.7B-Instruct), которая кушает user prompt и system prompt, отвечает на вопрос с указанием ссылок и списка источников

• На MacBook Pro с M5 с MPS(aka Mac CUDA) ответ модели занимает около 5 секунд

Прикрепил пример работы в комментах. Обратите внимание, что вопрос содержит свежие данные, значит модель действительно пользуется инфой из интернета

Бенчмарк
Также мне было интересно побенчмаркать модель с web-поиском на каком-нибудь датасете. Взял кусок датасета TriviaQA на 100 вопросов, который используется в статье. Вопросы короткие, имеют вид "Who was the next British Prime Minister after Arthur Balfour?".

Получилось, что модель без web-поиска ответила правильно на 31/100 вопросов, с web-поиском на 62/100 вопросов. На этом моменте я очень обрадовался)


Немного про статью и подход
Подход включал разработку web environment, в которой GPT-3 могла делать поисковые запросы, переходить по ссылкам и читать страницы.

Сначала модель обучалась имитировать то, как человек пользуется интернетом (behavior cloning), используя логи взаимодействий разметчиков с браузером. Таким образом модель училась искать информацию, подтягивать найденный текст как контекст и цитировать источники.

Чтобы мотивировать модель делать это лучше, далее обучалась reward-модель, оценивающая качество ответа. Для этого разметчикам показывали пары ответов модели и просили выбрать лучший. Reward-модель училась предсказывать человеческие предпочтения.

Для параметризации этих предпочтений использовалась модель, аналогичная Elo-рейтингу(как в шахматах): разность рейтингов позволяет оценить вероятность того, что один ответ предпочтительнее другого.

После обучения reward-модели можно использовать RL и rejection sampling, чтобы выбирать ответы с наибольшим Elo score


О том как π монеткой оценивать
(терпеливо)

Будем подбрасывать монетку до тех пор, пока доля "орлов" x не превысит 0.5 и запишем себе в блокнотик эту долю x. Например для последовательности "ророо" x=3/5, а если сразу выпал орёл "о", то x=1. Чему в среднем равно x? Судя по недавней работе ⟨x⟩ = π/4 !

Справедливости ради после тысячи бросков выяснится, что π = 3.1 ± 0.3, а после миллиона что π = 3.14 ± 0.07 — не самый быстросходящийся метод оценки, но по-моему достаточно неожиданный.

P.S. Сегодня 03.14, всех с днём π)


О том как бумага мнётся
(фрактально)

Если взять лист бумаги площади S, и сложить из него кораблик, то размер кораблика будет масштабироваться по sqrt(S): взяв A5 вместо A4 закономерно получим кораблик в √2 раза меньшей длины. А если этот лист бумаги скомкать, как будет меняться диаметр комочка в зависимости от исходных размеров? Отличный вопрос, чтобы задуматься о фрактальности! (спасибо @ergobas)

Это и предлагается коллективным экспериментом проверить. Мы как-то с вами считали звёзды (link) и получилось очень здорово. Теперь можем воспроизвести результаты этой работы. Должно получиться, что размер комочка меняется в 1.3 раза, при переходе от A4 к A5, или от A5 к A6 -- при любом уменьшении площади в 2 раза.

Так что берёте ненужный прямоугольник бумаги, измеряете размеры, комкаете его как можно плотнее, и присылаете какого диметра D получился результат. А потом построим D(S), в лог масштабе должна получиться прямая)

форма для результатов: https://forms.gle/Z4dt1xbSW1zHvsUV8


Собственно да, можно.

Так ещё в бакалавриате немного поучаствовал в оформлении патента "Natural language processing by means of a quantum random number generator" (link), ныне действующего в Австралии и Японии. Иногда стартапам для отчётности бывает полезно просто иметь заявки на патенты, особенно на ранних этапах. Любопытно видеть, как такие сюжеты доходят до реализации и принятия. Не представляю, что с этим делать, зато у вас теперь есть забавный факт об авторе канала и патентах)

На всякий случай уточню, что вряд ли использование QRNG тут чем-то может пригодиться — разве что, как было отмечено выше, даёт ощущение тайны и смешно звучит.


Вопрос по патентам, как вы думаете, можно ли запатентовать использование квантового генератора случайных чисел (QRNG) для выбора варианта LLM ответа?)
Опрос
  •   Да
  •   Нет
  •   Не надо.. 🤦‍♂️
132 голосов


О том как пятнашки представить в виде группы перестановок
(а точнее S(n²-1) × Cₙ × Cₙ)

Допустим вам захотелось представить пятнашки в виде группы перестановок. Но проблема: что и куда переставлять зависит от положения 0 (пустой клетки). И вообще, для классических пятнашек это сделать не получится. Но если допустить периодические гран условия (да, мы теперь живём на торе), то всё можно.

Для этого рассмотрим следующую конструкцию: для квадрата n×n заполним его n² элементами, 0 в левом верхнем углу (на рисунке это синий квадрат); дальше повторим как на рисунке строки и столбцы этого квадрата до (2n-1)×(2n-1); установим рамку в положение (0,0). Внутренности синего квадрата это как раз будет группа S(n²-1), а положение рамки по x и y это Cₙ × Cₙ.

Теперь если мы хотим поменять местами с 0 (пустышкой) соседний элемент, то: (i) двигаем в эту сторону рамку, (ii) внутри синего квадрата делаем циклические перестановки (внутри столбцов|строк), не трогая 0. Собственно, внутренности рамки это и будет состояние пятнашек, а мы только что описали их набором перестановок!

Давайте для наглядности выпишем генераторы для n=3. Всего будет (n²-1)+(n)+(n) элементов.
state: [1, 2, 3, 4, 5, 6, 7, 8,
0, 2, 1, 0, 2, 1]

right: [2, 1, 4, 5, 3, 7, 8, 6,
8+2, 8+0, 8+1, 11+0, 11+1, 11+2]
down: [4, 5, 6, 7, 8, 3, 1, 2,
8+0, 8+1, 8+2, 11+2, 11+0, 11+1]
и left, up получаются аналогично как обратные к right, down. Теперь чтобы сделать ход, нам достаточно применить заданную перестановку к набору элементов, независимо от положения пустышки.

// кстати, card(S_{n²}) = card(S_{n²-1} × C_n × C_n)


О том из чего квантовые компьютеры собираются
(или о плотных подмножествах SU(2ⁿ))

Возьмём n кубитов и зададимся вопросом сделать с ними всё что угодно унитарное — реализовать некоторый квантовый алгоритм U через набор доступных гейтов {Gⱼ} (fig. a). Квантовый алгоритм U — просто унитарная 2ⁿ-мерная матрица, гейт Gⱼ — операция которую мы делаем с поднабором кубитов, тоже сводится к действию унитарной матрицы. То есть мы хотим представить одну матрицу U в виде произведения U=Gⱼ₁ Gⱼ₂ ... Gⱼₘ . Возникает естественный вопрос, а для какого вообще набора {Gⱼ} мы может так сделать?

Оказывается достаточным взять 3 вида матриц (fig. b): две действующие на один кубит (T,H) и одну действующую на два кубита (CNOT, изображается точкой с плюсом). Действуя ими на разные кубиты получается всего n(n-1)+2n доступных матриц {Gⱼ}. И ограничиваясь только такими матрицами, мы можем приблизить сколь угодно точно любую другую унитарную матрицу — то есть они образуют плотное подмножество SU(2ⁿ).

Было бы интересно подумать, а как для минимального m найти такое разложение U=Gⱼ₁ Gⱼ₂ ... Gⱼₘ — очередная, к слову, NP-complete задача.

// говоря про вид комплексных элементов z матрицы U (fig. c) — формула приведена в title, распределение построено для k=1, n_q={-1,0,1} (другие варианты в комментариях), собственно пост возник скорее из желания поделиться этими узорами)
// опечатка: сумма по q от 0, а не от 1


Я не нашёл генератор QR code, который бы не требовал от меня регистрации/просмотра рекламы/капчи/... — кошмар, мне просто текст/url в картинку нужно перевести. В общем сделал минималистичный вариант для себя, но вдруг и вам пригодится)

https://qdiag.xyz/qr/

// на телефоне из браузера tg скачивание файла шалит, а вот в chrome всё ок


О том как в шахматах ходят

Всем немного знакомым с шахматными правилами предлагаю посмотреть на распределение ходов: по горизонтали отложен номер клетки откуда ходили, а по вертикали отложено куда ходили, данные на основе 1M партий lichess. Чем ярче клеточка, тем чаще делали такой ход. Крупная сетка по сути делит доску на линии: на клетках от 1 до 8 стоят в начале фигуры белых, на клетках от 9 до 16 в начале стоят пешки белых, ... . Можно заметить, что со стороны черных и со стороны белых идёт достаточно симметричная игра.

Что вы тут видите? Какие ходы повторяются из партии в партию? Наиболее характерные выделил красным цветом. Мне очень нравится эта картинка тем, что в начале она выглядит скорее странно, но после пары минут становится до жути очевидной :)

1. Это рокировка O-O белого короля, просто e1-g1!
2. А тут уже лошади прыгают g1-f3, b1-c3
3. Восемь пешек, которые шагают на 1 или на 2 клетки, из партии в партию


Потихоньку готовлюсь к конференции и хотелось сделать какое-нибудь демо. С радостью представляю вниманию .js реализацию описанного алгоритма: прямо у вас в браузере обученная в пределах 5 минут нейросетка найдёт близкий к оптимальному путь на графе в 10¹⁹ вершин за пару секунд — соберёт кубик Рубика 3×3×3 в среднем за 24 действия)


Когда-то этот канал начинался как обмен графиками однокурсников на физтехе (давно же это было). Интересно как обстоят дела сейчас — сколько здесь физиков/математиков/... . С какой областью/направлением вы себя ассоциируете?
Опрос
  •   физика
  •   математика
  •   computer science
  •   data science
  •   программирование
  •   биология
  •   химия
  •   другое
382 голосов


Нобелевская премия по физике 2025
(или о некоммутативности фазы и заряда)

И в этом году Нобелевская премия за эксперимент: демонстрация дискретных уровней энергии в current-biased переходе Джозефсона и наблюдение макроскопического туннелирования между ними.
Нобелевскую премию по физике 2025 получат Джон Кларк, Мишель Деворе и Джон Мартинису за открытие макроскопического квантово-механического туннелирования и квантования энергии в электрической цепи.


Любопытно, что они именно коллеги, а октябре 1985 в PRL у них вышли совместные работы
Measurements of Macroscopic Quantum Tunneling out of the Zero-Voltage State of a Current-Biased Josephson Junction

Energy-Level Quantization in the Zero-Voltage State of a Current-Biased Josephson Junction

Вообще очень интересно открывать эти работы с мыслью "через 40 лет это будет нобелевка".

Из этого появились современные сверхпроводниковые кубиты и подняли точность SQUID-магнитометров (два Джозефсоновских перехода в петле, одно из наиболее ярких коммерческих проявлений квантовых технологий), так что влияние на область действительно заметное)

Показано 20 последних публикаций.