


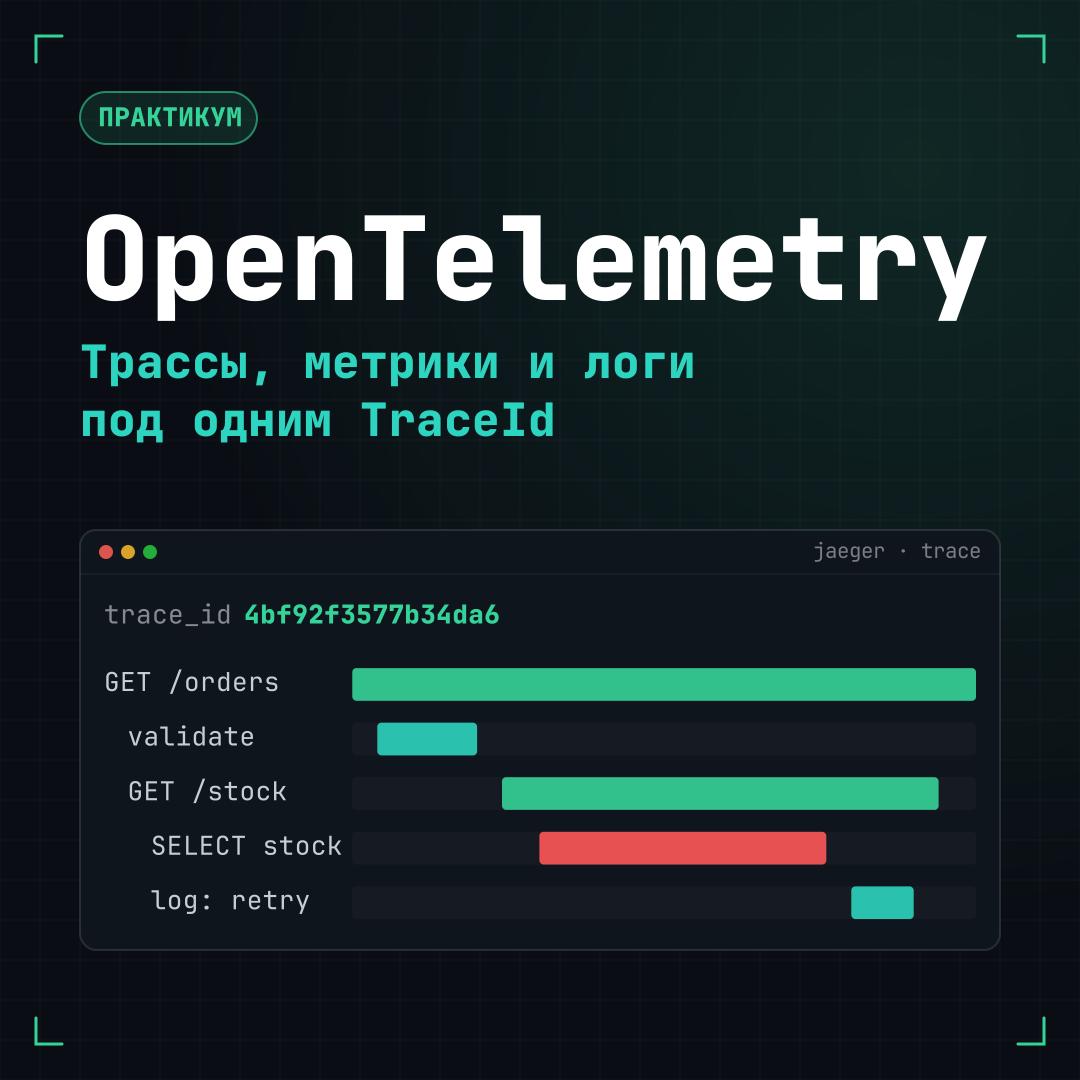
OpenTelemetry: как связать трассы, метрики и логи одним TraceId и перестать искать причину инцидента вручную
Во время инцидента трассы лежат в Jaeger, метрики в Prometheus, логи отдельно, и связи между ними приходится искать руками. Хуже, когда сервисы размечены устаревшими атрибутами вроде http.method и db.statement: актуальные observability-платформы такие данные уже не понимают.
Мы сделали практикум OpenTelemetry, чтобы инженеры могли размечать сервисы по актуальным Semantic Conventions, связывать все сигналы через единый TraceId и настраивать Collector так, чтобы в хранилище попадали трассы с ошибками, а не health-check спаны.
В программе тебя ждёт:
🟢Проектирование и внедрение полного стека наблюдаемости (traces, metrics, logs) на базе OpenTelemetry SDK v1.66 и Collector
🟢Ручная инструментация HTTP- и gRPC-сервисов с соблюдением актуальных OTel Semantic Conventions v1.23+ (http.request.method, db.query.text и другие)
🟢Конфигурирование OTel Collector с процессорами filter и transform на базе OTTL для гибкой фильтрации и обогащения телеметрии
🟢Реализация tail-based sampling в Collector для селективного сохранения трасс с ошибками и высокой задержкой
🟢Построение сквозной корреляции трасс, метрик и логов через единый TraceId с использованием W3C TraceContext, Baggage и Logger Bridge
🟢Настройка кастомных гистограмм latency с View API и ExplicitBucketHistogram для точного профайлинга в Prometheus
↘️ Подробная программа
В финальном проекте ты построишь систему наблюдаемости для двух HTTP-микросервисов на Go или Python: вручную инструментируешь трассы, метрики и логи, настроишь пропагацию контекста, поднимешь Collector с фильтрацией /health-спанов и tail-based sampling и разведешь трассы в Jaeger, а метрики в Prometheus. Все разворачивается в Docker Compose.
Практикум уровня Middle. Нужно уверенно работать в Linux CLI, уметь написать HTTP-сервер на Go, Python, Java или Node.js, понимать HTTP и gRPC и знать основы Docker.
🎁 До 20 октября включительно действует скидка 3 000 рублей для новых участников
↘️ Практикум OpenTelemetry
↘️ Практикум OpenTelemetry + тренажёры