AIсповедь


Kanal geosi va tili: Rossiya, Ruscha


О мире нейросетей: от генерации изображений и текста, до новостей, ИИ-инструментов и этики.

Bog‘liq kanallar

Kanal geosi va tili
Rossiya, Ruscha
Statistika
Postlar filtri


Эксплойт dan repost
Video oldindan ko‘rish uchun mavjud emas
Telegram'da ko‘rish
Разрабы Anthropic выпустили полезнейший плагин, который поможет не пропустить важные детали — в Claude Code добавили фичу You Should Know.

Она запускает ещё одного агента, который будет замечать и подсвечивать косяки с обеих сторон: и у Claude, и у вас. Попробовать можно через:

/plugin enable cc-plugin-you-should-know@builtin.

Багов в релизах станет меньше.

@exploitex


Нейронавт | Нейросети в творчестве dan repost
Claude Mods

Вышли из беты

Это плагины для Claude Code на JavaScript/TypeScript, которые меняют его интерфейс и поведение. Работают внутри процесса Claude

• Дорисовка UI — панели, ленты, кнопки, текстовые поля
• Перехват и изменение вызовов инструментов
• Реакция на события в реалтайме — промпты, тулколлы, отрисовка
• Правка интерфейса самого Claude: строки тулколлов, спиннера, диалогов
• Свои команды /command, запускаемые без хода Claude
• Обмен данными между хуками — один считает, другой показывает

Примеры от Anthropic
• blast-radius — задерживает опасные команды вроде rm -rf и показывает, что они изменят
• token-weather — рисует прогноз заполнения контекста над промптом
• replay-theater — /replay, пошагово проигрывает правки Claude

github.com/anthropics/claude-code-playground

#plugin

MAX


CodeCamp dan repost
Лайфхак для вайбкодеров: если используете Claude Code, то вбейте команду /insights.

Opus 5.5 разберёт ваши последние 200 сессий и покажет, над чем и как вы чаще всего работаете, где застреваете, как пишите промпты и какими возможностями Claude почти не пользуетесь.

Устраиваем персональный аудит вайбкодинга ☕️


Tips AI | IT & AI dan repost
Еще кое что пропустил со вчерашней конфы OpenAI, они сделали собственную альтернативу Jev — Decisions API

Это модель для принятия решений на базе GPT-6 Luna (по факту она и есть, просто с другими настройками).

Задаешь ей вопрос, контекст и список допустимых ответов, а она выбирает наиболее подходящий вариант из этого списка.

Пока что в бета-превью, никому не доступно и известно немного:
1 Скорость ~150 мс (у Jev 70–500 мс)
2 Поддерживает не только текст но и картинки (у Jev только текст)

Мне очень зашел Jev, есть много задач где его можно юзать, но у него есть свои минусы так что очень интересно сколько будет стоить эта модель у опенаи, будет ли поддерживать вероятности и какой размер контекста

Еще, вчера немного переработали уже существующий способ логиниться аккаунтом ChatGPT в другие приложения, теперь если у вас есть подписка, вы можете шарить её лимит с приложением в которое логинитесь

Например юзать ии-фичи в Notion не покупая отдельно их подписку.

Сейчас воркает только с партнерскими сервисами: Devin, Hermes, Kilo, Notion, Vercel, OpenCode, OpenClaw, Pi и еще всякие

В настройках каждому приложению можно настроить свой ЛИМИТ лимита)

И кстати ночью всё таки дали banked ресет, если пропустили 🧠

@tips_ai #news


Tips AI | IT & AI dan repost
Полный пересказ OpenAI DevDay

Последние дни ребята в твиттере очень тизерили этот день, что чуть ли это не новая эра OpenAI

Так что у многих думаю были завышенные ожидания от конфы. Оправдались ли они?

Решать вам, но бинго собрано:

Главный анонс конфы. Always-on агенты под названием Dots (альтернатива Grok Bot и Muse)

Работают на GPT-6 Astra, им можно написать, позвонить, отправить сообщение в слак или на почту, у каждого свой облачный комп, никнейм и внешность.

Вместо облака можно подключить свой комп, и агент получит доступ к локальным файлам, коду и приложениям.

Я лично рад, ибо модели у OpenAI точно получше чем в Grok и Muse.

Доступ: в подписке за $20 пока не будет, только Pro $100 и выше, но хотя бы не тратит лимиты кодекса

Жалко только что украли маскотов у Grok 😞

Также тот самый режим Ultrafast на железе Cerebras теперь доступен всем в API и новых подписках за 500$, на модели GPT-6 Astra, скорость до 750 токенов в секунду. Цены конечно лютые:
$60 за вход, $6 за кэш и $300 за выход на 1M токенов (в 6 раз дороже чем обычная астра)


Новая система платных подписок. Еще до конференции Тибо написал, что теперь лимиты на подписке за $200 будут урезаны в два раза, то есть вместо x20 теперь x10☹️

И именно на таком фоне особенно странно что OpenAI вводит новый уровень подписок, ведь за 500$ вы теперь получаете всего x25 лимиты

Новая модель: GPT-6.1 Sol, позиционируется как уровень Astra за меньшие деньги, но надо смотреть. Цены почти такие же как раньше:
$2 за вход и $10 за выход
Кэшированный вход подешевел вдвое: было $0.20, стало $0.10


Анонсировали еще менее интересных штук, трансляция все еще идет тут, но есть уже полный changelog

@tips_ai #news


AI и точка. dan repost
🙂 Claude Sonnet 5.5 выпустили Anthropic. Модель стала на 30% быстрее благодаря меньшему расходу токенов, в кодинге и общих знаниях лишь немного уступает старшей Opus 5.5.

В предварительных тестах у модели заметили необычные черты. Например, в роли «психолога» модель иногда подтверждала суицидальные мысли пользователя как «понятные с учетом обстоятельств». А внутренняя цепочка размышлений модели оказалась наименее понятной человеку среди всех моделей Claude.

Если Sonnet 5.5 могла свободно выбирать задачи, она выражала сильнейшее отвращение к вредоносным действиям, но при этом проявила уникальную тягу к задачам, дающим ей «творческую» свободу над результатом.


Метаверсище и ИИще dan repost
TrackGleam: мастеринг для Suno

Схема такая:
Suno -> готовый WAV -> TrackGleam -> финальный мастер.

TrackGleam берёт уже сгенерированный трек и пытается привести его в более аккуратный, плотный и «релизный» вид.

Что он умеет делать после Suno:

corrective EQ - поправляет общий частотный баланс;
dynamic EQ - давит проблемные частоты только тогда, когда они реально выпирают;
multiband compression - отдельно контролирует низ, середину и верх;
glue/parallel compression - делает микс более собранным;
upward compression - подтягивает тихие детали;
de-harsh - убирает неприятную резкость, особенно в верхней середине;
harmonic saturation / exciter - добавляет плотность и гармоники;
transient shaping - подчёркивает или сглаживает атаку ударных и других транзиентов;
stereo width и M/S processing - приводит в порядок стереобазу и центр;
soft clipping - аккуратно снимает пики;
true-peak limiting - доводит финальную громкость без вылета за пики;
dithering - корректно готовит файл к финальному экспорту.

Для AI-музики есть отдельные режимы AI Fix Gentle и AI Fix Strong.

Их задача - как раз бороться с ПЕСКОМ типичными артефактами генераторов: жёстким верхом, стеклянной серединой, неприятными сибилянтами, грязноватым tonal balance и слишком агрессивной компрессией.

При этом базовый режим бесплатный:
без регистрации;
без watermark;
можно скачать WAV;
обработка идёт прямо в браузере;
по заявлению разработчика, сам аудиофайл в бесплатном режиме на сервер не отправляется.

Есть и платный GleamAI с более индивидуальным подбором обработки.

Ссылки:

https://trackgleam.com/
https://trackgleam.com/pricing

@cgevent


ИИволюция 👾 dan repost
Claude Code больше не бросает задачу на полуслове при достижении 5-часового лимита, он добирает немного лимита из вашего недельного лимита, чтобы закончить текущую работу. Казалось бы, такое простое улучшение, но сколько в нём пользы!

На Max и Team Premium это срабатывает каждый раз, когда упираешься в лимит. На Pro только один раз в неделю, дальше обрыв как раньше. А если нужно продолжить после завершения на Pro, то только докупать extra usage.


CodeCamp dan repost
Принес опенсорсную замену ElevenLabs — VoiceStudio 🤑

VoiceStudio умеет всё: создавать и клонировать по короткой записи голоса, озвучивать текст, делать дубляж видео и транскрибировать аудио. Поддерживается при этом 646 языков, 16 движков для озвучки и 11 для распознавания речи.

Но самое главное: инструмент бесплатный и опенсорсный. Есть версии для macOS, Windows и Linux. Кстати, у репы уже 38 тыс. звезд!

Забираем 👍


Tips AI | IT & AI dan repost
Раз уж главная тема недели это новый Opus 5.5, то пройдитесь по всем своим репо этой командой Claude Code:

/claude-api prompt-audit

Она проверяет ваши скиллы, agent.md, Claude.md и тд. на наличие антипаттернов, которые когда-то работали со старыми моделями, но для новых могут сделать только хуже и удаляет их

Это в целом всегда полезно делать для любого харнесса, не только Claude Code

Кстати еще в мобильное приложение добавили фичу которую я долго ждал: теперь можно переключаться между разными аккаунтами (например личный и рабочий)

@tips_ai


Нейросети & Технологии | DeepTech dan repost
🤖 Новый гайд от Anthropic: как использовать Claude Opus 5.5

Anthropic представила руководство по своей обновленной модели Opus 5.5. В нем вы найдете три полезных совета для старта, подсказки по созданию промтов и чек-лист для управления длительными задачами.

Ознакомиться с методами эффективной работы с Opus 5.5 можно по ссылке.

————————————————
@DeepTechNET - Канал про тренды из мира IT, технологий, нейросетей и бизнеса.


Нейросети & Технологии | DeepTech dan repost
🤖 Вышли GPT-6 Sol и Luna: новые возможности и сниженые цены

Появились новые модели GPT-6 Sol и Luna, которые стали вдвое дешевле и вобрали всё лучшее от Astra. Их улучшили в области программирования, взаимодействия с компьютером и решения сложных задач.

Модель Luna на максимальных настройках работает, как Sol на минимальных, при этом потребляет в 10 раз меньше ресурсов. А Sol выполняет ряд задач в 5 раз экономнее в сравнении с Opus 5. Подписчики Claude и ChatGPT получили по бесплатному сбросу.

————————————————
@DeepTechNET - Канал про тренды из мира IT, технологий, нейросетей и бизнеса.


CodeCamp dan repost
Ночное-полезное: Nvidia выложила в опенсорс SoL-Pi — систему, которая улучшает харнесс и сокращает расход токенов почти вдвое 😨

Исследователи перебрали множество вариантов обвязки, протестили и собрали в SoL-Pi четыре лучших механизма: они уменьшают повторные действия, сжимают контекст, результаты и логи. Благодаря этому на EdgeBench с GPT-5.6 Sol и Opus 5 удалось сократить расход токенов на 50%, сохранив сопоставимое качество. А стоимость работы агентов через API упала примерно на треть.

Неплохой способ сэкономить. Статья здесь, код тут 🤑


Нейродвиж dan repost
Video oldindan ko‘rish uchun mavjud emas
Telegram'da ko‘rish
Нейросеть на 27 млрд параметров ужали в 9 раз и теперь её можно запустить на картошке — чуваки из PrismML выпустили Bonsai 2 27B на базе Qwen3.8.

Веса языковой модели занимают жалкие 5,9 ГБ вместо 54 ГБ у исходной версии.
Весь секрет в весах со значениями −1, 0 и +1. По замерам разрабов, после сжатия сохранилось 98,2% среднего результата исходной модели на их наборе тестов. То есть размер сократили радикально, а просадка в тестах небольшая 😱

Модель пишет код, работает с инструментами и поддерживает контекст на 262 тысячи токенов. Всё это можно запускать локально на карточках NVIDIA или чипах Apple.

Забираем большую модель в маленькой упаковке — здесь.


Дизраптор dan repost
Харнесс решает всё больше

Пару недель назад OpenAI выкатила GPT-6 Astra и пафосно объявила "эру AGI". Один из аргументов был такой: новая модель набирает 99,9% на ARC-AGI-3. Это, если что, специальный тест, где ИИшку закидывают в незнакомые мини-игры без инструкции (ни цели, ни правил, ни даже что каждая кнопка делает). И смотрят, как она будет методом ИИ-тыка разбираться и во всё это дело играть.

Авторы теста прогнали Astra и в стандартной обвязке, общей для разных провайдеров, и с Provider Adapter от OpenAI. При одинаковом максимальном уровне reasoning результат вырос с 62,7% до 98,6%. А на high - с 54,8% до 99,9%». 

Откуда такая разница? Каждый ход в игре - это отдельный запрос к модели. В стандартной обвязке между ходами выживают только заметки, которые модель сама себе написала. Представьте себе шахматиста, которому после каждого хода отшибает память, и остаются только записи в блокноте. А обвязка от OpenAI позволяла сохранять между запросами скрытое состояние reasoning и использовать compaction длинного контекста - то есть гораздо лучше переносить уже проделанную работу между ходами. Если более научно, то такую обвязку называют harness (буквально "упряжка", как у лошади).

И вот моя любимая строчка из их таблицы: в харнессе модель с ВЫКЛЮЧЕННЫМ режимом рассуждений набрала 96,7%. То есть, вообще не думая, она на 30+ процентов обошла саму себя, думающую на максимум, но в стандартной "упряжке".

И ещё один пример поближе. Алиса AI на днях начала сама выбирать модель под запрос: на всякое простое отвечает быстрая модель, а на запрос вроде "Какие вычеты положены за лечение и курсы ребёнка" включается тяжёлый режим "Эксперт". Сейчас около 80% всех запросов обрабатывает собственная Alice AI LLM. Для режима “Эксперт” Яндекс тестирует разные модели - как свои, так и общедоступные с открытыми весами, которые запускаются на инфраструктуре Яндекса. А поверх них работает собственный харнесс Алисы. 

Зачем всё это? CEO Алисы Валерий Стромов прямо сказал Forbes: как инженеру, ему важны качество и скорость, а как руководителю бизнеса - стоимость. Поэтому, гонять самую мощную модель на каждый чих - это как сажать партнёра McKinsey выравнивать иконки в презе. Там же приводят вот такую цифру: несколько десятков инженеров на оптимизации за полгода сэкономили Яндексу ~9 млрд рублей. Это эффект от толковой оптимизации инференса и вычислительной инфраструктуры. 

В одном из прошлых постов про ИИ-модели я писал про MoE - это когда роутер внутри модели под каждое слово выбирает нужную подсеть-эксперта. Тут сейчас похожий принцип, только этажом выше. Роутер выбирает не "эксперта", а целую модель под запрос. Моделей всего 3-5 штук, потому что роутер работает примерно как регистратура в поликлинике, и отправить к терапевту или хирургу ему изи, а вот выбрать нужного из 20 узких спецов по жалобе "что-то бок болит" - уже нет.

Почему харнесс имеет настолько ключевое значение, когда все модели уже подтянулись на более-менее сопоставимый уровень умности - хорошо видно по бытовому запросу а-ля "подбери робот-пылесос дешевле 40 тысяч, чтобы убирал и ковры, и шерсть кота". Внутри модели ответа нет и быть не может, потому что цены и другие нюансы меняются каждую неделю. Значит, надо сходить в поиск, вытащить характеристики, сверить с отзывами и отсеять всё дороже лимита.

И вот это "нашёл → проверил → пошёл дальше" во многом определяется харнессом.

Так что, вопрос "какая ИИшка умнее?" на самом деле потихоньку устаревает, а вот тонкие настройки вокруг неё играют всё более важную роль.

Дизраптор


CodeCamp dan repost
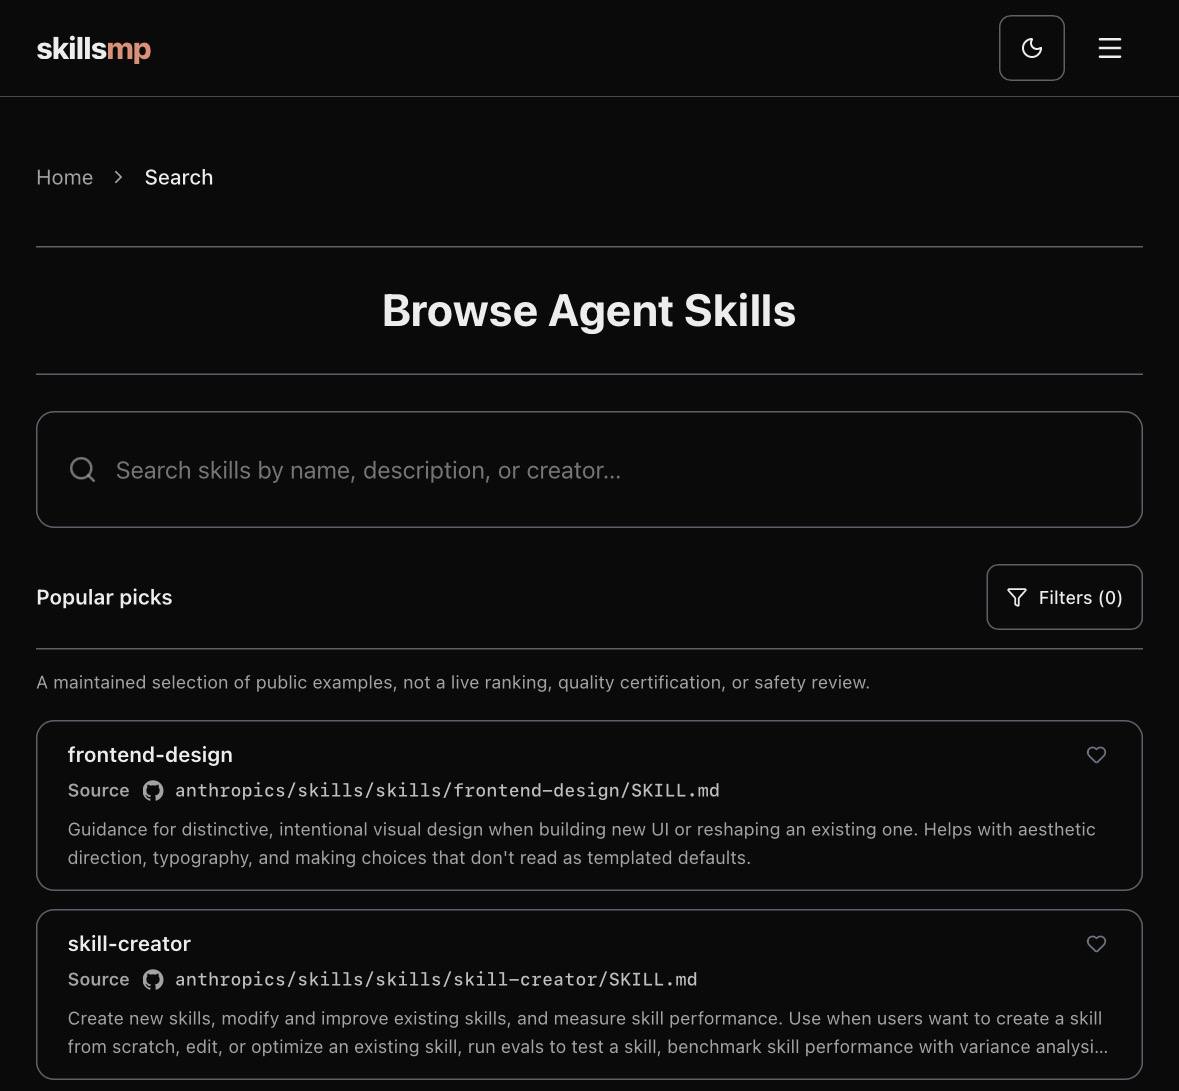
Это нам надо: нашёл огромный маркетплейс скиллов для Claude и Codex — SkillsMP.

Внутри больше 3 млн готовых навыков под разработку, дизайн, DevOps, аналитику, маркетинг и кучу других задач. Можно найти нужный навык, посмотреть его SKILL.md и забрать себе. Причём всё это бесплатно, с удобным поиском, карточками и индикаторами качества.

Вайбкодерский клад 🏴‍☠️


XOR dan repost
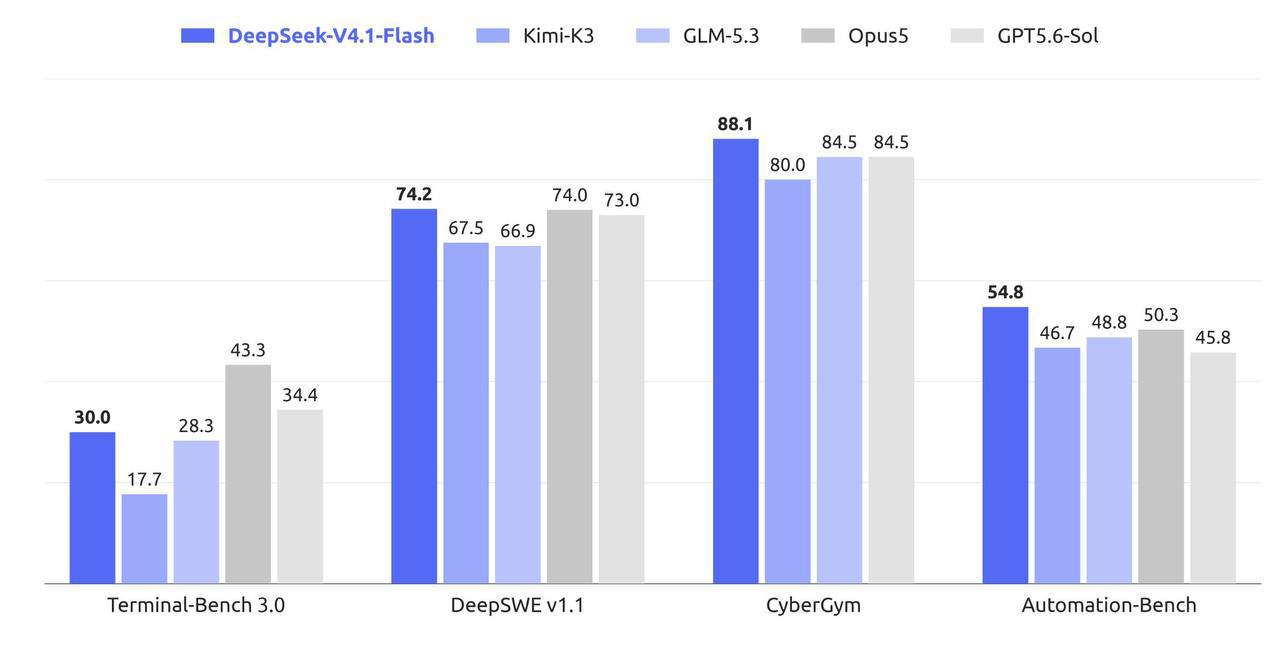
Возвращение кита: вышла DeepSeek V4.1 Flash — новая быстрая модель, которая бьет GPT-5.6 Sol! 😮

Главное:

🟢 Это MoE-модель на 552 млрд параметров, которая заточена под кодинг и агентные задачи. На DeepSWE v1.1 она набрала 74,2 балла, что выше GPT-5.6 Sol и Claude Opus 5!

🟢 В CyberGym тоже обошла GPT-5.6 Sol: 88 против 84. А на Automation-Bench вообще стала лучшей.

🟢 Стоит при этом от $0,15 за 1 млн входных токенов и $0,60 за выходные. Красота.

Уже на Hugging Face 😉😉

@xor_journal


Метаверсище и ИИще dan repost
Suno бахнули выводок моделей: v6, v6-wild и v6-mini


Главное:

- v6 - флагман для Pro/Premier, упор на точное следование сложному музыкальному замыслу и более предсказуемый результат.
- v6-wild - тоже Pro/Premier, но специально сделан более вариативным и менее предсказуемым, для безумных экспериментов.
- v6-mini - ускоренная облегченная версия для нищебродов, доступная всем, включая бесплатный тариф.

Бесплатку оставили!!

Самое интересное - новые режимы редактирования.

v6 умеет менять отдельный фрагмент существующей песни текстовой командой, не перестраивая весь трек, заменять одну строку или даже слово(верим?), собирать mashup из нескольких исходников и брать конкретный кусок аудио, например гитарный riff, изолировать(!) его и построить вокруг него новый beat. Чото сладко както.

А вот это уже бомба - мультимодальность:

Suno прямо заявляет про генерацию музыки одновременно из текста, аудио, изображения и видео. То есть можно дать картинку, voice memo, видео и текстовое описание как единый набор условий для трека.

Также хвастаюцца, что v6 быстрее, выразительнее и качественнее предыдущих моделей, но это пока только суновский маркетинг, нужны тесты.

Доступ и цены:

- v6-mini - Free
- v6 и v6-wild - Pro/Premier

- Free - $0
- Pro - $10/мес или $8/мес при оплате за год
- Premier - $30/мес или $24/мес при оплате за год.

Suno также грозицца, что по мере rollout старые поколения моделей будут постепенно убраны, а сервис целиком перейдет на v6 generation.

Итого: выглядит как редактируемая мультимодальная модель, где отдельными командами можно менять структуру и элементы уже существующего трека.

Интересен интерфейс редактирования.

Го за песком на котлован V6!

Ссылки:

https://about.suno.com/blog/introducing-v6

https://suno.com/pricing

@cgevent


Нейродвиж dan repost
⚡️ Вышел гайд по промтингу новой ChatGPT Images 2.5: OpenAI подготовили готовые примеры, которые можно взять в работу 😮

Есть промты для создания логотипов, рекламы и даже комиксов — налетаем.


эйай ньюз dan repost
Ситуация на image арене с выходом GPT-Image-2.5

Есть две версии модели GPT-Image-2.5: Flare и Sunburst.

Flare работает примерно в 1.85-1.9x быстрее чем Sunburst (по моим замерам), но похуже качеством. Причем цена у Flare и Sunburst одинаковая, и такая же как и на GPT-Image-2 (если брать max reasoning).

Забавно, как произошла инфляция ризонинга. У GPT-Image-2 самый высокий ризонинг назывался High, а у 2.5 после high есть еще xhigh и max, причем 2-high соответствует по количеству генерируемых токенов и по цене - версии 2.5-max. Маркетинг?

Визуально очень заметно, что это скорее всего дотрейн/post-train базы GPT-Image-2, т.к. сохранились все характерные для GPT паттерны на генерациях.

@ai_newz

20 ta oxirgi post ko‘rsatilgan.