Коммуналка аналитиков


Kanal geosi va tili: Rossiya, Ruscha


Канал аналитиков Авито.
Рассказываем о том, как аналитика помогает — а иногда и мешает — нам жить, делимся победами и фейлами из рабочих будней, перекладываем в тексты идеи и мысли.

Bog‘liq kanallar
Kanal geosi va tili
Rossiya, Ruscha
Statistika
Postlar filtri


Обновляем список литературы на Хабре

Надеемся, вы уже прочитали нашу летнюю подборку статей. И раз уж учебный год и четвёртый квартал в разгаре — самое время для нового списка литературы, сохраняйте ↓

📌 Локальная LLM миграция Vertica2Trino: как довести до рабочего состояния, если модель не тянет

Алексей Дубинец и Павел Беспалов переводят с Vertica на Trino около 65 витрин, в каждой от 500 до 4 000 строк SQL. Локальной модели, которая справилась бы с этим сама, не нашлось, поэтому её встроили в систему с проверками на каждом шаге. 

Теперь одна витрина переезжает за 30–60 минут вместо 3–5 часов

Читать →


📌 От «когда-нибудь» к работающему прототипу: как LLM дала идее шанс

Владислав Козлов давно хотел кластеризацию, которая из коробки работает с категориальными признаками и не боится выбросов. Пара обсуждений с LLM и несколько исправленных багов — и у него MVP библиотеки Forest Clustering, хотя сам он не написал ни строчки кода.

На датасете «Титаника» метод выдержал выбросы, на которых просели остальные алгоритмы

Читать →


📌 От ручных правил к модели: как автоматизировать субсидии, если нельзя просаживать метрики в A/B

В Авито Подработке гигерам доплачивают за «сложные» смены, и отключить доплаты ради A/B-теста нельзя: упадёт заполняемость смен и пострадают обязательства перед клиентами.

Арина Сокова рассказала, как команда перешла на модель отклика на цену и LP-оптимизатор бюджета. Сумма доплат сократилась на 9%, а бизнес-метрики не просели.

Читать →


📌 Всё по полочкам или как мы создавали единую метрику для сотен моделей антифрода

Аня Шатшнайдер рассказала, как они с командой разложили всё по полочкам в антифроде. Сотни моделей там оценивали по отдельности, и сравнить их между собой было почти невозможно.

Команда придумала единую метрику MES из шести компонентов, собрала 7 витрин и 10 дашбордов и сразу нашла 8 неэффективных моделей.

Читать →


💭 Приятного чтения! Если есть похожий опыт или наблюдения в тему, не стесняйтесь комментировать прямо на Хабре.

820 0 17 1 13

Контента про ИИ в последнее время стало так много, что без ИИ за ним уже и не уследить.

Условно его можно поделить на две части: одна — про ужасы, которые нас ждут при таких темпах развития ИИ, а другая — про крутые мегаудобные ИИ-инструменты-сервисы B2B SaaS Pro Max Duo.

Мы теорий заговора не строим, B2B SaaS не делаем, а просто постепенно находим наиболее эффективный путь интеграции ИИ в нашу работу. И у нас уже есть первые результаты, которыми хотим поделиться:
- провели AI-акселератор по аналитике;
- вырастили adoption агентов до 90%;
- сформировали первое видение того, как ИИ меняет профессию.

Подробнее обо всём расскажут коллеги в коротком ролике → «ИИ заменит аналитика?»

Смотрите на ютюбе

Или в ВК

Пишите в комментариях: какой adoption ИИ у вас и какие проекты уже успели сделать с помощью нейронок?)


Встречаемся 7 октября на Avito DS Meetup 🚀
Собрали доклады про RL, AI-агентов и BidCorrection — с продуктовыми задачами внутри.

19:10 🔴 Как повысить качество трафика для продавцов, которые платят за клики | Владислав Воробьев, Авито
Влад поделится, как BidCorrection учится оценивать относительную ценность входящего трафика и учитывать её в ранжировании.

19:35 🔴 RL для Авито | Булат Шарипов
Булат расскажет про полный цикл обучения собственных языковых моделей: адаптация под русский язык, алаймент, GRPO/DAPO/GSPO и трудности агентского RL.

Обсудим необычную постановку задачи: изменить состав трафика, сохраняя среднюю поправку объявления около единицы. Разберём, как обучить такую модель и проверить, что её применение приносит пользу.

20:00 🔴 Что на самом деле нужно делать AI-инженеру, чтобы автоматизировать процессы агентами | Всеволод Викулин, Т-Банк
Узнаете, как выбирать процессы для автоматизации, от чего отказаться и на чём фокусироваться. Плюс про команду, роли и ответственность.

Приходите слушать доклады, общаться с DS-сообществом. А ещё искать пасхалки, которые мы для вас спрятали 😉

🕒 7 октября, начало в 18:30

Количество офлайн-мест ограничено — регистрация обязательна. Онлайн-трансляция будет доступна позже


Я провожу собеседования аналитиков в Авито и часто вижу одну и ту же картину...

➡️ К нам приходят сильные ребята с интересным опытом, но переходим к кейсу — и аналитики начинают решать его с помощью метрик своего продукта, привычной логики и знакомых подходов.

Это естественная цена глубокого погружения. Чем дольше работаешь внутри одного продукта, тем проще принять его правила за универсальные. Привыкаешь к конкретной бизнес-модели, аудитории и системе метрик, а потом приносишь всё это в каждый новый кейс.

➡️ Чтобы не стать заложником одного продукта, нужна насмотренность — та самая, про которую постоянно говорят стилисты.

В стиле есть правила, но одного правильного образа для всех не существует. Одна и та же вещь в разных сочетаниях может работать или проваливаться. Поэтому стилисты смотрят не только на готовый образ, но и на логику, по которой он собран: что с чем сочетается, почему это работает и в каком контексте уместно.

С продуктовыми кейсами так же.

Чем больше разных продуктов и задач разобрал, тем легче переключаться между контекстами, мыслить шире привычных схем и видеть больше вариантов решения.

Тогда на незнакомом кейсе не хватаешься сразу за привычную конверсию или ретеншен, а сначала разбираешься, как устроен этот бизнес, какую ценность и для кого он создаёт, на чём зарабатывает и какие задачи решает прямо сейчас. И уже потом подбираешь метрики.

Самый очевидный способ прокачать насмотренность — это поработать в разных компаниях и с разными продуктами. Но менять работу ради этого совсем не обязательно.

➡️ Вот пара способов прокачки насмотренности от меня:
🔍 смотреть конференции и разборы кейсов других компаний;

🔍 подписаться на каналы с видео от аналитиков, например, на AvitoTech;

🔍 решать кейсы с собеседований и кейс-чемпионатов;

🔍 собирать собственное решение и только потом смотреть чужое;

🔍 разбирать не только выбранные метрики, но и логику: почему они подходят этому продукту именно сейчас.

Насмотренность не даёт готовых правильных ответов, но помогает быть гибче, видеть больше вариантов и собирать решение под конкретный продукт, бизнес и задачу.

Тогда привычный набор метрик перестаёт быть единственным приличным костюмом в шкафу 💅


Какой формат постов хочется видеть в канале чаще?
So‘rovnoma
  •   Короткие посты с одной мыслью
  •   Подробные разборы рабочих ситуаций
  •   Аналитические кейсы из команд Авито
  •   Разборы статей / видео / исследований
  •   Опросы и обсуждения в комментариях
  •   Карточки / визуальные форматы
  •   Мемные посты
  •   Истории людей и карьерные интервью
  •   Другое — напишу в комментариях
83 ta ovoz


Какая карьерная тема вам сейчас ближе всего?
So‘rovnoma
  •   Как войти в аналитику
  •   Как вырасти из junior в middle
  •   Как вырасти из middle в senior
  •   Как сеньору расти дальше: менеджер vs эксперт
  •   Как перейти в другую команду / домен
  •   Другое — напишу в комментариях
102 ta ovoz


Что чаще всего болит в работе?
So‘rovnoma
  •   Мутная постановка задач
  •   Слишком много адхоков
  •   Сложно влиять на продуктовые решения
  •   Непонятно, как расти дальше
  •   Дашборды есть, решений — нет
  •   А/Б-тесты и интерпретация результатов
  •   Коммуникация с продактами / бизнесом
  •   Хочется больше технической глубины
  •   Другое — напишу в комментариях
94 ta ovoz


За последнее время в канале стало заметно больше людей: кто-то только пришёл в аналитику, кто-то думает про следующие карьерные шаги, а кто-то просто любит листать мемы в рабочее время читать про данные и продуктовые кейсы.

Хотим свериться с вами и узнать, о чём интереснее читать сейчас.

Проголосуйте в опросах ниже, а мы почитаем ответы и будем делать больше постов, которые вам правда полезны.

А если вашего варианта нет — делитесь им в комментариях 👇


1 октября пройдёт первый митап Trisigma в Ташкенте 🚀

Команда Trisigma собрала экспертов и коллег из TBC и Uzum, чтобы обсудить, как data-driven подход работает за пределами вайт-пейперов, в разных компаниях и разных контекстах.

➡️ Как культура экспериментов превращает продуктовую команду в data-driven, а не data-informed.

➡️ Как выстроить аналитику так, чтобы она помогала, а не мешала бизнесу.

➡️ Как в разных компаниях устроен процесс работы с данными — и почему в одной он работает как нужно, а в другой нет.

➡️ Как оценить экономический эффект от внедрения A/B-культуры в бизнесе.

И, конечно, будут говорить про A/B-инструменты в целом, в том числе про Trisigma: как она устроена, в каких компаниях используется уже сейчас. И к каким результатам эти компании пришли за последний год.


🔴 Регистрируйтесь на офлайн-встречу в Ташкенте или на онлайн-трансляцию 🔴


Если работаете в горизонтальной команде, после хорошего A/B почти всегда прилетает вопрос:
А у нашей вертикали точно всё хорошо?


И вопрос справедливый. Общий эффект может быть положительным, а внутри отдельной вертикали или категории что-то могло просесть.

Самое очевидное решение — посчитать эффект отдельно по всем вертикалям и логическим категориям. Только разрезов обычно много, выборки становятся меньше, а вместе с количеством проверок растёт шанс найти случайную просадку.

Поэтому мы смотрим не только на общий эффект, но и на перцентили total-метрики: от P10 до P90. Так можно понять, не получился ли хороший средний результат за счёт верхней части распределения, пока нижний хвост уехал вниз.

Это, конечно, не ответ на вопрос «в каждой ли вертикали всё идеально?». Скорее ранний сигнал. Если среднее растёт и нижние перцентили ведут себя нормально, причин копать каждый разрез подряд меньше. Если хвост начинает проседать, уже есть повод идти глубже и искать, где именно появилась проблема.

Мне этот подход нравится тем, что он не превращает один эксперимент в десятки отдельных тестов и при этом не оставляет нас с ответом «ну в среднем же всё хорошо».

А как вы проверяете, что хороший общий результат не скрывает проблемы в отдельных маленьких срезах?


Спрашивает меня как-то подруга-аналитик: «Слушай, как посчитать эффект от выкатки нового тарифа в новом городе? Чтобы посмотреть каннибализацию других тарифов». 

(Продукт существует, но в новом городе выкатили новый тариф, который уже раскатан в нескольких других городах)

😊 «А есть похожий город, где вы уже были раскатаны?» — спрашиваю я

👩‍💻 «Ну они сильно другие»

😊 «Окей, выкатывали ли вы на всех пользователей эту фичу?»

👩‍💻 «Исключали новичков — тех, кто сделал менее 10 пользований сервиса, — а так на всех, да»

😊 «Ага, супер. Тогда можно сравнить 2 группы и то, как они пользовались другими тарифами»


Тут важно сказать, что не стоит просто сравнивать пользователей «до порога» и «после порога». Человек, который пользовался сервисом 2 раза, и человек, который пользовался им 50 раз, очевидно, отличаются не только наличием нового тарифа. Они и без всякой выкатки могли бы по-разному пользоваться остальными тарифами.

Но здесь есть условная граница, и можно найти пользователей, которые плюс-минус похожи, но при этом в разных группах: кто увидел новый тариф, и кому он недоступен. Если тариф становился доступен после 10 использований сервиса, можно сравнить, например:

8–10 использований ➡️ тарифа ещё нет
11–13 использований ➡️ тариф уже есть

Это уже гораздо более похожие пользователи. В идеальном мире единственное значимое отличие между ними — это доступность нового тарифа. А дальше смотрим, начали ли пользователи справа от порога реже выбирать старые тарифы.

И обязательно проверяем устойчивость результата: берём окно поуже — например, 9–10 vs 11–12, потом пошире — 7–10 vs 11–14. Если вывод каждый раз примерно один и тот же, доверия к нему становится сильно больше.

Если вам это что-то напоминает — да, это Regression Discontinuity Design, про который я уже писала в отдельном посте 👀

Что интересно, именно в момент этого разговора я сидела и считала по такому же методу свой «псевдотест». Изначально это не планировалось как АБ-тест, а просто было плавной раскаткой коммуникации на пользователей. Но в механике раскатки тоже нашлась условная граница, вокруг которой можно было сравнить очень похожих пользователей.

Спойлер, мой «псевдотест» не показал никаких аплифтов. Я проверила на разных границах (брала пользователей и поближе к границе, и подальше, разницы не было никакой), а у подруги-аналитика как раз такое исследование показало жёсткую каннибализацию других тарифов.

Дальше, конечно, стоит сделать обратный АБ, чтобы точно замерить негативный эффект на метрики других тарифов и получить данные для принятия решения. Ну или понять, что совсем всё плохо, и не катить тариф в этом городе :)

Вот так и поговорили.

Ну делитесь, а как бы вы попробовали обсчитать такой запуск?


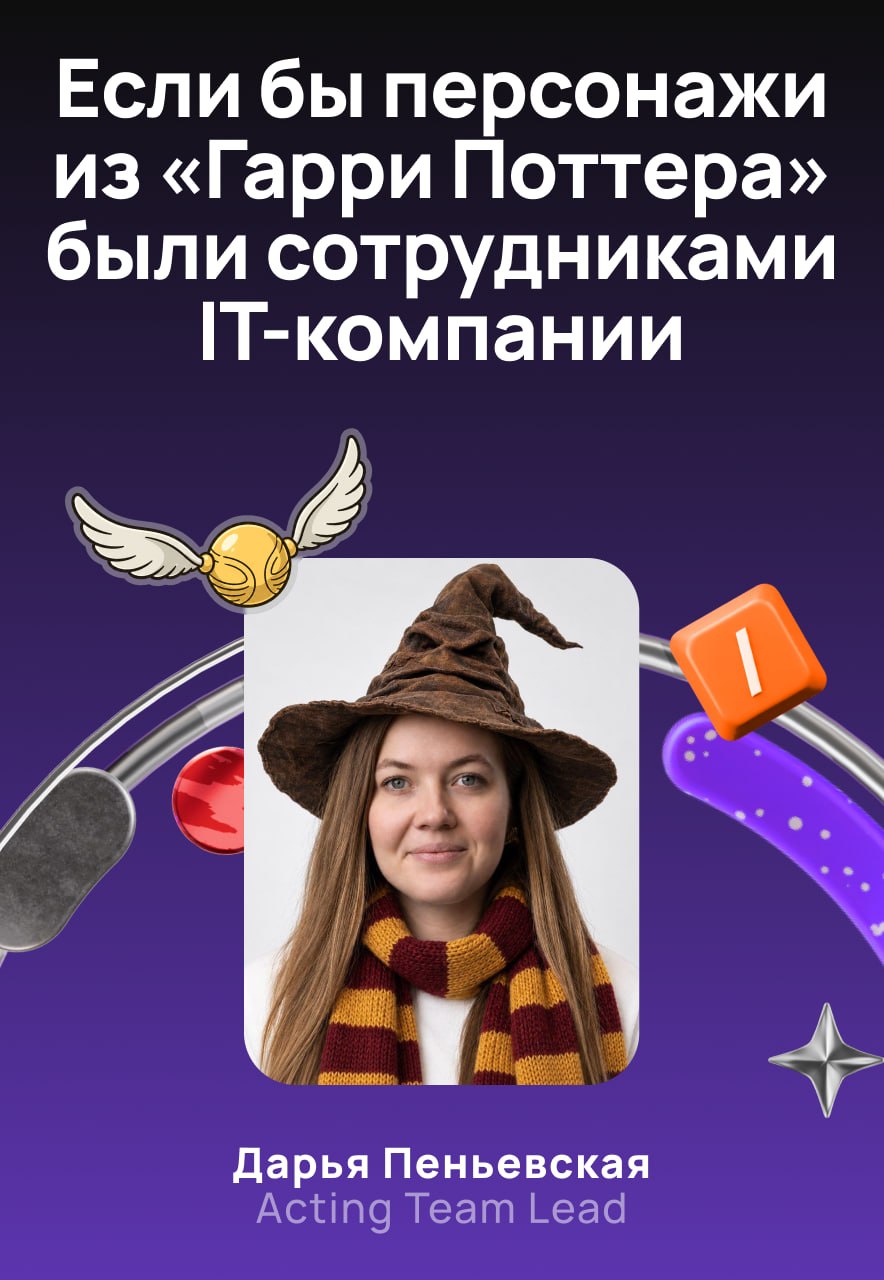
Мир IT — отдельная параллельная вселенная. Она существует рядом с обычным миром, но в ней свой язык, свои правила и огромное количество непонятных аббревиатур.

Со стороны иногда кажется, что это и правда волшебный мир: в офисах стоят массажные кресла, на кухнях всегда есть фрукты, а люди произносят слова «деплой», «пайплайн» и «прод» — и каким-то образом заставляют всё работать.

Давайте представим, кем работали бы персонажи «Гарри Поттера», если бы вместо Хогвартса оказались в современной IT-компании.

🧙‍♀️ Сегодня Распределяющая шляпа будет отправлять героев не на факультеты, а в IT-профессии.

P. S. В какой-то момент поняла, что пишу уже не пост для канала аналитиков, а фанфик по «Гарри Поттеру» в мире IT, и решила не останавливаться…


В последнее время поднялся очередной шум вокруг ИИ — на этот раз из-за математики. OpenAI заявила, что её внутренняя AI-система предложила решение задачи Навье — Стокса — одной из знаменитых открытых математических задач. В решение был включён текст доказательства и формализация на Lean (языке для формальной проверки математических доказательств).

На этом фоне Теренс Тао, один из ведущих современных математиков, опубликовал заявление A Severe Misalignment of AI in Mathematics, подписанное 25 лауреатами Филдсовской премии.
Главная мысль, как я её понял: в математике важен не только финальный ответ. Решение большой задачи ценно ещё и тем, какие идеи, методы и обсуждения появляются по пути.


И мне кажется, что в аналитике прослеживается что-то похожее.

➡️ Если ИИ способен подходить к таким сложным задачам, то агентские системы будут всё лучше строить большие цепочки рассуждений и самостоятельно «копать данные»: искать сегменты, замечать аномалии, предлагать объяснения и формулировать инсайты. Вероятно, таких инсайтов будет становиться всё больше и больше.

Но, как и с большими математическими результатами, сам факт появления ответа ещё не всегда закрывает вопрос. Нужно понимать, как именно возникло исследование: какие гипотезы проверялись, какие шаги привели к выводу, что было отброшено, где осталась неопределённость и какое решение из этого действительно следует.

➡️ Возможно, роль аналитика будет смещаться не только в сторону поиска инсайтов, но и в сторону их валидации. Нужно будет следить за путём решения, проверять ограничения и объяснять, почему найденному выводу можно или нельзя доверять.

А как вы думаете: если ИИ будет приносить всё больше готовых инсайтов, что станет главным навыком аналитика — находить ответы, проверять путь к ним или превращать их в правильные решения для бизнеса?

#АрменЕс


Зачем ходить на офлайн-конференции? 
Да чтобы поиграть в управленческий покер, получить разборы проблем от лидов Авито и посидеть с коллегами по индустрии в нишевом баре. 

Подробности в карточках, а регистрация ➡️ по ссылке ⬅️


Зелёные тесты и сырники, рассказываем про кайфушечки аналитиков

❤️ Когда чей-то дэш помог ответить на все вопросы за 2 минуты

❤️ Задачу, рассчитанную на день, получилось сделать за полчаса

❤️ Скрипт, обрабатывающийся обычно час, выполнился за 5 минут — и как будто ничего оптимизировать уже не надо

❤️ Тест оказался зелёным, и можно не копать дальше

❤️ Расчёты, сделанные по разным методологиям, сошлись

❤️ Заказчики решили, что больше не нужна выгрузка

❤️ На кухне дают сырки

❤️ Встречу на час закончили за 20 минут

❤️ Аналитическое исследование действительно прочитали до конца и задали актуальные вопросы по нему

❤️ Не получилось подключиться на собес, но нашёлся коллега, готовый подхватить

❤️ Причину просадки метрики поняли за первые пять минут

❤️ Скинули код другого аналитика — и в нём ничего не нужно было чинить

Что забыли?)


16 ta oxirgi post ko‘rsatilgan.